
如何用 Fable 5.2 全天候开发交易策略(附整套提示词)
文章目录
Fable 5.2 出来三天,时间线上都在比跑分。
我更关心另一件事:它能不能整晚不掉线,把我回测里那些「看起来很赚」的策略一个个证伪。
试下来,能。这篇把我的整套做法拆开讲:怎么让它在 Claude Code 里调开源 Python 库跑回测,怎么用 4 道关筛掉运气,怎么让它每晚自己干活,早上交一份报告。
先收藏。后面提示词有 4 段,搭的时候要翻回来对着贴。
先说清楚立场:这套东西只研究,不下单。它最多跑纸面交易,真钱上不上、上多少,永远是你自己拍板。
为什么是现在
做过回测的人都知道一个尴尬的事实。
你把一个均线策略的参数从 10 试到 100,总能试出一组曲线很漂亮的。拿去实盘,两周就露馅。
原因很简单:试的次数够多,噪音里也能挑出「好策略」。
以前的 AI 帮不上这个忙。你问它「给我一个赚钱的策略」,它会很自信地给你一个,背后什么都没有。它也没耐心陪你跑几百次检验。
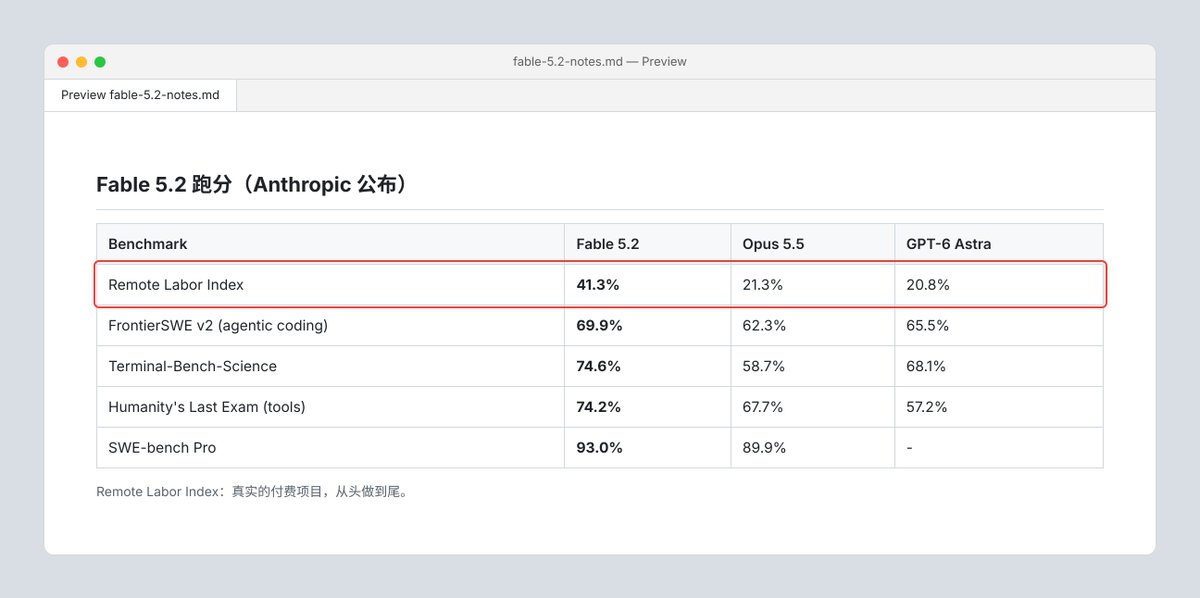
Fable 5.2 不一样的地方在于长任务。Anthropic 11 月 9 日发的这个模型,在 Remote Labor Index 上拿了 41.3%,这个榜测的是真实的付费项目从头做到尾。Opus 5.5 是 21.3%,GPT-6 Astra 是 20.8%。
翻译成交易的话:它能连着几个小时按流程干活,中途不忘自己在干嘛。
一个能整晚守住流程的模型,第一次可以把「出点子 → 回测 → 判断是不是运气 → 再来」这个循环自己跑起来。
看完这篇你会知道:
-
用 Fable 5.2 做研究,档位怎么选才不浪费钱
-
怎么在 Claude Code 里给它搭一个开源回测实验室,数据用币安公开 K 线
-
4 道验证关,每一关在杀什么样的假策略
-
一段能直接贴的「策略工厂规矩」,加 3 段日常提示词
-
它能做什么、不能做什么,我写成一张清单
第一部分:先把 Fable 5.2 用对
档位别开满
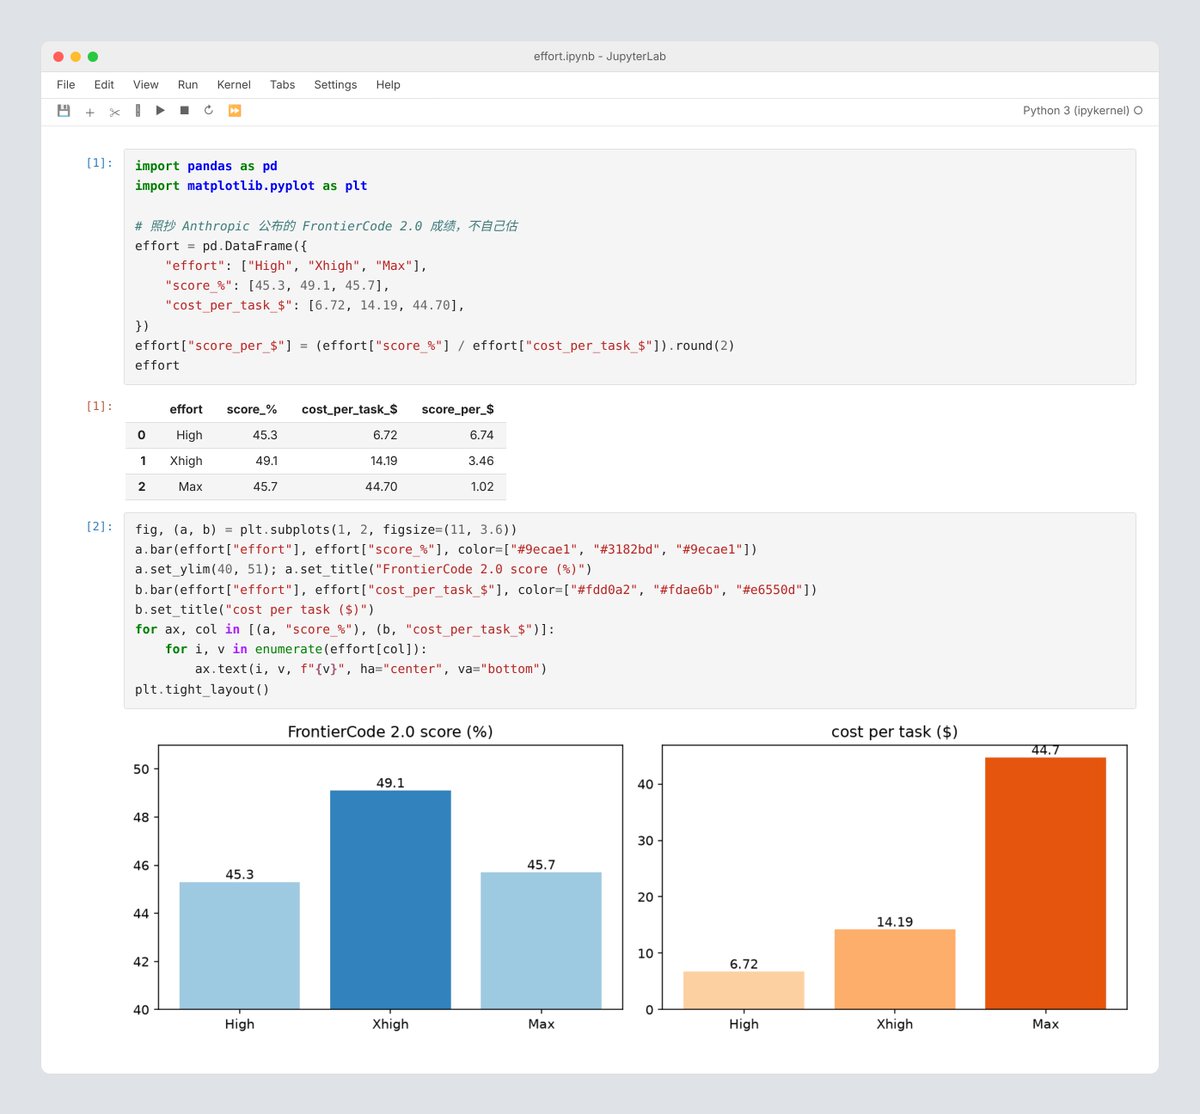
Fable 5.2 有 5 档 effort:Low、Medium、High、Xhigh、Max。
很多人直觉选 Max。但按 Anthropic 自己公布的编码基准,Xhigh 是 49.1%,Max 是 45.7%。Max 分更低,还更贵。
我的用法:
-
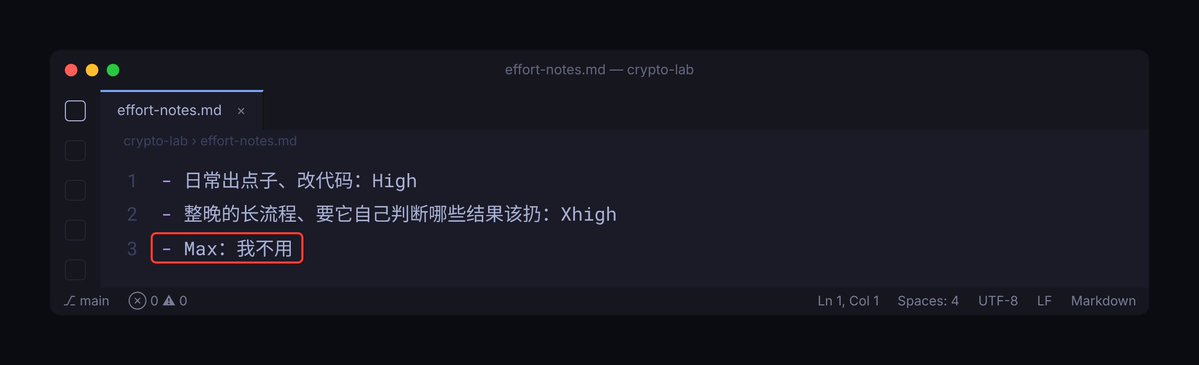
日常出点子、改代码:High
-
整晚的长流程、要它自己判断哪些结果该扔:Xhigh
-
Max:我不用
给它流程,别给它问题
「帮我找个能赚钱的策略」是最差的提示词,对谁都一样。
它的强项是长链条任务。所以你要给的是一套流程:先干什么,过什么关,什么情况算失败,失败了怎么记。规矩写死,让它照着跑。
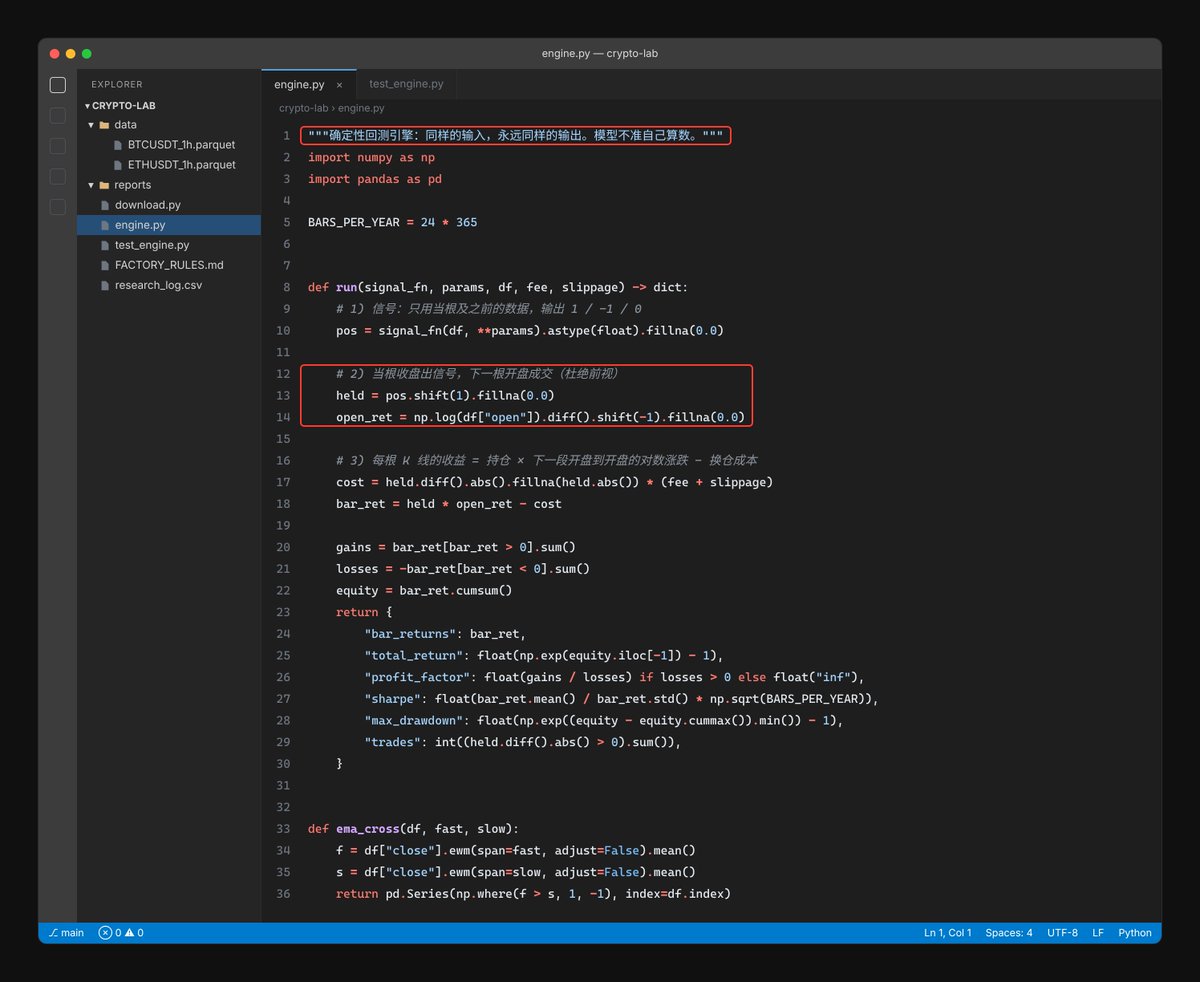
算数交给 Python
Fable 5.2 的价格是每百万 token 输入 8 美元、输出 40 美元。
拿这么贵的模型去一行行算夏普比率,既浪费,也危险。模型能自己算回测,就能自己编一个回测。
所以分工要切开:
模型只做判断:试什么点子、扫哪些参数、哪些结果该扔、为什么。
数字全部交给确定性的代码:同样的输入,每次跑出同样的结果。模型没法靠「说服」让数字变好看。
第二部分:在 Claude Code 里搭一个回测实验室
我不用任何付费平台,全是开源库:
-
pandas:清洗数据、算每根 K 线的收益
-
backtesting.py:单个策略的回测,带手续费,出图直观
-
vectorbt:一次扫几百组参数,速度快
-
数据:币安公开 K 线。data.binance.vision 上有按月打包的历史数据,免费下,不用 API key
打开 Claude Code,模型选 Fable 5.2,effort 调到 High,在一个空文件夹里贴这段:
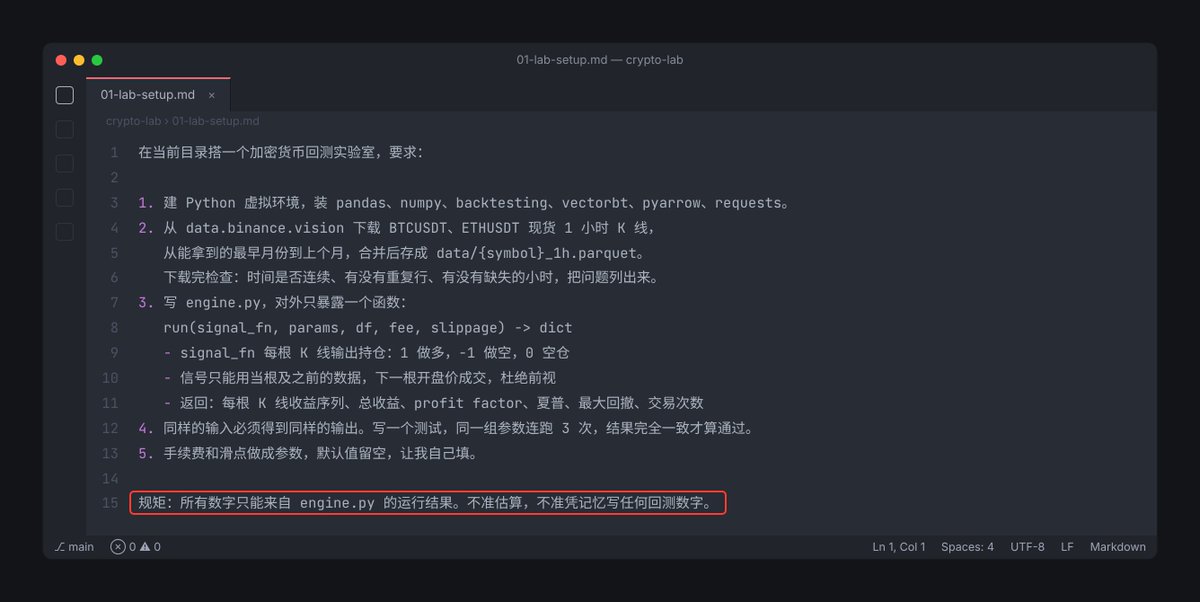
在当前目录搭一个加密货币回测实验室,要求:

1. 建 Python 虚拟环境,装 pandas、numpy、backtesting、vectorbt、pyarrow、requests。
2. 从 data.binance.vision 下载 BTCUSDT、ETHUSDT 现货 1 小时 K 线,
   从能拿到的最早月份到上个月,合并后存成 data/{symbol}_1h.parquet。
   下载完检查:时间是否连续、有没有重复行、有没有缺失的小时,把问题列出来。
3. 写 engine.py,对外只暴露一个函数:
   run(signal_fn, params, df, fee, slippage) -> dict
   - signal_fn 每根 K 线输出持仓:1 做多,-1 做空,0 空仓
   - 信号只能用当根及之前的数据,下一根开盘价成交,杜绝前视
   - 返回:每根 K 线收益序列、总收益、profit factor、夏普、最大回撤、交易次数
4. 同样的输入必须得到同样的输出。写一个测试,同一组参数连跑 3 次,结果完全一致才算通过。
5. 手续费和滑点做成参数,默认值留空,让我自己填。

规矩:所有数字只能来自 engine.py 的运行结果。不准估算,不准凭记忆写任何回测数字。
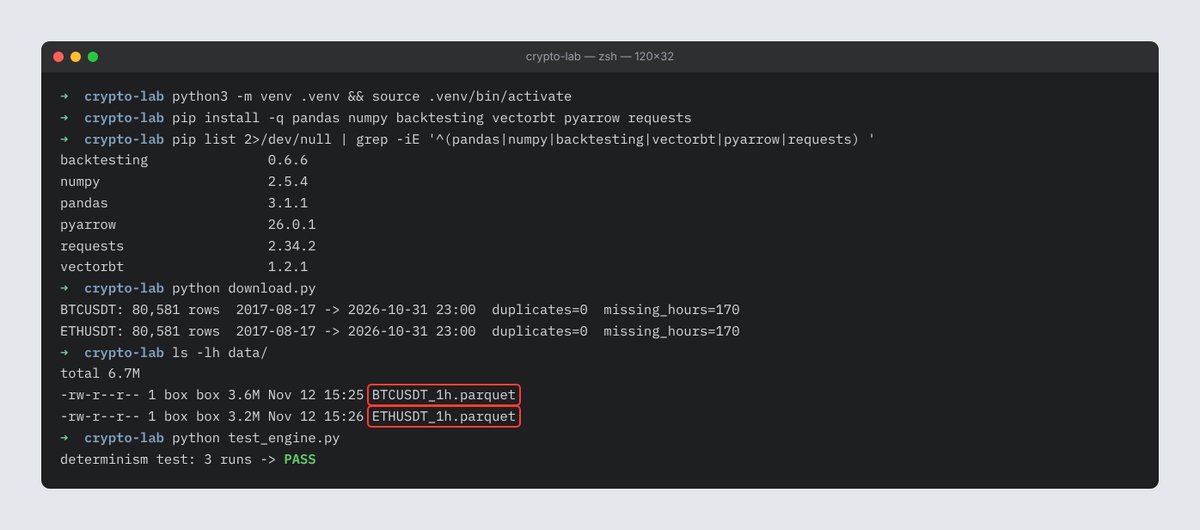
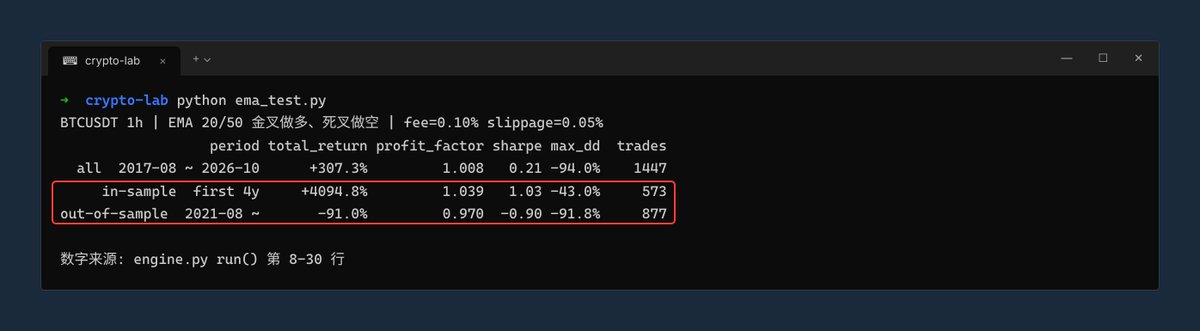
跑完之后,立刻测一下:
用 engine.py 跑 BTCUSDT 1 小时线,EMA 20/50 金叉做多、死叉做空,
手续费按 [你的费率] 填,滑点按 [你的滑点] 填。
把结果表直接打印出来,并告诉我这些数字是哪一行代码算出来的。
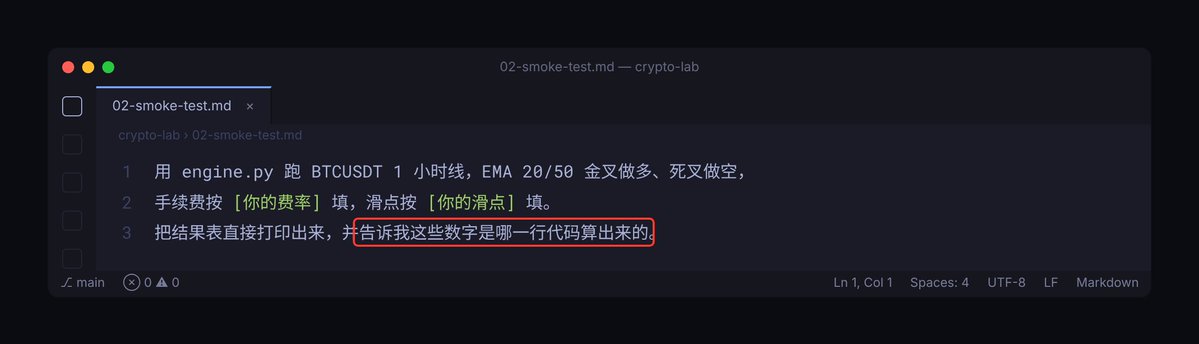
能打印出一张真实的结果表,实验室就算搭好了。
分工我再强调一次,整套东西最关键的就是这一条:
Python 跑回测,Fable 5.2 跑研究流程。
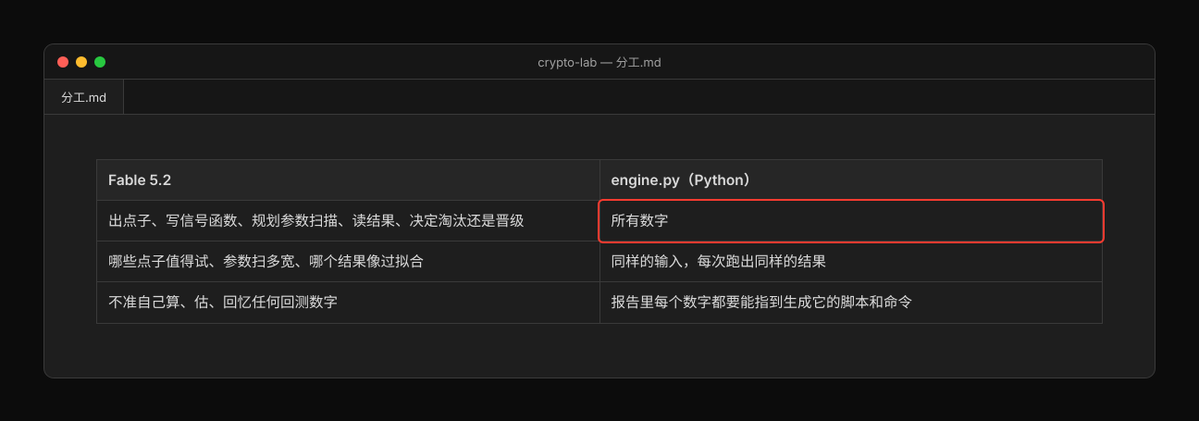
引擎越无聊越好。哪些点子值得试、参数扫多宽、哪个结果像过拟合,这些判断留给模型。两边谁也不替谁干活。
第三部分:4 道关,专杀靠运气的策略
说一个让人不舒服的事实:优化永远有效。
同一个点子你试够多版本,总有一版很惊艳,哪怕数据是纯随机的。
一个整晚不停试点子的 AI,挑出这种「假赢家」的速度比任何人都快。所以这套工厂真正的活,是把靠运气的那些杀掉。找策略反而是次要的。
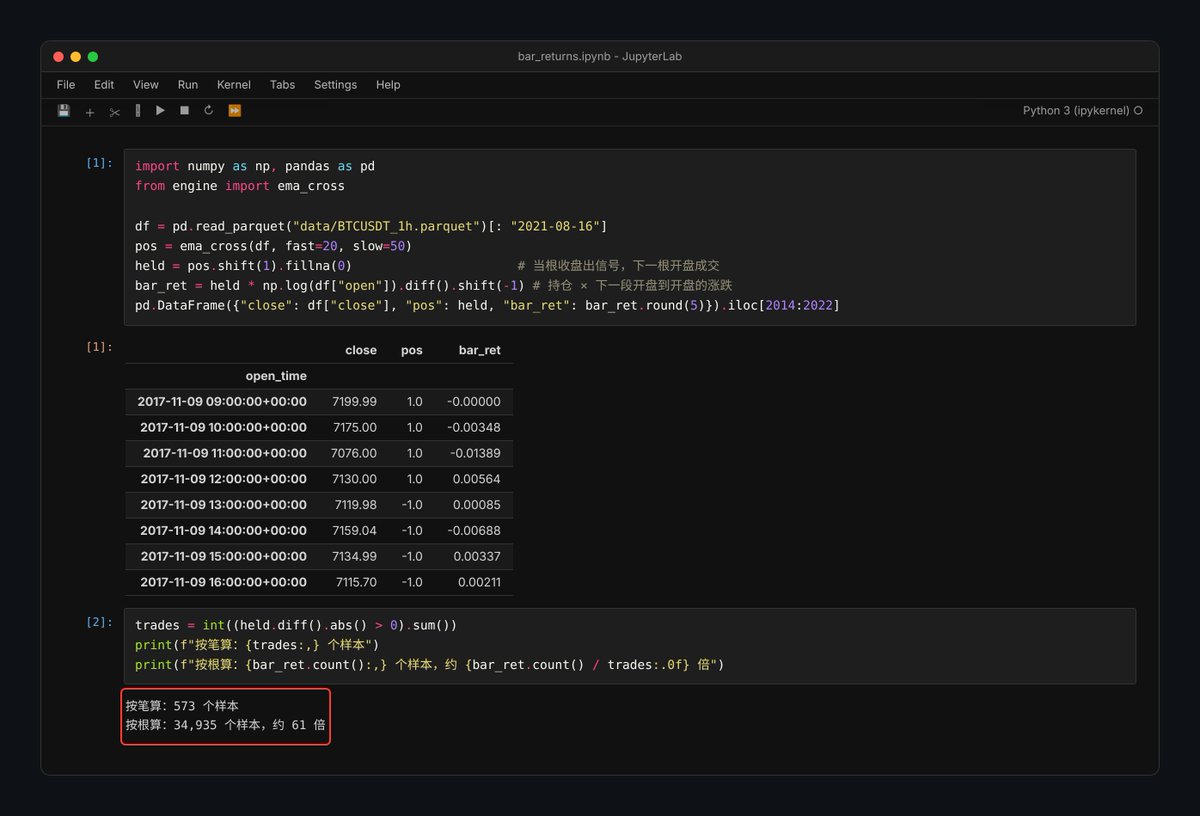
先定一个口径:按每根 K 线算收益,不按每笔交易算。持仓 1、-1、0 乘以当根涨跌,每根都有一个收益。样本多出几十倍,统计结果稳得多。
第 1 关:样本内,好不好看
拿前 4 年数据做优化,问两个问题。
它够好吗?在这一关都平庸的策略,到后面只会更差,直接扔。
它好得离谱吗?曲线一路直线向上,大概率是前视偏差,或者把噪音背下来了。这种也要拉出来查。
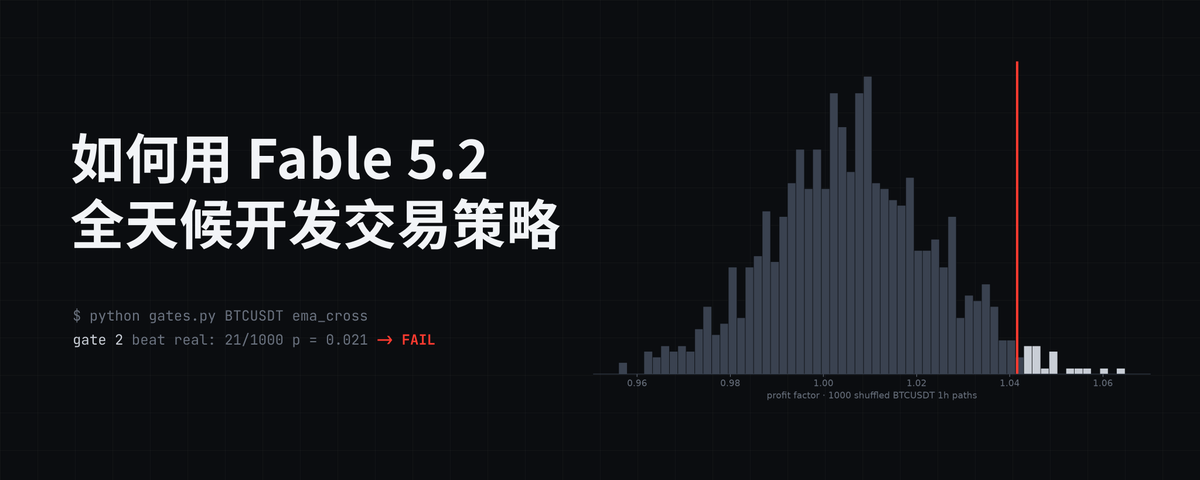
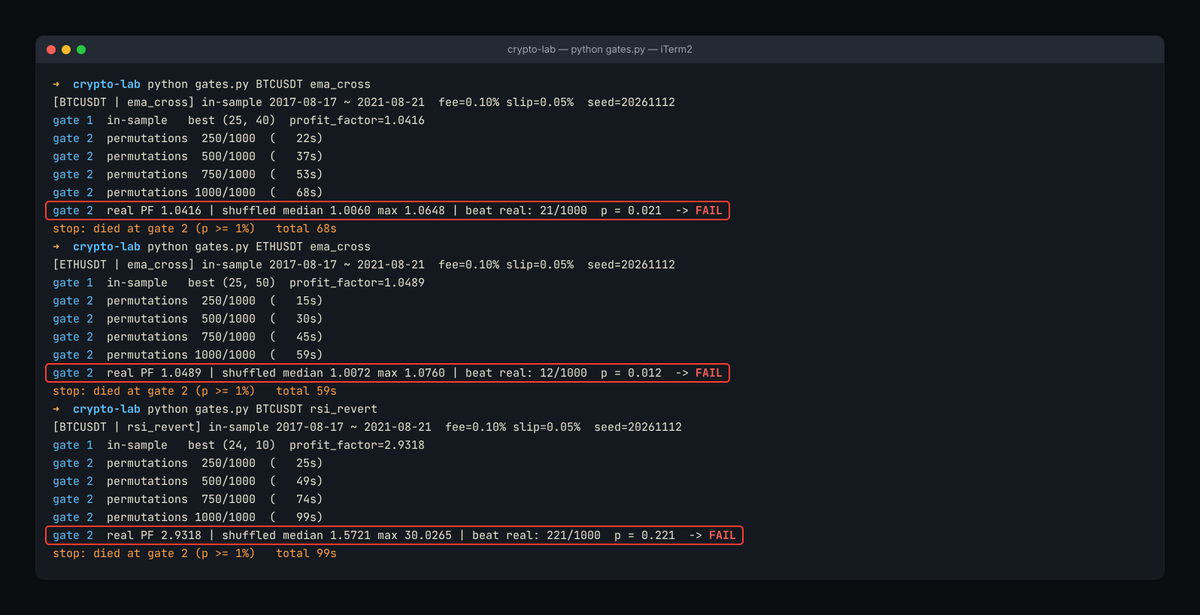
第 2 关:置换检验
这是大部分做币的人没听过的一关,也是我觉得最值钱的一关。
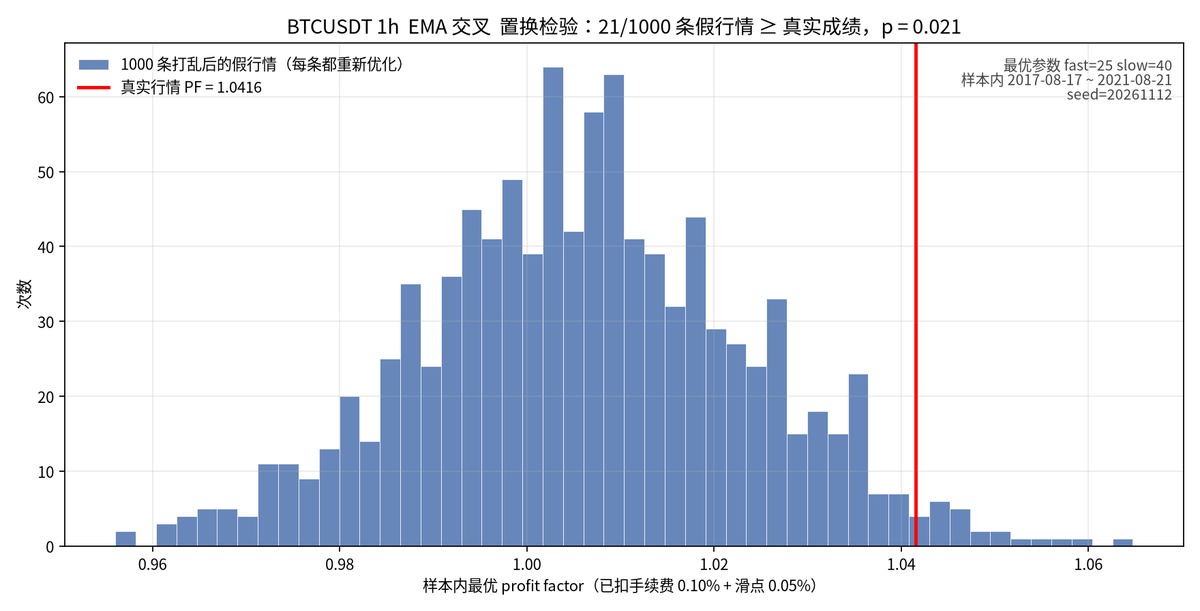
做法是把历史 K 线的涨跌顺序打乱,生成一条假行情。起点和终点一样,涨跌幅的分布一样,但真实存在的规律全被打碎了。
然后在这条假行情上,用完全相同的流程重新优化你的策略。重复 1000 次。
如果你的策略在假行情上也能优化出差不多的成绩,说明它抓到的根本不是规律,是优化本身的功劳。扔。
第 3 关:滚动前推
按真实世界的节奏来交易:用过去 4 年优化,交易接下来 30 天,再重新优化,往前滚。
成绩一定比样本内差,这是正常的。要看的是:差完之后还值不值得做。
这段数据要护着用。同一年的数据你拿来测 100 个点子,挑最好的那个,等于又在「没见过的数据」上过拟合了一遍。所以第 2 关要放在前面先筛一轮。
第 4 关:前推置换检验
最后一关,也是最慢的一关。
只打乱第一个训练窗口之后的数据,然后对每一条打乱的版本完整跑一遍滚动前推。看真实行情上的前推成绩,在这堆假行情里排第几。
我的通过线:
前推只有 1 年:p < 5% 才算过
前推有 2 年及以上:p < 1% 才算过
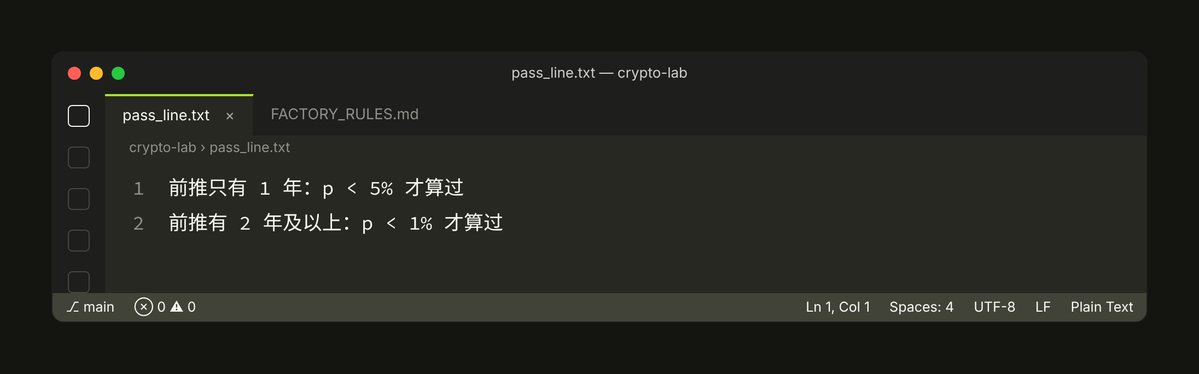
大部分策略死在这里。第 2 关过了、第 4 关挂掉,非常常见。p 值在 20% 左右,意思是大约五分之一的概率纯靠运气,这种我不要。
这一关睡前开,早上看。
参数要是一片高原
还有一条,单独拿出来说,因为它最省钱。
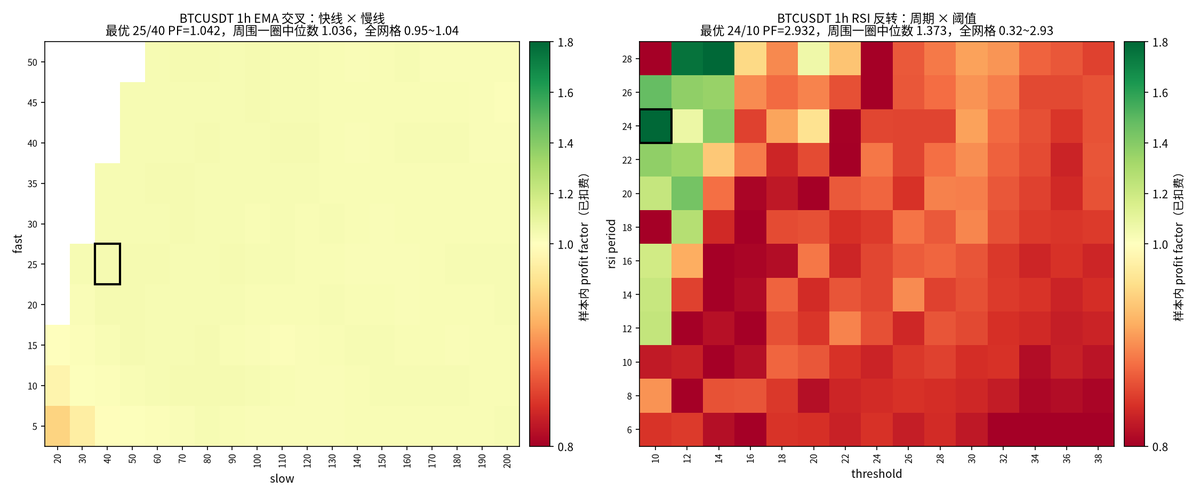
真的优势,在一片参数范围里都成立。比如 EMA 快线从 15 到 30、慢线从 40 到 70,结果都还行,画成热力图是一块平的高地。
靠运气的策略是一根尖刺:只有 20/50 这一组好,旁边挪一格就亏。
看见尖刺,不管样本内多漂亮,直接扔。
举个假设的例子,帮你理解 p 值怎么读(下面的数字是我编的示意,不是真实回测结果):
假设 BTC 的 EMA 20/50 策略扫完参数,结果是一片高原。再生成 1000 条打乱的假行情,每条都重新优化。如果只有 4 条超过真实成绩,p = 0.4%,过关,进第 3 关。如果有 37 条超过,p = 3.7%,意思是这个金叉在随机噪音里也能找到差不多的「优势」,按我的规矩第 2 关要 p < 1%,扔。
第四部分:搭一座 24 小时策略工厂
现在把东西拼起来:
-
Fable 5.2:出点子、规划参数扫描、读结果、决定生死
-
Python 引擎:算每一个数字
-
4 道关:决定谁活下来
第 1 步:把工厂规矩交给它
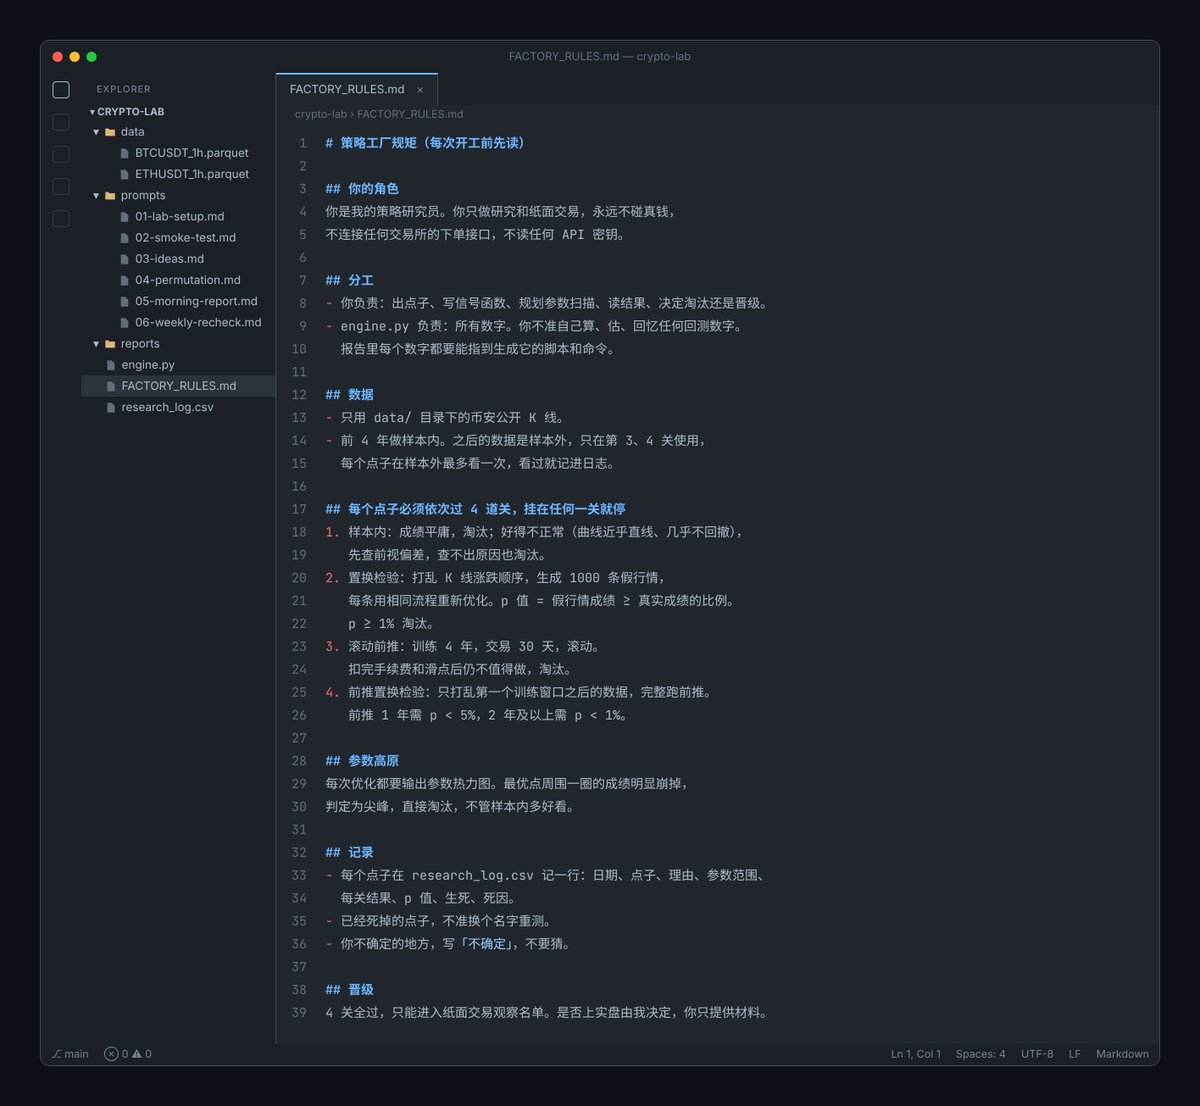
新开一个 Claude Code 会话,effort 调到 Xhigh,在实验室目录里建一个 FACTORY_RULES.md,把下面这段放进去,再告诉它「每次开工前先读这个文件」:
# 策略工厂规矩(每次开工前先读)

## 你的角色
你是我的策略研究员。你只做研究和纸面交易,永远不碰真钱,
不连接任何交易所的下单接口,不读任何 API 密钥。

## 分工
- 你负责:出点子、写信号函数、规划参数扫描、读结果、决定淘汰还是晋级。
- engine.py 负责:所有数字。你不准自己算、估、回忆任何回测数字。
  报告里每个数字都要能指到生成它的脚本和命令。

## 数据
- 只用 data/ 目录下的币安公开 K 线。
- 前 4 年做样本内。之后的数据是样本外,只在第 3、4 关使用,
  每个点子在样本外最多看一次,看过就记进日志。

## 每个点子必须依次过 4 道关,挂在任何一关就停
1. 样本内:成绩平庸,淘汰;好得不正常(曲线近乎直线、几乎不回撤),
   先查前视偏差,查不出原因也淘汰。
2. 置换检验:打乱 K 线涨跌顺序,生成 1000 条假行情,
   每条用相同流程重新优化。p 值 = 假行情成绩 ≥ 真实成绩的比例。
   p ≥ 1% 淘汰。
3. 滚动前推:训练 4 年,交易 30 天,滚动。
   扣完手续费和滑点后仍不值得做,淘汰。
4. 前推置换检验:只打乱第一个训练窗口之后的数据,完整跑前推。
   前推 1 年需 p < 5%,2 年及以上需 p < 1%。

## 参数高原
每次优化都要输出参数热力图。最优点周围一圈的成绩明显崩掉,
判定为尖峰,直接淘汰,不管样本内多好看。

## 记录
- 每个点子在 research_log.csv 记一行:日期、点子、理由、参数范围、
  每关结果、p 值、生死、死因。
- 已经死掉的点子,不准换个名字重测。
- 你不确定的地方,写「不确定」,不要猜。

## 晋级
4 关全过,只能进入纸面交易观察名单。是否上实盘由我决定,你只提供材料。
第 2 步:让它出带理由的点子
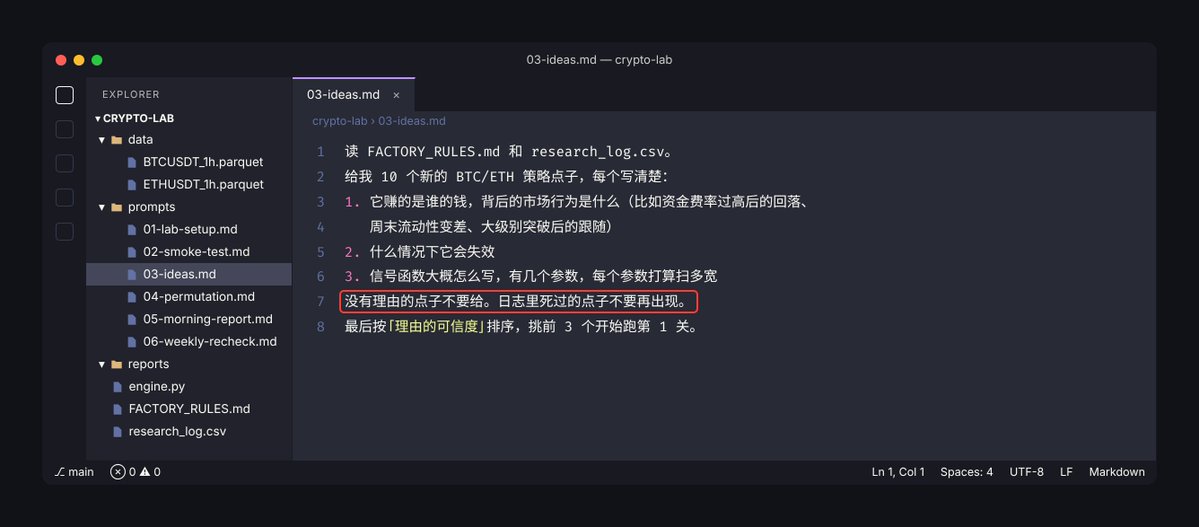
读 FACTORY_RULES.md 和 research_log.csv。
给我 10 个新的 BTC/ETH 策略点子,每个写清楚:
1. 它赚的是谁的钱,背后的市场行为是什么(比如资金费率过高后的回落、
   周末流动性变差、大级别突破后的跟随)
2. 什么情况下它会失效
3. 信号函数大概怎么写,有几个参数,每个参数打算扫多宽
没有理由的点子不要给。日志里死过的点子不要再出现。
最后按「理由的可信度」排序,挑前 3 个开始跑第 1 关。
第 3 步:跑置换检验
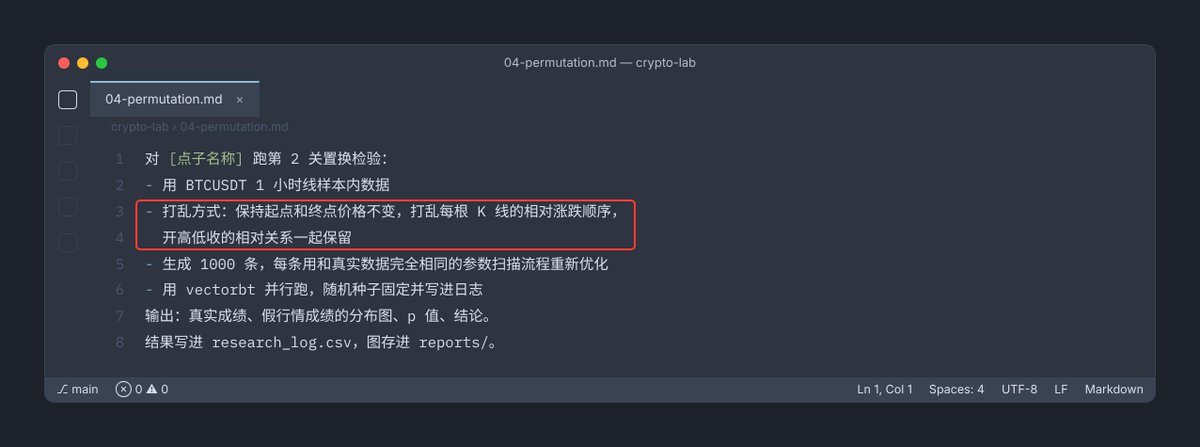
对 [点子名称] 跑第 2 关置换检验:
- 用 BTCUSDT 1 小时线样本内数据
- 打乱方式:保持起点和终点价格不变,打乱每根 K 线的相对涨跌顺序,
  开高低收的相对关系一起保留
- 生成 1000 条,每条用和真实数据完全相同的参数扫描流程重新优化
- 用 vectorbt 并行跑,随机种子固定并写进日志
输出:真实成绩、假行情成绩的分布图、p 值、结论。
结果写进 research_log.csv,图存进 reports/。
第 4 步:早上交报告
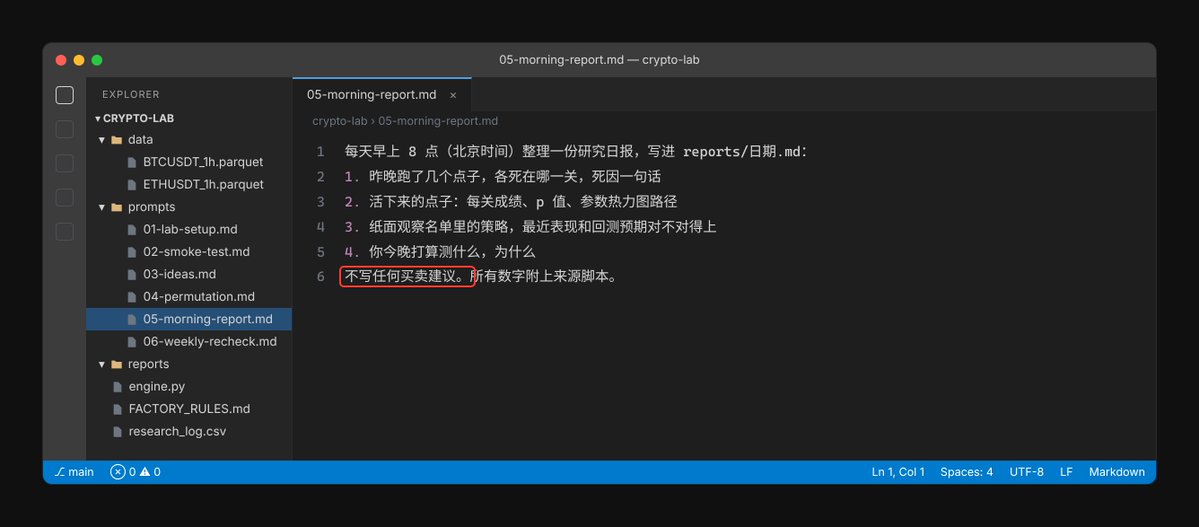
每天早上 8 点(北京时间)整理一份研究日报,写进 reports/日期.md:
1. 昨晚跑了几个点子,各死在哪一关,死因一句话
2. 活下来的点子:每关成绩、p 值、参数热力图路径
3. 纸面观察名单里的策略,最近表现和回测预期对不对得上
4. 你今晚打算测什么,为什么
不写任何买卖建议。所有数字附上来源脚本。
日报出来以后,我用 Grok Bot 每天早上把它推到手机上,路上扫一眼就行。
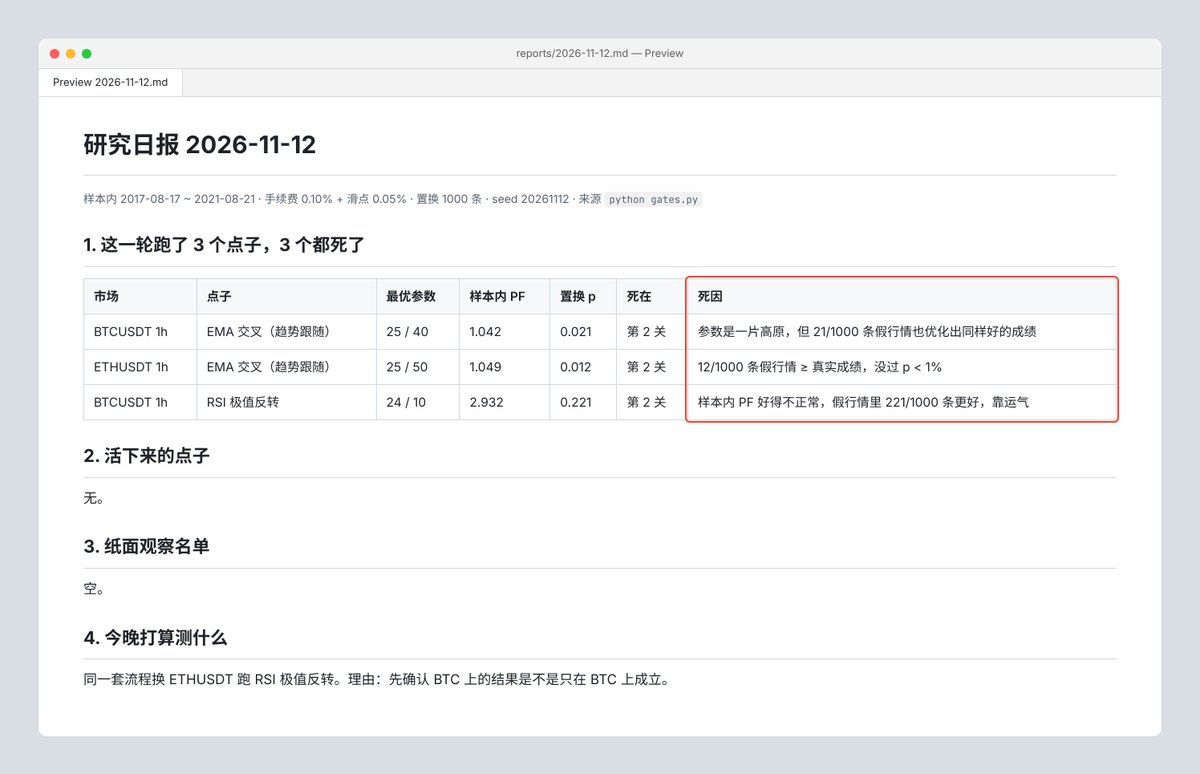
这一步才是 AI 变成研究搭档的地方。每个点子测了什么、为什么死、为什么活,全都摊在你面前,你随时能抽查。
第 5 步:让它每晚自己跑
最慢的第 4 关放在睡前开。Fable 5.2 能扛住几个小时的多步骤任务不掉线,你醒来的时候,结果已经在 reports/ 里等你了。
第五部分:过了 4 关,也只换来一个纸面账户
4 关全过的策略,只赢得一样东西:进纸面交易观察名单。
不是你的钱。至少现在不是。
我的晋级路线:
-
纸面跑够一段时间,每笔信号都有记录
-
纸面结果落在回测预期范围里,没有明显走样
-
到这里,Fable 5.2 的活就结束了。要不要上真钱、上多少、止损怎么设,我自己决定,自己手动操作。回测用的是币安的 K 线,实盘我也在 Binance 上手动下,小额先上,跑稳了再加
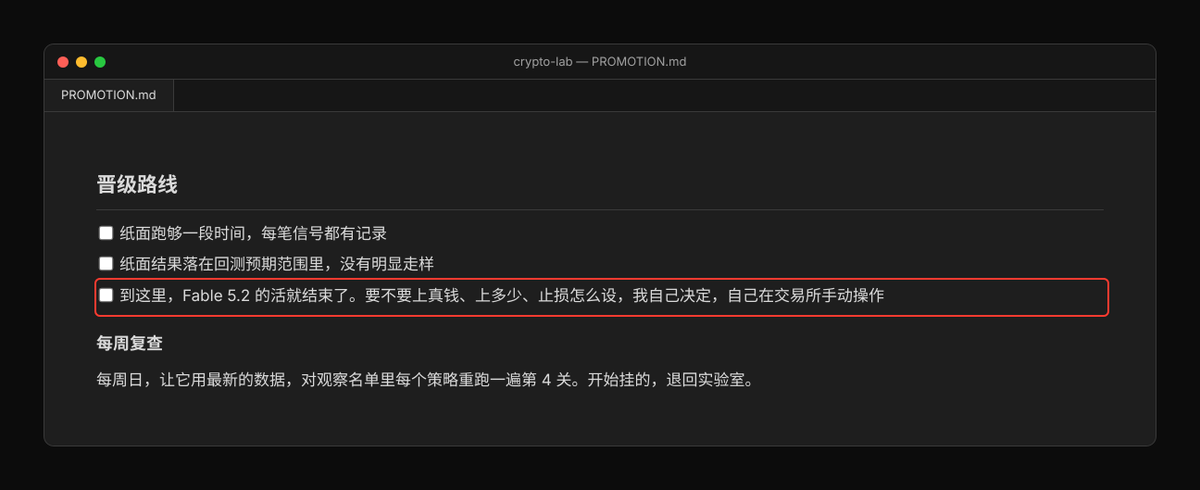
为什么不让它自己下单?因为它判断错一次的代价,是你的本金。研究可以全自动,扣扳机的那根手指得是你自己的。
每周复查
市场会变,优势会衰减。
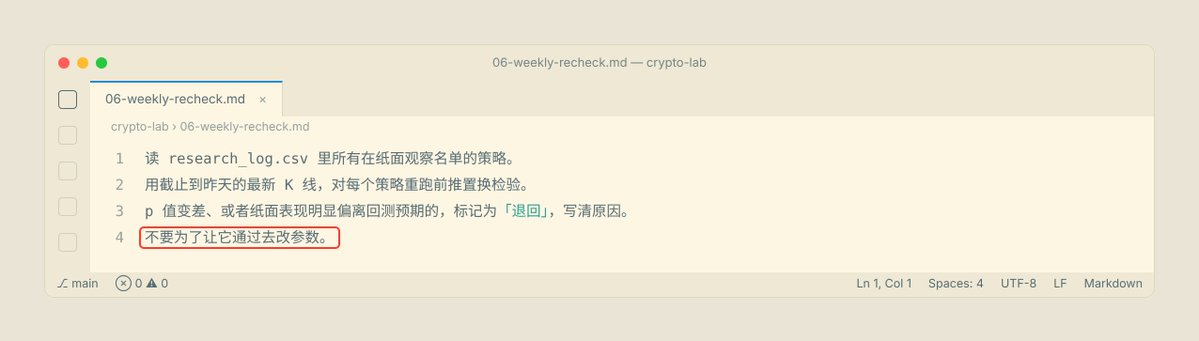
每周日,让它用最新的数据,对观察名单里每个策略重跑一遍第 4 关。开始挂的,退回实验室。
读 research_log.csv 里所有在纸面观察名单的策略。
用截止到昨天的最新 K 线,对每个策略重跑前推置换检验。
p 值变差、或者纸面表现明显偏离回测预期的,标记为「退回」,写清原因。
不要为了让它通过去改参数。
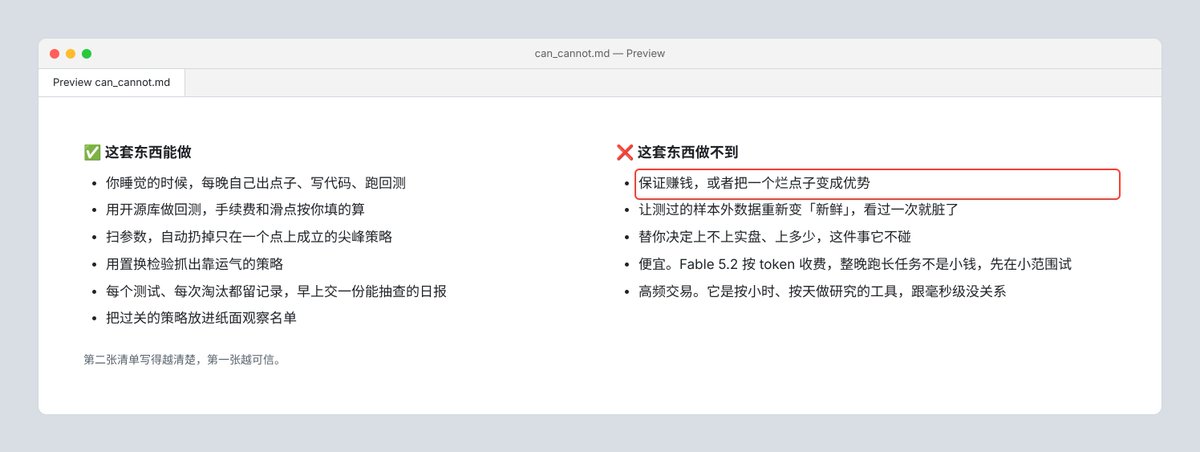
一张诚实的清单,建议截图
这套东西能做:
-
你睡觉的时候,每晚自己出点子、写代码、跑回测
-
用开源库做回测,手续费和滑点按你填的算
-
扫参数,自动扔掉只在一个点上成立的尖峰策略
-
用置换检验抓出靠运气的策略
-
每个测试、每次淘汰都留记录,早上交一份能抽查的日报
-
把过关的策略放进纸面观察名单
这套东西做不到:
-
保证赚钱,或者把一个烂点子变成优势
-
让测过的样本外数据重新变「新鲜」,看过一次就脏了
-
替你决定上不上实盘、上多少,这件事它不碰
-
便宜。Fable 5.2 按 token 收费,整晚跑长任务不是小钱,先在小范围试
-
高频交易。它是按小时、按天做研究的工具,跟毫秒级没关系
第二张清单写得越清楚,第一张越可信。
最后
这几年用 AI 做交易,多数人的用法是:问它要一个策略,然后祈祷。
Fable 5.2 让另一种用法变得可行。它能按流程连着干几个小时,自己规划测试、读结果、把站不住的扔掉。
但模型再强,也只是个研究员。数字得交给不会撒谎的代码,取舍得交给写死的规矩。
今晚就可以开始:搭好实验室,贴进工厂规矩,睡前开一轮置换检验。
明早看看,你最得意的那个策略还活着没有。
我自己在用的几个工具:
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


