
实测 MiniMax H3-Image 开源王炸:11.6秒直出原生 4K 大图,去磨砂人像与 Picture 隐藏改图语法全解
MiniMax 刚刚把 33.1B 参数的 MiniMax-H3-Image 正式开源了。简单说,它是把前阵子口碑炸裂的 MiniMax-H3 全模态基座砍掉音频分支,专门针对文生图和多参考图编辑做了 6 步蒸馏(无需 CFG 负面提示词),不用挂任何超分放大节点,直接原生出 1680 万像素(从 4096×4096 到 6272×2688) 的 4K+ 超清大图。
我在 Google Colab 云端开了一台 96GB 显存的 G4(NVIDIA RTX PRO 6000 Blackwell),把 ComfyUI 最新主干与 INT8 量化权重拉起来跑了两轮完整实测。跑下来的真实体感非常分裂:一方面,原生 1682 万像素(3552×4736) 直出真只要 11.59 秒,速度猛得不像 33B 大模型;但另一方面,如果你直接写 Python 无头脚本调节点,或者照搬以前玩 Flux 的提示词习惯,大概率会连踩三个大坑——VAE 解码瞬间飙到 94.23 GiB 爆显存、4K 人像满脸粗砂纸磨砂感、以及城市夜景莫名其妙跑成 3D 游戏建模。
这篇实测把我在 G4 上踩出来的排障补丁、两轮提示词 AB 对比和隐藏改图语法一次性摊开讲透。
1、零积分静默拉权重 + H3 编码器直接复用: 教你用免费 CPU 实例配合 16 线程分片预热云盘;如果你之前部署过 MiniMax-H3 视频模型,那颗 24.55 GiB 的 32B 视觉文本编码器(含社区 Heretic 去审查版) 可以原封不动直接复用,立省一半下载时间。
2、一行补丁干掉 94GB 假性爆显存: 揪出无头脚本调用 ComfyUI VAEDecode 解码 1680 万像素大图时吃光 96GB 显存的真凶,加一行装饰器直接把整套峰值显存焊死在 47.15 GB,48G 显存卡也能稳跑原生 4K。
3、100% 原生像素对比拆穿 4K 磨砂脸与 3D 假人真相: 用同题材前后对比证明,在 MiniMax-H3-Image 里照搬旧模型的「哑光微孔胶片词」和「赛博词」必翻车,附上实测最干净的中国真实人像与街拍提示词写法。
4、逆向提炼隐藏「Picture + Subject」免 Mask 改图语法: 从官方 MiniMax-H3-Image-PE 扩写器里扒出底层主语绑定句式,不用手涂任何遮罩,在 1682 万像素原图上直接锁脸换黑金刺绣旗袍、跨三张参考图合成茶室大片,这套逻辑通杀单图换装、电商换背景与多角色合拍,建议先点个「收藏 Bookmarks」备用。
一、架构拆解与云端 G4 部署实测:为什么 33B 模型跑 4K 只要 11 秒?
很多朋友看到官方原版 BF16 权重(主干 66.28 GB + 文本编码器 66.7 GB)第一反应是劝退。其实在 ComfyUI 里完全不需要硬扛 FP16/BF16 原版,直接上官方与社区配套的 INT8 ConvRot 量化黄金三件套,总磁盘体积不到 47 GB,画质肉眼几乎无损:
1、扩散主干(DiT 33.1B): 选用 Comfy-Org/MiniMax-H3-Image 仓库下的 minimax_h3_image_pruned_int8_convrot.safetensors(20.98 GB)。50 层单流 Transformer,通过 PDD 分步融合输出头蒸馏到了固定的 6 步采样(euler 采样器 + simple 调度器,cfg 设为 1.0),不需要算负面提示词,直接省掉一半推理计算量。
2、视觉文本编码器(Qwen3-VL 32B): MiniMax-H3-Image 直接读取 H3 编码器第 50 层的隐藏状态,权重与视频版 100% 通用。实测直接挂载社区去审查版 qwen3vl_32b_minimax_h3_ultra_uncensored_heretic_int8_convrot.safetensors(24.55 GB)完全兼容,不仅中英文长指令理解极准,高审美写真也不会触发莫名其妙的安全拦截。
3、图像解码器(MiniMaxH3ImageVAE): 选用 minimax_h3_image_vae_fp16.safetensors(1.17 GB)。这是它能秒出 4K 的核心秘密——采用 16 倍空间下采样配合 24 通道潜空间 与 24 层 2D ViT 解码器,DiT 再做 2×2 Patch 打包,相当于每个 Token 直接覆盖 32×32 像素。实测解码一张 1682 万像素 大图仅需 0.86 到 0.92 秒。
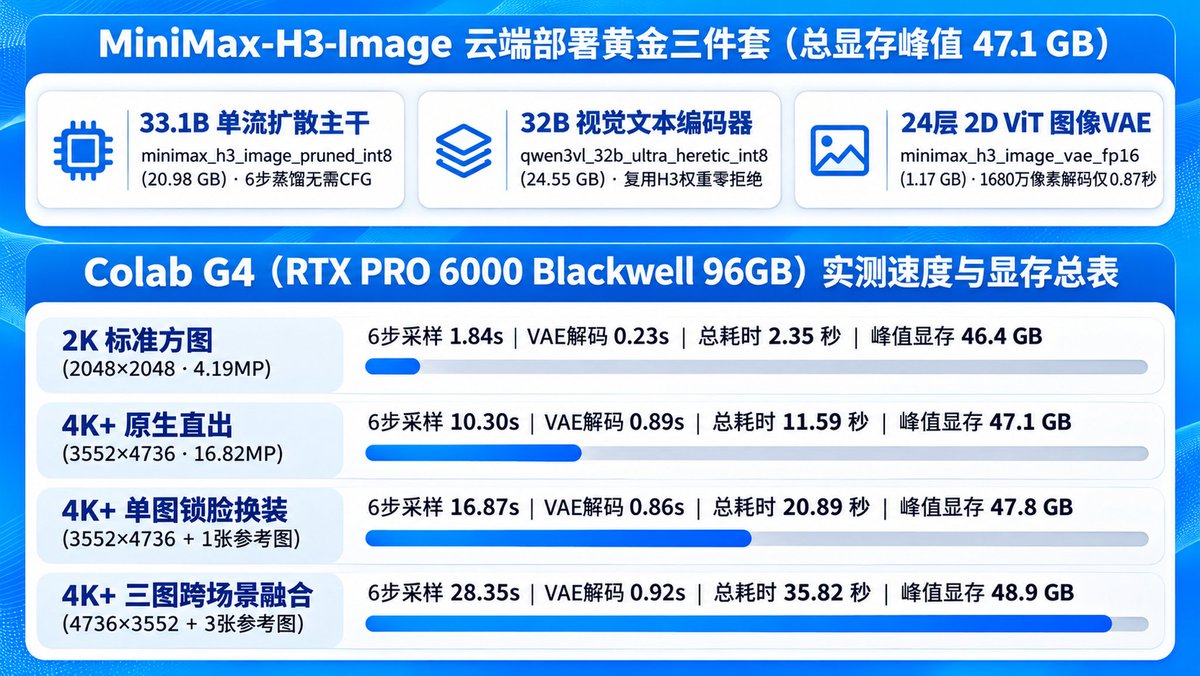
G4云端1680万像素实测数据与架构总表
在 Google Colab 云端部署这套环境时,有两个能帮你省下大把算力积分和排障时间的实操细节:
第 1 步:用免费 CPU 会话分片拉权重,装依赖切记去掉升级参数
千万别一上来就开 10.05 CCU/h 的 G4 显卡干等几十 GB 权重下载。先开一个 0 CCU/h 的免费 CPU 会话把模型持久化到 Google Drive;往实例本地 NVMe 盘拉取大文件时,用 16 线程 HTTP Range 并发写入临时后缀 「.part」 文件,全部下完再原子重命名为正式文件名,防止多进程误读半截空文件。另外在 Colab 克隆最新 ComfyUI 主干(注意默认分支是 master 而不是 main)安装依赖时,直接跑 pip install -q -r requirements.txt,千万别手痒加「-U」参数,否则它会把 Colab 预装好的 PyTorch 卸掉重装,白白烧掉好几分钟 GPU 计费时长。
第 2 步:无头脚本必加 inference_mode 装饰器,防住 94GB 爆显存惨案
如果你是通过 ComfyUI 网页端跑官方工作流,框架底层已经默认包了推理模式;但如果你像我一样用 Python 脚本直接调用 nodes.VAEDecode().decode(vae, samples) 批量跑图,第一张 1682 万像素图走到最后一步解码时,显存会瞬间从 46 GB 暴涨到 94.23 GiB 然后直接报 CUDA out of memory 崩掉。原因是在未关闭自动求导的情况下,PyTorch 会把 24 层 2D ViT 解码器在 1682 万像素上的中间激活图全部留在显存里。只需要在执行函数头顶加上一行 @torch.inference_mode(),VAE 解码的额外显存开销立刻从 48 GB 暴降到 1.49 GiB,整机峰值显存稳稳停在 47.15 GB。
二、4K 提示词两大翻车重灾区:为什么你的图有磨砂感或像 3D 游戏?
第一轮基准跑完后,我把原图放大到 100% 像素逐张检查,立刻发现了两个极其反直觉的现象:江南少女特写脸上有一层明显的粗砂纸颗粒感,而重庆洪崖洞夜景里的姑娘看起来像虚幻 5 渲染出来的 3D 国漫游戏角色。为了验证到底是模型天生缺陷还是提示词背锅,我固定相机焦段与场景做了第二轮控制变量重跑,答案一目了然。
1. 避坑一:彻底戒掉 Flux 时代的「防油光磨砂词」
以前玩 Flux 或视频模型时,为了压住 AI 常见的塑料油光脸,大家习惯在提示词里塞满 matte skin texture(哑光肤质)、fine pores(细微毛孔)、delicate peach fuzz(面部绒毛)、tiny microscopic raindrops(显微水珠) 以及 35mm Kodak Portra 400 film(胶片颗粒)。
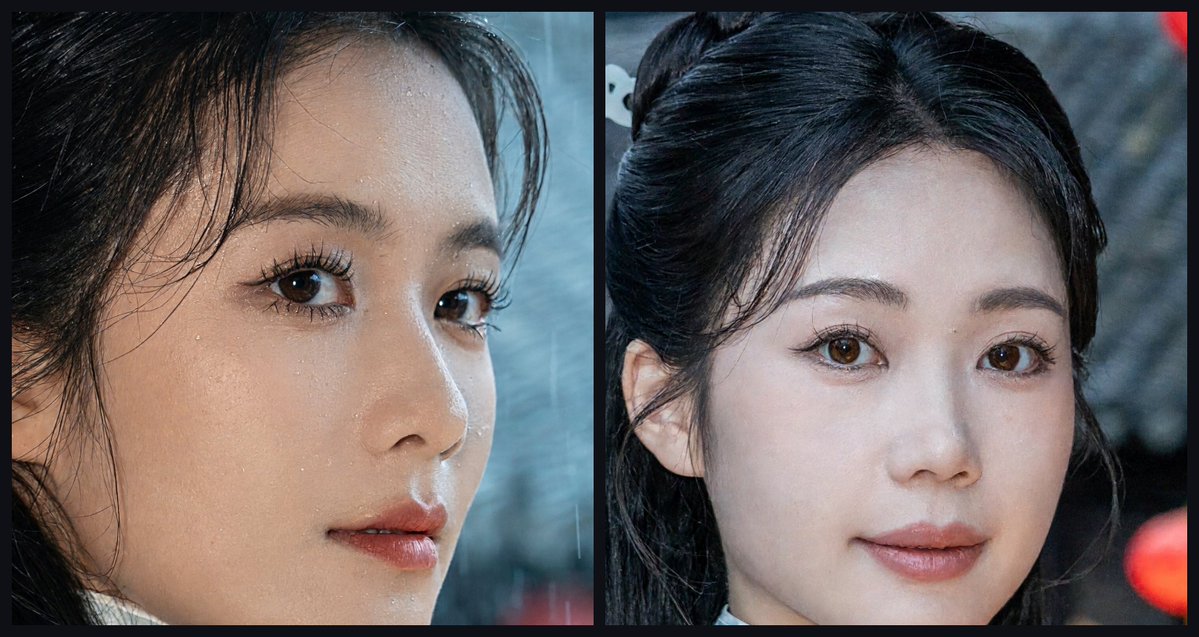
V1磨砂颗粒与V2通透真皮100%像素对比
看上面这张 100% 原生像素 1:1 同部位裁切对比图:左边就是塞了那堆「真实感强化词」的第一版,因为在 1682 万像素 分辨率配合 24 通道 2D ViT 解码器下,模型本身已经具备极强的原生高频细节还原力,再强行叠加哑光、微孔、胶片颗粒和微距水珠,高频通道就会严重过载,把皮肤渲染成粗砂纸磨砂感;右边是我把这些词全部删光、改写为 smooth fair skin, real-life portrait photograph, clean natural lighting 后的第二版,不需要任何后期磨皮,皮肤自带柔和通透的真实光学质感,睫毛与发丝根根分明。
2. 避坑二:拍中国城市实景人像,严禁混入「赛博科幻词」
再看重庆洪崖洞这张 5472×3072 超宽幅测试。第一版提示词里我顺手写了 futuristic cyber-oriental、CYBER CHONGQING 2088、holographic banner 和 neo-Chinese techwear jacket。
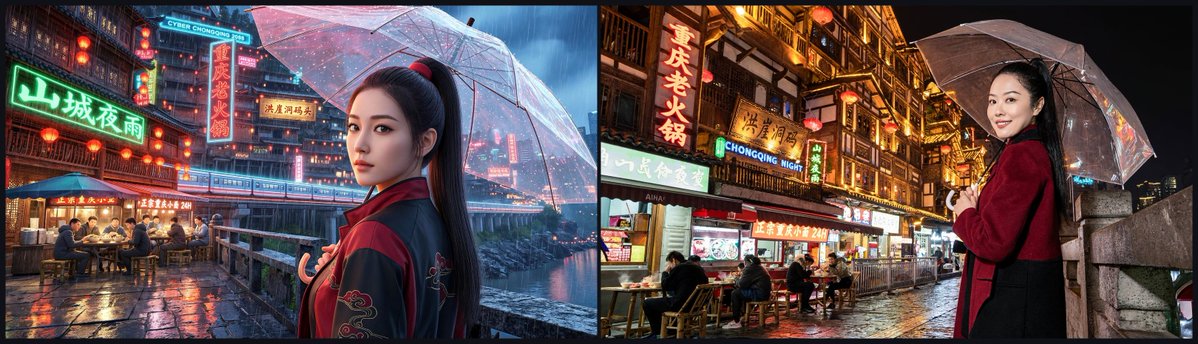
提示词避坑2-重庆洪崖洞V1赛博3D建模与V2真实街拍对比
结果如上图左侧所示:只要中国古建夜景同时撞上 cyber / 2088 / holographic / techwear 这几个词,32B 编码器就会自动把整张图的审美流形切进「3D 游戏 CG 概念原画」,人物五官和头发瞬间变成精致但一眼假的 3D 建模。而在右侧第二版里,我把科幻词彻底清零,改成 real-life documentary street photograph taken at Chongqing Hongyadong at night, captured on a Sony A7R V with a 35mm f/1.4 lens,前景撑透明伞回眸的中国姑娘和后方竹椅上吃面的食客立刻恢复了 100% 真实相机街拍质感。
三、四大文生图硬核实测:微距肤质、无审查写真、双语招牌与空间逻辑
摸清脾气之后,我们来看看 MiniMax-H3-Image 在纯文生图模式下的四项极限表现。以下所有测试人物均明确锚定纯正中国东亚面孔(Chinese young woman / East Asian face),全部在 G4 上以 6 步采样 原生直出。
1. Case 1:1682 万像素(3552×4736)江南庭院中国少女 + 100% 像素微距检阅
这张图重点测试 4K 竖幅人像的五官骨相与微观材质。左侧是完整的 3552×4736 原图缩略,右侧上下两格分别是原图橙框与青框位置的 100% 原生像素无损裁切(1720×1120):可以看到盘发里的碎发走向、白玉发簪的温润透光感、瞳孔里映出的暖色灯笼反光,以及立领宋锦暗纹都经得起放大镜检阅。
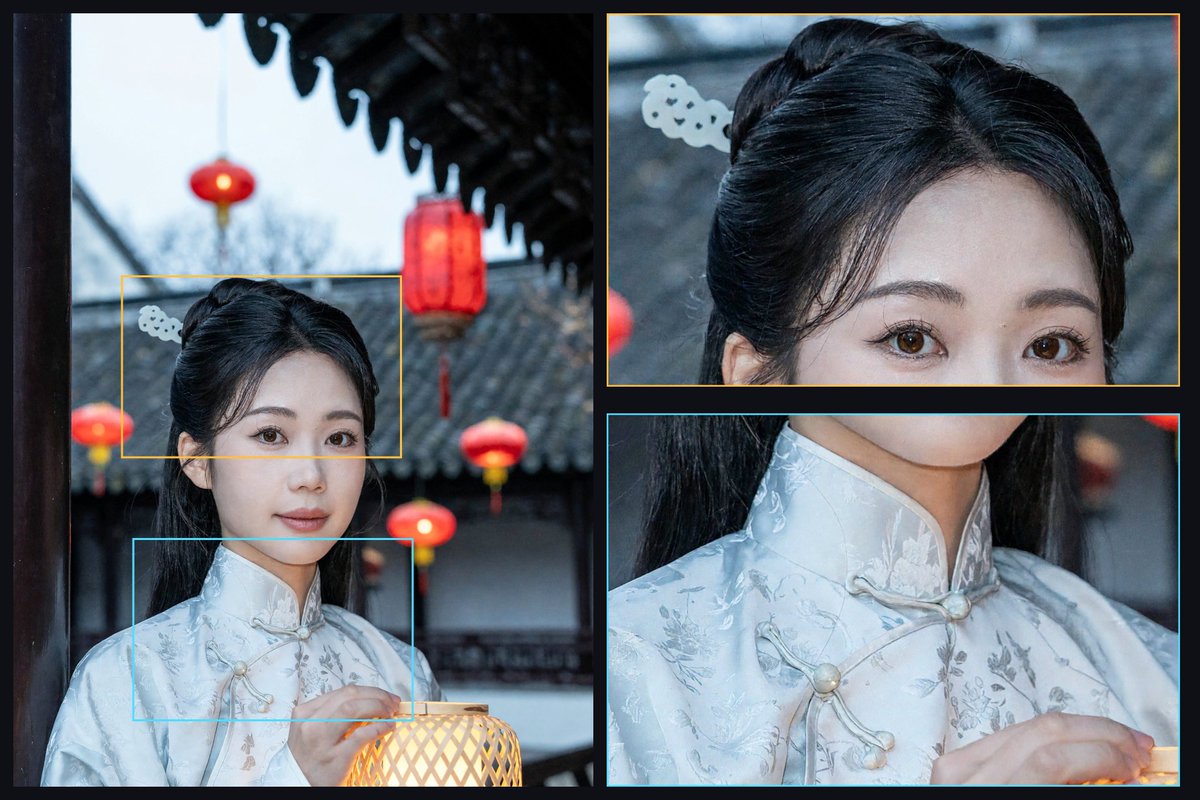
实测Case1-江南庭院中国少女1682万像素原图与100%放大板
可直接抄作业的纯净真皮人像英文提示词模板如下:
A high-resolution, real-life portrait photograph of an elegant 20-year-old Chinese young woman with a classic East Asian oval face, smooth fair skin, expressive dark brown almond eyes, and a serene, natural expression, standing beneath the carved wooden eaves of a traditional Suzhou courtyard at dusk. Her long, sleek black hair is styled in a graceful half-up bun secured with a carved white jade hairpin. She wears a pale moonlight-white silk Chinese stand-collar jacket with subtle woven floral patterns and holds a warm glowing bamboo paper lantern near her chest. Behind her, soft out-of-focus red lanterns and grey tiled roofs glow warmly in the evening twilight, captured on a Canon EOS R5 with an 85mm f/1.4 lens, clean natural lighting, and shallow depth of field.
2. Case 2:Heretic 32B 无审查编码器实测,11.59 秒直出 1688 万像素(3360×5024)午后丝绸写真
很多开源大图模型一碰到蕾丝、真丝睡袍或大面积露肩锁骨提示词就会触发安全过滤(或者强行给你裹得严严实实)。得益于前文提到的社区 Heretic Uncensored 32B 编码器无缝兼容,这张 3360×5024 的午后百叶窗暖光私房写真从编码、6 步采样(10.30 秒)到解码(0.89 秒)一气呵成,总耗时仅 11.59 秒。酒红真丝滑落肩头的垂坠褶皱、黑色蕾丝花边细节与暖阳漫反射下的自然肤质都非常在线。
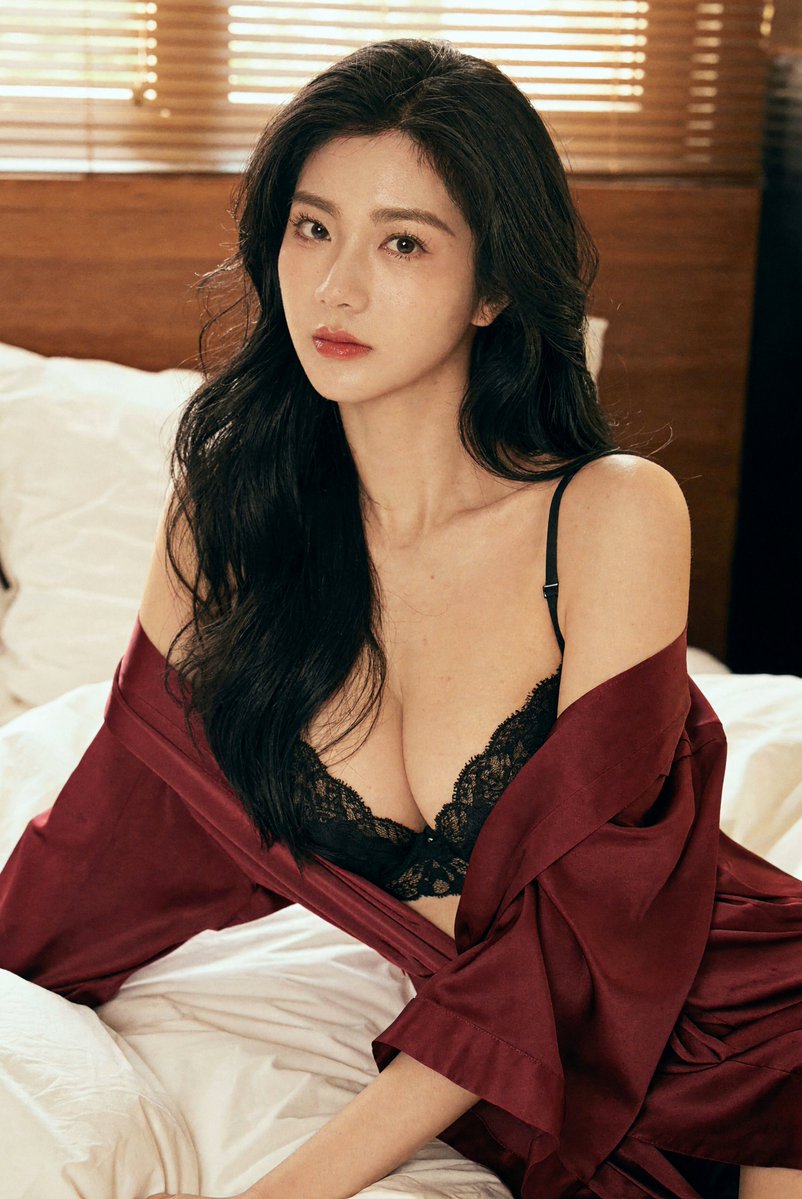
实测Case2-Heretic无审查32B编码器午后丝绸写真1688万像素
3. Case 3:1681 万像素(5472×3072)重庆洪崖洞夜景纪实与中英双语招牌
过去开源生图模型最怕在复杂夜景里写汉字,稍微远一点的店铺招牌就会糊成鬼画符。在这张 5472×3072 超宽画幅实景图(总耗时 11.85 秒)里,我们一次性塞进了多块中英双语招牌和密集人群:左上方竖排红霓虹 「重庆老火锅」、屋檐下金字木匾 「洪崖洞码头」、蓝色霓虹灯带 「CHONGQING NIGHT」、绿色竖招 「山城夜雨」,以及街边摊红底白字的 「正宗重庆小面 24H」 笔画全部清晰工整,连雨夜青石板路上的暖光倒影和竹凳食客碗里的热气都交代得明明白白。
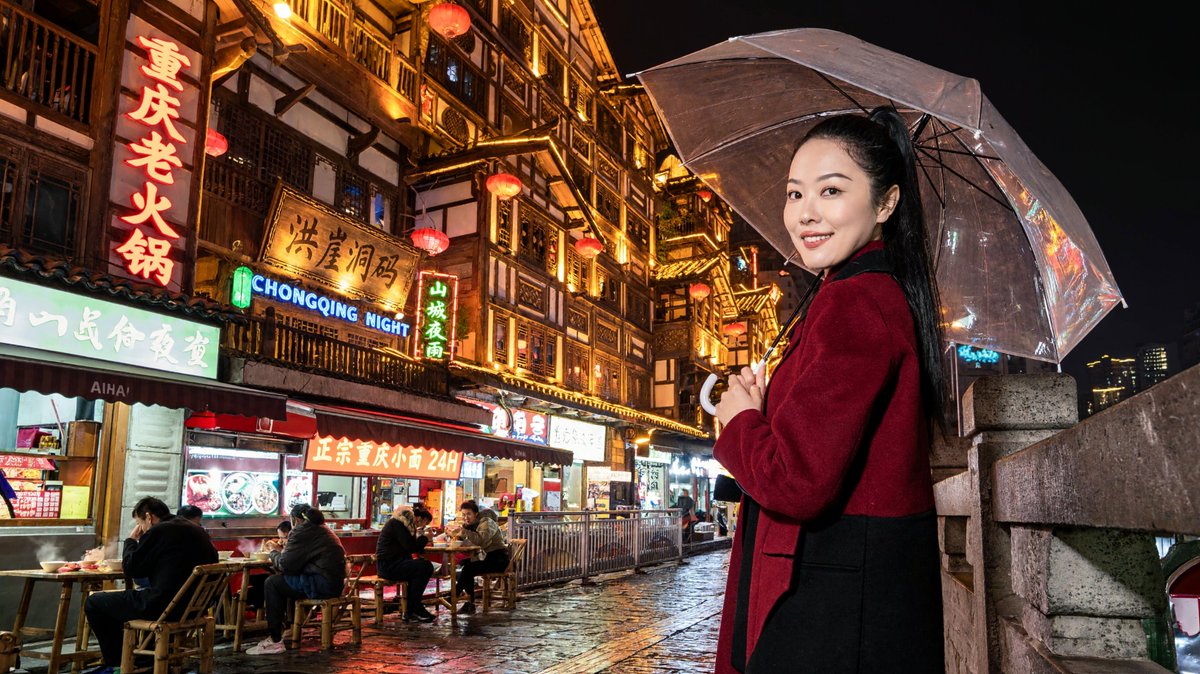
4. Case 4:1682 万像素(4736×3552)多主体空间逻辑与排版(国宝玉玺失窃案线索板)
官方推文里最让人印象深刻的是它的多元素视觉逻辑编排能力,这里我专门设计了一张中文语境升级版测试——「国宝玉玺失窃案」刑侦软木线索板(分辨率 4736×3552,总耗时 11.85 秒)。
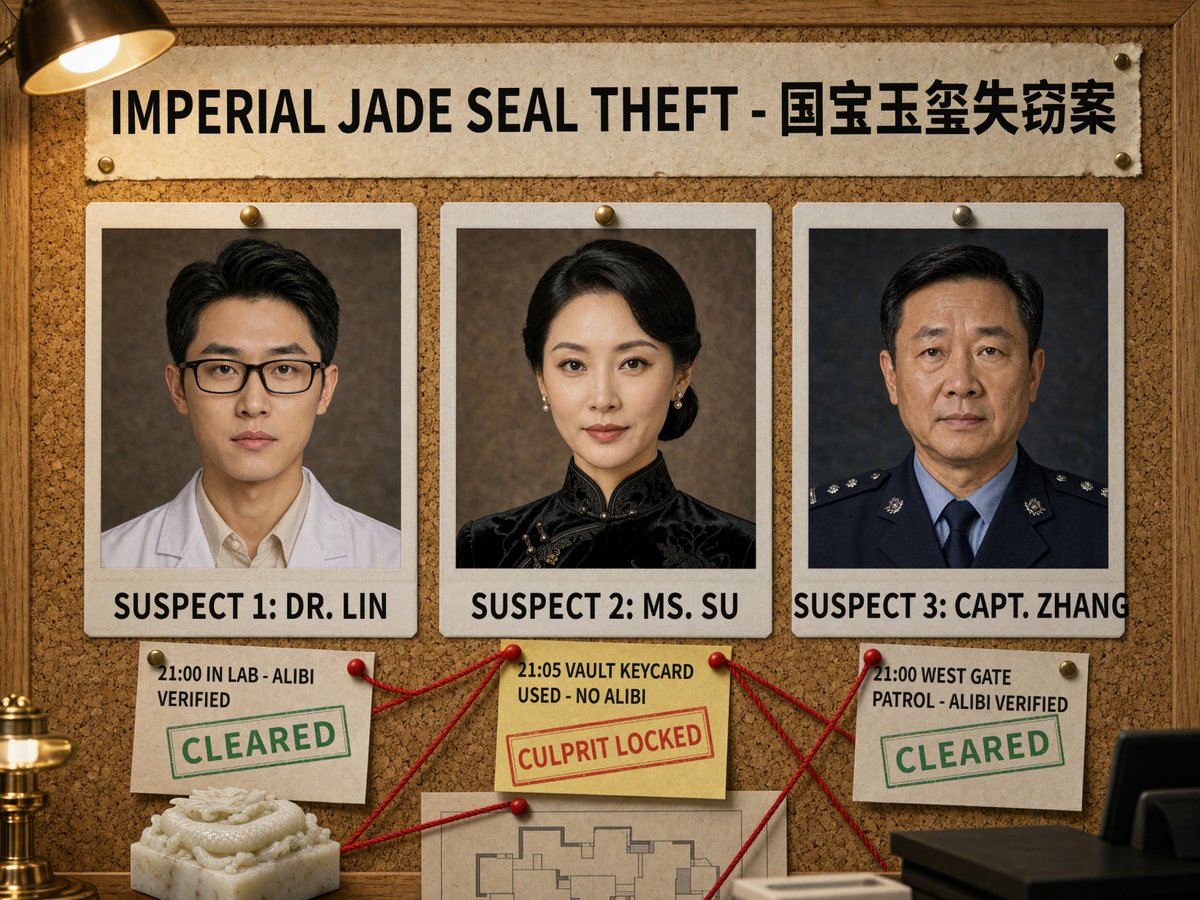
实测Case4-国宝玉玺失窃案刑侦线索板1682万像素空间逻辑
你可以放大看图里的空间对应关系:顶部横幅精准印着中英双语标题 「IMPERIAL JADE SEAL THEFT - 国宝玉玺失窃案」;下方按左中右严格排列三位中国面孔嫌疑人宝丽来照片——左边戴眼镜穿白大褂的 「SUSPECT 1: DR. LIN」 下方贴着不在场证明便签并盖上绿色 「CLEARED」 印章,中间穿黑丝绒立领旗袍的 「SUSPECT 2: MS. SU」 下方黄便签写明 「21:05 VAULT KEYCARD USED - NO ALIBI」 并精准盖上红色 「CULPRIT LOCKED」 锁定真凶印章,右边穿制服的 「SUSPECT 3: CAPT. ZHANG」 同样核验通过盖上绿色 「CLEARED」;左下角桌面上还摆着白玉盘龙玺证物、黄铜台灯和底部建筑平面图,红色毛线严格缠绕在各个图钉之间,没有任何悬空断线或文字串位。
四、隐藏王牌揭秘:逆向 Picture + Subject 语法,免涂 Mask 玩转 4K 换装与三图融合
如果只把 MiniMax-H3-Image 当普通文生图模型用,其实只发挥了它一半的功力。它是把「文生图」与「最高 16 张参考图编辑」统一在同一个权重里的原生多模态模型。但官方基础文档并没有细讲编辑提示词该怎么写才能不崩脸,我直接去翻了配套提示词扩写模型 MiniMax-H3-Image-PE 的输出规律,逆向总结出这套最好用的 「Picture + Subject 三段式主语绑定语法」:
1、第一段(绑定锚点): 把输入参考图 \<Picture 1\>、\<Picture 2\> 里的关键元素逐个定义为编号主语,比如人物是 \<Subject 1\>、身上原来的衣服是 \<Subject 2\>、手里的灯笼是 \<Subject 3\>、庭院背景是 \<Subject 4\>。
2、第二段(一句话定全局): 描述目标成图里 \<Subject 1\> 在什么环境、穿什么新衣服、拿什么新道具。
3、第三段(精确声明保留度): 完全不动的部分直接写一句 \<Subject 4\> is fully preserved.;需要锁脸换装的人物写 \<Subject 1\> is partially preserved; her exact facial features... remain completely unchanged, while \<Subject 2\> is replaced by...。
靠这套结构化指令,在 ComfyUI 里用 MiniMaxH3ImageConditioning(或者链式串联 ReferenceLatent 节点)就能彻底告别手涂局部重绘蒙版:
1. Case 5:1682 万像素单图无 Mask 锁脸换装(耗时 20.89 秒,峰值显存 47.84 GB)
直接把前面 Case 1 生成的 3552×4736 江南少女原图作为 \<Picture 1\> 喂进去,不画一笔遮罩,要求保持五官、盘发、白玉发簪与庭院红灯笼背景不变,把月白立领上衣换成 黑金凤凰刺绣真丝旗袍、加上 帝王绿翡翠耳坠、把手里竹灯笼换成 撒金油纸伞
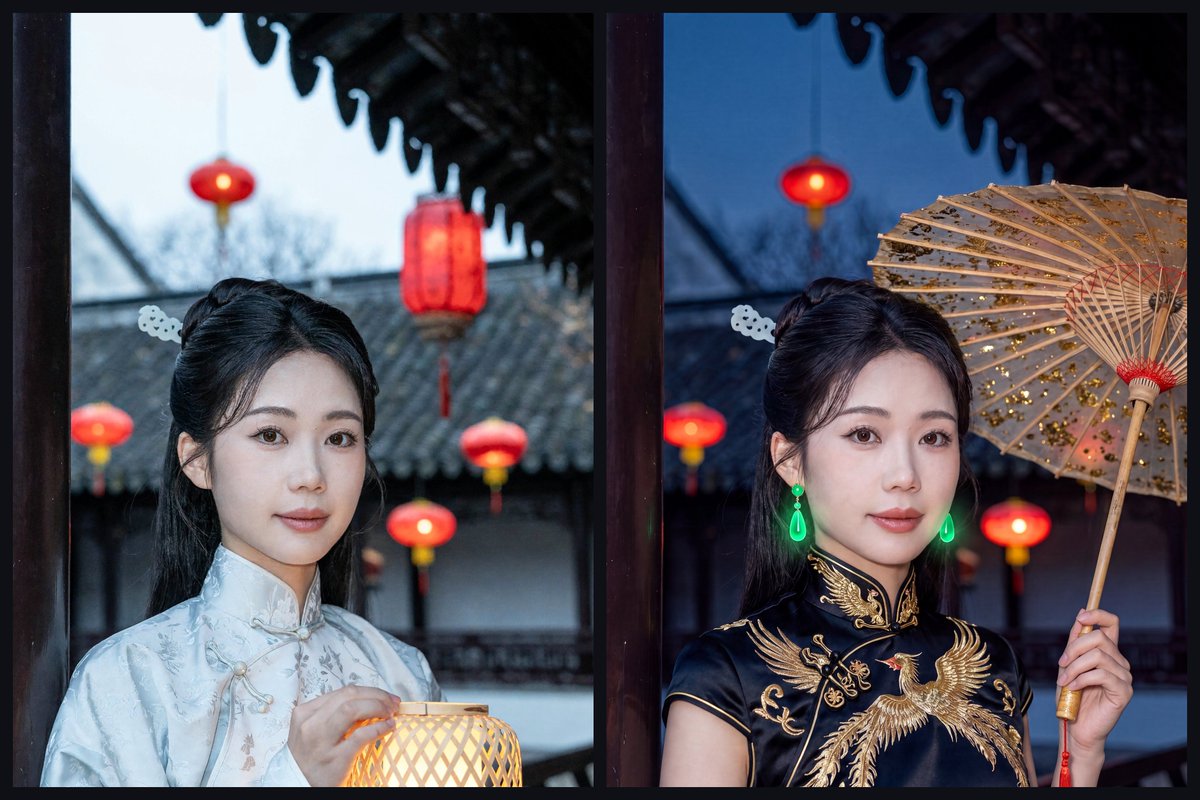
实测Case5-单图无Mask锁脸换黑金刺绣旗袍前后对比
对比左右两张图:人物的脸型、眉眼间距、唇形甚至头顶那支白玉发簪的镂空孔位都实现了像素级锁死,而新换上的黑金旗袍领口刺绣和右手握伞的手指姿态又完全自然贴合。可直接套用的换装指令模板如下:
The young Chinese woman in \<Picture 1\> is \<Subject 1\>. The moonlight-white silk jacket worn by \<Subject 1\> in \<Picture 1\> is \<Subject 2\>. The hand-held bamboo paper lantern in \<Picture 1\> is \<Subject 3\>. The Suzhou courtyard eaves and glowing red-lantern background in \<Picture 1\> is \<Subject 4\>. The target image shows \<Subject 1\> wearing a luxurious black-and-gold embroidered royal silk qipao and imperial emerald jadeite earrings while holding a translucent gold-flecked oil-paper umbrella in \<Subject 4\>. \<Subject 1\> is partially preserved; her exact Chinese East Asian facial features, oval face, smooth fair skin, serene gaze, and half-up black hairstyle with the white jade hairpin remain completely unchanged, while \<Subject 2\> is replaced by a tailored black silk modern qipao with a high mandarin collar and gold phoenix embroidery across the chest, plus a pair of glowing imperial green jadeite teardrop earrings. \<Subject 3\> is replaced by a traditional bamboo-ribbed translucent paper umbrella dusted with gold leaf held gracefully near her shoulder. \<Subject 4\> is fully preserved.
2. Case 6:1682 万像素三图跨场景融合(耗时 35.82 秒,峰值显存 48.85 GB)
最后拉满难度,同时喂入 3 张完全独立的参考图 合成一张 4736×3552 大图:左上角 \<Picture 1\> 提供江南少女主角,上方中间 \<Picture 2\> 提供一只手工羊毛毡小熊猫玩偶与青花龙纹茶壶茶盏(2048×2048 直出仅花 2.36 秒),右上角 \<Picture 3\> 提供空无一人的苏州月亮门阳光茶室(2048×2048 直出仅 2.35 秒)。
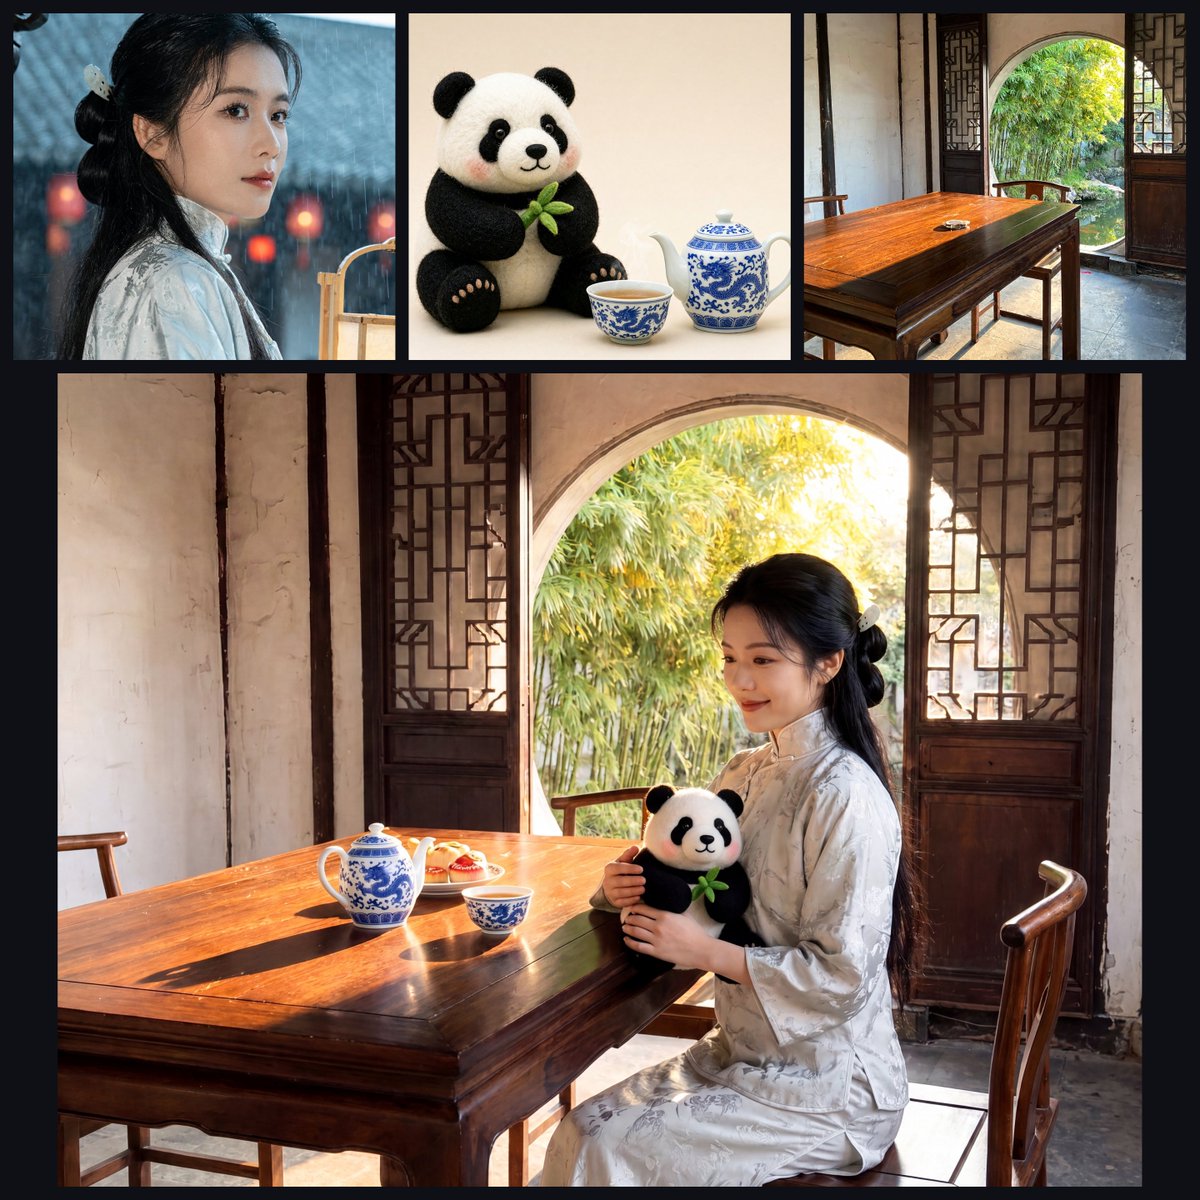
实测Case6-三图跨场景融合少女熊猫茶室1682万像素展板
看上方合成后的 1682 万像素大图:模型不仅把三张图里的人物长相、羊毛毡熊猫手中的竹叶、桌上的青花龙纹壶盏和茶室月亮门竹影严丝合缝地拼进了同一个三维透视空间,更绝的是它自动重算了全局光影——原本在阴雨天冷光下的少女,坐进茶室后侧脸与丝绸衣袖自动染上了午后暖阳的漫反射金边,毫无抠图硬贴的违和感。
五、算力账单与实测总结:这模型值不值得立刻装进主力工作流?
最后算一笔实在的云端算力账:这次第二轮在 Google Colab G4(10.05 CCU/h) 上跑完模型加载加 4 组 1680 万像素超清生图与改图,实例从开机到自动销毁总计运行 6 分 1 秒,实际只扣了 1.01 个计算单元(CCU)。换算下来,平时攒好提示词批量开机跑图,平均每张原生 4K+ 大图的算力成本连几美分都不到。
如果你的日常需求涉及 4K 级商业人像海报、带中文招牌的实景视觉设计、高密度信息展板,或者需要保持角色长相一致的连续换装与多商品合拍,MiniMax-H3-Image 目前在开源界几乎没有同生态位的对手——既有 6 步蒸馏带来的 11 秒极速,又省去了传统工作流里「先出 1K 小图再挂 Tile 放大重绘」容易引发的五官崩坏。只要记住前面两条铁律:写脚本加上 inference_mode 防爆显存,写 4K 人像提示词删掉旧时代的磨砂胶片词,就能直接跑出最顶的成片质感。
如果你觉得这篇干货帮你省下了真金白银的算力积分和排障时间,欢迎点个「关注 + 转推 + 收藏 Bookmarks」!
刚建了个微信群,叫「赛博领鸡蛋🥚」 找些同样爱折腾 AI 的朋友,一起聊工具玩法、订阅优惠,也互相交流实测经验和踩过的坑。 群刚起步,欢迎来做第一批群友。扫下方二维码,一起折腾,少花点冤枉钱👇
附录:本文涉及的官方网址与核心参考资源汇总
为了方便大家在实操部署时一键直达,这里把本文全流程用到的官方入口、量化权重与参考文档整理如下:
一、官方发布与在线体验入口
1、MiniMax 官方发布推文原帖: https://x.com/MiniMax_AI/status/2120179737695826420
2、MiniMax-H3-Image 官方原版模型库(BF16): https://huggingface.co/MiniMaxAI/MiniMax-H3-Image
3、MiniMax-H3-Image-PE 官方提示词扩写模型: https://huggingface.co/MiniMaxAI/MiniMax-H3-Image-PE
4、海螺 AI 官方在线体验入口: https://hailuoai.com/
二、ComfyUI 部署黄金三件套权重与教程
1、ComfyUI 官方 INT8 量化主干与图像 VAE 仓库: https://huggingface.co/Comfy-Org/MiniMax-H3-Image
2、社区 Heretic 32B 去审查版 INT8 视觉文本编码器: https://huggingface.co/OTMFLY/Qwen3-VL-32B-Ultra-Heretic-MiniMax-H3-ComfyUI-INT8-ConvRot
3、ComfyUI 官方 MiniMax-H3-Image 图文与改图工作流教程: https://docs.comfy.org/tutorials/image/minimax/minimax-h3-image
4、ComfyUI 官方 GitHub 主干仓库(需更新至最新 master): https://github.com/comfyanonymous/ComfyUI
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


