
首次公开!Claude 记忆的组成部分和架构
文章目录
原文标题:The components of agent memory 原文链接:Anthropic 发布日期:2026 年 11 月 6 日 团队:工程团队(Engineering) 主题:智能体、上下文工程、智能体记忆 翻译整理日期:2026 年 11 月 11 日 译者:刘老板 形式:AI 翻译 & 全文人工校准
中文摘要
智能体记忆是跨会话保留、可供后续读取的经验信息。文章区分了原始记录、记忆笔记、知识组织形式和自动载入上下文,并介绍用空闲时间回顾记录、整理记忆的“梦境整理”(dreaming)。
有效记忆需要筛选和验证,而非保存一切。错误或过时的笔记会误导后续行动;回查原始记录有助于纠正它们。知识库可辅助跨文档推理,但也可能膨胀、重复或丢失重要信息,不能简单代替检索。
记忆设计需要权衡准确性、即时可用性与维护成本:自动载入的内容应精简,重要结论应能追溯来源,整理方式应围绕实际任务调整。
正文
索伦·克尔凯郭尔曾写道:生活只能回头理解,却必须向前走。我们在为 AI 智能体设计记忆时,也遇到了类似的困境。
人类在日常生活中不断将经历编码为记忆。海马体在这个过程中发挥着核心作用:它即时捕捉经历,使记忆得以迅速形成,并能立即调用。但只有一部分经历会被巩固为长期知识。
这种巩固过程似乎有很大一部分发生在大脑“离线”时。在睡眠和安静休息期间,海马体会重放近期的经历。人们认为,这一过程会逐步提炼这些经历,并将它们整合到新皮层中——我们通常所说的知识,大部分就存储在大脑的这一区域。
智能体记忆也可以采用类似的分工。智能体的大量工作会留存在日志或会话记录中。Letta 和加州大学伯克利分校的研究人员提出了睡眠时间计算(sleep-time compute),让模型利用交互之间的空闲时间重新组织已有上下文。同样的思路也能帮助智能体整理记忆:回顾日志,纠正错误,或者生成新的笔记和记忆表征。这一过程通常被称为梦境整理(dreaming)(图 1)。
我们发现,梦境整理是帮助 Claude 获得有效记忆的一种有用工具。本文将分享我们对智能体记忆的理解,并介绍几项用于探索智能体记忆的评估,其中包括梦境整理的应用,以及各个组成部分对记忆组织的贡献。
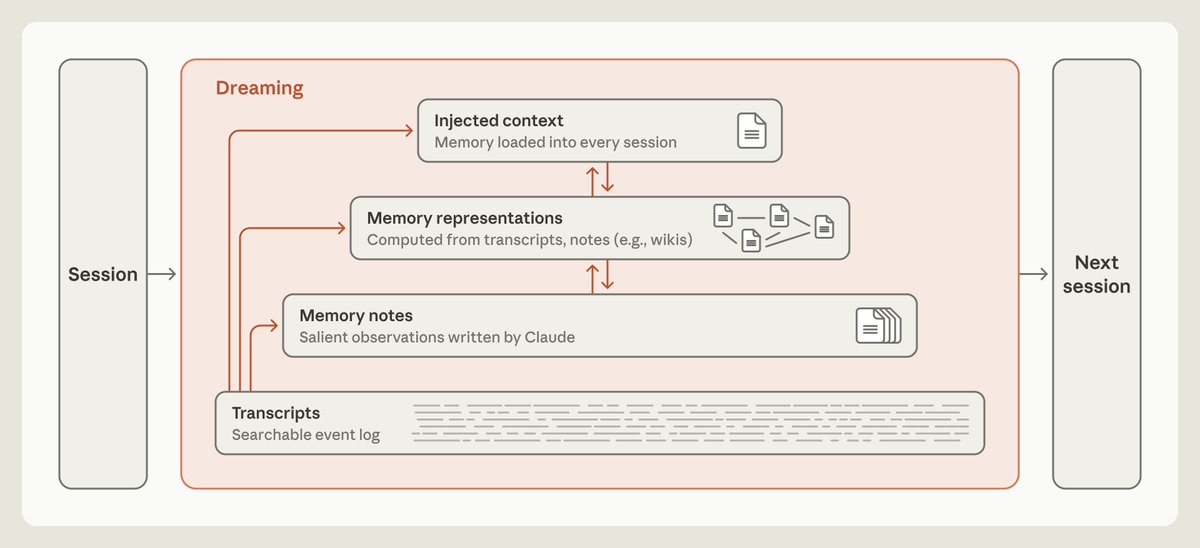
图 1:Claude 可以通过梦境整理来组织记忆,包括纠正错误、创建笔记、构建新的记忆表征,以及决定哪些内容应预先载入未来的会话。
记忆笔记
我们所说的“智能体记忆”,是指 Claude 从经验中获得的知识,包括与用户的互动以及被分配的任务,并以日后可读取的上下文形式跨会话保存下来。它不包括模型学习或管理上下文的其他方式,例如改变权重(训练期间设定的内部参数)、上下文学习(在单次对话中获得知识),以及上下文压缩(由 Claude 编写摘要,替代较早的对话轮次,使其能在新的上下文窗口中继续工作)。
在人脑中,一段经历发生之前、期间或之后释放的化学信号,可以把某段记忆标记为重要。大脑离线时,被标记的记忆通常比未被标记的记忆更频繁地得到重放。这一过程称为“重放”,有助于使记忆稳定下来,并将其整合进长期记忆。
类似地,Claude 可以在重要事件发生时就在会话日志中做标记,方便日后查找;也可以将它们写入记忆存储,例如一个存放记忆笔记的文件夹(图 2)。但在还不知道接下来会发生什么的时候,Claude 怎么判断眼下哪些事情重要呢?
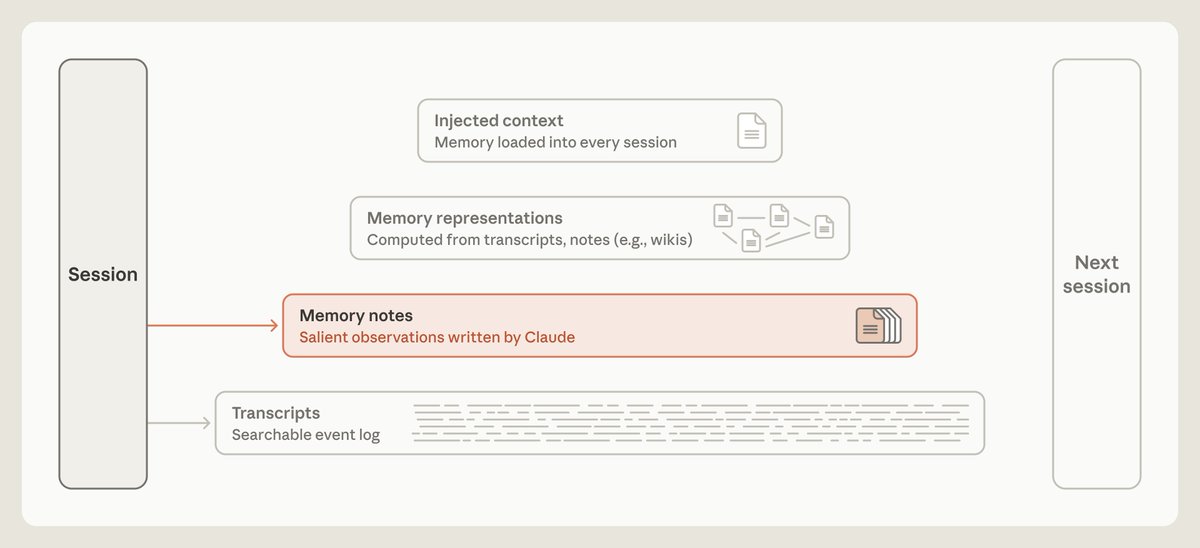
图 2:Claude 可以把笔记写入记忆。
记忆可以是对未来需求的预测
记忆有时是一种预测。智能体写下一条规则,就是在预测这条规则所描述的模式还会再次用得上。例如,写下一项经过验证的事实,就是预测未来某次会话中的智能体会希望直接依据这一事实,而不必再次核查。随着时间推移,Claude 越来越擅长做这类预测。
以持续学习基准(Continual Learning Bench,CL-Bench)1.0中的一项任务为例。这项基准衡量智能体利用记忆处理长程任务的能力。其中一项任务要求 Claude 查询数据库中的信息,回答一系列问题。Claude 每次作答后,都会获知正确答案,并可以写下一条记忆,帮助回答后续问题。
记忆在这里可以支撑一个学习循环。如果 Claude 答错了一道题,它可以记录失败,提出关于出错原因的假设,检验这些假设,再把发现转化为指导今后作答的规则。
我们使用 Claude Managed Agents运行了这项 CL-Bench 1.0 任务。Claude 对每道问题都从一个全新的会话开始,只有一个例外:它可以从跨会话持久保存的记忆目录中检索文件。
不同模型在建立自身学习循环方面取得的成效不同。Claude Sonnet 4.6 只做到了对错误答案的原因提出假设。它的记忆目录中散落着一些文件,每个文件都列出若干未经检验的猜测。
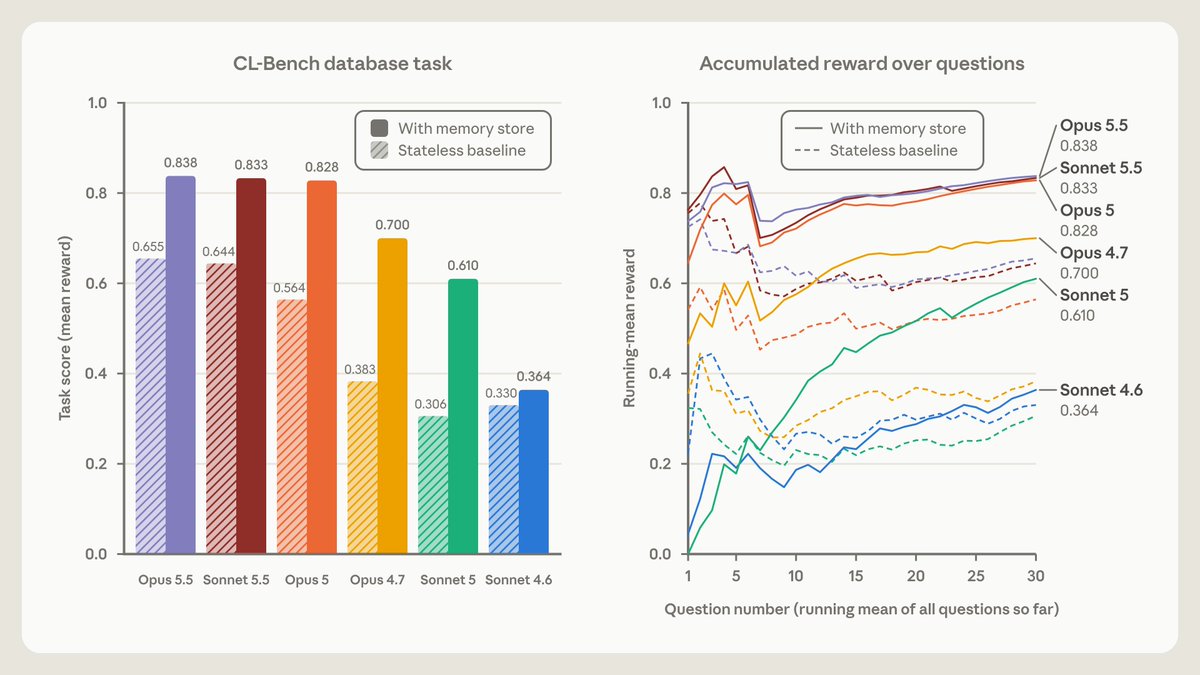
图 3:在 CL-Bench 数据库任务中,对比不同模型使用记忆时的表现与无状态基线。
Claude Opus 4.7 将笔记整合成了一份参考文档,并开始标注哪些事实已核查、哪些尚未确认。Claude Sonnet 5 会在评分器检查答案后,将答案标记为已确认;如果答错了,就写下更正。
Claude Opus 5 是这些模型中第一个完成学习闭环的。它的大多数条目都包含一条规则,以及它如何确定这条规则正确;还包含先前问题的答案,以及对过程中发现的陷阱所作的明确提醒(图 3)。
与 Opus 5 一样,Claude Opus 5.5 和 Claude Sonnet 5.5 都完成了闭环,利用记忆记录经过验证的规则,以便更好地回答未来的问题。在使用记忆时,这两个模型的得分与 Opus 5 大致相当,不过它们在不使用记忆时的基线表现略高一些。
Claude 已学会判断什么值得记住
我们还评估了 Claude 玩《宝可梦 红》的能力。这款游戏要求 Claude 应对复杂的长程任务,我们用它来测试 Claude 对哪些信息应保存到记忆中的判断。每轮运行开始时,我们都给每个模型提供了一个记忆文件夹,允许它在游戏过程中读写(图 4)。
我们分别取 Claude Sonnet 3.7 和 Claude Fable 5 的一轮游戏记录,在两者都进行到约 10,000 步时,比较了它们的记忆文件夹。我们注意到的一个关键差异,是模型认为哪些内容值得记住。Sonnet 3.7 假定任何事情都可能重要,因此不加区分地写入记忆。它的记忆文件夹成了一份遭遇档案,往往每打一场战斗、每找到一件道具、每遇见一名非玩家角色,就单独创建一个文件。最终,Sonnet 3.7 在 225 个文件夹中写下了 413 个记忆文件,并获得了一枚徽章(徽章用来标记玩家在游戏中的进度)。
相比之下,Fable 5 在两个文件夹中写了九个文件,另外还有一个名为 global.md 的顶层文件,并获得了四枚徽章。
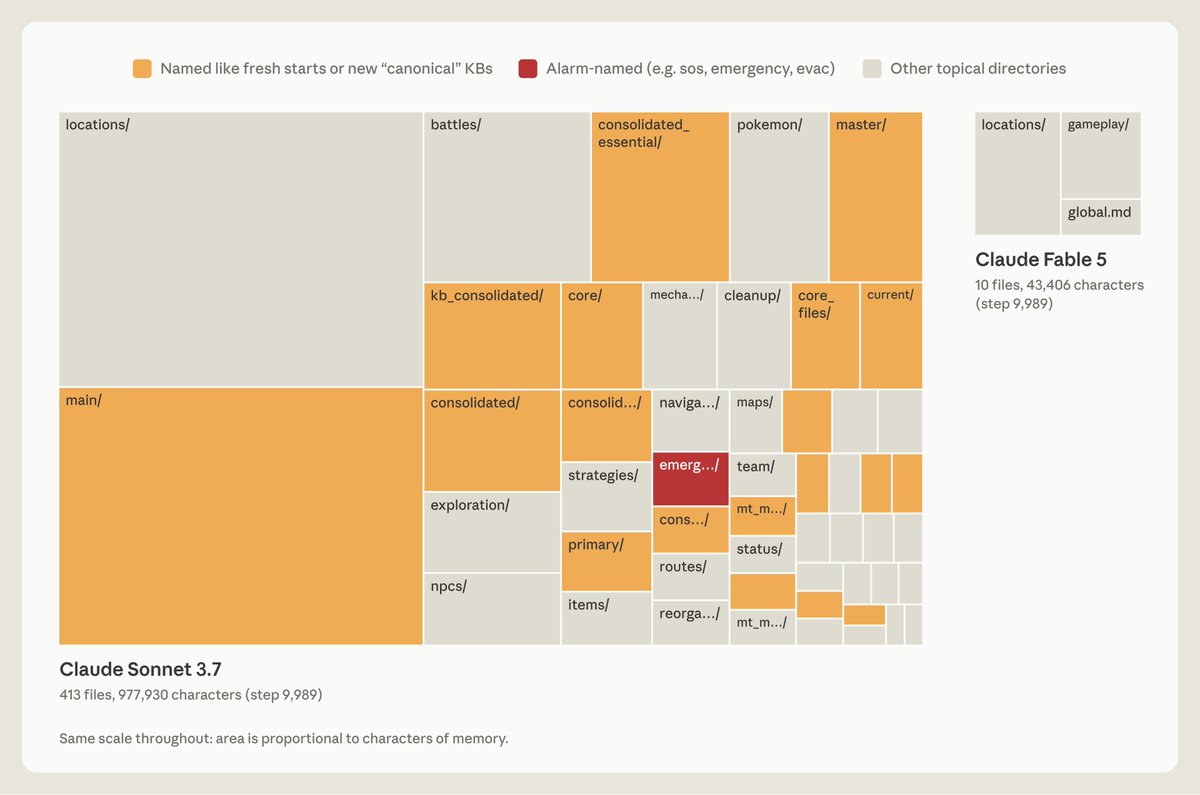
图 4:Sonnet 3.7 与 Fable 5 玩宝可梦时所使用的记忆目录。
Sonnet 3.7 的做法之所以有问题,主要是因为宝可梦的游戏状态不断变化,它的详细记录也就不断过时。结果是,随着游戏推进,Claude 不得不花费更多时间和资源梳理记忆,而不是继续玩游戏。例如,在大约第 10,000 步时,Sonnet 3.7 开始创建第四个存放“主”记忆文件的文件夹。在接下来的 17 步中,它创建了六个文件,删除了另外九个文件,却没有在游戏中采取任何行动。
Fable 5 则用记忆保存游戏没有明确告诉它的事情。Sonnet 3.7 写入记忆的某些信息,例如玩家有多少钱、在地图上的什么位置,每一轮都可以直接从屏幕上读到,因此没有必要重复存储。相比之下,策略、计划和经过验证的规则,只有在 Claude 自己推导出来之后才会存在;如果不把它们写下来,它们就会消失。
Fable 5 按照这一思路组织记忆。它的 global.md 文件充当信息面板,保存当前目标、预先写好的道馆挑战计划(完成道馆挑战可以赢得徽章),以及模型自己制定的记忆使用规则。locations 文件夹保存特定路线的通行计划,gameplay 文件夹保存根据游戏机制经验形成的策略。例如,在连续投出七个精灵球都没能抓住一只鲤鱼王——最容易捕捉的宝可梦之一——之后,Claude 写道:
如果连续 3 个或更多精灵球都失败,就改变操作时机(在菜单操作步骤之间额外插入“等待”按键)——这样做后马上就抓到了。
Fable 5 的记忆文件夹小得多,游戏进度却远超 Sonnet 3.7。Opus 5.5 采用了类似方法:保留一个小型记忆笔记文件夹,跟踪当前目标和下一步行动,在游戏过程中不断改写这些笔记,并最终通关。
引导 Claude 写入记忆
我们发现,告诉 Claude 记忆的用途有帮助,但不必规定它该怎样使用记忆。在 CL-Bench 上,我们只是告诉 Claude 有一个可用的记忆文件夹。这种概括性的指引,就足以让 Opus 4.7 和 Opus 5 有效使用记忆,并使两者的表现都有明显提升(图 3)。
我们也测试了为模型设定具体规则,规定它们应把什么写入记忆,每次测试只设一条规则。我们比较了各模型在有无该规则时,从记忆中获得的收益。当我们设定“只记录失败”这条规则时,Opus 5 和 Opus 4.7 都失去了记忆原本带来的很大一部分性能提升(图 5 右)。对能力更强的模型来说,让它们自主判断信息的重要性,比预先设定固定规则更有效;这些规则反而可能削弱表现。
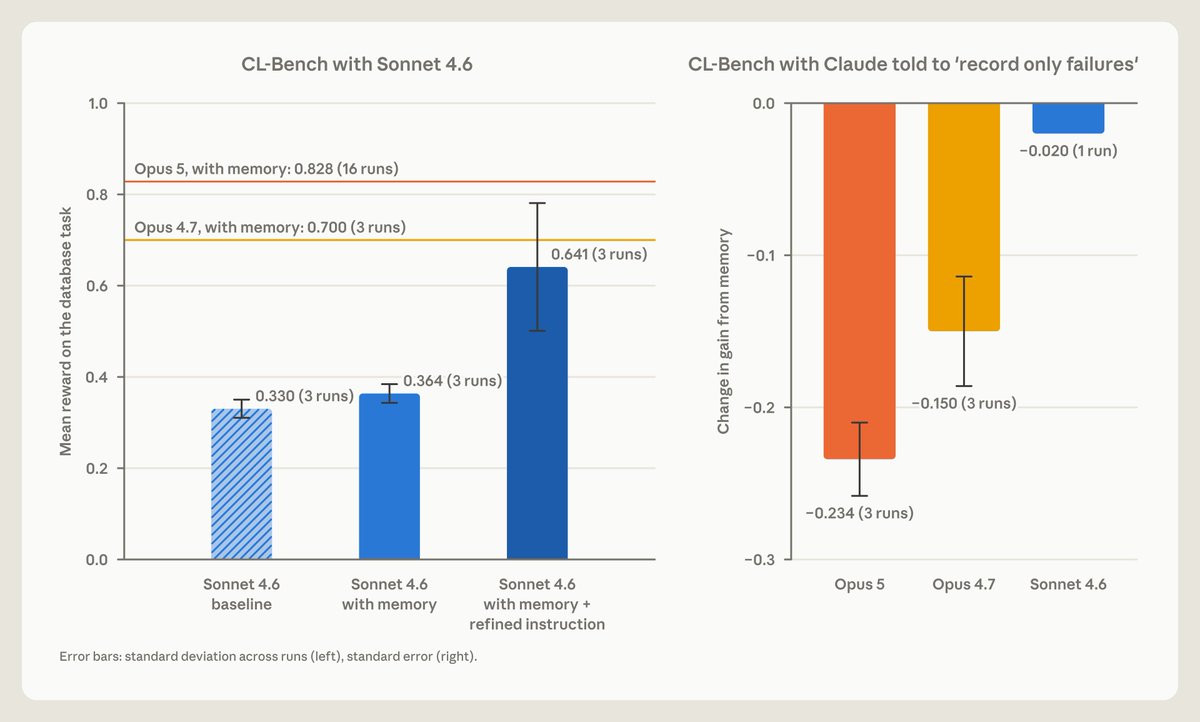
图 5:左图为 Sonnet 4.6 在 CL-Bench 数据库任务上,有无提示词引导记忆使用时的表现。右图为要求模型“只记录失败”后,各模型从记忆中获得的收益发生了多大变化。
我们还注意到,引导对较早模型的帮助最大。例如,Sonnet 4.6 经常不读取记忆目录中的文件,也没有检验自己对错误答案原因的假设。
在这种情况下,提示 Claude 在回答前先读取记忆文件,再明确检验自己的假设,几乎使它的基准得分翻了一倍(图 5 左)。Sonnet 5 则会主动这样做。即使没有提示,它也会在十次回答中的九次先读取记忆。相比之下,Sonnet 4.6 这样做的比例不到一半。
对于前沿 Claude 模型,我们通常只给出简单指引:当用户要求记住某件事,或某件事明显值得记住时,创建记忆笔记;具体判断则交给 Claude。
梦境整理可以纠正记忆
Claude 会根据自己在会话中对信息重要性的判断来写入记忆,因此,一条从一开始就有误、或随着环境变化而失真的笔记,可能在后续会话中被 Claude 读取并信任。
梦境整理为 Claude 提供了一种将笔记与原始会话记录进行核对的方法(图 6)。我们让 Claude 使用 Managed Agents 玩宝可梦,并为它挂载了一个记忆目录;在这个过程中,我们看到了一个正面例子。
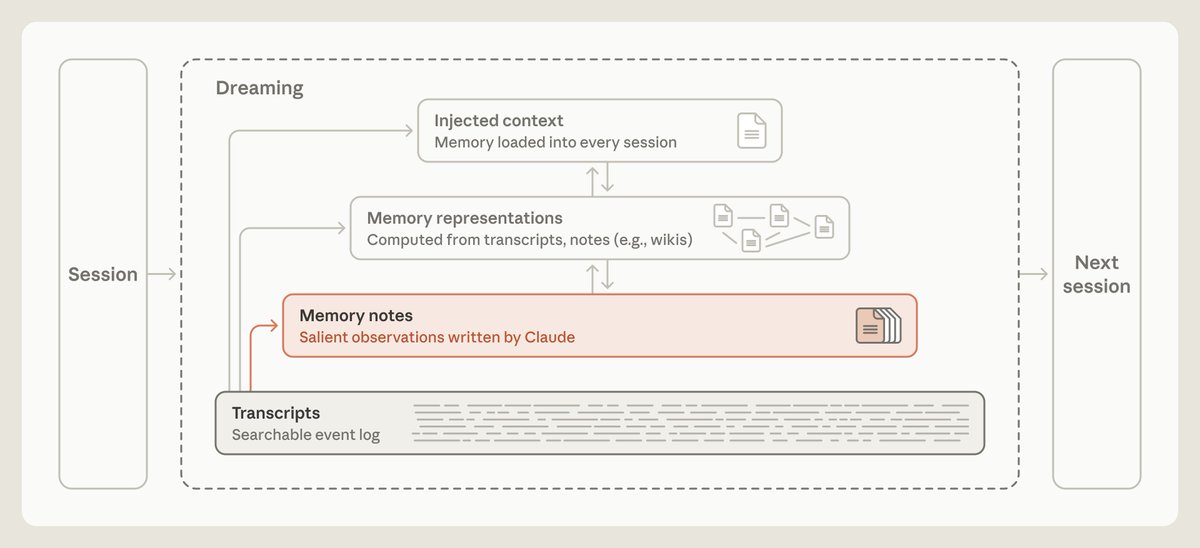
图 6:梦境整理可以纠正记忆中的错误。
在游戏的某一段,玩家必须穿过月见山(Mt. Moon)。这是一片洞穴群,入口位于地图西侧,出口在东侧。入口附近有一个陷阱:一道只能单向跳下的台阶,会把玩家送回来时的道路,而且看不出有什么办法可以爬回去。Claude 把山入口处的宝可梦中心当作地标,因此它是否会跳下台阶,取决于它认为宝可梦中心位于山的哪一侧。
某个时候,Claude 错误地记下了“宝可梦中心在东侧”。从宝可梦中心出来时,它宣布“月见山已经在我身后了”,并更新笔记:“月见山,已完成。”但实际上,它并没有穿过月见山。几次操作后,Claude 跳下台阶,又落回了来时的道路(图 7)。导航工具没有显示这次下落,因此 Claude 得出结论:“我向西走过头了”,并认为自己此前一直位于正确的一侧。事实并非如此。
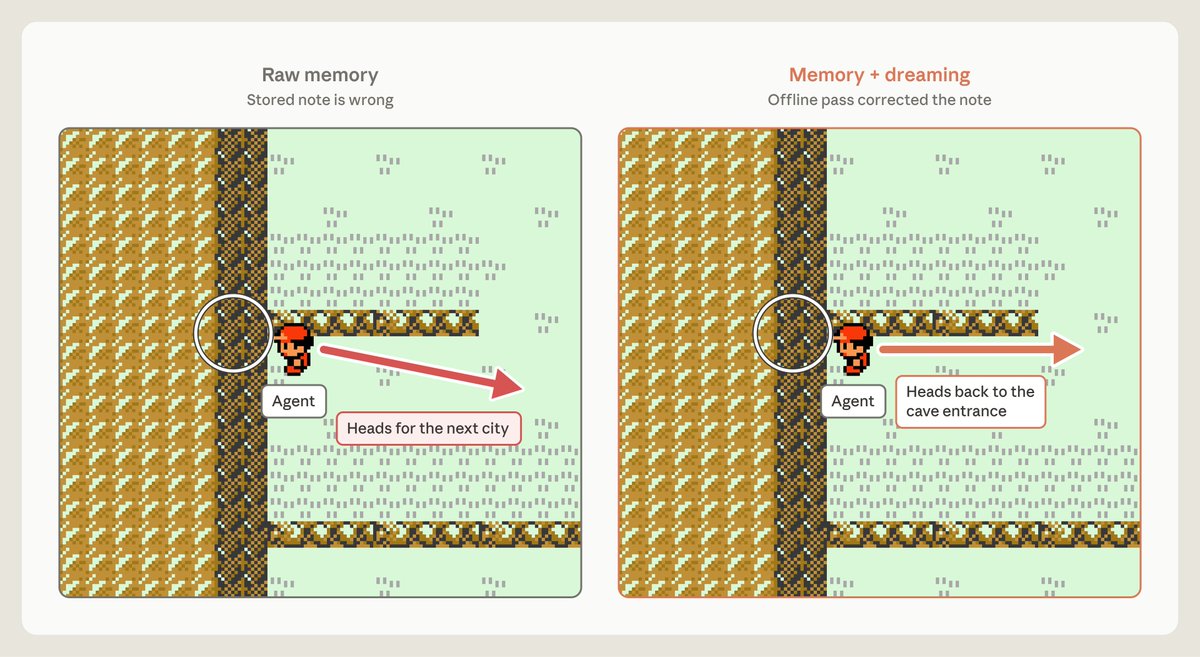
图 7:纠正一条记忆笔记,改变了宝可梦游戏中的结果。使用未经纠正的笔记时,Claude 说“月见山已经在我身后了”,然后前往下一座城市,最终却回到了来时的道路。笔记经过梦境整理纠正后,它说“现在我需要找到月见山的洞穴入口,重新进去”,随后返回洞穴。
接着,我们测试了梦境整理能否帮助 Claude 避开这一陷阱。我们对那个错误记录宝可梦中心位置的记忆文件夹运行了梦境整理:Claude 将笔记与会话记录进行核对,发现错误,并重写了笔记。会话记录为 Claude 验证记忆提供了事实依据。使用纠正后的记忆笔记,Claude 直接返回月见山,最终到达了华蓝市(Cerulean City)。
而在使用未经纠正笔记的那轮运行中,Claude 三次掉回先前的道路。第三次失败后,Claude 似乎想放弃,写道:“我打算停下来,不再继续重复这个循环。”我们的测试设置自动回复,要求它继续。于是它继续前进,一路退回月见山之前的深灰市(Pewter City),希望在那里治疗并补充物资。这轮运行结束时,Claude 始终没能到达华蓝市。
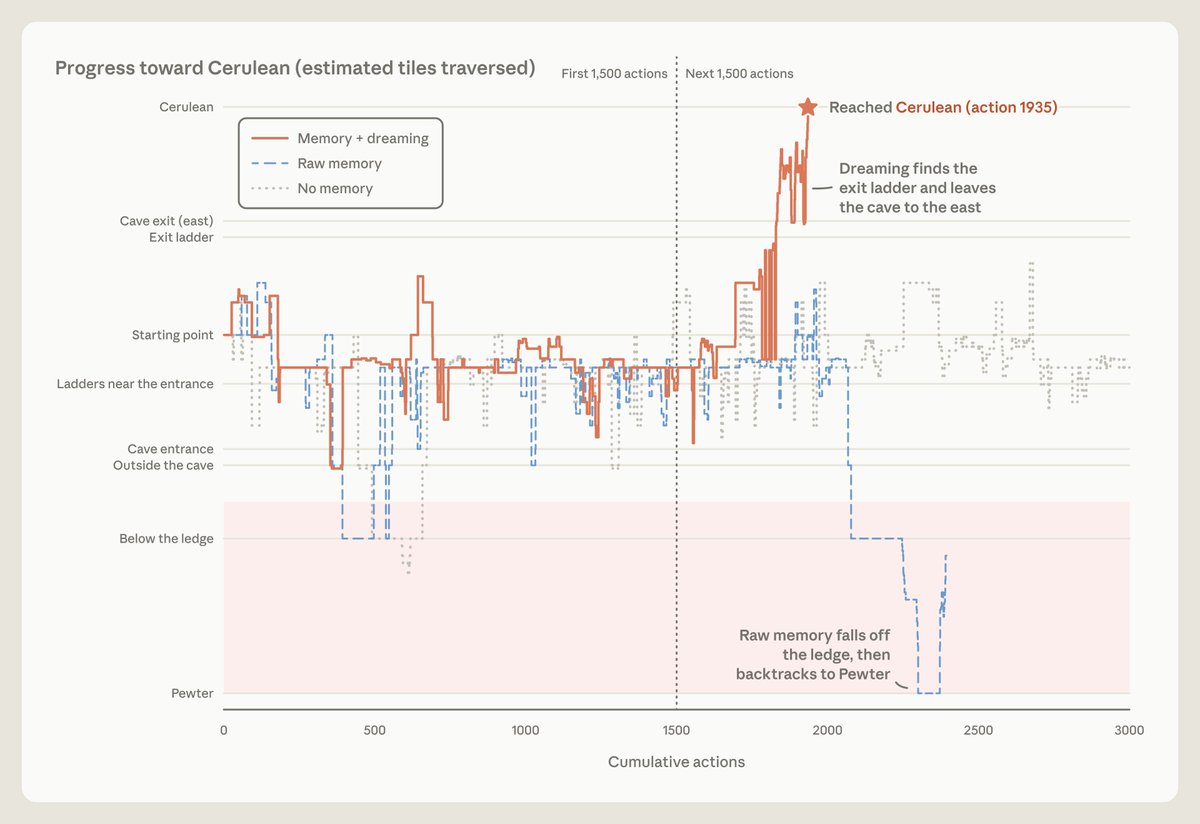
图 8:梦境整理纠正记忆后,Claude 返回洞穴,并到达下一座城市。使用未经纠正笔记的运行(“原始记忆”)始终没有穿过这座山,不使用记忆的运行也是如此。
梦境整理可以构建新的记忆表征
通过梦境整理,Claude 可以构建帮助其在记忆中导航的表征(图 9)。它使用的一种记忆表征叫作维基(wiki):这是一组由 Claude 编写和维护的页面,将它对某一主题的知识汇集起来,并链接到其他笔记。这些链接实际上为 Claude 提供了一张地图,让它可以梳理记忆,并在需要时高效地找到相关内容。
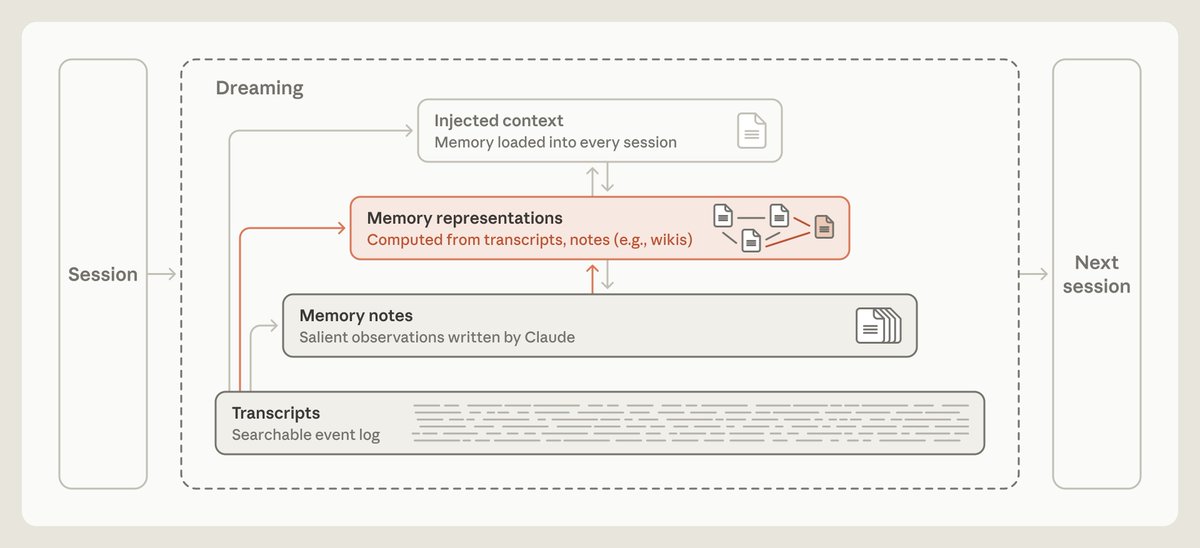
图 9:梦境整理可以构建记忆表征。
维基这样的表征可以帮助 Claude 浏览不断增长的知识库。为了探索维基作为记忆表征的益处,我们使用了来自 Stainless 的内部文档语料库,约含 350,000 个文件、4.2 亿个 token。Stainless 是我们在 5 月收购的一家软件公司。我们针对这批语料构建了一套包含 25 个问题的评估集,并向 Claude 提供搜索工具,让它探索这些文档。我们还要求 Claude 通过梦境整理,基于这些文件建立维基。在 128 次会话中,我们提示 Opus 5 智能体探索文件、编写或修正彼此链接的维基页面、合并重复内容,并对照来源核查各项说法。
每次会话都在智能体此前会话的成果之上继续推进,并通过共享日志协调工作。当我们把梦境整理从两次会话扩展到 128 次时,在这 25 个问题上满足评分标准的比例从 13% 提高到了 48%(图 10)。
Claude 以增量方式构建维基。在建立初始维基之后,它会通过后续多轮梦境整理,对其进行补充、编辑或删减。在早期几轮中,Claude 的知识水平像一名新员工,仅凭维基回答问题的能力有限。随着梦境整理不断进行,它的知识地图越来越丰富,逐渐像一名资深员工。在测试中,我们发现,当 Claude 同时拥有搜索工具时,维基对它的帮助最大。当搜索和维基结合使用时,随着维基不断发展,Claude 的综合得分从 54% 上升到 61%;而只使用搜索工具时,得分为 53%。仅凭维基回答问题时,Claude 的最高得分是 48%。同时使用搜索和维基,还使每个问题节省了约 20,000 个 token。
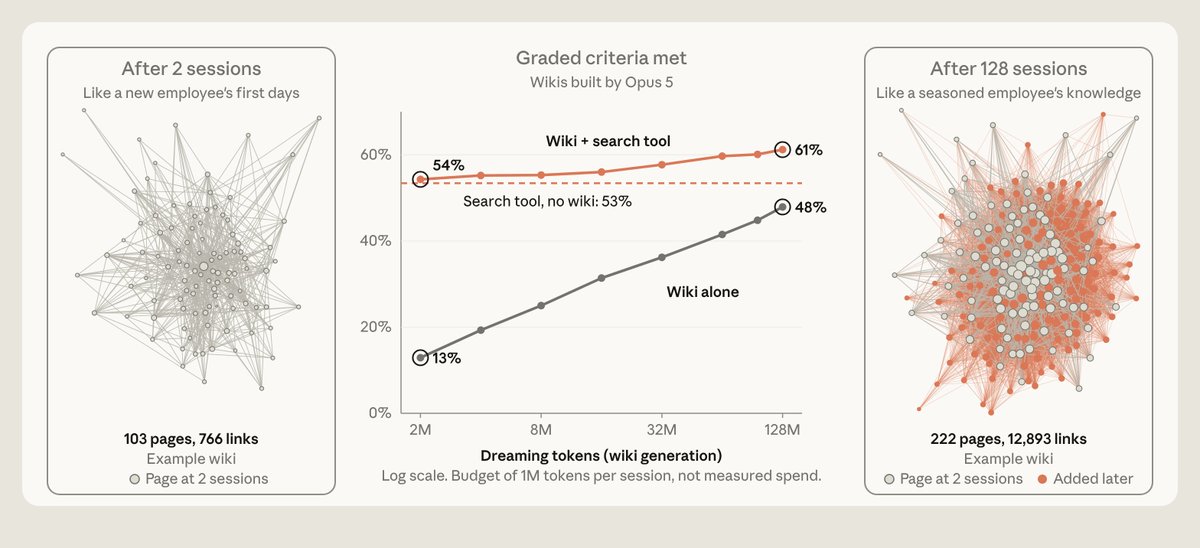
图 10:中图显示,随着 Claude 在连续会话中构建维基,它对某家公司文档语料库中 25 个问题的回答得分。左右两图分别展示两次与 128 次会话后的维基示例;每个点代表一个页面,连线表示页面间的链接。
我们想进一步测试,哪些任务会因 Claude 拥有维基而受益。为此,我们使用了 Harvey LAB 基准,以及一组有关并购的文档。这项基准向 Claude 提供一组文档,要求它依据文档内容生成一份法律简报,再按照一系列标准评分。这些评估或许不如玩宝可梦有趣,但它们为我们提供了多样化的文档集合,可用于构建维基。
我们先要求 Claude 根据文档建立维基,再分别让它通过维基和直接文件搜索来回答并购相关问题,或生成法律简报(LAB 基准)。其中一项测试提出了 24 个有关并购的问题(图 11 左),超过一半的问题需要 Claude 从多份文档中寻找信息,许多问题还需要它作出判断或进行计算。在这些题目上(红色和橙色连线),Claude 查阅维基时的得分为 87%,只使用搜索时为 73%。
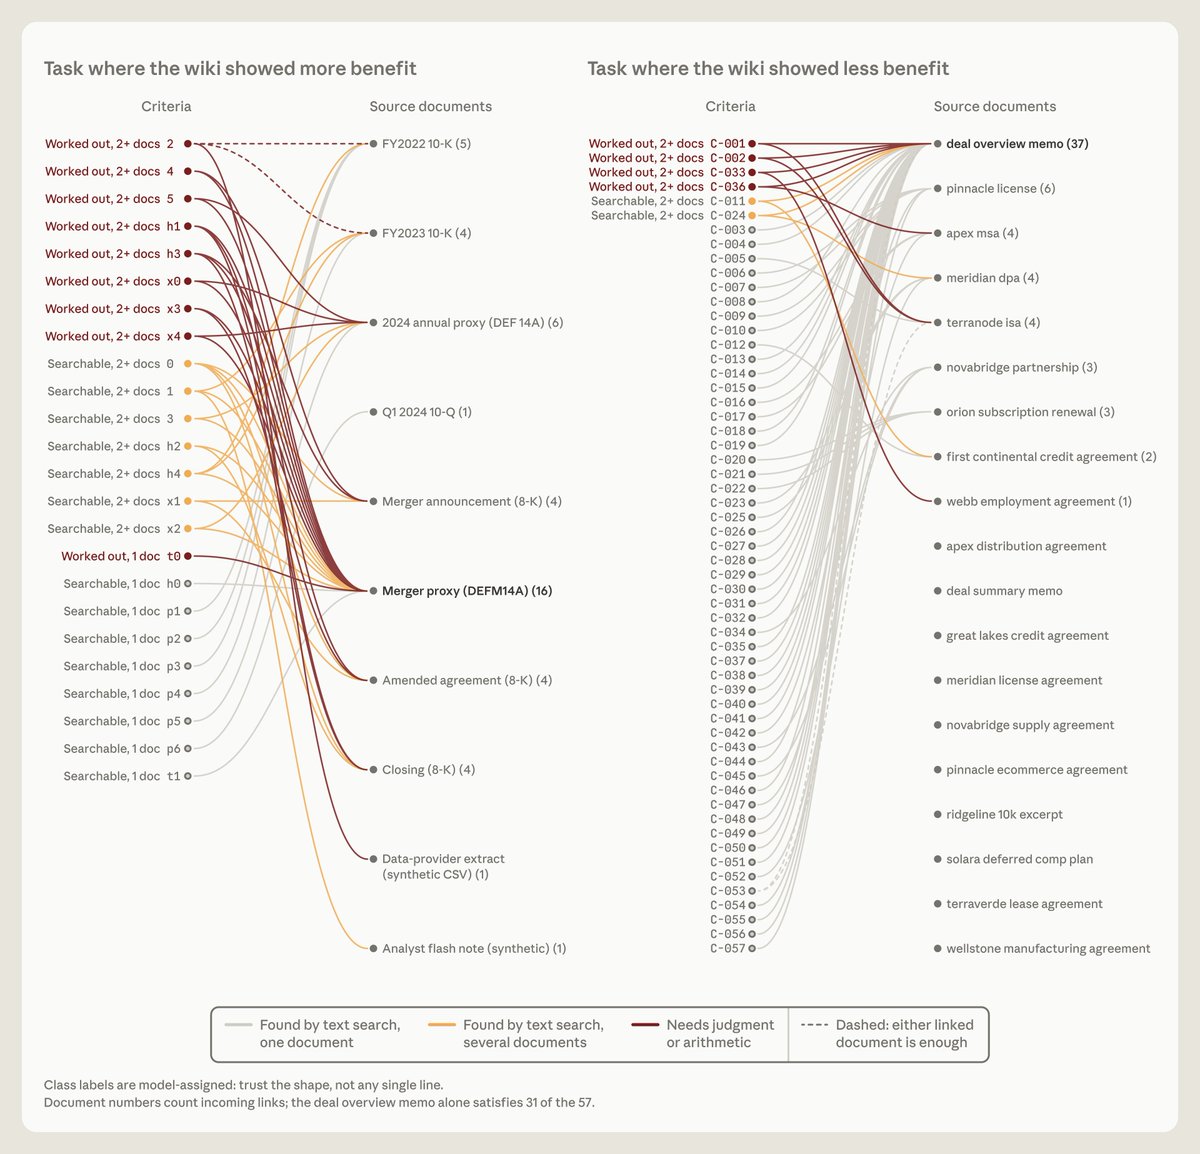
图 11:每个面板左侧列出评分项目,右侧列出满足各项要求所需的来源文档。左图是 24 个有关并购的问题,主要可以通过公开申报文件回答;超过一半的评分标准需要整合多份文档中的信息。右图是一项维基未带来明显收益的 LAB 任务,大多数评分标准仅凭一份文档就能满足。
在其他情况下,维基的作用没那么大。在一项 LAB 任务中(图 11 右),法律简报所需的内容通常通过搜索一份文档就能找到,与搜索相比,维基没有带来明显的性能提升。在另一项 LAB 任务中,维基甚至比原始文档还大(图 12)。这就像博尔赫斯那篇只有一个段落的短篇小说《论科学的精确性》中的制图师:他们绘制的地图过于详细,最后竟与地图所描绘的帝国一样大。Claude 同样建出了一套极其详尽的维基,实际上没有起到任何抽象提炼的作用。
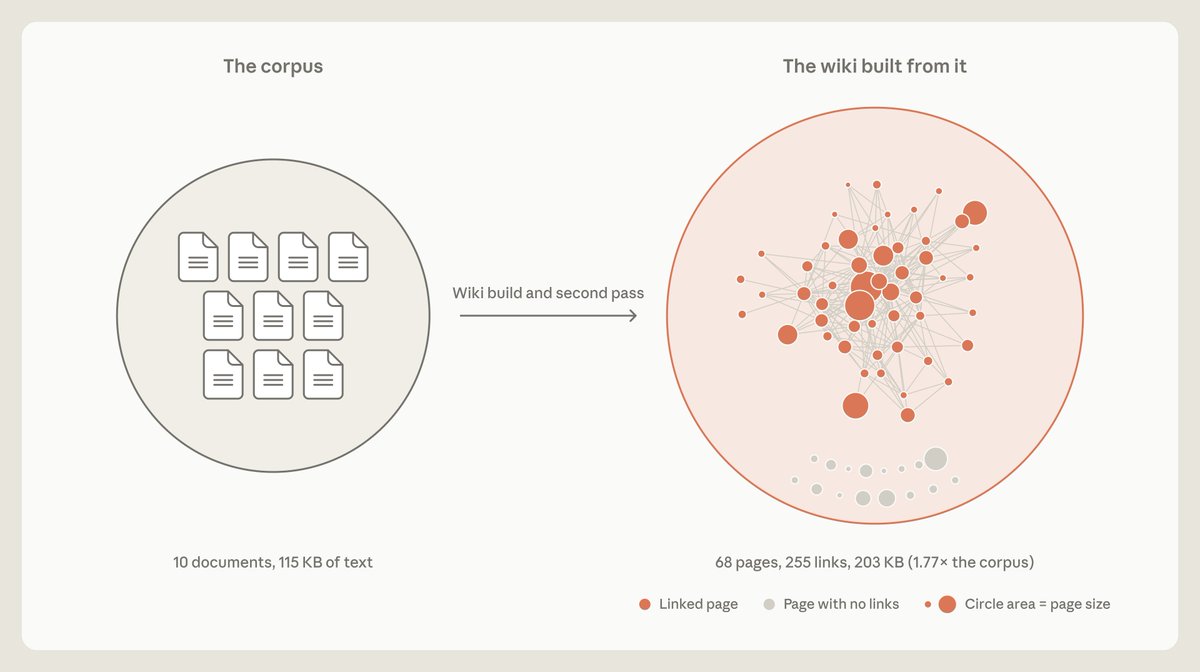
图 12:维基变得比原始文件还大。
梦境整理可以把笔记提升到记忆层级的更高层
梦境整理还可以将笔记提升到记忆层级的最顶层,由智能体运行框架在每次会话开始时,预先载入 Claude 的上下文(图 13)。这样,Claude 就不必搜索这些内容,甚至不需要先意识到有某件事值得搜索。
将记忆带入新会话,是一种上下文注入,必须谨慎处理。注入的记忆会占用宝贵的 token,而一条错误笔记可能被带入每次会话。载入一条笔记,也不保证 Claude 会照着执行:我们的 Claude Code 文档提醒,指令文件越长,遵循程度就越低。因此,记忆层级的顶层必须保持相对精简,而梦境整理在这一层的大量工作,就是维持这种精简——把部分细节移到更低层,只在顶层保留链接。
Claude Code 的自动记忆也用同样的方法保持注入层精简,由 Claude 在会话期间维护。Claude 不会把全部自动记忆载入每次会话的上下文窗口,而只会载入 MEMORY.md 的前 200 行或 25 KB。这一开头部分充当索引,告诉 Claude 它知道什么,以及去哪里找这些内容。
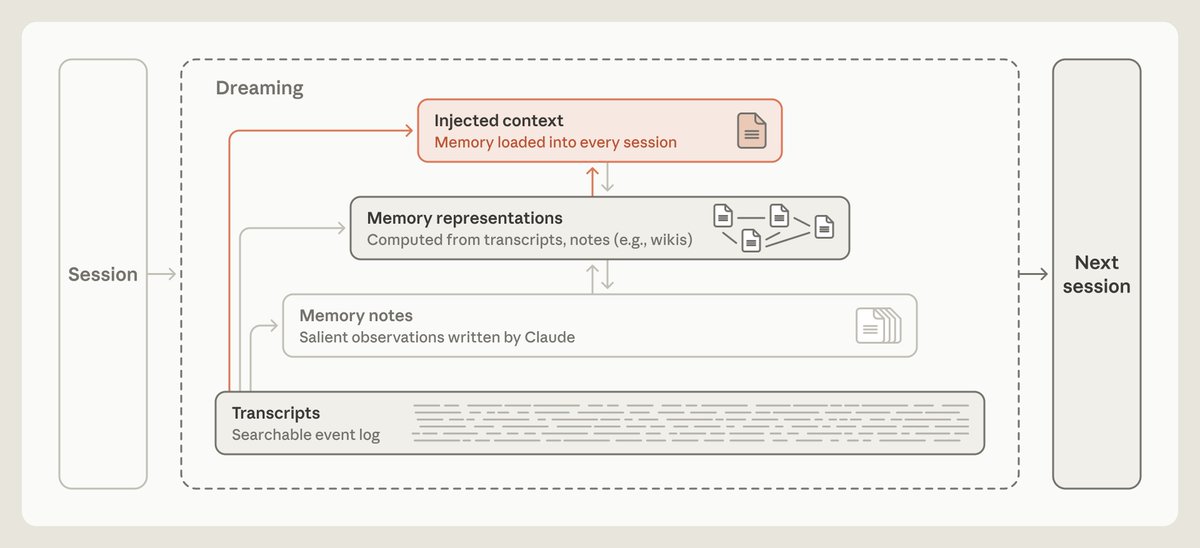
图 13:梦境整理可以写入记忆层级的顶层。注入上下文会在每次会话中载入,而下方各层则在 Claude 需要时才被读取或搜索。
梦境整理可以让记忆围绕特定目标组织起来
梦境整理还可以影响记忆如何增长。例如,Claude Duet 这样的助手,通常能从围绕服务对象组织的记忆中获益;梦境整理也可以经过调整,让记忆的构建服务于某个特定目标。
指导记忆如何增长的指令因任务而异,它们会告诉 Claude 哪些信息真正重要。例如,LAB 基准中的一项任务模拟了一次公司收购,并提供了一组合同。法律简报的评分取决于它是否准确描述了合同条款。
最初,我们只提供了生成维基的基本指令,没有告诉 Claude 该如何使用维基。这项任务高度依赖合同条款。在构建维基时,多个智能体同时向一张共享的合同条款表写入内容(图 14 左)。
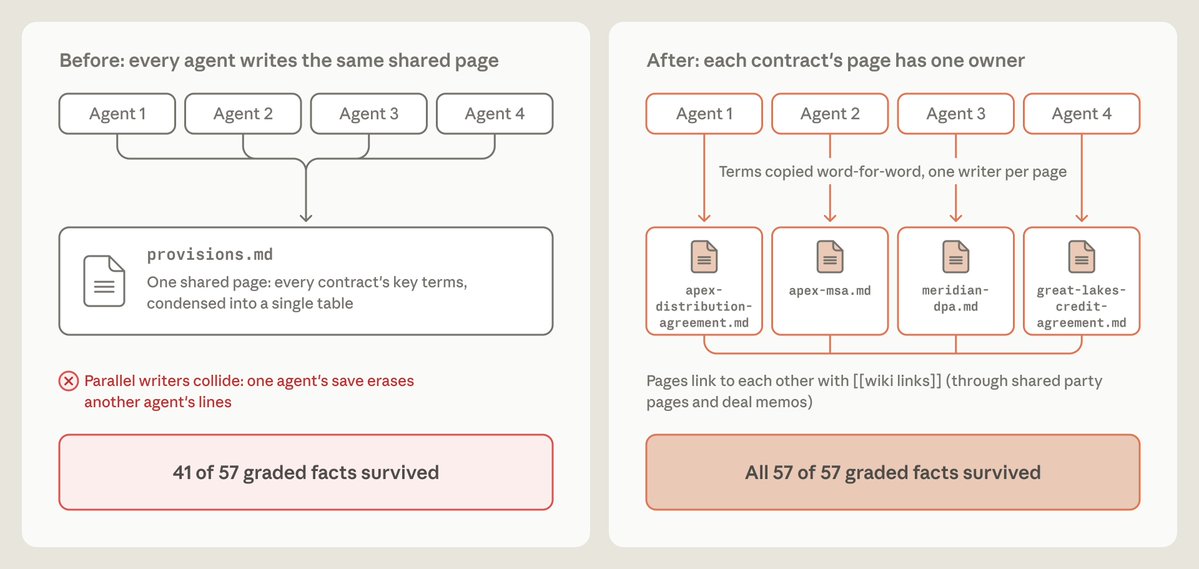
图 14:指令修改前后,进入维基的合同评分事实数量。左图中,多个智能体写入同一个共享页面,57 项事实中保留了 41 项。右图中,每份合同由一个智能体负责,各自编写独立页面,并逐字引用条款,57 项事实全部保留。
结果是,生成的维基遗漏了关键事实。我们对基于这份维基生成的法律简报评分时,发现 Claude 只纳入了 57 项事实中的 41 项(72%)。排查原因后,我们发现,共享表格对合同条款的概括不够准确,而且由于智能体相互覆盖工作成果,部分条款完全缺失。
合同条款是维基中最重要的部分,但指令没有明确说明这一点。为了找到更好的指令,我们运行了一个循环,让 Claude 反思失败、提出指令修改方案,再重新构建维基。这个循环让 Claude 认识到忠实遵循合同条款的重要性,并据此重写了维基构建指令。
此后,每份合同都有了自己的维基页面,由单个智能体编写,并逐字引用条款,而不是把它们概括进一张共享表格。我们对基于改进后维基生成的法律简报评分时,所有评分标准都能够得到满足,比例从 72% 提升到了 100%。
梦境整理可以补上单次会话留下的缺口
Claude 编写记忆笔记时,只能看到当次会话的上下文。梦境整理可以跨多次会话搜索,发现共同模式,或纠正反复出现的错误。
在为 LAB 基准构建维基时(例如图 14 所示的情况),Claude 有时会链接到尚未创建的页面。第二轮梦境整理补上了其中许多缺口。在一项任务中(图 15),梦境整理发现了维基中九条指向缺失页面的链接,并将它们重新指向同一文档对应的已有页面。它还新增了三个页面,包括一个索引页,以完善维基。
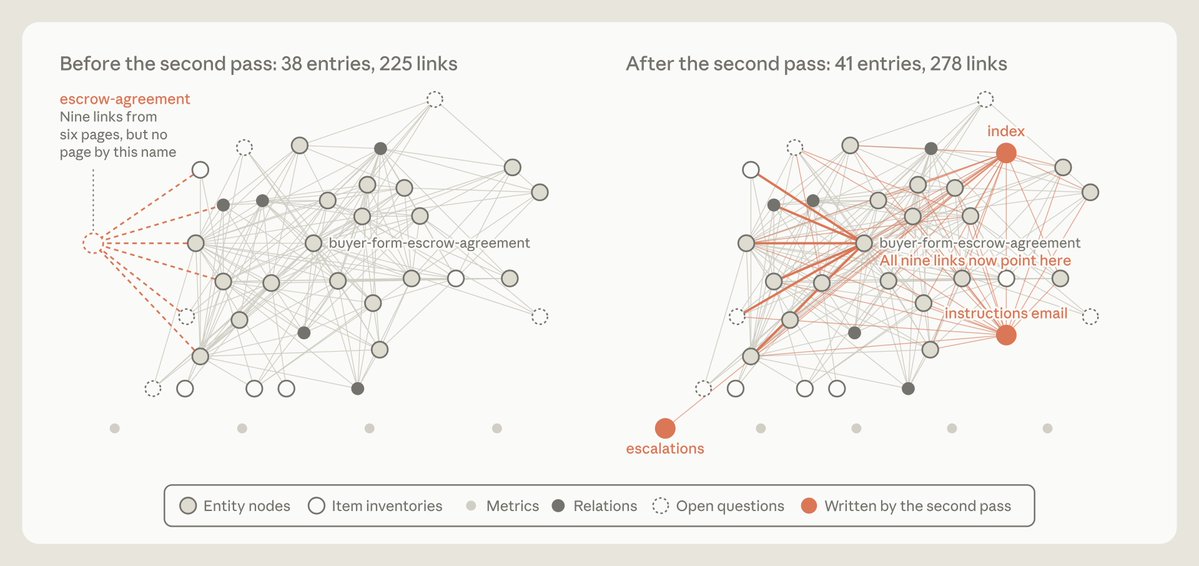
图 15:第二轮梦境整理前后的维基。
回头思考,向前看
关于如何为智能体设计记忆系统,仍有许多尚未解决的问题。其中之一是,Claude 应在什么时候创建记忆。Claude 执行任务时,可以向记忆存储(如文件夹、文件或数据库)写入内容,在源头捕捉重要信息,让后续轮次或会话立即获得这些关键细节。但即时记笔记不可避免地会分散 Claude 对主要任务的注意力。相比之下,梦境整理可以把记忆创建移到后台,但它的产出未必能立刻供 Claude 使用。
另一个问题是,如何可靠地让记忆保持最新。Claude 可能作出错误预测,也可能写入从一开始就错误的规则。随着环境变化,记忆还可能失真,或者变得不再相关。梦境整理是纠正这些错误的一种方法(图 8),但它需要算力。要求 Claude 持续检查所有记忆,可能并不现实。更重要的做法或许是,让梦境整理重点处理容易变化的信息,或者仔细调整整理频率,例如根据记忆被访问的频率来决定。
把会话记录搜索视为 Claude 记忆的基础,也是合理的。将维基等记忆表征与搜索结合起来,有时会很有效(图 10)。但 Claude 需要消耗算力来维护这些记忆表征,确保它们不会不断积累错误或幻觉。
尽管 Claude 对信息重要性的判断有所进步,没有任何模型能真正知道未来的对话轮次中会发生什么。梦境整理让 Claude 有机会回顾过去,利用算力组织记忆、纠正错误,并维护能让未来会话更方便地访问记忆的表征。随着 Claude 能力增强,记忆系统也会不断演进;关于如何设计 Claude 的记忆系统,我们仍有许多需要学习的地方。
作者与致谢
本节依据用户上一份粘贴文本中提供的原文致谢补入。
致谢
本文由 Lance Martin 撰写,Caitlin Love、Tom Chivers、Rebecca Hiscott、Jake Eaton 和 Blake Wilson 提供编辑指导。感谢 Barry Zhang、Theodora Chu、Daliang Li、Mahesh Murag、Jake Noble、Ravi Trivedi、Tina Vachovsky、Brad Abrams、Henry de Valence、Jeremy Fox、Matt Bell、Allen Li、Chris Gorgolewski、Eugene Yan、Artur Renault、Wei Zhang 和 Kevin Chen 提供有益的讨论与贡献,也感谢 David Hershey 为 Claude Plays Pokémon 所做的工作。图表由 Monika Tuchowska 绘制。
好啦,这就是今天的全部内容,如果你喜欢这篇推文,一定要记得按赞和关注!
我是 刘老板(@leo_xiaolei) 头部安全公司 AI 研发 | 讲师 北京xx大学计算机硕士 | 多篇专利& SI 论文 探索 AI | 创造价值 | 开源分享 AI充值小店:https://shop.apsdeck.com PPT 制作系统:https://apsdeck.com 联系方式(咨询&合作,注明来意) ➡ https://threerocks.xyz/me
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


