Historia de una ida y una vuelta: re-aprender a trabajar en la era agéntica
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
Estuve dudando mucho acerca de si escribir este artículo o no. Principalmente porque leo (y he tenido la suerte de conocer en persona) a auténticos magos técnicos de eso que hemos acordado llamar “programación agéntica”.
Uno se siente francamente pequeño intentando explicar cualquier cosa relacionada con desarrollo de software, IA, agentes y toda la parafernalia, comparado con estas personas. Y es inevitable pensar “pero a dónde vas tú a explicarle nada a nadie, bocachancla”.
Pero no hay nada como preguntar en Twitter, y en vista de que alguno de esos pesos pesados me ha animado a hacerlo, aquí estamos. Voy a intentar poneros en antecedentes antes (si no queréis leer tremenda chapa, pasad directamente al apartado "La evolución").
Un poco de contexto
He iniciado la aventura de emprender con 44 años, aunque llevo haciendo código desde los 8, rompiendo algún que otro Spectrum de 128k que ya estaba desfasado cuando llegó a mis manos por primera vez.
Bueno, a ver… haciendo código… con 8 años no tienes ni puñetera idea de lo que estás haciendo. Como pasa muchas veces ahora también. Pero me entendéis: la vocación ha estado ahí siempre.
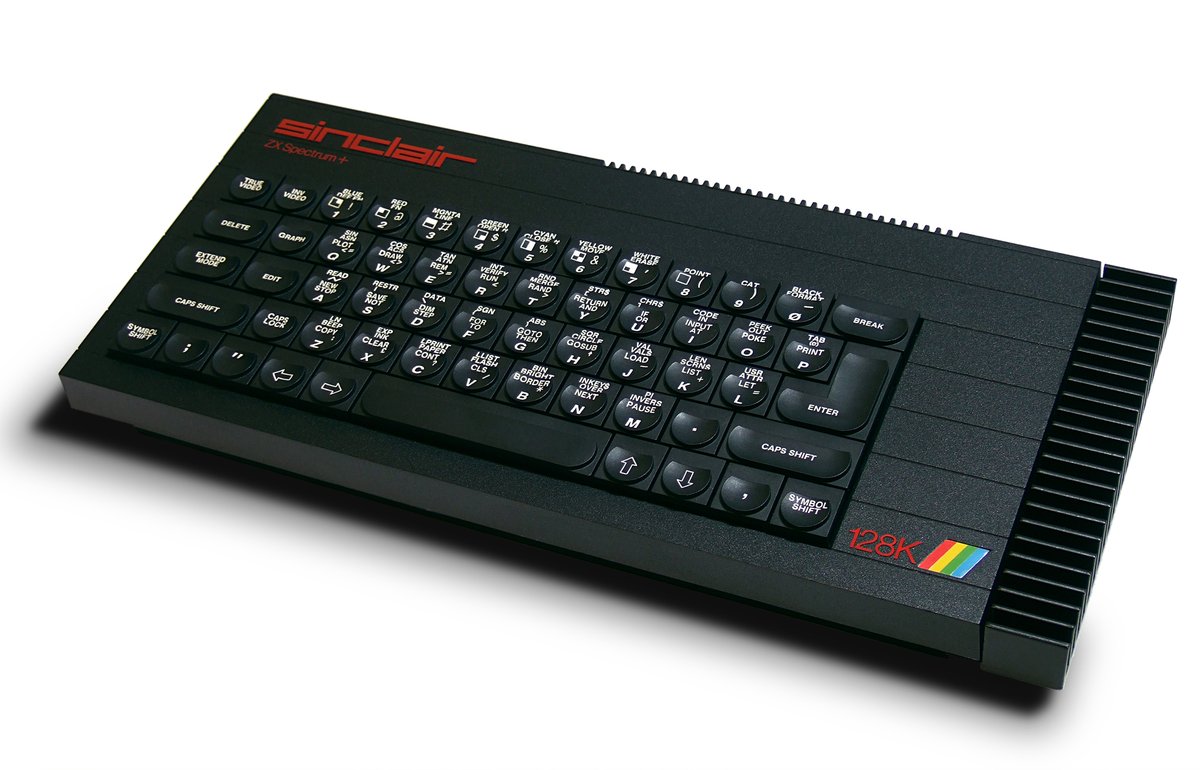
Éste fue mi primer ordenador. De cuarta mano. Cuando llego a mi mesa de estudiar ya estaban en el mercado los 80486 de Intel, pero en España (y sobre todo en familias mas bien humildes) aquello era ciencia ficción.
El caso es que ideas nunca me han faltado, y ahora que ya no trabajo por cuenta ajena no me vale con una empresa, sino que tengo dos: una establecida legalmente y la otra que lo estará en pocos meses.
Pero claro, montar una empresa no es salir del notario y empezar a facturar a lo bestia. Sobre todo si vas sin inversión. Así que al trabajo de las dos empresas hay que sumar el de autónomo puro, porque las facturas hay que pagarlas.
Empecé a trabajar en serio en mi primera empresa, @NextivalApp, antes de la era agéntica. Eso significa que al terminar mi jornada por cuenta ajena, echaba otra (completa o casi completa) para poder avanzar en ese proyecto. Y como os podéis imaginar iba muy lento. No solo porque podía echar pocas horas sino porque lo hacía con el cerebro ya cansado.
Pero bueno iba avanzando. Sin prisa porque el horizonte de montar la empresa se veía muy lejos. Así pasaron un par de años. Y entonces apareció Claude.
La transición
Aunque no pillé la ola del primerísimo Claude 1 en 2023, me uní a esta locura a principios de 2024 con Claude 2 Sonnet. Creo. No recuerdo la versión exacta porque esto todavía era una marcianada, y todo ocurre tan rápido que parece que fue hace 30 años.
Al principio era todo bastante rudimentario: tenías un chat al que preguntar cosas, pero sin acceso a ficheros y sin capacidad de retener un contexto. Entonces copiaba y pegaba funciones en una conversación, preguntaba cosas realmente largas y obtenía algo bastante mediocre. Ahí todavía hacía yo mejor código que Claude, y lo usaba como una documentación que respondía preguntas.
Y no estaba nada mal ojo, aquello fue un x1.25, aunque todavía era muy rudimentario comparado con lo que tenemos hoy, claro. Pero el potencial era evidente: en el momento en que los modelos mejoraran aquello iba a ser prácticamente automático. Y ya se empezaban a escuchar las primeras voces críticas y/o apocalípticas.
La bajada a los infiernos
La cosa evolucionó muy rápido como ya sabemos todos, pero también lo hizo la necesidad de saber y de entender cómo funcionaba esa caja mágica que cada vez hacía mejor código. Pero aún todavía mas fuerte fue la pulsión de supervivencia.
Cualquiera con ojos en la cara y cuatro tiros pegaos en la profesión podría darse cuenta de que ésta era una nueva vuelta de tuerca. Ya hemos pasado por muchas de éstas, de reinventarse dentro de la misma profesión, aunque ésta vez la ola se intuía bastante mas fuerte.
Pero claro, se iban apilando cosas: trabajo por cuenta ajena, trabajo para sacar adelante una idea de emprendimiento y ahora trabajo para entender que es esta cosa que llaman IA generativa. Mucha tela que cortar y el día solo tiene 24 horas, te pongas como te pongas. Y que no tenemos ya la plasticidad cerebral que teníamos con 20 años también.
Aunque no sea baturro tengo pocos rivales si hablamos de cabezonería, así que forcé la máquina one more time. Y durante unas semanas pude mantener el ritmo, pero el cansancio se acumulaba y terminé por procrastinar mucho con todo, lo cual generaba mucha frustración porque no veía avances y el trabajo se acumulaba y me metí en una madriguera de conejo complicada.
Así que terminé por no hacer nada durante un tiempo. Nada mas que trabajar por cuenta ajena, porque no se puede vivir del aire. Fue como un mes o un mes y medio, pero suficiente como para reorganizar la baraja y darme cuenta de algo que parece obvio pero no lo es: no puedes saber de todo al máximo nivel, ninio.
Esa es una vieja piedra con la que he tropezado varias veces desde joven. Eso creo que lo he contado ya alguna vez. Así que decidí hacer algo que a los técnicos nos cuesta horrores: dejar a un lado la excelencia técnica (aquí es donde todo el mundo se tira de los pelos).
La metamorfosis
Cuando un cambiapieles cambia de forma, el proceso es doloroso. Huesos que crujen, piel que se desgarra y morfología que se revuelve y contusiona para dar como resultado otro tipo de ser. Metafóricamente, eso es lo que le ocurre a un enamorado del código fuente cuando intenta salir de su zona de confort. Por varios motivos.
«Es un cambiapieles. Cambia de piel: unas veces es un oso negro, enorme y fuerte; otras es un hombre vigoroso y de pelo negro, con brazos enormes y una gran barba. [...] Al menos no está bajo ningún sortilegio. Es un hombre de su propia estirpe. [...] De todos modos no come animales: no caza ni come carne silvestre. Tiene grandes colmenas de abejas, y vive casi por completo de crema y miel.» El Hobbit - J.R.R. Tolkien
En mi caso, de chaval, tenía un hambre infinita. Una suerte de Galactus. Incapaz de saciar el hambre de conocimiento. Del que me daba a mi la gana también os digo, porque el calvario que pasaron mis padres conmigo por mal estudiante no se lo deseo a nadie.
Quería ser el mejor, cada error que cometía era una pequeña muerte y eso me hizo un cretino pedante e insufrible. Hasta el punto de dejar de ir a convenciones técnicas porque la gente se lo pasaba mejor socializando que en las propias charlas.
Afortunadamente me acabé dando cuenta de que era un completo imbécil y fui dejando atrás poco a poco esa pulsión de querer ser el mejor. No lo vas a ser nunca; ni tu ni yo. Siempre hay alguien mejor que tu y que yo y eso es bueno.
Pero como aquello me pilló muy joven, quedaron cicatrices que incluso hoy hay que mantener un poco a raya. Eso es justo lo que me pasó con la adaptación a la IA generativa y por eso, ahora que somos mas viejos y sabios, tomé la decisión mas complicada: salir de la zona de confort. De cabeza a diseñar producto.
Mentiré si no digo que diseñar producto también tiene ese punto de solución de problemas del que bebe también la excelencia técnica. Pero mentiría también si no reconociera que a pesar de lo doloroso, dejar de lado conversaciones eternas acerca de si un booleano puede ser nullable /*optional * y si tiene sentido un booleano triestado (por ejemplo), es liberador. Es llevar la conversación a alto nivel, y ahí es donde descubres que somos humanos.
Romperse ese par de huesos ha sido clave para entender los principios que me han llevado a trabajar como trabajo hoy.
La evolución
Metiéndonos ya en el ajo, voy a intentar explicar cómo trabajo hoy para llevar @NextivalApp, @StagelinerApp y atender como autónomo a clientes que deben quedar satisfechos. Esto último es lo que paga mis facturas hoy, hasta que pueda obtener beneficios de mis dos empresas.
Empecemos por el principio: ¿qué equipo somos? Somos muy pocos y solo yo tiro código a día de hoy:
-
Nextival: somos tres socios (dos no técnicos)
-
Stageliner: somos dos socios (uno no técnico)
-
Y evidentemente como autónomo estoy yo solo
[未转换内容,参见原始 JSON]
[未转换内容,参见原始 JSON]
No sería posible hacer todo lo que hago sin agentes autónomos y por supuesto es completamente imposible revisar línea a línea todo el código de todos los productos y proyectos. Porque ¿cuántos repositorios hay en @NextivalApp y en @StagelinerApp?
-
Nextival: son 18 repositorios activos. El producto que se ve es un API, un CMS y apps personalizadas iOS / Android. El que no se ve va desde un sistema automatizado de inteligencia de datos hasta una navaja suiza de herramientas internas y automatizaciones que nos permiten salir a producción (por ejemplo) con un cliente nuevo en apenas un par de horas.
-
Stageliner: es bastante mas ligero pero aun así son 6 repositorios, aunque solo se ven dos y en algunos casos tres. Este producto todavía está en construcción, esperamos poder publicarlo pronto.
-
Como autónomo el número de proyectos varía, como supondréis, pero hagamos una media de dos o tres repositorios activos de diferentes productos al mismo tiempo.
Hacer todo esto a mano y revisar cada punto y coma, entenderéis que es imposible. Y no vamos a entrar en features y niveles de complejidad para no aburrir (mas).
Lo primero es pensar en una infraestructura que soporte todo esto y que no me tenga pegado a una pantalla 20 horas al día.
Hoy todo el trabajo se realiza sobre un MacMini M4 Pro con 64GB de RAM en modo headless. Ahí es donde viven todos mis agentes, desde donde se hace push a los repositorios alojados en GitHub y donde se hacen las subidas a producción. FileVault activado, conectado 24/7 en un lugar seguro y respaldado con copias de seguridad. Pero al tenerlo headless no tengo otro remedio que usar Tailscale para crear una tailnet entre todos mis dispositivos. Eso me permite salir de casa, básicamente, aunque para llagar hasta aquí he pasado por varias etapas.
Un momento... si todo está en la misma máquina ¿cómo separas proyectos? ¿los agentes tocan donde no deben? ¿que aislamiento uso? Pues cuando empecé a pensar en una factoría de código 24/7 dibujé auténticos arcos de iglesia obsesionado con el aislamiento. Sobreingeniería a niveles de arcada. Y la solución, para mi, ha sido siempre la mas sencilla: usar directorios. Ni mas ni menos. Cada repositorio a una profundidad de un directorio desde el directorio de cada cliente y no tengo absolutamente ningún problema.
Vamos a ordenar un poco todo esto y vayamos al principio, antes de Tailscale, el MacMini headless y toda la parafernalia.
Empezando por el principio
Uno de los problemas que me llevó a la sobreingeniería es el de manejar varias cuentas de Anthropic, OpenAI y nan.builders, cada una para su proyecto concreto y que no se mezclen los usos (ni los límites). Además de meter por medio mi cluster de DGX Spark para que sea trasversal a todos los proyectos.
Primero tenía acceso a dos cuentas de Claude Code: la mía personal y la que un cliente me proporcionaba. Intenté trabajar haciendo login y logout en la terminal a pelo cada vez que necesitara una cuenta u otra, pero claro... eso me limitaba a hacer solo un proyecto a la vez. Así que estuve usando durante un tiempo los perfiles de iTerm2 para poder tener varias ventanas con varias terminales y diferentes variables de sesión, que me permitían aislar en cada perfil de iTerm2, un proyecto. Cada uno con las cuentas de Anthropic o Codex que le correspondía. Eso ya no me mezclaba usos y la verdad es que funcionaba bastante bien. Durante esta etapa llegó una tercera cuenta de Claude Code y el sistema escalaba metiendo mas perfiles así que estupendo.
Pero claro, este sistema que me monté con los perfiles de iTerm2 no valía para mucho visto desde el ángulo de separarme del ordenador en algún momento: necesitaba hacer un escritorio remoto para ver como iba todo y era bastante incómodo. Total que acababa pasando de nuevo mucho tiempo delante de un teclado y una pantalla, con 40 terminales abiertos y 40 errores diferentes cada día por teclear una instrucción en el que no es.
Si vistiera pantalones de pinzas y zapatos alguna vez, ese podría haber sido yo hace unos meses perfectamente.
Y lo que es peor: al verme obligado a viajar, a mi que no me gusta trabajar con portátiles, no me quedó mas remedio que pasar por el aro. Pero apareció un nuevo problema: todo lo que tenía en mi MacMini donde trabajo habitualmente, no lo tenía en el portátil. Y retomar una sesión de trabajo era o bien hacer un escritorio remoto que iba lento de narices o bien empezarla prácticamente en blanco.
Me puse a buscar qué hacía la gente para paliar un poco esto. Y empecé con Notion. Pero por mucho que me he obligado todos estos años a usar apps de notas, simplemente no puedo. Me aburre y me hastía tener que apuntar todo. Es terriblemente ineficiente para mi forma de ver las cosas y una obligación mas que sumar a una larga lista, asi que lo descarté rápido. Luego probé Granola y todos los similares y tampoco.
Así que volviendo a mi filosofía del keep it simple, básicamente hice lo que cualquier programador haría: un repositorio de GitHub. En ese repositorio, y usando los webhooks de ClaudeCode, se iban a ir guardando en una estructura de directorios todas y cada una de las decisiones que se iban tomando en cada proyecto. Así, lo tendría disponible en el portátil también. Y todavía está funcionando hoy. Es simple, es eficaz y no añade mas capas. Para mi manera de trabajar es ideal.
En este punto sabía que necesitaba algo que me ayudase a organizarme mejor, pero no quería pasar por el peaje ni de la sobreingeniería ni de depender excesivamente de terceros para poder realizar mi trabajo diario. Y eso que hasta este momento solo había batallado contra tres cuentas de Claude Code. Mas tarde llegarían nan.builders y mi propio servicio de inferencia local con dos DGX Spark.
Mas allá de Anthropic y OpenAI
Vamos a hacer un alto en el camino, porque merece capítulo aparte hablar de lo que no es tan fácil como instalar ClaudeCode y ya: modelos de pesos abiertos. Y si, como estarás imaginando el fantasma de las Navidades pasadas (ese con el que os conté al principio que me he peleado durante toda mi vida laboral) volvió a aparecer: montañas de papers, horas y horas de vídeos explicativos y un montón mas de información relacionada, que fue debidamente almacenada en un hueco de mi disco duro con un único fin: querer saber del tema todo lo posible lo antes posible. Y a ser posible mas que la media.
Por supuesto, todo acabó en el mismo sitio de siempre: falta de sueño y decepción. Te decepcionas porque arrancas con la fuerza de un océano, pero la carga de trabajo puede contigo. De nuevo, pude mantener el ritmo un tiempo corto hasta que abandoné.
Pero no todo está perdido. Porque en ese tiempo corto pude hacer pruebas con modelos locales pequeños, entendí lo que era un arnés, descubrí pi y nan.builders, y lo mas importante: sin darme cuenta me hice una opinión. Pude evaluar lo que me gusta y lo que no. Por ejemplo:
-
Prefiero pi a Hermes
-
Prefiero GLM a DeepSeek para pensar
-
Me gusta tener ayudas visuales para mi, para cambiar de contexto rápido
Y esta nueva pieza del puzzle tenía que entrar en mi día a día como fuera. Descartado Hermes, al principio usaba pi por separado junto con los modelos de nan.builders para cosas muy aisladas, o (y esto es vergonzoso) iba haciendo copy-paste de ClaudeCode a pi y viceversa... en casa del herrero, ya sabes.
[未转换内容,参见原始 JSON]
Los resultados de estos modelos de pesos abiertos eran (son) francamente estupendos, lo cual me llevó a dos cosas: decidirme por invertir dinero en inferencia local de verdad comprando un par de DGX Spark y prescindir de mi cuenta de ClaudeCode durante un tiempo para ver si podía funcionar sin ella. Y pude, pero con algunos "peros".
Si te preguntas porqué elegí las Spark en lugar de tarjetas gráficas lo podemos discutir, pero mis argumentos son: espacio, consumo y ruido. No quiero convertir mi casa en un datacenter. El balance entre potencia y todo lo anterior es, para mi, un elemento clave a la hora de tomar una decisión. Igual que el factor de forma. Las Spark son realmente pequeñas.
Evidentemente eso de copiar y pegar en pi no se sostuvo durante mucho tiempo por lo poco práctico del tema. Y porque en realidad guarreaba mas que ayudaba. Así que acabé volviendo a delegar en modelos de pesos abiertos solo tareas aisladas o proyectos pequeños. Me quedé un poco planchado la verdad.
En aquel momento me parecía algo super-complejo y, aunque suene a cliché, la solución se me ocurrió en la ducha: "pero vamos a ver... si pi es un proceso y ClaudeCode puede lanzar procesos... definitivamente eres tonto perdido". ¡Pues claro! la solución era decirle a ClaudeCode que levantara procesos de pi con el modelo que mas conviniera y el solito se encargaría de pasarle el contexto y recoger la respuesta.
Y así mi ClaudeCode empezó a lanzar agentes con modelos de pesos abiertos alojados y servidos por nan.builders y con pi como arnés. A veces nos enredamos en complejidades completamente locas y en realidad todo es mucho mas sencillo.
El último paso en este descubrimiento de los modelos de pesos abiertos es la revisión adversarial. Quedaos con este concepto porque al final va a cobrar mucho mas sentido, pero por el momento diré que aunque estuve funcionando unos meses sin ClaudeCode, hoy por hoy no puedo prescindir de el, sobre todo después de Opus 5.5 y llevando todo este arsenal de repositorios a la espalda.
Y entonces llegaron Herdr y Tailscale.
De Orion Pax a Optimus Prime
Hasta ahora solo hemos conseguido un entorno mas o menos estable, con algún costurón que otro, pero que se puede usar diariamente sin mayores problemas. Resumamos como estamos en este punto de la historia
-
Un MacMini M4 Pro 64GB que lleva la mayoría del trabajo diario
-
Un MacBook M2 16GB que hace su servicio en viajes y cuando no estoy en casa
-
Un sistema de "memoria compartida" mas simple que el asa de un cubo: un repositorio de GitHub ordenado por directorios.
-
ClaudeCode orquestando agentes propios y con modelos abiertos a través de pi
Y claro funcionar funciona, pero en cuanto le tenía que meter carga de trabajo de verdad al MacBook M2, la cosa iba regular. Estaba desperdiciando la potencia del MacMini M4 Pro cuando no estaba en casa y eso me pinchaba bastante.
Ya había oído hablar de Orca pero me resistía a probarlo porque, una vez mas, no quería sobreingeniería. Como no me quedaba mas remedio que empezar a complicarme me lo instalé y me puse a probarlo. Primer escollo insalvable: es incapaz de manejar diferentes cuentas de proveedores de inferencia, sin hacer doscientas piruetas antes. Hay hasta una PR en GitHub para añadirlo, pero en el momento de escribir esto sigue en discusión.
Tiene truco. Si se puede hacer sin tanta parafernalia pero no encontré la manera de hacerlo cuando lo intenté. Probé dos o tres cosas que no funcionaron y lo dejé por imposible. Todavía no se porqué no me funcionó tampoco el método clásico de CLAUDE_CONFIG_DIR, pero menos mal.
Con esto quedaba completamente descartado, claro. Menos mal que no desinstalé iTerm2 del tirón. No me valía, así que (sin muchas ganas) tuve que probar la alternativa: Herdr. Y menos mal que lo hice.
Herdr es exactamente lo que encaja en mi forma de trabajar como un guante. Puedo mantener aisladas varias cuentas fácilmente, puedo agrupar sesiones, su UI me parece mas amigable,... un acierto.
En este punto no sabía porqué me gustaba mas Herdr que Orca, pero creo que con el tiempo he entendido que lo que necesitaba/quería era un multiplexor en condiciones y no un ADE completo.
Bien pues con Herdr instalado y funcionando en el MacMini y en el portátil podía trabajar en mi despacho o irme al sofá un rato o hacer la comida mientras vigilaba como iban las cosas. Pero ¿y cuando no esté en casa?. Y llegó Tailscale a abrir definitivamente el campo.
Chico, no se como he estado trabajando los últimos años sin Tailscale. Es una maravilla. Tu propia red privada allá donde vayas. Eso abre posibilidades para muchas cosas, pero para el caso que nos ocupa es básicamente llevar el modelo de irse al sofá o a hacer la comida, pero a un hotel en cualquier parte, o en casa de unos amigos en un pueblo perdido cuando necesitas echarle un ojo a algo. Incluso desde el mismo móvil, sin necesidad de portátil.
[未转换内容,参见原始 JSON]
En este punto había conseguido tener un sistema que podía funcionar en cualquier parte, porque el trabajo se hace todo en el MacMini que tengo en un lugar protegido y no importa que yo no esté delante.
Fue el primer paso de la factoría de código 24/7 que llevo pensando desde aquel primer Claude 2 Sonnet.
Estado del arte
Hoy por mi sistema para trabajar es el siguiente.
Los hierros:
-
MacMini M4 Pro 64GB: es donde se hace todo el trabajo, donde viven los agentes y donde se gestionan todas las cuentas de proveedores de inferencia, incluido mi propio clúster. Además es un CI completo desde el que puedo desplegar todos mis proyectos en cualquier entorno, incluidas apps nativas iOS y Android, con una sola orden.
-
MacBook Pro M2 16GB: es el satélite en el que trabajo cuando no estoy en casa y necesito sentarme a trabajar. Llevo Herdr y una conexión tether con mi teléfono. No necesito nada mas.
-
Mi teléfono móvil: he estado usando Moshi con suscripción mensual para trabajar desde mi teléfono móvil cuando no quiero llevar un portátil, y la verdad es que ha funcionado siempre muy bien. Hace apenas un día que salió la app de Herdr para iOS y probablemente cancele mi suscripción a Moshi. Es mucho mas sencilla.
El software:
-
En todas las máquinas, Herdr corriendo 24/7 siendo que en el MacMini están corriendo de verdad todos los agentes y es dónde se hace todo el trabajo. El portátil y el móvil solo observan y mandan órdenes.
-
Tailscale me permite tener conectados todos los hierros en una red local virtual esté donde esté. El MacMini siempre está en el mismo sitio fijo, el portátil lo uso a veces y el móvil lo llevo siempre encima.
-
Xcode, Android Studio y otras hierbas: se mantienen en el MacMini porque los agentes trabajan con ellos para realizar todas las tareas que requieren de un IDE. Pero yo ya no los toco apenas. Si me preguntas, es liberador.
Los proveedores de inferencia:
-
Anthropic: varias cuentas de ClaudeCode, algunas proporcionadas por clientes y otras mías, que deben convivir pero no mezclarse.
-
OpenAI: proporcionadas por clientes.
-
nan.builders: un imprescindible si me preguntas.
-
Mi propio clúster de DGX Spark: no es inferencia a escala industrial pero es suficiente para delegar tareas y hacer ciertas revisiones. Cada semana que pasa mejora el ecosistema y a día de hoy es increíble el trabajo que hacen estas dos maquinitas.
Lo imprescindible:
-
La app de notas del teléfono: si tengo un tiempo muerto en cualquier lado, o simplemente se me ocurre alguna idea, la apunto ahí para revisarla cuando pueda. Ahora mismo es como llevar papel y boli.
-
Mi cerebro. Yo tomo las decisiones importantes. Asumiendo que me voy a equivocar mas de una y de dos y de tres veces. Asumir la responsabilidad te hace ganar control sobre lo que haces.
Hoy tomo (mucho) mas tiempo pensando que ejecutando. Si se lo dices a mi yo de 20 años probablemente se reiría. Pero si os soy sincero, creo que es la evolución natural, por mucho que nos resistamos.
Conclusiones, preguntas y alguna respuesta
Me imagino que, como yo, habréis notado que toda esta turra es algo inconexa y complicada de leer. Pero es que el camino ha sido exactamente así. Esto que he escrito aquí no es una verdad absoluta, ni pretende serlo. Es el camino que he recorrido yo hasta conseguir un sistema de trabajo que me convence y que me permite no solo trabajar de forma holgada, sino hacer algo mas que trabajar de Lunes a Domingo.
¿Significa esto que no voy a necesitar contratar a nadie en el futuro? Todo lo contrario. Estoy loco por poder pagar a gente para que trabaje conmigo. Si todo sale bien voy a necesitar a muchos. Lo que no voy a necesitar es gente para cerrar incidencias exclusivamente. Necesitaré gente con agencia. Necesitaré un grupo de gente que tome decisiones, que dirija un enjambre de agentes. Personas a las que llegar con un problema, una duda, o una propuesta realmente estúpida y que me digan que no. No necesitaré subalternos, necesitaré iniciativa. No se si se ve la diferencia pero creo que es la base de la transformación que está ocurriendo en nuestra profesión.
¿Cómo escala entonces este sistema si en algún momento contratas gente? Esa es una buena pregunta y creo que la respuesta mas honesta es que todavía no lo se, pero me estoy preparando para cuando llegue el momento. Pensar que este sistema no va a cambiar en el momento en el que entre la primera persona a trabajar conmigo, sería bastante tonto, la verdad. Precisamente la moraleja de esta historia es que siempre hay alguien mas listo que tu, y a esos los quiero cerca. Ellos serán el agente del cambio real. Mi papel no es ser imprescindible sino ser un catalizador.
¿Cómo validas todo el trabajo que sale de este sistema? Como dije por ahí arriba, es imposible validar línea por línea todo el código que estoy manejando en estos momentos. Pero se puede hacer uno responsable de lo que hacen sus agentes, si pone especial cuidado en una serie de técnicas sencillas que ya todo el mundo conoce porque muchas son de la era pre-agéntica en el desarrollo de software. Pero hay una técnica concreta que para mi ha sido un factor diferencial: las revisiones adversariales. Enfrentar la opinión de tres modelos (Opus 5.5, GLM5.3-Flash y DeepSeek-v4-Flash en mi caso) funciona y es muy consistente. Por supuesto que hay veces en las que se mete la pata. Pero ¿acaso no lo hacíamos nosotros escribiendo código a mano? Hoy por hoy el sistema que he montado escribe mejor código que yo con 20 años de experiencia, si tenemos en cuenta la velocidad a la que lo escribe, las pruebas que pasa y que no tiene días malos como yo. Por esto decía en la pregunta anterior que no vamos a necesitar gente que cierre tickets, sino gente que aporte. Aunque esto no es de ahora. Al final de la era pre-agéntica quizá algunas empresas muy grandes si necesitaban ese tipo de empleado, pero desde luego en startups ese nunca fue el perfil.
Bonus track: ¿qué es una factoría de código 24/7?
En contra de lo que muchos puedan pensar, una factoría de código no es un batiburrillo de tecnología que escupe código sin parar las 24 horas del día. Mi concepción es otra.
Hefesto no trabajaba 24/7 en su forja, la tenía automatizada: autómatas de oro, cíclopes y fuelles mecánicos.
Una factoría de código es un oráculo. Si, hace el trabajo pesado de tirar líneas de código pero es lo que menos tiempo lleva. Las revisiones adversariales diría que ocupan el 65%-70% de las 24 horas del día. De cada día. Eso supone que un, pongamos, 70% del día se va en revisiones, tests, pruebas, comprobaciones y en enfrentar la opinión de tres LLMs sobre el misma arreglo. Para mí es la clave de todo.
La mayor parte del tiempo se va en comprobar el trabajo que se ha realizado, pero el rol de oráculo también abarca una "compresión" profunda del trabajo que se está realizando. La única forma de llegar a eso es a través de los meses. Trabajar día a día en mis proyectos va enriqueciendo el "corpus" que tienen mis agentes sobre cómo atacamos según que problemas en cada proyecto.
¿Recordáis aquel repositorio de GitHub del que os hablé, que hacía de histórico de decisiones y trabajo? pues es crucial también. Todos los agentes saben donde ir a consultar cuando hay que tomar una decisión. Y si la respuesta no está en el historial, entonces iniciamos una conversación en la que se aplica mi criterio y queda guardado.
Esto me permite tomar decisiones durante el día, o durante mi jornada de trabajo, y por la noche dejo que la máquina trabaje en la implementación y las revisiones adversariales. Por las mañanas tengo un resumen simplificado de qué trabajo se ha realizado y cómo probarlo.
¿Tengo un control granular de cada punto y coma que se ha puesto en el código? No, y no creo que sea ya necesario. De joven estaba obsesionado con aprenderme el código de memoria. Y lo hacía. Eso era muy efectista porque casi podía solucionar bugs de memoria y en tiempo real en una reunión. Pero francamente, no aportaba nada mas que engordar el ego y eso no acaba bien.
Hoy un LLM tiene mucho mas contexto y es mas rápido que yo. Por eso pienso que el valor ya no está en aprenderte de memoria un código sino en saber porqué se ha hecho de la manera en que se hizo. Hay una diferencia grande ahí. Pasamos de ser ejecutores a ser cerebros y en mi opinión eso es liberador.
Si os perguntáis por la mecánica del día a día: no, no uso PRs. Ya no me gustaban antes de la era agéntica porque se convirtieron en un sumidero de tiempo: discusiones infructuosas, suspicacias y a veces hasta odios. Sobre papel siempre han sonado muy bien, pero no nos podemos olvidar que trabajamos con seres humanos y como tal, somos imperfectos. Por eso opino que delegar en las máquinas el trabajo mecánico de hacer código es clave para una mejor relación humana en lo laboral.
Pero si no uso PRs ¿dónde está el histórico del trabajo? Mi sistema trabaja con tarjetas de Linear, que él mismo se escribe y se contesta. Me deja un histórico muy granular de cada tarea y subtarea, con pantallazos cuando es necesario. De tal manera que el repositorio de GitHub queda para que el LLM consulte lo que necesite, y en Linear yo puedo revisar el trabajo realizado a alto nivel. Escrito por un LLM para humanos, con la información necesaria, pero justa, para entender qué se ha hecho y porqué.
Gracias
Si has llegado hasta aquí solo puedo darte las gracias, porque posiblemente estés convulsionando de la tremenda turra que te has comido.
Como ves no hay nada de místico en cómo he llegado a tener una infraestructura 24/7 para trabajar, y aún así, cada día es mas sencillo alcanzar una comodidad relativa con todo este follón.
Para cualquier cosa, nos vemos por Twitter.