X 算法大更新!我翻完开源代码,整理出新手起号的 8 条做法和 老手犯错的10 个雷区!
文章目录
兄弟们,今天应该都在时间线上看到诸位朋友们在晒收益。
很多人的收益突破历史新高,这也说明创作者的算法和𝕏 算法都在更新。
但是,对于未来起号的新手和还没有达标的朋友们,可以通过查看新算法调整,而进行快速突破达到目标。
11 月 6 日晚上,Peter Mick(@ThePeterMick,3.5 万粉)发了一条长帖,标题是 X AI ALGORITHM UPDATE 🚨。
他说 X 的开源推荐算法前一天改了打分,点赞的权重涨到了历史最高,小号应该专心写「让人点赞、让人读完」的帖子。
我抓数据的时候,这条帖子是 46.1 万浏览、2,501 个赞、2,919 次收藏。
有意思的地方在这里:在 X 现在开源的排序打分公式里,收藏这一项的权重是 0。这条教你追点赞的帖子,是被一个算法不计分的动作推着走的。
我把他提到的数字一条条回到 X 的开源仓库里核对了一遍。
结论分两半:数字基本都是真的,但大多数人读这些数字的方式是错的。错在哪,正好决定了一个小号该怎么起、怎么养、什么事千万别碰。
这条推文到底说了什么
先把原帖的核心信息摆清楚。Peter 每天用 Claude 盯着 X 的开源仓库 xai-org/x-algorithm,有变化就发一条更新。11 月 5 日这次,是他说的「三周来第一次改分」:
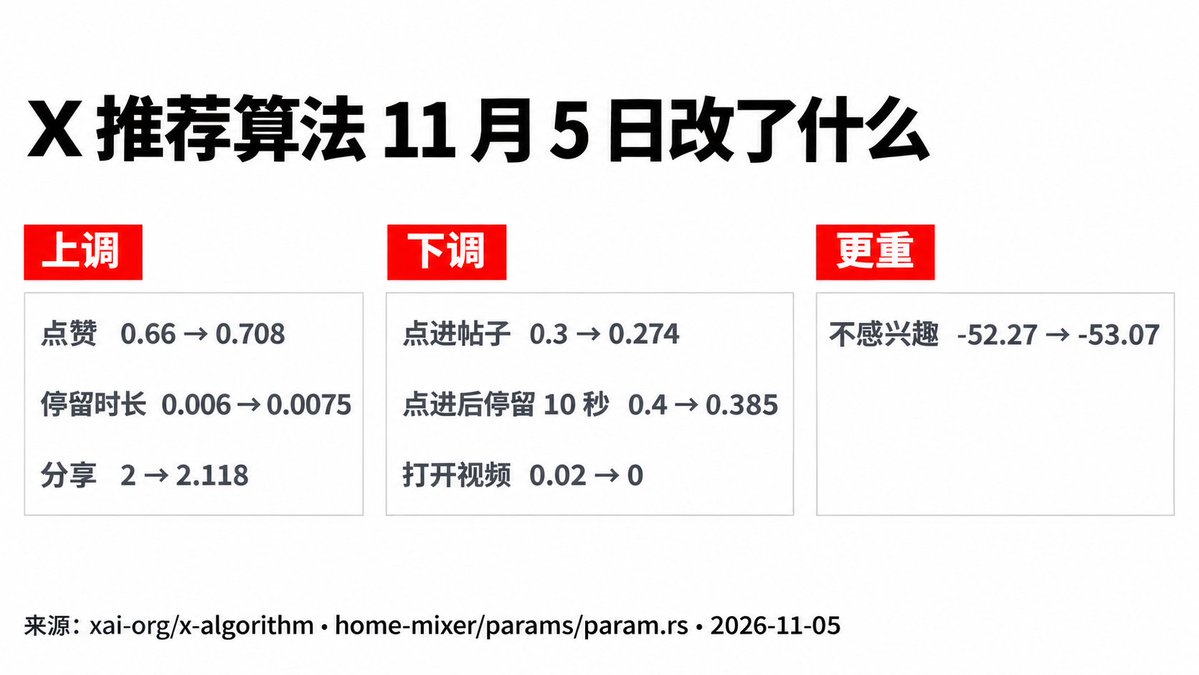
他的一句话总结是:「a tap isn't the win anymore. Someone staying and liking is.」点开不再算完全有效,留下来并点赞才算。
另外还有一条新规则引起了很多讨论:粉丝超过 25 万的大号下面,AI 生成的回复可能被打上 llm slop 标签,而且被打标签的回复和提及不会出现在对方的通知里,除非对方关注了你。
我去翻了代码:数字是真的
我把仓库克隆下来,对比了 11 月 4 日和 11 月 5 日两次提交里的 home-mixer/params/param.rs。上面表里 7 个数字,全部对得上,一个不差。
再往前翻提交历史,能看到一条很清楚的线:
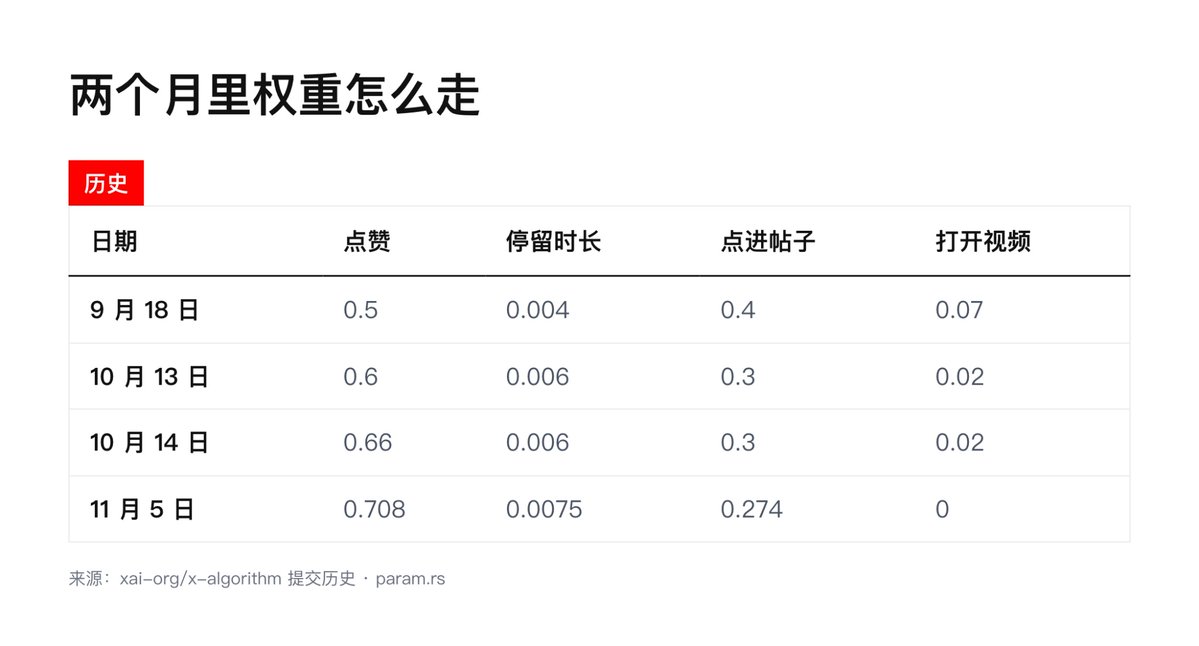
两个月里,点赞涨了四成,停留时长接近翻倍,点进和打开视频一路往下走。
方向从来没有反复过。这跟 X 自己在仓库 README 里写的更新日志也对得上:10 月 8 日,排序模型「更准地预测你会在每条帖子上花多少时间」;
10 月 13 日,给陌生人找内容的召回模型「也开始被训练去找那些被人读完的帖子」。
你可以把 X 想成一家餐厅的老板。以前他看的是有多少人推门进来,现在他只关心有多少人坐下来吃完了这顿饭,还给了好评。
他说的「新帖前 2 小时、前 200 次曝光有额外推力」,代码里也有。参数叫 ColdStart,写得明明白白:
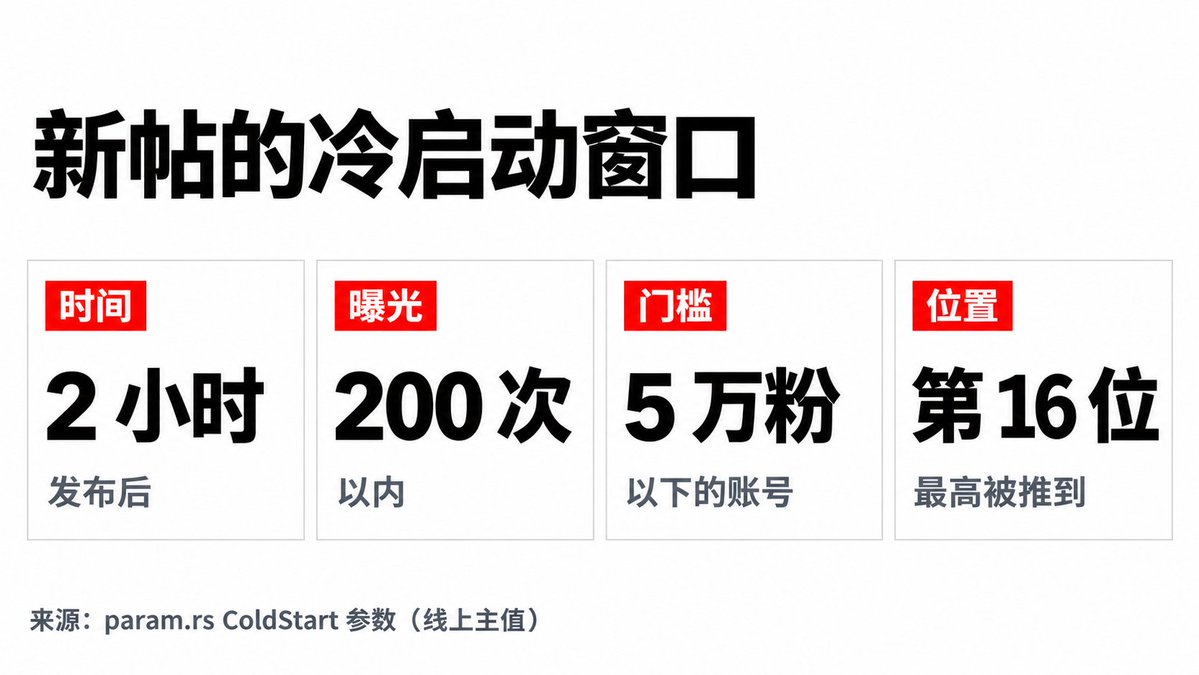
ColdStartMaxPostAgeSecs 是 7200 秒,也就是 2 小时;
ColdStartImpressionThreshold (冷启动)是 200;
ColdStartFollowerCap 是 50000;ColdStartSlotMax 是 16。
翻译成人话,就是粉丝 5 万以下的账号,发出一条新原创,在头 2 小时、头 200 次曝光之内,最多能被抬到别人信息流的第 16 位左右。
llm slop 也是真的,天天看到AI slop 回复这一次直接明确进行精准打击👊!
在 abuse-enforcement-service 的规则文件里,有一条规则写着:只要帖子被判成 llm_slop_post,就加上 RiskyHighVizReply(高曝光位置的风险回复)标签,有效期 2592000000 毫秒,正好 30 天。
有几条我没能在代码里核到,诚实地标出来。
25 万粉这个门槛,开源规则文件里写的是一个故意填的假值 12.34,旁边注释写着「线上用的是另一个阈值,这里是假数据,防止有人钻空子」。
所以「25 万」可能来自别的文件,我没找到原始出处。
同一作者第二条帖子降到 62%、第 1 个赞和第 32 个赞各打开一条新路径、视频在 64 和 512 个赞时复查,这几条我没有在仓库里找到对应的参数,下面引用时都会写明是 Peter 的说法。
这不是说他错了。他每天读这个仓库,比我熟。只是写文章要分清楚,哪些是我亲眼看到的,哪些是转述。
但「点赞值 0.708 分」是个误读
这是整件事里最反直觉、也最重要的一段。
几乎所有转发这条推文的人,都在用「积分」的方式理解这些数字:一个赞 0.708 分,复制链接 20 分,回复 5 分,一次「不感兴趣」扣 53 分。照这个算法,你只要拉 100 个朋友来点赞,就能攒出 70 分。
X 自己在代码注释里,专门写了一大段来否定这种理解。原文在 param.rs 的权重定义上方,我直接翻译过来:
每个权重乘的是这个动作的预测概率(比如 P(点赞)、P(转发)),或者一个连续值(比如观看时长),不是乘原始的互动次数。一个常见的误解是把权重的比值当成次数换算,比如「一次举报抵消 468 个赞」,这是错的。
紧接着还有一段,更直接:
一次互动要被推荐系统计入,必须发生在首页时间线推给你的帖子上。直接点链接进去(比如在群聊里约好一起去互动)对排序没有任何影响。
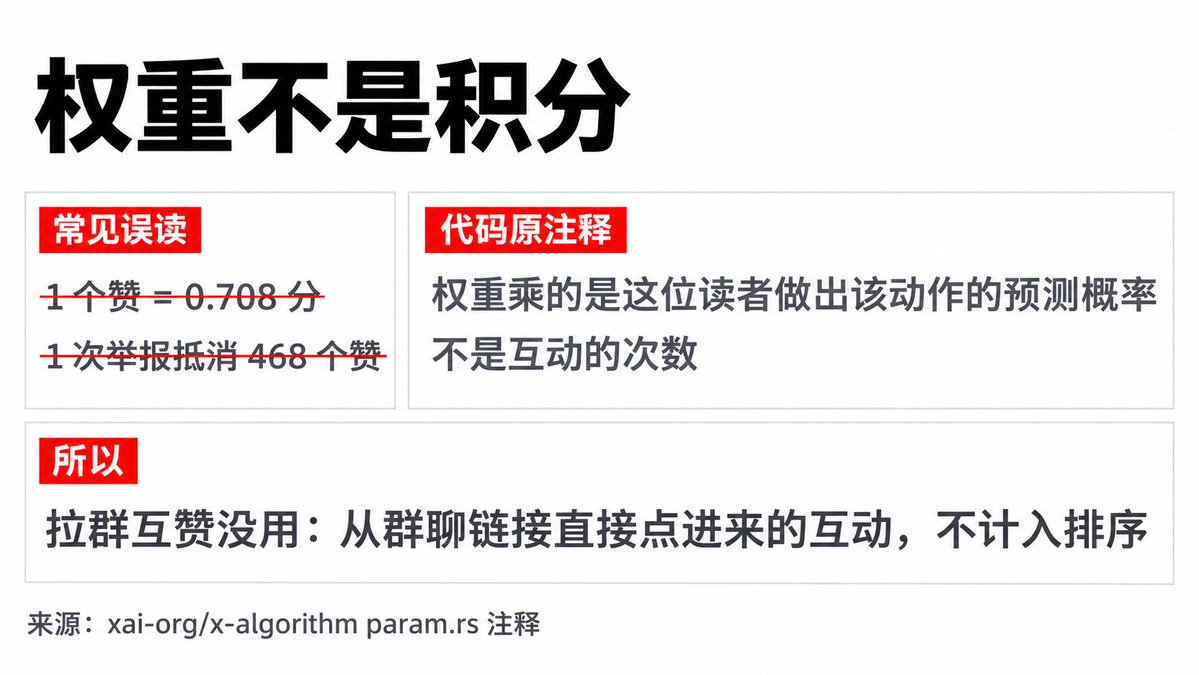
所以这些数字真正的意思是这样的。
X 在决定要不要把你的帖子推给某一个具体的人时,会先预测:这个人看到它,点赞的概率有多大、会停留多久、会不会点「不感兴趣」。
然后用这些权重,把几个预测值加权求和,得到这条帖子对这个人的分数。
点赞权重从 0.66 涨到 0.708,意思是「这个人可能会点赞」这件事,在排序里更值钱了。它跟你帖子下面已经有多少个赞,不是一回事。
我更喜欢用考试来理解。权重像是一张试卷各题的分值,预测概率像是老师判断「这个学生大概率能答对这题」。分值再高,学生答不对也拿不到分。你没法通过多印几张答题卡来提高分数。
这一段对小号的意义,比任何一个数字的涨跌都大:
互赞群、刷量、拉人点赞,在这套系统里基本是白费力气。
不是因为平台在严查,而是因为从群聊链接点进来的互动,压根不进排序。你能影响的只有一件事,就是让「正确的那批人」看到你的帖子时,真的想点赞、想读完。
还有一个顺带的好消息。很多人担心被恶意举报就会被限流,同一段注释里也写了:推荐是个性化的,恶意举报主要影响的是「和这些举报者相似的人」看到的推荐,不会让所有人都看不到你。
收藏是 0 分,可 Peter 是被收藏推起来的
回到开头那个矛盾。
我翻了 Peter Mick 最近两周的帖子,他的「算法更新」系列有三条主帖:
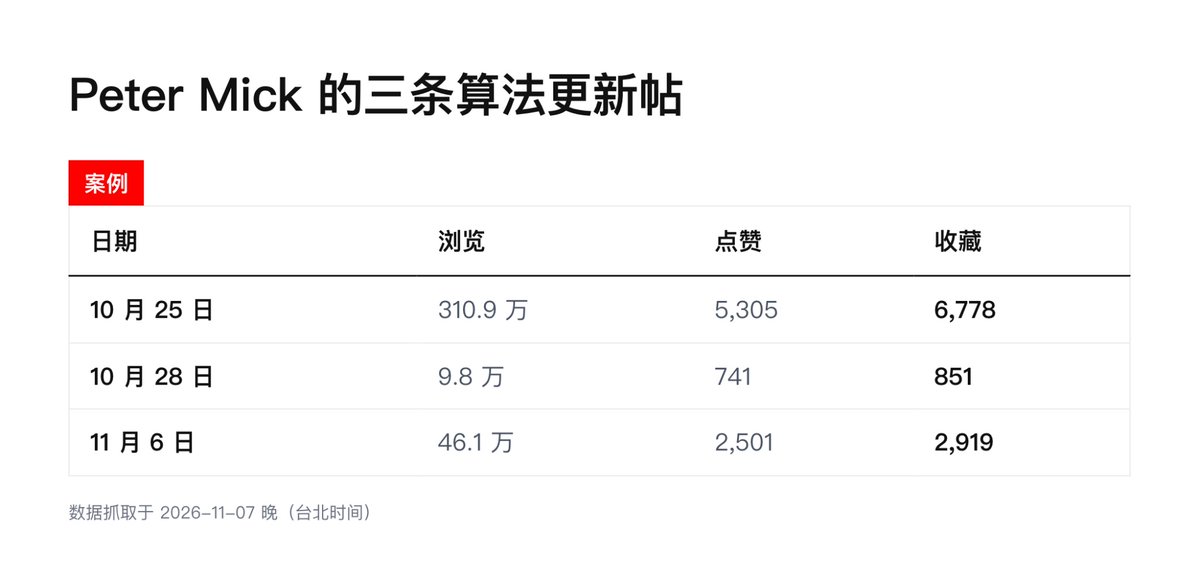
三条全都是收藏多于点赞。
而在排序打分的权重表里,我从头到尾找了一遍,有点赞、回复、转发、引用、私信分享、复制链接、关注作者,还有一长串负面信号,就是没有收藏。
仓库里唯一出现收藏的地方,是一个读取互动计数的模块,它只负责把数字取出来。
这就是第一个反共识:一个帖子在算法里拿高分的原因,和一个账号能长大的原因,不是同一件事。
收藏不进排序,但收藏说明这条内容「以后还用得上」。用得上的内容,才会让人回来看你的下一条、点进你的主页、点下关注。关注作者在权重表里是 4,而且关注带来的是以后每一条帖子的基础曝光。
Peter 的增长,靠的从来不是某一条帖子的点赞,而是一个格式。
你看他的发帖记录。10 月 31 日,他发了一条「今天没有重大算法更新 🚨,大家照常」,11 月 1 日又一条「又是没有重大更新的一天」,11 月 3 日一条「今天没有值得分享的更新,只是证明我每天都在帮你盯着」。
这几条帖子各自只有一千来次浏览、十几个赞,按算法看几乎是失败品。
但它们在做一件更重要的事:告诉关注他的人,这个号是一个每天准时更新的信息源。就像报纸的天气预报栏,晴天也要登,读者养成的是每天翻到这一页的习惯。
他的帖子结构也几乎固定:一行标题加警报符号,一句话的 tl;dr,一句「lesson learned」,然后是详细解释,最后是两张清单,「你应该做的」和「你不该做的」。
读者不用读完就知道这条在讲什么,想细看的人可以一直往下读。这正好同时满足了算法最看重的两个东西:愿意点赞,愿意停留。
在 10 月 25 日那条 310 万浏览的帖子下面,他第二天补了一条:喜欢这类内容就订阅我的免费通讯。流量最高的那一刻,他把一部分读者导到了一个不归 X 算法管的地方。
这才是一个完整的起号模型:一个能持续的格式,一个具体的信息源角色,一个把公域读者变成自己读者的出口。 点赞权重是 0.66 还是 0.708,在这个模型里是最不重要的那个变量。
起号:从 0 到第一批读者
把代码和 Peter 的案例放在一起,小号起步阶段能做的事情其实很清楚。
第一,只有原创能走出你的粉丝圈。
Peter 原话是「strangers only get shown your originals」,陌生人只会刷到你的原创。回复和转发能维护关系,但几乎不会带来新人。起号阶段,原创帖是唯一的获客渠道。
第二,把冷启动窗口用在读者在线的时候。
新帖的额外推力只有 2 小时、200 次曝光。凌晨三点发帖,等于在读者睡觉的时候把唯一一次试镜机会用掉了。先去看你现有读者的活跃时段,再定发帖时间。
第三,第一行负责被点开,后面负责留住人。
停留时长两个月涨了接近一倍,打开视频的权重直接归零。标题党能骗来一次点开,骗不来停留,而骗来的点开越多,被点「不感兴趣」的概率也越高,那一下是 -53.07。
第四,选一个具体的角色,而不是一个宽泛的领域。
「AI 博主」是一个领域,「每天帮你盯 X 开源算法的人」是一个角色。
角色有更新节奏、有固定格式,读者知道为什么要关注你。领域只会让你和几万个同类账号挤在一起。
第五,一次只发一条好的。
Peter 的说法是,同一个人的信息流里,你的第二条帖子只算 62%。不管这个具体数字线上是不是这样,连发多条确实会让它们互相抢同一个位置。与其一天发五条平庸的,不如一条认真写完。
养号:先别让账号被打上标签
起号是加分,养号更多是避免扣分。X 现在大部分的「限流」,都以标签(label)的形式存在,而且你可以自己查。
X 在 10 月 30 日更新了 Under the Hood 功能(入口 x.com/i/jf/under_the_hood),会列出你的账号和帖子在过去一个月被打上的、影响可见度的标签。
被打标签的帖子少于你发帖总数的 5% 时,还会把具体是哪几条列出来。觉得自己被限流了,先去这里看,而不是在评论区猜。
几类最容易踩的标签,Peter 在两条帖子里反复提到:
被标成「低质量」或「错误信息」的帖子,不关注你的人看到时会带一个警告,而且没法点赞、回复、转发、收藏或分享。
被标成「侮辱」的帖子,非关注者完全看不到。账号最近 5 条帖子里有 3 条带成人内容,整个账号会被打标签。
置顶帖里放了一个评级很差的网站链接,可能给整个账号带来 7 天的标签。
这几条是 Peter 的整理,我没有逐条在代码里核到,但方向和 X 公开的规则一致。
我能确定的是 llm slop 那条。规则文件里,被判成 AI 废话的帖子会挂 30 天的风险标签;
账号层面也有一个 llm_slop_user 的判定。在大号下面用 AI 批量刷回复引流,过去是一个流行的玩法,现在它会让你的回复变成别人看不到的回复,严重的会让整个账号被归类。
还有一条很多人没意识到:粉丝足够多、或者被 X 判定为高可信度的账号,可以跳过这类检查,小号没有这个豁免。
规则文件里确实写着「粉丝数足够高就跳过」和「可信度足够高就跳过」两条规则,Peter 还补充说灰色认证标识的账号也在豁免之列。
同样一句 AI 味很重的回复,大号发了没事,你发了可能就被标记。这不公平,但这是现实。
增长:可以照做的事
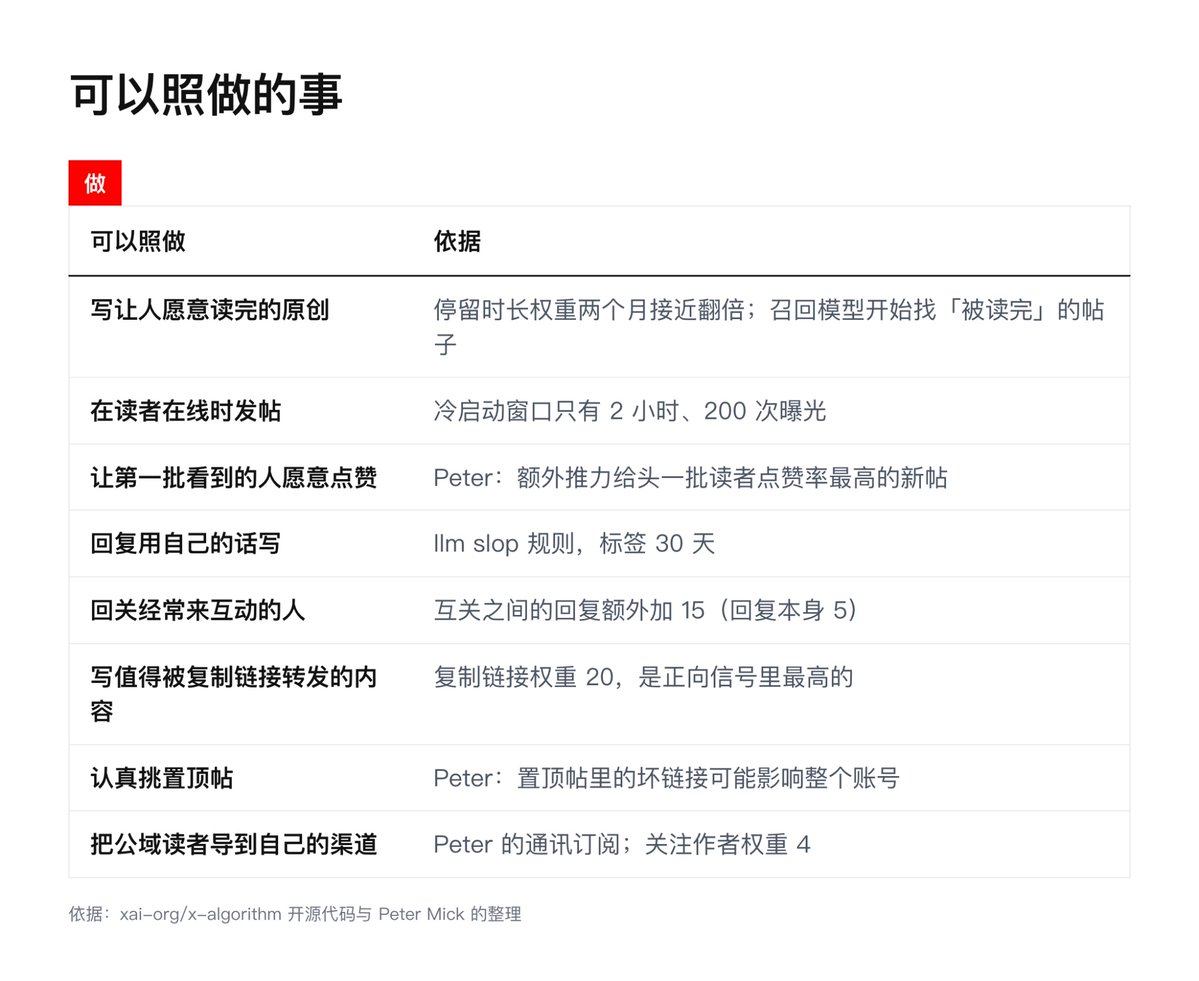
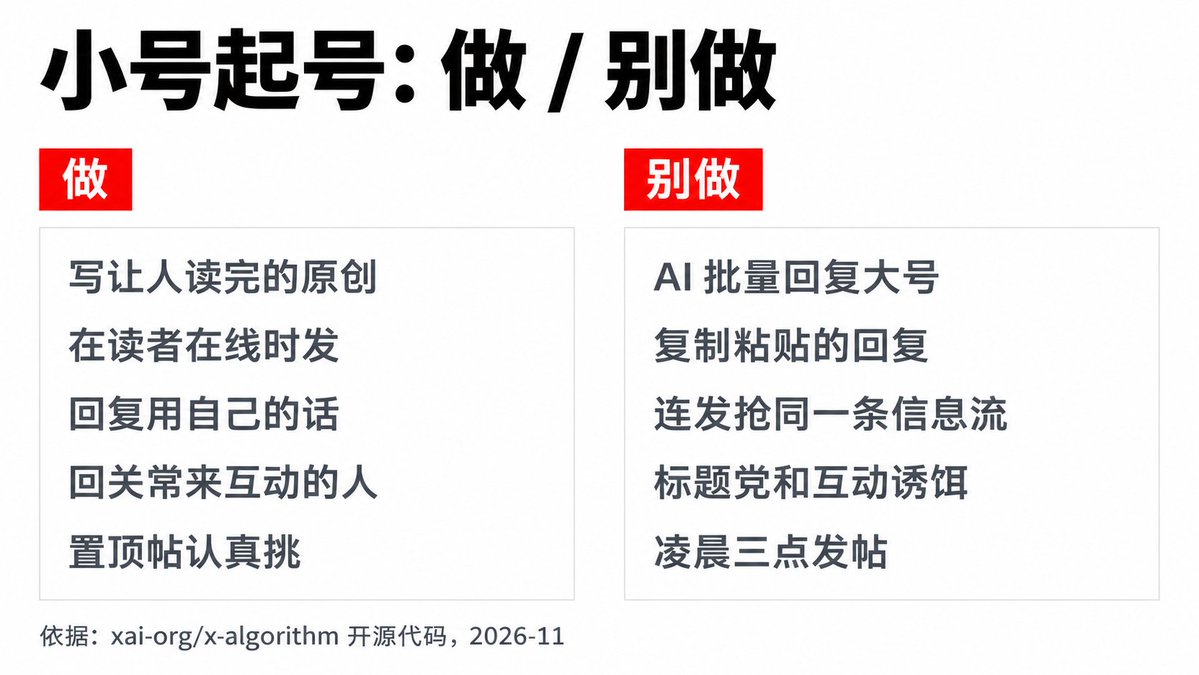
把上面所有内容压缩成一张能执行的清单:
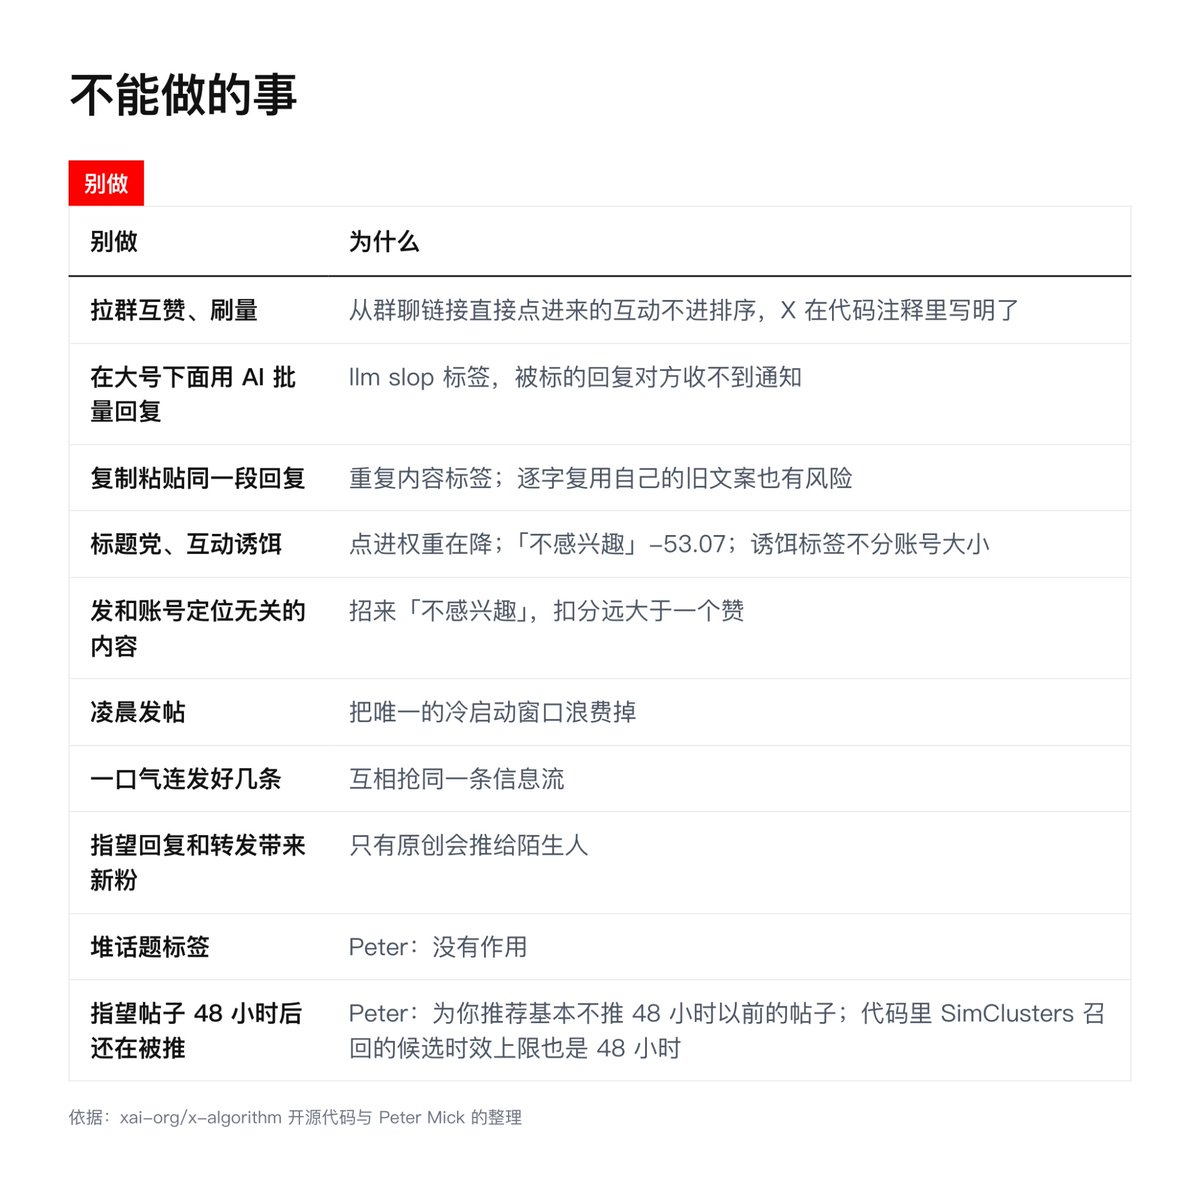
不能做的事
最后,关于那 2,919 次收藏
写到这里,我反而更理解为什么 Peter 那条帖子的收藏比点赞多了。
算法给点赞打 0.708 分,给收藏打 0 分。读者却用收藏告诉你,这是一条他打算以后再回来看的东西。
前者决定一条帖子今天能走多远,后者决定一个人明天还会不会回来找你。
X 的代码改了一整个秋天,每一次改动都指向同一个方向:奖励那些让人停下来、读下去的内容。这听起来像是算法在变,其实是它终于在用代码,描述一件做内容的人早就该知道的事。
下次再看到有人说「X 算法又改了,赶紧这样做」,你可以先去仓库里看一眼数字是不是真的,再问自己一个问题:如果明天这些权重全部清零,我的读者还会不会来?
参考来源
-
Peter Mick 原帖(2026-11-06):https://x.com/ThePeterMick/status/2118845386890592562
-
Peter Mick 10 月 25 日、10 月 28 日的算法更新帖:https://x.com/ThePeterMick/status/2114368194546696576 、https://x.com/ThePeterMick/status/2115554277343064310
-
X 开源推荐算法仓库:https://github.com/xai-org/x-algorithm (home-mixer/params/param.rs、abuse-enforcement-service/service-lib/rules/、README 更新日志)
-
@XOpenSource 关于 Under the Hood 的公告(2026-10-30):https://x.com/XOpenSource/status/2116262141745565826
-
互动数据抓取时间:2026-11-07 晚(台北时间),后续会变化
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。