
Agent 高频题 14. ReAct 和 Plan-and-Execute:原理、缺点、怎么选
文章目录
字节一场二面问得最直接:什么是 ReAct,流程是什么,有什么缺点?
快手一场二面往前走了一步:ReAct 和 Plan-and-Execute 分别适合什么场景,能举个例子吗?在你的项目里,怎样选择或组合这两种模式?
美团一场后端一面问到了后半段:ReAct 为什么不适合大型复杂项目?如果整体用 Plan,初始 Plan 就错了,或者中间某一步确认以后发现有问题,怎么办?恒生的 AI 面试官追得更细:你说每一步之后要反思是否重规划,判定标准怎么定,才不会让模型频繁推翻原来的计划?
定义一两句就能说完。往下问,才问到两种模式各在哪里出问题、怎么按任务选、计划错了怎么办。
这是 Agent 高频面试题单第 14 题的详解。题单里这题是 29 位作者、32 场面试。这次和第 12、13 题一样,重读库里记过的牛客链接,共 516 篇。按 ReAct、Plan、Planner、Executor、Critic、重规划这些词找出 83 篇,按规划、拆解、范式、编排、循环这类词又找出 187 篇,命中的问题逐条读过,再用自主决策、漂移、长任务、主流架构、Spec 这类词扫了一轮补漏。前端的 React、Reactor 模式、线程池的 Executor、职业规划、动态规划都去掉了;只问 Agent Loop、不提 ReAct 的归第 9 题。剩下问到这道题的有 62 场、50 位作者。追问分九个方向(按作者数,一场可以算进几类):
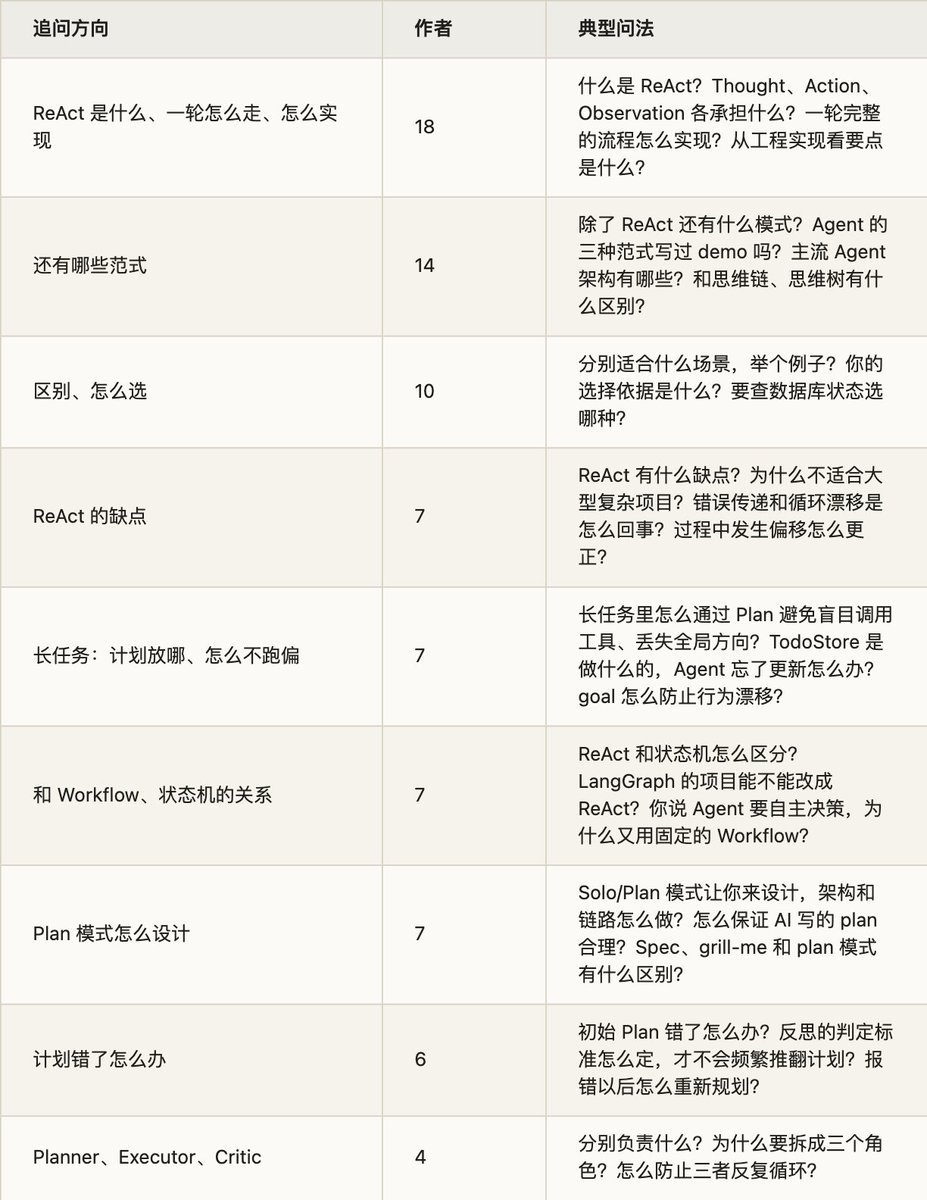
问得最多的是 ReAct 本身,不少只是一句「了解 ReAct 吗」。
下面先把几个词说准,再讲两种模式各自的缺点、怎么选、怎么组合,然后是计划错了怎么办、长任务的计划放哪、三个角色、别的范式、AI Coding 的 Plan 模式,最后看模型变强以后还要不要计划。Agent Loop 的写法第 9 题讲过,工具失败第 11 题讲过,多 Agent 和 Critic 第 3 题讲过,Workflow 怎么选第 23 题、死循环第 28 题单讲,这里只讲它们和规划有关的部分。
一、先把几个词说准
- 一条轴:下一步什么时候定
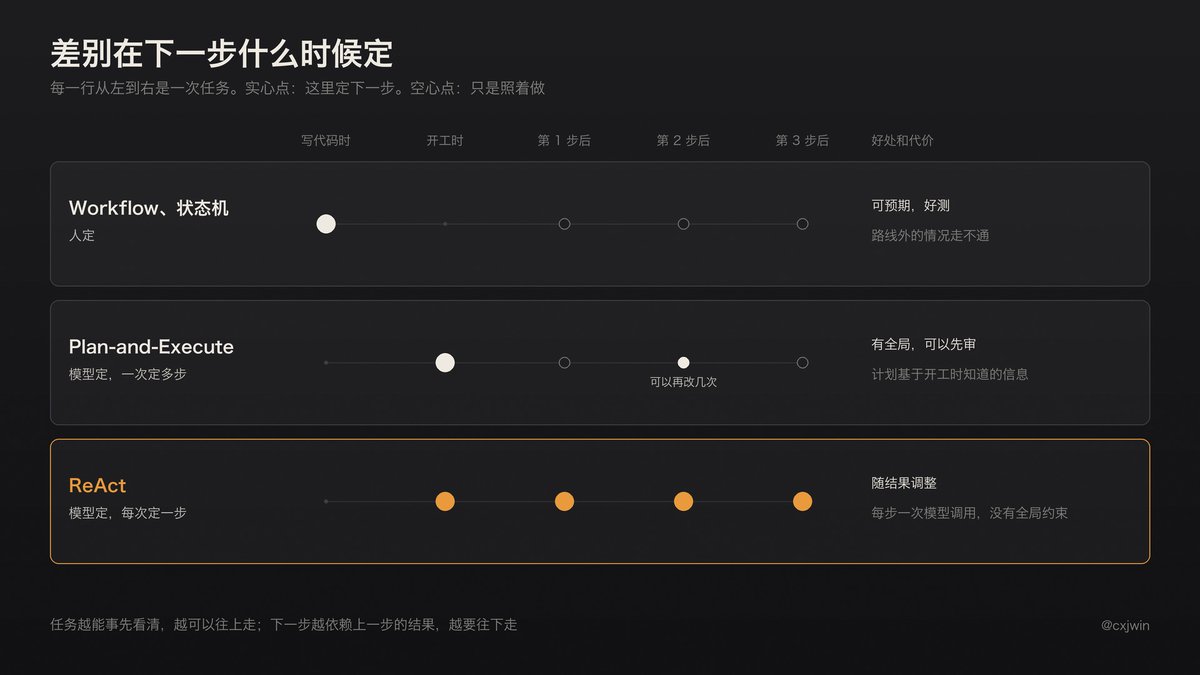
这几个词放到一条轴上比较好分:下一步做什么,是什么时候定的,谁定的。
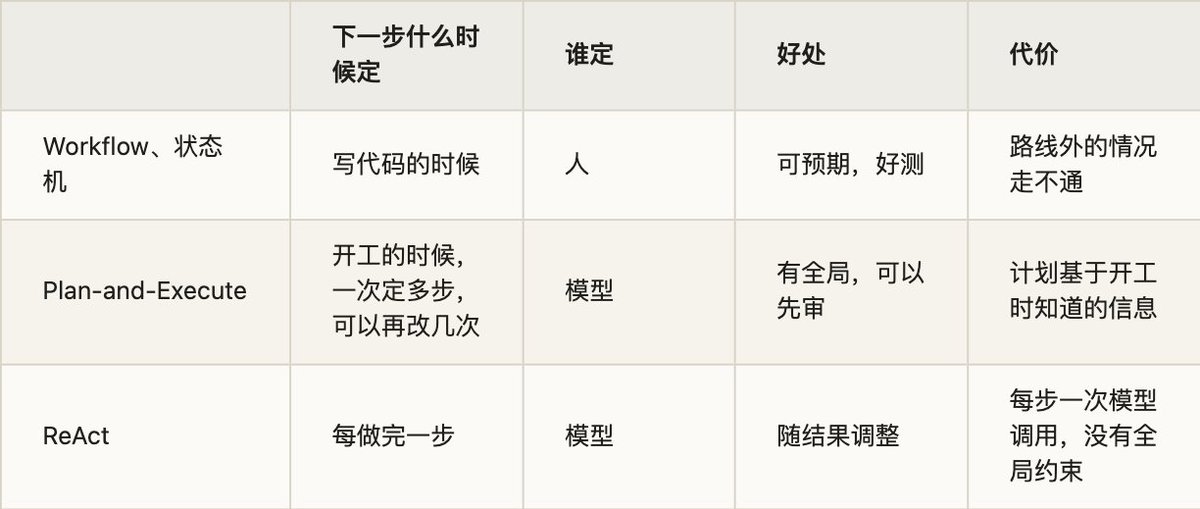
这张表是我的归纳,不是哪篇论文的分类。任务越能事先看清,越可以往表的上面走;下一步越依赖上一步的结果,越要往下面走。
- ReAct 论文做了什么
ReAct 是 Reason + Act,出自 2022 年 10 月 Yao 等人的论文(ICLR 2023)。它和前端框架 React 没有关系,和经典 AI 里的「反应式 Agent」也不是一回事。面经里常写成 react,同一场面试可能两个都问,字节那场二面就是前半段问 React Native,后半段问 ReAct。
当时有两条路。一条是思维链(CoT),只推理不动手,事实全靠模型自己记,容易幻觉。一条是只动手不推理。ReAct 让两者交替:
Thought: 要回答这个问题,先查 X 是哪一年成立的
Action: Search[X]
Observation: X 成立于 1998 年……
Thought: 还要查 Y
Action: Search[Y]
Observation: ……
Thought: 两个都有了,可以回答
Action: Finish[答案]
Thought 是模型写给自己的,不碰外部环境,也没有返回。Action 才调工具。Observation 由环境返回,下一个 Thought 接着它写。
论文的主要结果,注意 HotpotQA 那行 ReAct 比 CoT 还低一点:
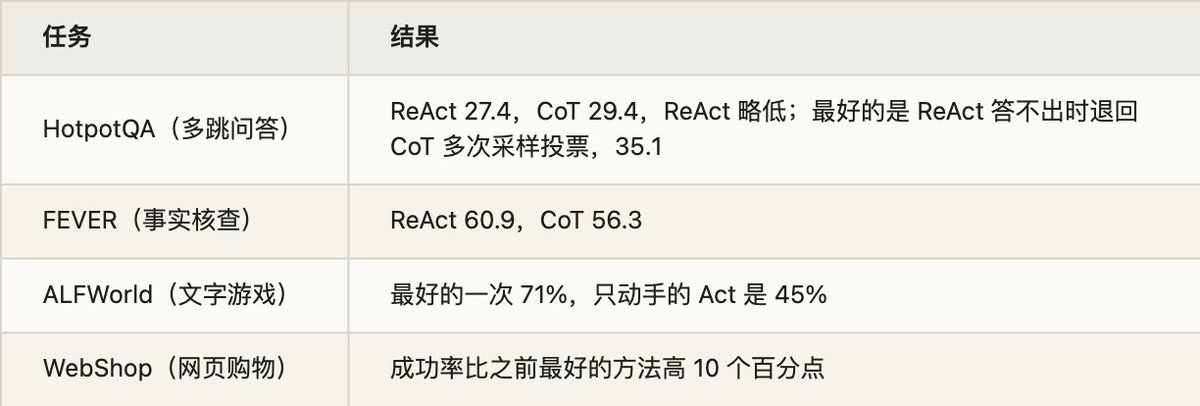
论文还人工标了 HotpotQA 上 200 条轨迹的成败原因。失败里,CoT 有 56% 是幻觉,ReAct 是 0;ReAct 有 47% 是推理错误(CoT 是 16%),另有 23% 是搜索没拿到有用的内容。论文单独提了一种 ReAct 特有的错:反复生成前面的想法和动作,跳不出循环。
所以 ReAct 换来的是事实有依据,代价是推理路径受约束。这些是 2022 年 PaLM 上的数字,不能当今天模型的水平。这几类错误今天还见得到,下一节接着讲。
百度搜索后端那场问了一句 RAG 和 ReAct 的区别,候选人自己也觉得不好类比。可以这样答:RAG 是程序固定检索一次再生成;ReAct 是模型决定查不查、查什么、查完够不够。把检索做成工具放进循环,就是常说的 Agentic RAG。
- 今天的 ReAct 长什么样
论文靠文本格式,程序要从输出里解析 Action:,LangChain 2022 年底的第一批 Agent 也是这样(第 10 题)。现在模型原生支持工具调用,三样东西换了形态:
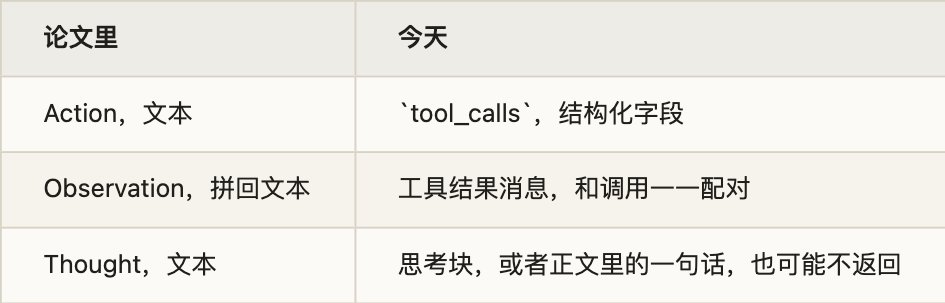
Thought 现在常常不在正文里了。Anthropic 2025 年 3 月发过一个 think 工具,让模型读完工具结果后停下来想一想,后来在文章开头补了一段更新:多数情况用 extended thinking 就够了。Claude Fable 5.1 的文档写的是,模型在工具调用之间的简短说明以 thinking 块返回,默认设置下内容是空的,要打开才看得到。
代码就是第 9 题那十几行循环。Claude Code 文档的说法是三个阶段(收集上下文、动手、验证)交织进行,下一步做什么取决于上一步学到了什么。
所以我会这样区分:ReAct 是这种决策方式的名字,Agent Loop 是它的工程形态,Harness 是让它跑得住的外围。淘天日常那场问的「Harness 相比 ReAct 多了哪些能力」,可以从这里接到第 9 题。
OPPO 一面问得细:从工程实现看 ReAct 的要点是什么?除了 Loop 和 Function Calling,还有什么驱动这套循环?上一轮结果怎么传?每次生成的文字都往上下文里塞吗?可以答这几条:
-
上下文就是状态。模型每轮只看得到发给它的那些消息,上一轮结果靠工具结果消息传回去,消息怎么组装决定了它知道什么。虾皮问的「为什么要单独设计 Tool Message」也在这里:工具结果要和调用配对,模型才分得清这是工具返回的,不是用户说的。
-
不是什么都塞。工具结果要裁剪,原文落盘(第 5 题)。
-
循环有两个出口。模型不再调工具,或者循环替它停(第 9、28 题)。
-
工具报错也是 Observation。报错送回给模型,它才有机会改(第 11 题)。
- Plan-and-Execute 从哪来
这个名字来自 LangChain 2023 年 5 月的一篇博客,文中说受 BabyAGI 和 Plan-and-Solve 论文启发。
Plan-and-Solve(Wang 等,2023)是纯提示技巧:zero-shot CoT 有漏步骤的毛病,就让模型先把任务拆成子任务,再按计划做。它没有工具,实验用的是 GPT-3。
LangChain 那篇把它工程化,分成 Planner 和 Executor。Planner 几乎总是模型。Executor 在初版里就是一个 ReAct 风格的 Agent,接过一步,自己决定调什么工具。所以 Plan-and-Execute 从一开始就是外层计划加内层 ReAct。那版的计划定了就不再回头,文章把「回头改计划」列在未来方向里。2024 年 2 月的 LangGraph 版本补上了:执行完再问一次模型,是结束,还是出一版后续计划。
plan = planner(task)                        # 一次列出多步
done = []
while plan:
    step = plan.pop(0)
    result = react_agent(step, task, done)  # 这一步内部是一个小循环
    done.append((step, result))
    decision = replanner(task, done, plan)  # 结束,还是改剩下的计划
    if decision.finish:
        return decision.answer
    plan = decision.plan
这是我按那篇的结构写的示意。每一步后面都问 replanner 代价不小,第六节讲怎么少问。
- 几个容易混的说法
-
Plan-and-Solve 和 Plan-and-Execute:前者是提示技巧,后者是带工具的架构。名创优品那场问的就是「ReAct 和 Plan and Solve 分别负责什么」。
-
Plan-Then-Execute:安全文献里的说法,要求计划定了以后,工具结果不能改变调什么工具,比一般的 Plan-and-Execute 严(第四节)。
-
Todo:模型在循环里写一张清单,下一步还是每轮定,所以还是 ReAct,只是多了一份状态(第七节)。
-
Plan Mode:产品里的权限模式,规划时不能改东西,批准后才能动手(第十节)。
面试常问:什么是 ReAct,流程是什么?ReAct 范式的核心思想是什么?Thought、Action、Observation 分别承担什么作用?一轮完整的 ReAct 流程怎么实现?用户发一个任务到完成,中间经过哪些处理?怎么设计一个 ReAct 流程?从工程实现看要点是什么?除了 Loop 和 Function Calling,还有什么驱动这套循环?上一轮结果怎么传?你用的 ReAct,工具调用是基于什么框架实现的?RAG 和 ReAct 的区别?基于 ReAct 设计排障循环时,工具链和提示词怎么配?
二、ReAct 的缺点
字节那一问。南方基金的题目里写着「错误传递和循环漂移」,是其中两条。
- 只看下一步
LangChain 2024 年那篇讲的缺点之一:模型一次只规划一个子问题,没有被要求想完整个任务,路径可能不优。
表现出来可能是范围缩水。Anthropic 2026 年 3 月的长任务实验里,不给 Planner,Opus 4.6 拿到原始需求就直接开工,做出来的应用功能比有 Planner 时少。也有反方向的失败,Anthropic 2025 年 11 月那篇记的是:Agent 想一口气把应用做完,做到一半上下文用光,留下半成品;后面接手的实例看到已经有进展,又可能直接宣布做完了。
- 错误会往下传
论文摘要说 ReAct 克服的正是 CoT 的错误传递,因为有外部事实可以校正。但它有自己的版本:搜索没拿到有用内容的情况占错误的 23%,论文说这会让模型的推理脱轨,很难恢复。工具结果一旦进了上下文,后面每一步都站在它上面。第 13 题讲「找第一处走偏」就是这个原因。
名创优品问:ReAct 过程中发生偏移,怎么有效更正?分几层:
-
能用代码判的,在工具层判,报错里写清哪里不对(第 11 题)。
-
关键节点插校验,不等到最后。
-
目标和约束放在窗口外,定期带回来(第七节)。
-
已经走偏就回退,别在原地接着纠正。Claude Code 的文档说,同一件事纠正两次还不对,第三次纠正基本只是让模型再多读一遍失败的尝试,清掉上下文、把学到的写进一条新提示,效果更好。
- 打转和漂移
这两种要分开。打转是同一个工具、差不多的参数反复调,代码能检测,第 28 题单讲。漂移是每一步都说得通,合起来离目标越来越远,代码看不出来,只能靠目标和验收(第七节)。这个区分是我的,论文里记的是前一种。
- 每步一次模型调用
每调一次工具就要问一次模型,每次都重发整段上下文(第 12 题)。LLMCompiler(2023 年)拿 ReAct 做基线,报告延迟最多快 3.7 倍,成本最多省 6.7 倍。
这一条现在要重算。模型原生支持一轮发多个工具调用,能并行的不用多问(第 11 题第六节);前缀缓存把重发的成本压下去很多(第 12 题);推理也在变快,我八月写 API 速度那篇时的判断是,吞吐跨过 1000 TPS,挂上 20 步的 ReAct 循环就不用犹豫了。所以别把「慢、贵」当 ReAct 的固定属性,要带上模型、缓存和任务一起算。
- 长了会丢目标
TravelPlanner(2024 年)给语言 Agent 出多约束的旅行规划题,GPT-4 的成功率只有 0.6%,论文总结的问题是守不住任务、用不对工具、记不住多个约束。这是早一代模型。Manus 2025 年也提到目标落在上下文中段容易被忽略,他们的办法第七节讲。第 5 题讲过的压缩也可能丢约束。
- 事先看不到,工具结果能改路线
下一步是读完工具结果才定的,所以开工前没法让人审全部动作。网页、邮件里如果藏了注入,也能影响它下一步调什么工具。第四节讲怎么办。
- 「不适合大型复杂项目」怎么答
美团那一问。我会先把范围说准:只有循环、没有外部状态、没有验证的裸 ReAct 不适合。但 Claude Code 这类能连续跑几小时的 Coding Agent,最底下还是这个循环,外面加了压缩、子 Agent、验证和可选的计划。所以大型项目要补的是下面这些,不一定要换掉主循环:
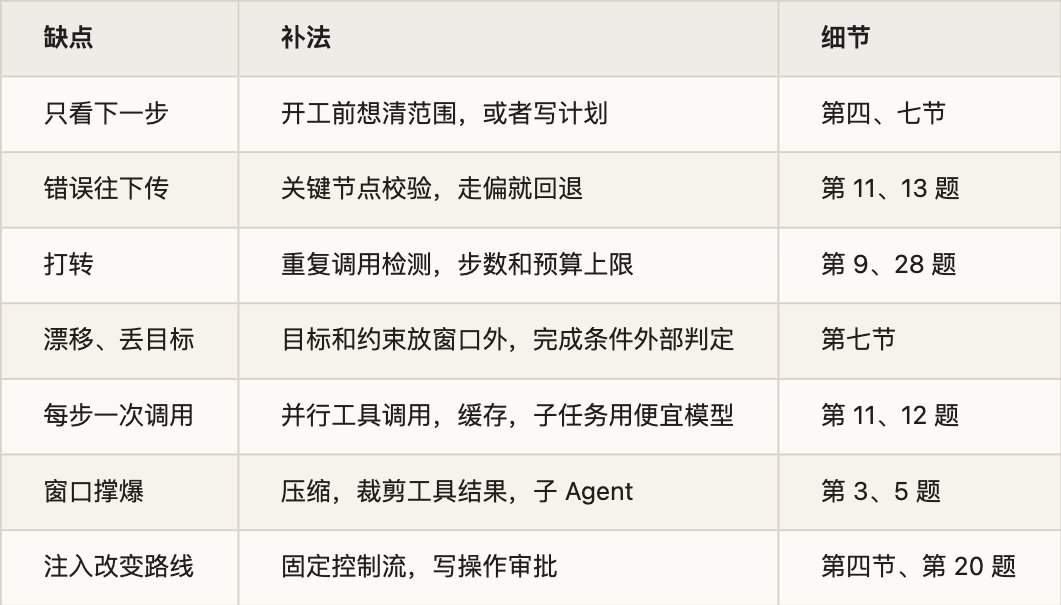
面试常问:ReAct 有什么缺点?ReAct 为什么不适合大型复杂项目?ReAct 的错误传递和循环漂移是怎么回事?ReAct 过程中发生偏移,怎么有效更正?ReAct 怎么避免一直循环?主循环怎么设计,怎么防死循环?原来的纯 ReAct 方案只是工具调用不稳定吗,还有哪些问题?这个场景直接用 ReAct 加工具能满足吗?
三、Plan-and-Execute 的缺点
面经里直接问它缺点的不多,多半藏在「计划错了怎么办」里。
- 计划写在知道得最少的时候
开工时信息最少,这时候定的计划最容易错。Thariq Shihipar 那篇 Field Guide 我翻译过,他的说法是,不管事先计划得多充分,执行时总可能碰到没想到的边缘情况,逼着 Agent 改方向。恒生问的「初始计划很快失效的开放场景」就是这种情况。
- 计划错了,错得更远
Anthropic 那个实验里,Planner 被要求只写产品和高层技术设计,不写实现细节。理由是如果它一开始把技术细节定死又定错,错误会一路传到后面的实现。文章的做法是约束交付物,路径让 Agent 边做边想。
也就是说,错误传递在 Plan-and-Execute 里同样存在,只是源头提前到了计划。计划写得越细,能出错的地方越多。
- 调用不一定少
LangChain 自己的两篇说法就不一样。2023 年说主要缺点是调用多得多;2024 年说更快更省。两句都对,差别在 Executor:每一步还要问模型,就多了规划和重规划的调用;步骤能直接跑,或者交给便宜模型(第 12 题第五节的分层),才省。
规划本身不一定贵。Anthropic 那次 4 小时、124 美元的运行里,Planner 只用了 4.7 分钟、0.46 美元,钱花在后面的构建上。
- 执行者看不到全局
Executor 拿到的是一步的说明。前面为什么这么定、哪些约束不能碰,不写下来就没了,和第 3 题说的多 Agent 传话是同一个问题。所以每一步要带上总目标和约束,交接走文件。OpenManus 的 PlanningFlow 是每步把整份计划状态和当前步骤一起发给执行者,Anthropic 那个实验是几个 Agent 之间读写文件。
- 计划本身可能不可行
Kambhampati 等人 2024 年的立场论文认为,LLM 自己做不了规划,也做不了自我校验,要配外部校验器。这是早一代模型上的观点,今天的模型未必还这样,但工程结论还能用:计划里能校验的部分交给代码,工具存不存在、参数满不满足、依赖有没有环、预算够不够。影石那位候选人事后整理的答法也是模型出计划 JSON,策略引擎校验后再执行。AI Coding 场景的做法见第十节。
- 简单任务不值得
Anthropic 的 Building Effective Agents 建议从最简单的方案开始,需要时才加复杂度。一两步能做完的事走一遍规划,只是多了一次调用和一段等待。
面试常问:有没有用 Agent 做过整个决策规划?你想把推理判断全部交给 Agent 吗?怎么放大它的能力做长任务,任务规划得准确、拆解清楚?
四、怎么选:先问计划要干什么
容易想到的答法是「简单用 ReAct,复杂用 Plan」。小厂 Agent 那位候选人就是这么答的,事后自己也觉得没有亮点。这个说法的问题是「复杂」说不清。线上排障很复杂,下一步却得看日志里有什么,计划很难事先写全。批量改 200 个文件不复杂,却很适合先列清楚。
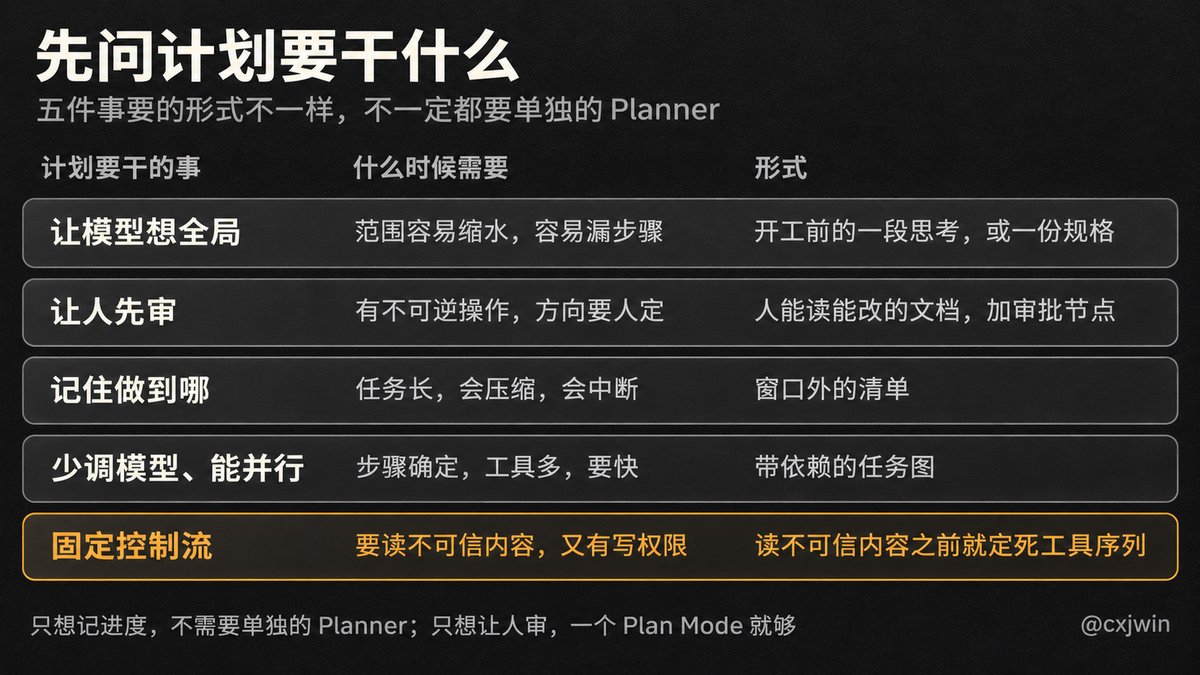
- 计划能干五件事
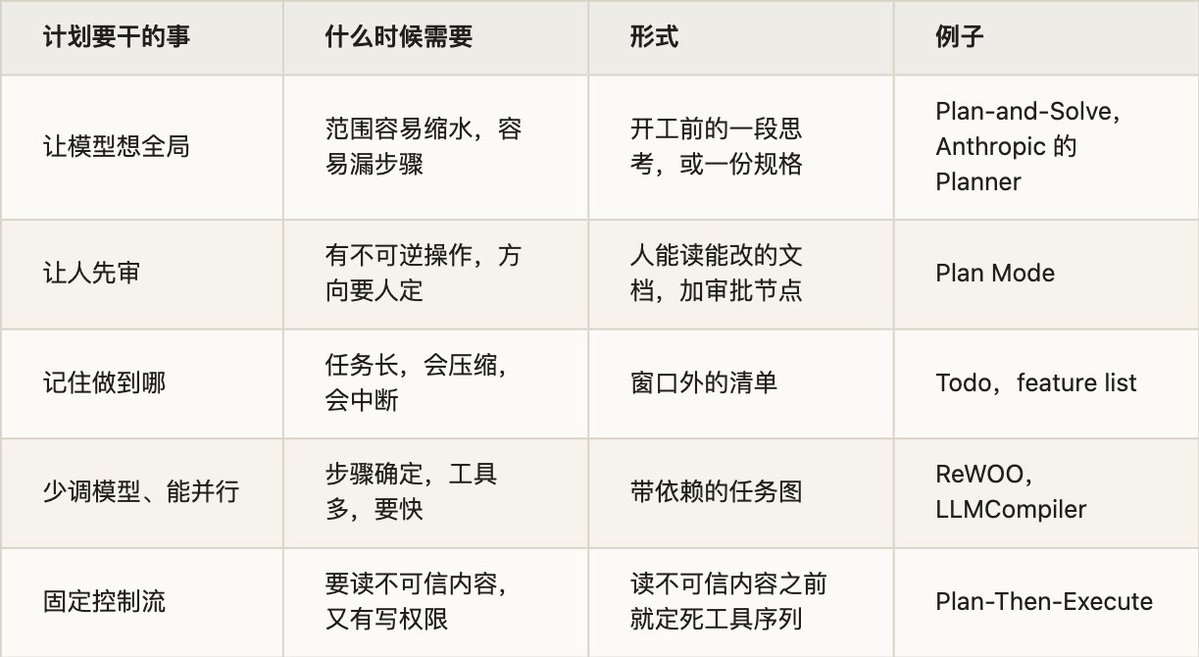
这张表是我的归纳。五件事要的形式不一样。只想记进度,不需要单独的 Planner;只想让人审,一个 Plan Mode 就够;要防注入,普通的 Plan-and-Execute 又不够,因为它的重规划会读工具结果。
-
五个判断
-
下一步依赖上一步的结果吗?依赖得多,就走一步看一步。
-
步骤能事先列清吗?能,而且结果只影响数据、不影响路线,就先列计划,甚至直接写成 Workflow。
-
有不可逆操作,或者方向要人定吗?有,就开工前出计划让人审。
-
要读不可信内容,同时又有写权限吗?是,就要考虑固定控制流。
-
对延迟和调用次数敏感吗?敏感,能并行的就画成任务图。
-
几个例子
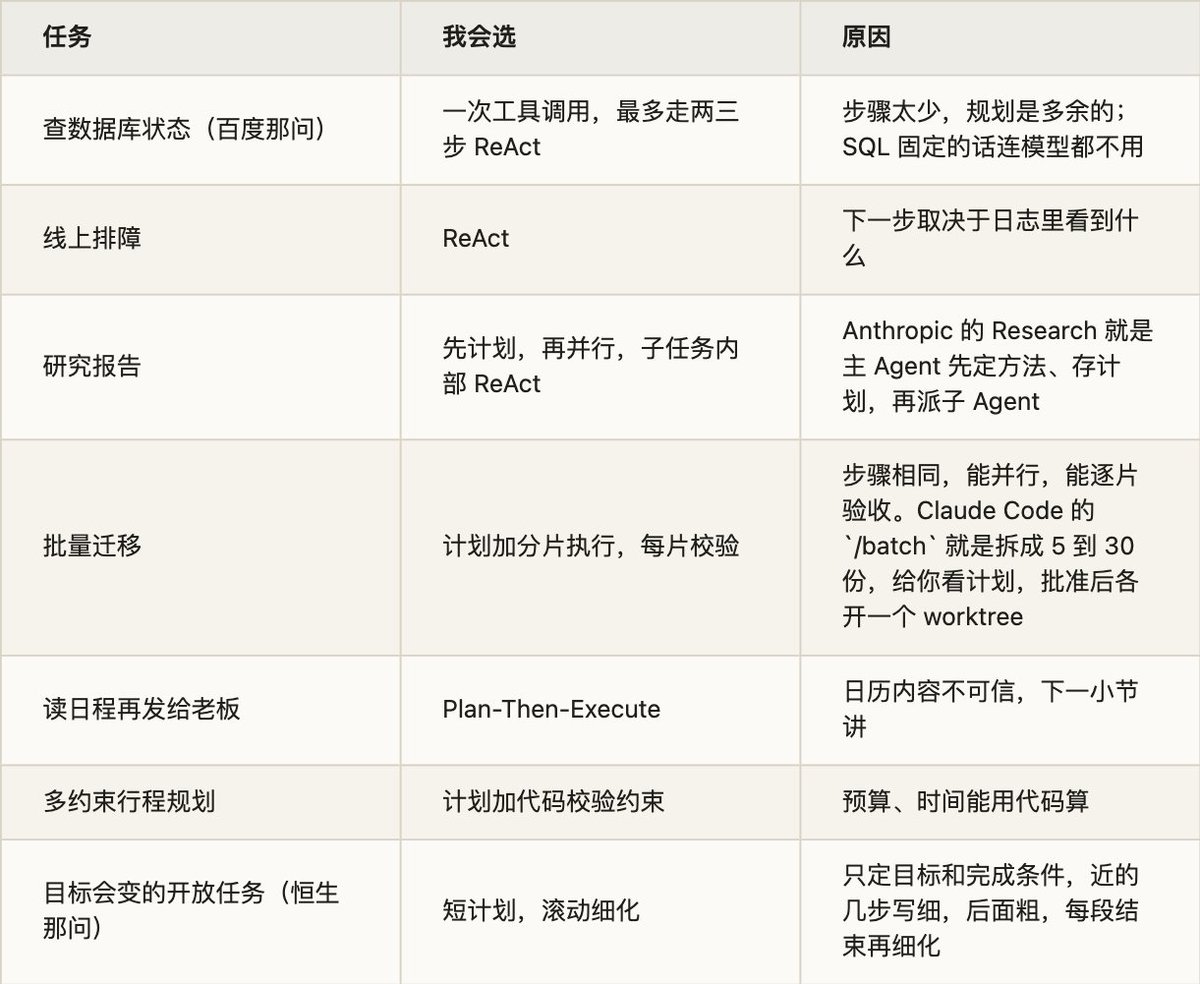
这些是我的选择,不同业务可以不同。答的时候把判断依据说出来,比选了哪个更要紧。
- 防注入这一条
样本里没人从这个角度问。我单列出来,是因为它不会随模型变强而消失(第十一节)。
2025 年的论文 Design Patterns for Securing LLM Agents 列了六种模式,Plan-Then-Execute 是其中一种:在读任何不可信内容之前,先定好要调的工具序列。例子是「把今天的日程发给老板」:先读日历,再给固定收件人写邮件。日历里即使藏了注入,也加不出新的工具调用,模型没法被骗去调计划外的工具。它防不住的是参数:注入还能改邮件正文。CaMeL 走得更远,把控制流和数据流分开,并给数据加能力标记,在 AgentDojo 上以可证明的安全性完成 77% 的任务(没有防御的系统是 84%)。
代价是路线不能随数据变。这和 ReAct 的优点正好相反,所以这类任务要拆开:读不可信内容的部分固定控制流,其余部分照常。细节放到第 20 题。
面试常问:ReAct 和 Plan-and-Execute 有什么区别,各自适合什么场景?能举个例子吗?怎么选?要查询数据库状态,你选哪种模式?需要动态调整全局目标、初始计划很快失效的开放场景,选哪种组合?
五、怎么组合
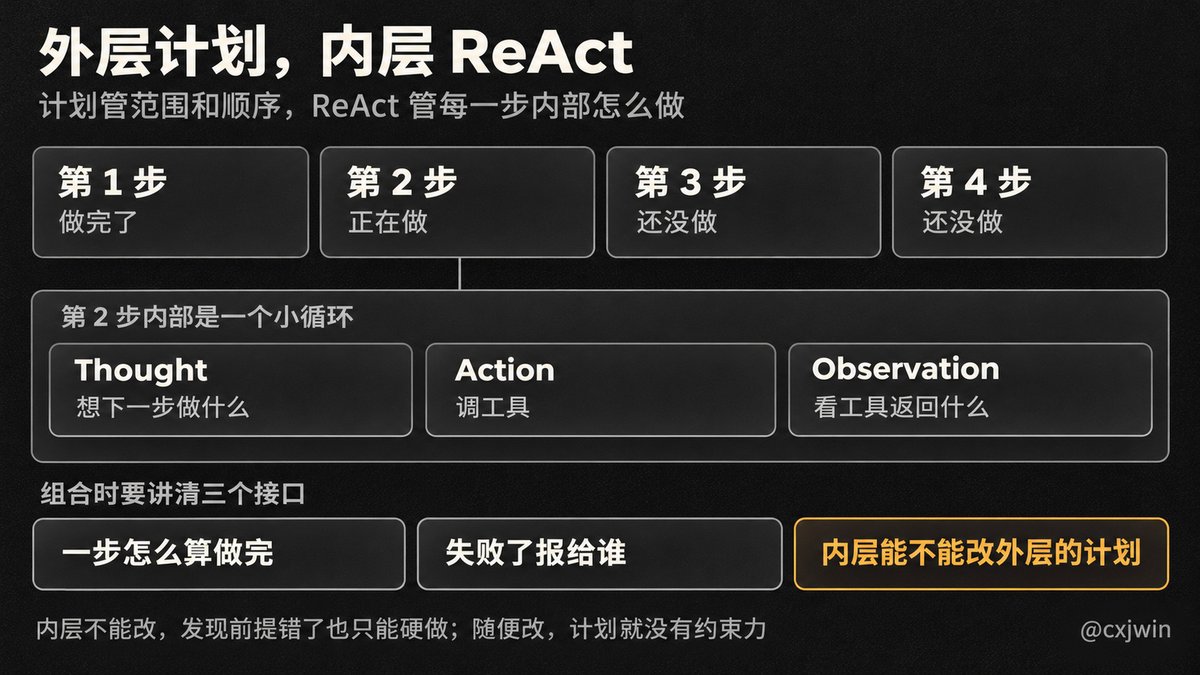
- 外层计划,内层 ReAct
快手和名创优品问的就是这个。计划管范围和顺序,ReAct 管每一步内部怎么做。
几个现成的例子。LangChain 的 Plan-and-Execute,Executor 本来就是 ReAct 风格。OpenManus 的结构很好读,面经里有候选人的项目基于它:ReActAgent 的一步就是 think() 加 act(),PlanningFlow 建好计划后循环取当前步骤,派给执行者。Anthropic 的 Research 也是,主 Agent 定方法,每个子 Agent 在自己的循环里搜索和判断。
组合时要讲清三个接口:一步怎么算做完,失败了报给谁,内层能不能改外层的计划。内层不能改,发现前提错了也只能硬做;随便改,计划就没有约束力。OpenManus 这版代码的流程里没有重规划这一步,执行完就往下走,要用得自己加。
- 和 Workflow、状态机的关系
经纬恒润问:不同功能的 Agent 模式怎么选,ReAct 和状态机怎么区分?面试官还补了一句,状态机其实就是工作流。按第一节的轴,差别在转移由谁定:状态机是人写好的,ReAct 是模型临场定的。PPT 生成这种阶段固定、每阶段有明确产物的,适合状态机。
字节全栈二面问:你说 Agent 应该自主判断,实际却用固定的 Workflow 编排,没有完全采用 ReAct,这是怎么考虑的?这不算矛盾。骨架固定的部分,通常是业务规定、要审计、要能重放的;节点内部不确定的部分交给模型。答的时候说清哪些是固定的,为什么。阿里 Token Foundry 问的「受控 Agent Workflow 具体受控在哪」也是这个,第 23 题展开。
百度后端一面问:LangGraph 做的项目能不能转成 ReAct,有什么问题?能转,LangChain 的 create_agent 就是建在 LangGraph 上的循环(第 10 题)。转了以后,写死的分支和顺序没有了,原来靠图保证的东西只能靠提示词和工具权限约束,节点级的恢复和中途等人也要重新想,评测要重跑。所以先问业务要不要这些保证。
阿里优酷二面问的是形态:自动化和交互式场景,分别用什么内核?我的答法是看有没有人在环上。交互式有人随时纠正,ReAct 的风险可控。无人值守的自动化没人兜底,骨架固定更稳。这是我的判断,要看具体任务。
面试常问:同时用了 ReAct 和 Plan and Solve,两者分别负责什么?项目里怎么选择或组合?ReAct 和状态机怎么区分?你说 Agent 应该自主决策,为什么又用固定 Workflow?LangGraph 的项目能不能转成 ReAct,有什么问题?流程编排型和自主规划型有什么区别?自动化、交互式场景分别用什么 Agent 内核?你提到的 Plan、ReAct、LangGraph,是现有能力还是自己做的?
六、计划错了怎么办
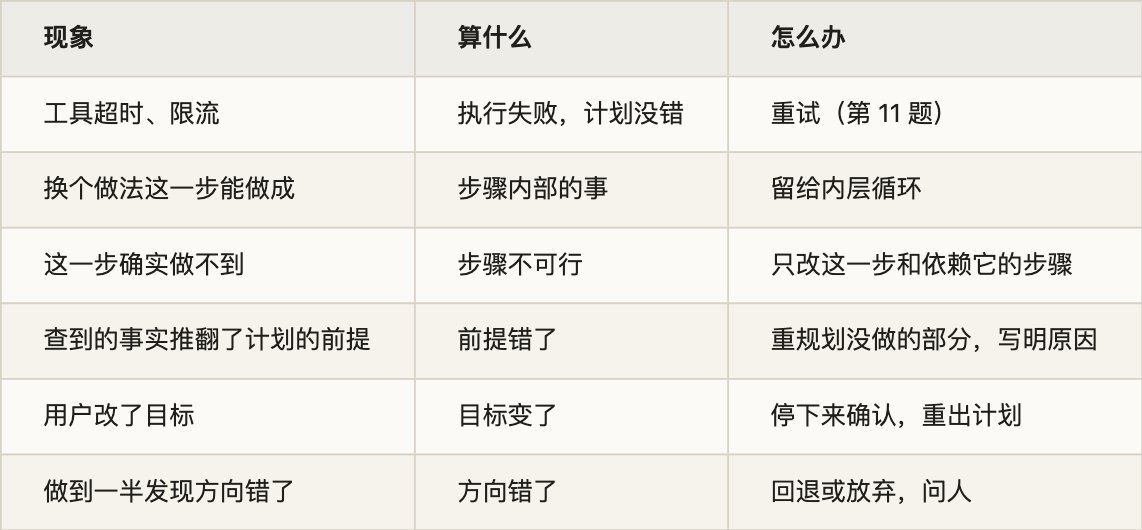
- 先分清错在哪
美团那一问。不是每次出错都要重规划:
- 判定标准怎么定
恒生那一问。如果每一步都问模型「要不要改计划」,调用多,模型也容易找理由改。我会这样做:
-
先用代码判。工具结果满不满足这一步的验收,连续失败几次,预算偏了多少。这些不用问模型。
-
计划里每一步写清前提和验收。反思只回答一个问题:前提还成立吗?
-
推翻要带证据,指到具体的工具结果。说不出证据就继续。
-
设上限。一个任务最多重规划几次;连续两次重规划没有新进展,就停下来问人。
还有一种做法是不推翻,只记录。Field Guide 里是让 Agent 维护一个 implementation-notes.md,碰到偏离计划的边缘情况,选保守的方案,记在 Deviations 下面,继续做。事后人来看要不要改。这适合小偏离,也适合人不在场的时候。
反方向也会出问题。Claude Code 早期给 Todo 加了定期提醒,后来发现提醒让模型觉得必须守着清单,发现该换方向时也不改。频繁推翻和死守清单是两头的毛病,都要防。
- 改什么、怎么改
-
只改没做的。做完的不重跑;有副作用的步骤(下单、发消息)不能简单回退,要靠第 11 题的幂等和补偿。
-
把失败原因和已有结果带给 Planner,否则它很可能原样再出一份。
-
旧计划留着,能对比,用户能看到改了什么。
小红书端侧那场问:函数报错以后怎么多步推理、重新规划?可以按这一节答:报错先当 Observation 回给模型,内层自己改;同一步反复失败才上报,由外层判断这一步还要不要。
- 计划不必一次定死
有两篇论文可以提。ADaPT(2023 年)不事先拆细,执行不了才拆,成功率在 ALFWorld、WebShop、TextCraft 上最多高 28.3%、27%、33%,它的意思是拆多细要看执行者的能力。Pre-Act(2025 年)每步之后细化多步计划,在 Almita 数据集上 Action Recall 比 ReAct 高 70%。这些都是基准上的结果,没有在你的任务上测过,拿来说明方向就好。
面试常问:初始 Plan 错了,或者中间发现问题,怎么办?每步之后的反思,判定标准怎么定,才不会频繁推翻计划?函数报错后怎么多步推理和重新规划?ReAct、Workflow、Replan 分别适用什么场景?
七、长任务:计划放哪、怎么不跑偏
- 放窗口外
蚂蚁二面问:长任务里怎么通过 Plan 避免 Agent 盲目调用工具、丢失全局方向?新旦问:任务复杂,模型忘了任务流程怎么办?快手问:Plan、Task State、Tool Result 分别怎么存?
窗口会被压缩,所以要紧的东西不能只留在窗口里:
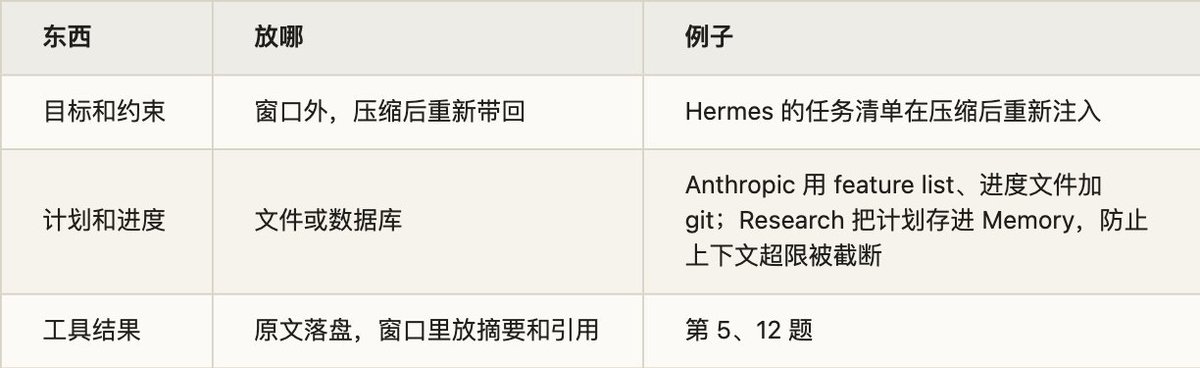
格式上有几个细节。Anthropic 试下来用 JSON 存 feature list,模型比改 Markdown 时更少乱动,而且只让它改一个 passes 字段。Hermes 的工具说明要求同时只有一项进行中,验证过才能标完成,失败了就取消并新增一项。七月那篇删 80% 里也提到过原文的例子:Todo 的 status 只给三个枚举值,加一句同时只留一个 in_progress,一个示例都不用给。
Manus 还有一个说法:反复重写 todo.md,等于把全局计划推到上下文末尾,放进模型最近的注意力范围。这样不用改架构,就能减少目标跑偏。
- Todo 工具什么都不执行
LangChain 2025 年那篇 Deep Agents 写道:Claude Code 的 Todo 工具基本是个 no-op,作用只是让 Agent 不跑偏。它不调度,不校验,就是让模型把计划写进上下文,顺便给用户看进度。
所以第一节说 Todo 不算 Plan-and-Execute。下一步还是每轮定,清单随时能改。项目里如果只是 ReAct 加一张清单,就这样说,别说成 Plan-and-Execute。
- TodoStore 那道题
百度 Go/Agent 那场一路追:TodoStore 是做什么的?Agent 忘了更新怎么办?提醒多少轮触发一次?为什么是 5 轮,你们统计过一个任务平均多少轮吗?如果你来负责这个参数,怎么定,不拍脑袋?
Hermes Agent 有一个同名的类,每个会话一份的内存清单,压缩后重新注入;候选人的项目是不是照这个写的,面经里看不出来。5 轮这个数在 Claude Code 上也出现过:早期就是每 5 轮提醒一次目标,这是 Thariq 自己写的,文章没说为什么是 5。
怎么定,我会这样答:
-
先统计。任务平均多少轮工具调用,清单落后实际进度的比例有多少。
-
再对照。3 轮、5 轮、10 轮、关掉,在同一批任务上每种跑多次,比完成率、Token 和提醒带来的无效调用(第 4 题第五节)。
-
按模型分开定。换模型要重测,后面第十一节会看到,这个参数可能直接作废。
-
提醒追加在消息尾部,不改前缀,否则缓存就断了(第 12 题)。
-
Goal:防行为漂移
腾讯 WXG 和虾皮问同一位候选人:goal 在长程任务里怎么防止 Agent 行为漂移?
目标和计划是两回事。目标说做到什么算完,计划说打算怎么做。计划可以改,目标不能让模型自己改。Claude Code 和 Codex 现在都有 /goal,文档里的做法可以当答案:
-
写成可验证的条件。一个可度量的终态,怎么证明,什么不能动,比如「test/auth 全过,lint 干净,别的测试文件不许改」。
-
判定不交给干活的模型。Claude Code 的 /goal 是一个 Stop Hook,每轮结束把条件和对话发给一个小模型,由它判定。这个小模型不跑命令也不读文件,只看对话里出现的证据,所以条件要写成干活的模型能在输出里证明的东西。
-
设上限。可以在条件里加「最多 20 轮」。
-
留进度。Codex 的文档要求一个目标、一个停止条件,分检查点做,记简短的进度日志。
这样目标不靠模型的记忆,判定不在干活的模型手里,范围写成不能碰的约束。Anthropic 记的那两种失败里,中途宣布做完靠这几条能拦;一口气做太多,要靠分检查点、一次做一个功能。
至于新旦问的「执行过程报错、挂了怎么办」,靠第 9 题的 checkpoint 和第 11 题的重试,计划状态要和 checkpoint 一起存。
面试常问:流程较长的任务怎么管理?除了 plan、todolist,从 Harness 和后端接口的角度还能做什么?长任务里怎么通过 Plan 避免盲目调用工具、丢失全局方向?模型忘了任务流程怎么办?怎么保证 plan 正常执行下去,不被中断?TodoStore 是做什么的,提醒多少轮触发,怎么定?Plan、Task State、Tool Result 怎么存?goal 怎么防止行为漂移?从 Plan/Action 切到更轻量的方式后,计划和自愈能力受损吗?
八、Planner、Executor、Critic
阿里 Token Foundry 和美团 AI 后端都问。Critic 查什么、和 Executor 用不用同一个模型、怎么防反复循环、定向补证,第 3 题第四节讲过。这里讲三个角色为什么分。
- 为什么拆
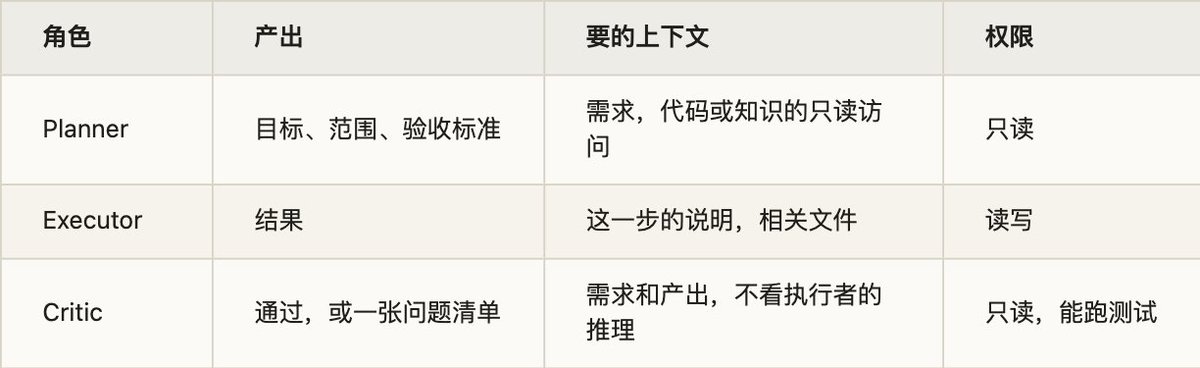
拆的理由有两个:三者要的上下文和权限不同;判断要独立。这张表是我的整理。三个角色不一定是三个进程,同一个循环的三个阶段也行,只要判断时换一份干净的上下文。
- 一个公开的例子
Anthropic 2026 年 3 月那篇就是这个结构,叫 Planner、Generator、Evaluator。Planner 把几句话的需求扩成一份规格,有一次是 16 个功能、10 个 sprint。Generator 逐个实现。Evaluator 用 Playwright 点真实页面,每个 sprint 按标准打分,低于阈值就打回。
有三个细节可以讲:
-
Sprint 合同。每个 sprint 开工前,Generator 和 Evaluator 先商量什么算做完,有一个 sprint 定了 27 条标准。验收标准在动手前定好,Critic 才有依据。
-
Evaluator 开箱不好用。它会发现真问题,然后说服自己这不要紧,放行。调了好几轮提示词才可用。第 3 题说过 Critic 也要评测,这里是一个实例。
-
贵。同一句需求,单 Agent 20 分钟、9 美元,这套 6 小时、200 美元,质量差别明显。
后来换到 Opus 4.6,作者一次拿掉一个组件看影响:sprint 拿掉了,模型自己能撑两个多小时;Planner 留下,没有它范围会缩水;Evaluator 改成最后跑一遍,文章的结论是它值不值,要看任务是否超出当前模型独立能做好的范围。
B 站问的「规划、记忆、工具、执行各承担什么」是更早一层的基础题,第 21 题讲。
面试常问:Planner、Executor 和 Critic 分别负责什么?为什么要拆成三个角色?Critic 在工作流里解决什么问题?Critic 发现证据不足后,定向补证怎么实现?怎么防止三者反复循环?最后敲定的方案里 Planner 起什么作用?规划、记忆、工具调用和执行模块各承担什么职责?
九、还有哪些范式
字节数据中台问「除了 ReAct 还有别的吗」,字节交易与广告问「三种范式写过 demo 吗」,美团全栈问「和思维链、思维树有什么区别」。
从面经看,「三种范式」多半指 ReAct、Plan-and-Execute、Reflection,这不是哪篇论文定的说法。吴恩达 2024 年 3 月列的是四种:Reflection、Tool Use、Planning、Multi-agent。Anthropic 2024 年 12 月列的是五种 Workflow 加 Agent。
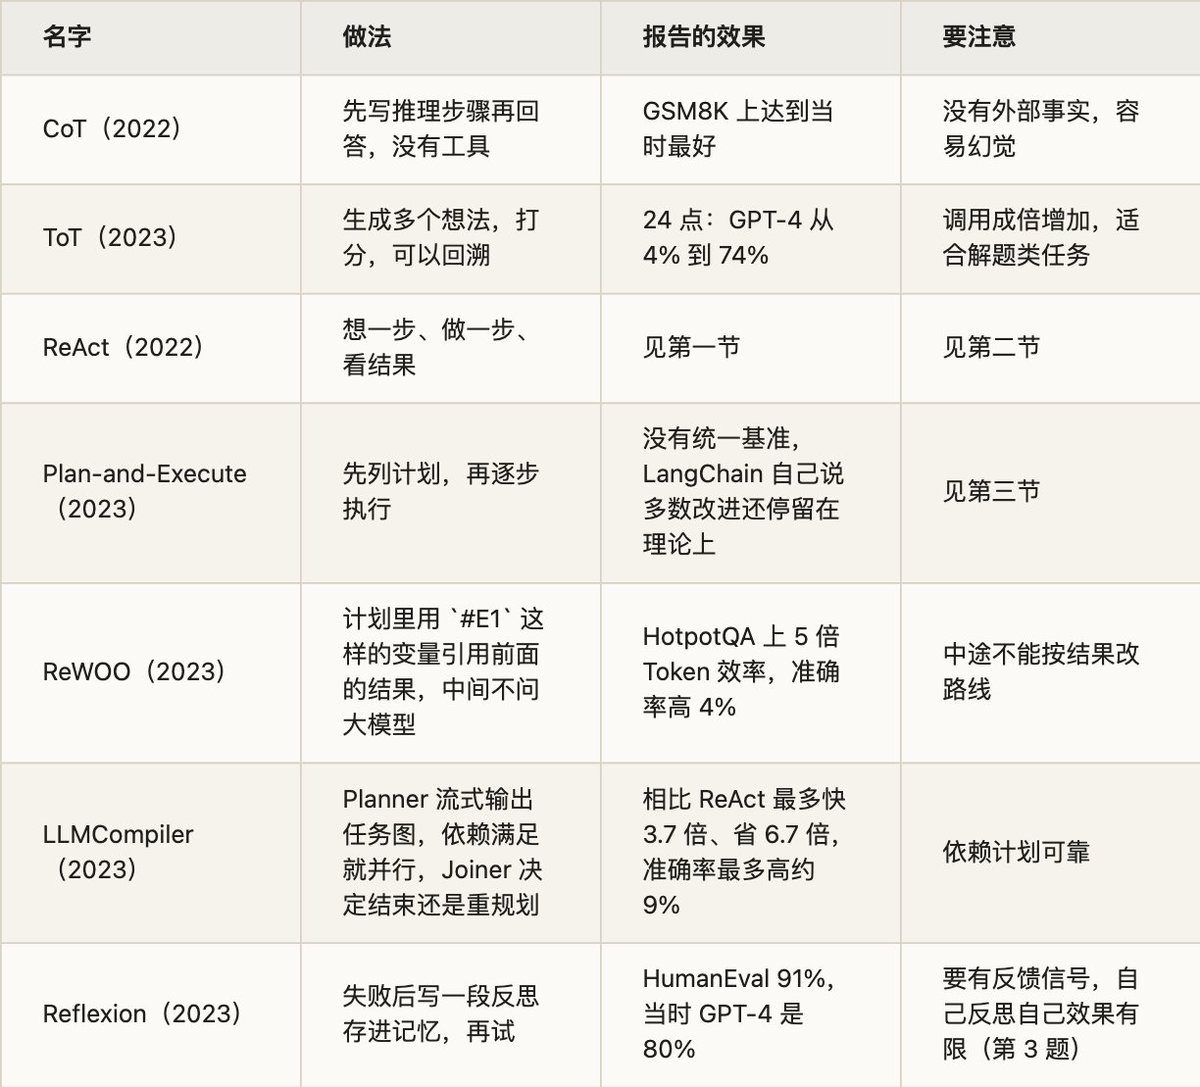
这些数字都是当时的模型和基准,只能说明方向。
Reflection 和前面几个不在一层。小厂 Agent 那位候选人的说法是:它不是一个完整的流程,是叠加在输出上的一道审查。所以它可以和前面任何一种组合。网易那题括号里还写了「反应式」,这是经典 AI 的分类,指按当前输入直接反应、不维护计划,和 ReAct 只是名字像。
有时候面试官问的「主流 Agent 架构」,不一定是这张表。可能问控制流(这一节),可能问拓扑(单 Agent、多 Agent,第 3 题),也可能问编排(Workflow 和 Agent,第 23 题)。阿里千问那场,面经里记的答法是按执行逻辑分成固定工作流和自主决策两类。先问清是哪一层,或者三层都说一句。
小厂 Agent 那位候选人事后的总结也有用:三个范式答完,接着讲项目里实际怎么混用。
面试常问:Agent 开发范式有哪些?Agent 的推理模式有哪些,区别是什么?除了 ReAct 还有别的模型交互模式吗?三种范式写过 demo 吗?ReAct、Plan-and-Execute、Reflection 分别是什么?ReAct 和思维链、思维树有什么区别?你总结过哪些设计模式,各适合解决什么问题?主流 Agent 架构有哪些,各有什么优缺点?项目里用到哪些编排范式?
十、AI Coding 的 Plan 模式
- 让你来设计 Plan 模式
字节 Trae 那场:假设 Solo/Plan 模式让你来设计,架构和工程链路怎么做?可以对着 Claude Code 的做法讲:
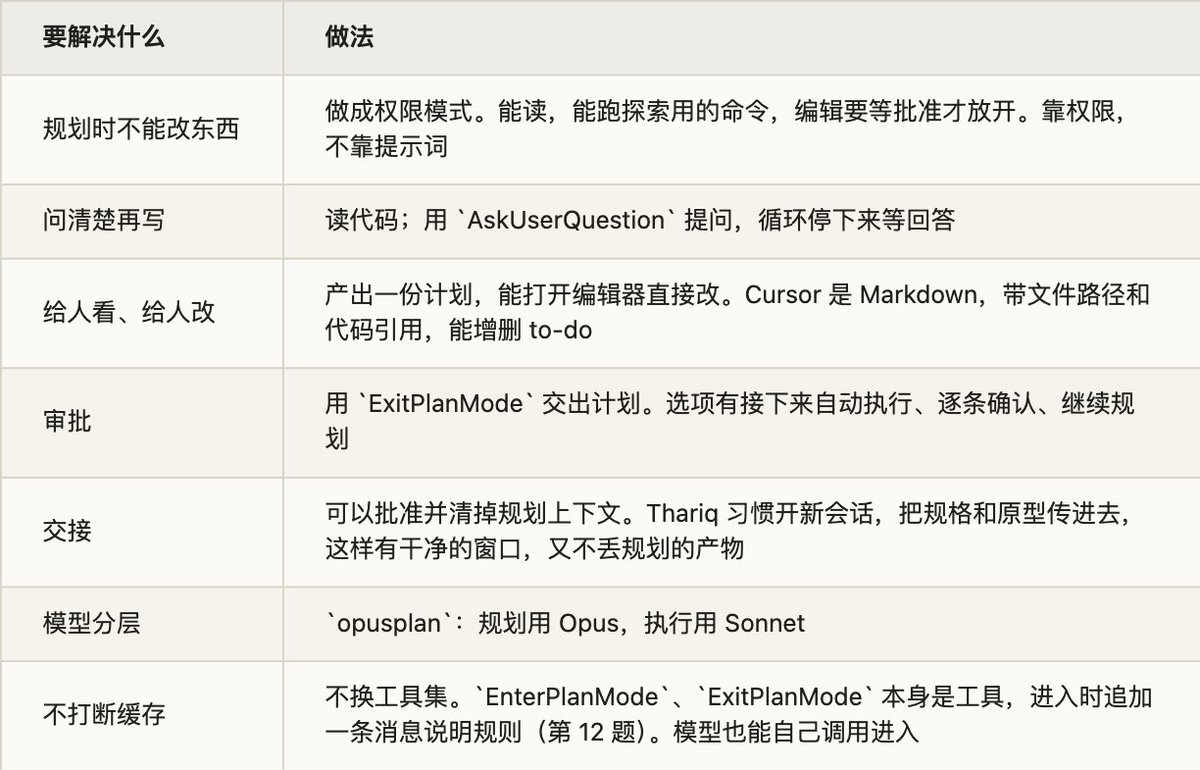
最后一条容易想错。直觉是进入计划模式就把写工具摘掉,但工具定义在缓存前缀里,一摘缓存就断了。
我自己用下来,Plan 模式解决的主要是返工。六月写 Grok Build 那篇时记过:以前让 Claude 直接开写,写到一半说换个 hook,它就从头重写,上下文越来越乱,Token 也烧得莫名其妙。换到 Grok Build 的 plan mode 以后,它只能写 plan.md,先给几版结构,我批准或者提意见,再开始写。七月那套混合配置用的也是 opusplan,规划用 Sol,执行用 Grok。要注意 opusplan 不会判断任务难度,只是按是否在 Plan Mode 切模型。模型一换,缓存也要重建(第 12 题)。
也不是什么时候都该开。九月写提示词大扫除时我说过:讨论选题时我希望它追问、反驳;已经让它修一个明确的 bug,就希望它在授权范围内做完。我觉得 Plan 模式也是这样,按任务开,不做全局默认。
- Spec、Plan、Todo、Goal
欢乐互娱问:Spec 模式、grill-me 和 Cursor 自带的 plan 模式有什么区别?
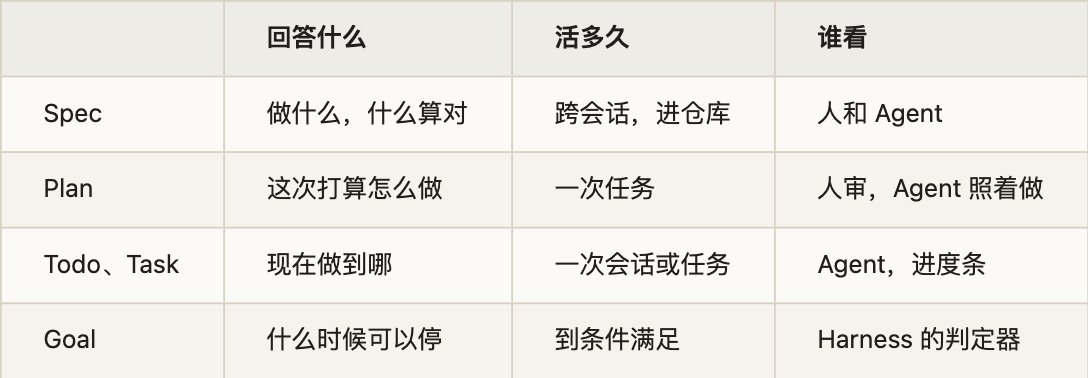
这张表是我的区分,各家产品的边界不完全一样。grill-me 这类做法是让模型反过来追问你。Claude Code 文档里的写法类似:告诉它先采访你,直到能写出规格,写进 SPEC.md,再开新会话照着做。SDD 的细节归第 2 题。
规格也不一定是 Markdown。Thariq 七月那篇说,规格可以是一套详细的测试,可以是另一个仓库里要移植的函数,也可以是一份评分标准。
- 怎么保证 AI 写的 plan 合理
字节一场二面问的。可以从这几条答:
-
带着代码写。先读代码,计划里有文件路径和现有接口的引用,容易看出是不是在空想。
-
审决策,不审步骤。Thariq 的提示词是让计划开头先放最可能要改的决定:数据模型、接口、用户能看到的东西,机械的重构放到最后。
-
写明不做什么,怎么验收。第三节说过,交付物和验收比实现细节要紧。
-
关键假设先验证。写个小原型或者测试,别等全部写完。
-
换一份干净的上下文审。子 Agent 按规格逐条查,第 25 题讲。
- 评审时发现计划有问题
华顺信安问:代码评审时还有必要检查执行计划和选型吗?检查出问题,要推翻计划重新实现吗?有必要,第 13 题讲过错在哪一层就修哪一层。局部问题改计划、记偏离。架构层的问题,我倾向于重来,因为生成代码的成本比以前低,在错的结构上打补丁更贵。这是我的判断,要看已经积累了多少不能丢的东西。
面试常问:Solo/Plan 模式让你来设计,架构和工程链路怎么做?Plan Mode 具体怎么设计,任务拆解和执行流程是什么样的?Spec 模式、grill-me 和 plan 模式有什么区别?怎么保证 AI 写的 plan 是合理的?代码评审时还要检查执行计划吗,有问题要推翻重来吗?一个小需求给到 Agent,它怎么分析需求、拆解任务、一步步实现?需求拆解、任务规划、内容审查模块是自研的,还是依托现有的技能组件?
十一、模型变强以后,还要计划吗
百度 Agent 后端三面问:从 Plan/Action 切换到更轻量的方式后,AI 的计划和自愈能力是否受损?提速减少了哪些环节,稳定性怎么样?
最近有几个公开的变化:
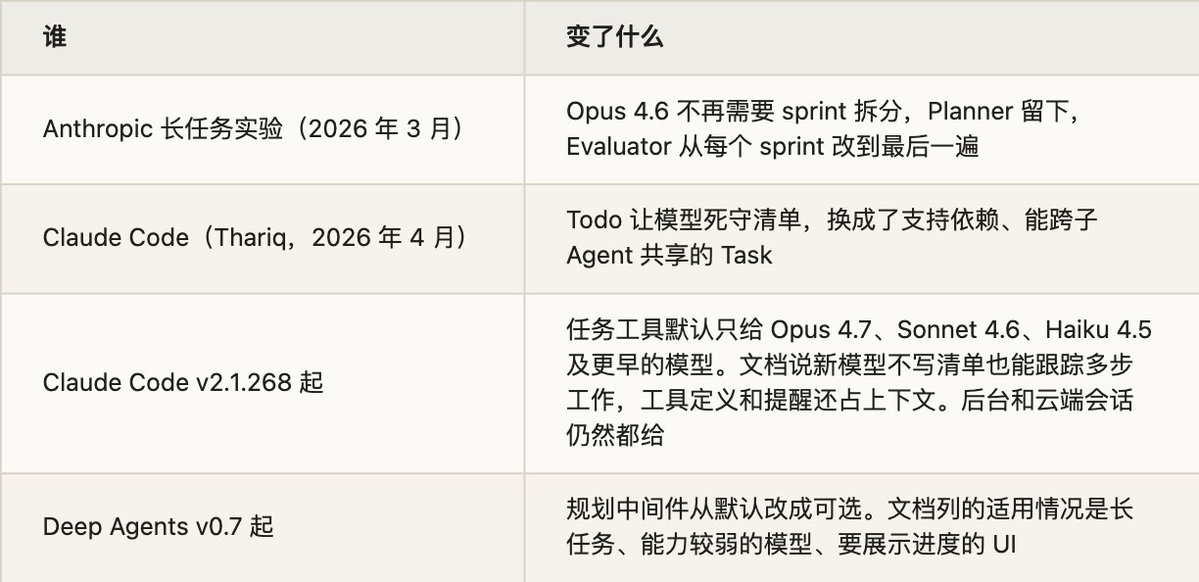
同时,Claude Code 的 Plan Mode 还在,还多了 /goal,Codex 也有 /plan 和 /goal。所以拿掉的只是其中一部分。
回到第四节的五件事看这几个变化:
-
让模型想全局、记住做到哪:模型在慢慢接手,所以 Todo 这类辅助在退。范围缩水的问题还在,Anthropic 留下 Planner 就是因为这个。任务足够长的时候,窗口外的状态也还要。
-
让人先审、固定控制流、少调模型:这三件要解决的不是模型能力问题,模型再强也需要。人要不要审,看的是风险;注入防护,看的是信任边界;少调模型,看的是成本和延迟。
这个划分是我的解读,官方没有这么说。Anthropic 那篇有句话意思相近:Harness 里的每个组件都编码了一个假设,即模型自己做不到什么,模型变了,假设就该重新验证。
落到工程上有三点:
-
一次拿掉一个。Anthropic 那位作者一开始大砍一通,效果掉了,也看不出哪块是承重的,后来才改成一次只拿一个。
-
按模型配。规划给强模型、执行给便宜模型时(第 12 题),便宜模型很可能还需要显式清单。Deep Agents 的文档就把能力较弱的模型单列出来。
-
写下来时标清楚。「每 5 轮提醒一次」这种参数是在纠正某个模型的行为。我现在的仓库把这类规则和项目事实分开放,注明适用模型和验证记录,换模型就重新验证。
百度那一问可以这样答:先说清「更轻量」拿掉了什么。然后在同一批任务上对比完成率、报错后自己恢复的比例、Token 和耗时,按任务类型分开看(第 4 题第五节)。没做过对比就直说没做过,别凭感觉说「没受影响」。
面试常问:从 Plan/Action 切换到更轻量的方式后,计划和自愈能力受损吗?上下文怎么处理?提速减少了哪些环节,怎么权衡效率和稳定性?
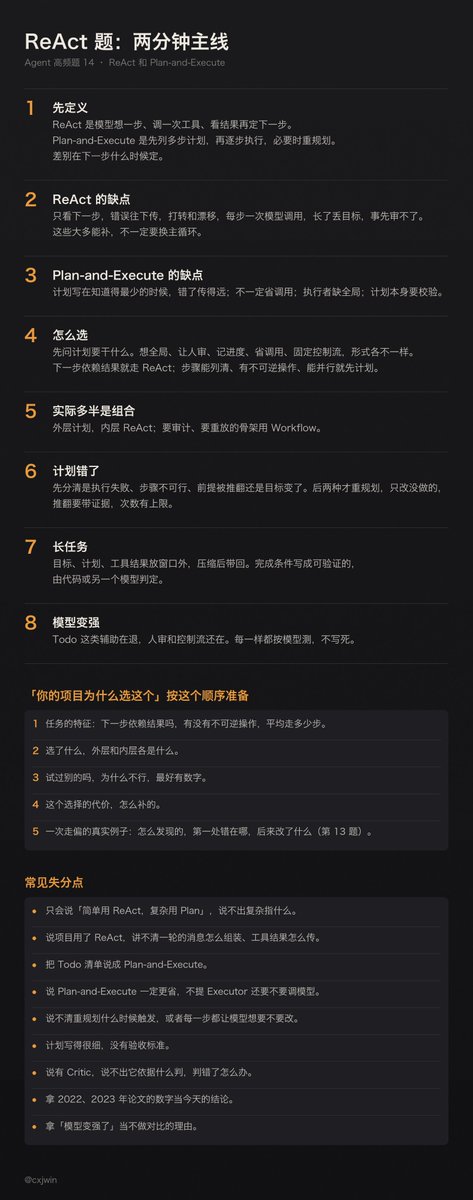
十二、面试怎么答
两分钟左右的主线:
-
先定义:ReAct 是模型想一步、调一次工具、看结果再定下一步。Plan-and-Execute 是先列多步计划,再逐步执行,必要时重规划。差别在下一步什么时候定。
-
ReAct 的缺点:只看下一步,错误往下传,打转和漂移,每步一次模型调用,长了丢目标,事先审不了。这些大多能补,不一定要换主循环。
-
Plan-and-Execute 的缺点:计划写在知道得最少的时候,错了传得远;不一定省调用;执行者缺全局;计划本身要校验。
-
怎么选:先问计划要干什么。想全局、让人审、记进度、省调用、固定控制流,形式各不一样。下一步依赖结果就走 ReAct;步骤能列清、有不可逆操作、能并行就先计划。
-
实际多半是组合:外层计划,内层 ReAct;要审计、要重放的骨架用 Workflow。
-
计划错了:先分清是执行失败、步骤不可行、前提被推翻还是目标变了。后两种才重规划,只改没做的,推翻要带证据,次数有上限。
-
长任务:目标、计划、工具结果放窗口外,压缩后带回。完成条件写成可验证的,由代码或另一个模型判定。
-
模型变强:Todo 这类辅助在退,人审和控制流还在。每一样都按模型测,不写死。
「你的项目为什么选这个」按这个顺序准备:
-
任务的特征:下一步依赖结果吗,有没有不可逆操作,平均走多少步。
-
选了什么,外层和内层各是什么。
-
试过别的吗,为什么不行,最好有数字。
-
这个选择的代价,怎么补的。
-
一次走偏的真实例子:怎么发现的,第一处错在哪,后来改了什么(第 13 题)。
几个常见的失分点:
-
只会说「简单用 ReAct,复杂用 Plan」,说不出复杂指什么。
-
说项目用了 ReAct,讲不清一轮的消息怎么组装、工具结果怎么传。
-
把 Todo 清单说成 Plan-and-Execute。
-
说 Plan-and-Execute 一定更省,不提 Executor 还要不要调模型。
-
说不清重规划什么时候触发,或者每一步都让模型想要不要改。
-
计划写得很细,没有验收标准。
-
说有 Critic,说不出它依据什么判,判错了怎么办。
-
拿 2022、2023 年论文的数字当今天的结论。
-
拿「模型变强了」当不做对比的理由。
面试常问:为什么主体选 ReAct?它和思维链、思维树、Plan and Execute 有什么区别?你提到使用 Plan-and-Execute,它和 ReAct 相比,选择依据是什么?在你的项目里,怎样选择或组合这两种模式?
出处
文中的面试问法都出自下面这些面经,括号里是发帖日期,链到牛客原帖。
-
开头的例子:字节二面(10.12)(10-12) · 快手二面 AI 应用(9.15)(09-24) · 美团后端开发一面(09-22)(09-22) · 恒生电子 AI 面(09-24)
-
ReAct 是什么、一轮怎么走、怎么实现:虾皮 Agent 开发一面(08-24) · 小鹏 Agent 开发实习一面(08-28) · 百度秋招 Agent 一二三面(08-28) · OPPO IT 开发一面(08-30) · 百度后端一面(海外 AI 产品)(08-30) · 淘天一面(09-07)(09-07) · 快手电商后端实习一面(09-10) · 百度搜索后端二面(09-11) · 百度大模型算法一二面(09-21)(09-21) · 字节剪映前端一面(09-22) · 淘天 Agent 算法一面(09-22) · 百度后端开发一面(09-23)(09-23) · 小红书 Product Engineer 一面(09-24) · 合肥某头部企业实习(09-30) · B 站 Java 开发一面(10-10) · 无锡赫玛科技(10-10) · 字节二面(10.12)(10-12) · 小厂一面(10-13)(10-13)
-
还有哪些范式:快手大模型应用实习一面(08-19) · 面经-8(08-20) · 快手效果营销日常二面(08-25) · 快手 AI 全栈二面(09-07) · 小红书 Agentic 端侧实习一面(09-14) · 字节数据中台 Agent 全栈(09-21) · 字节中国交易与广告日常(09-22) · 美团后端开发一面(09-22)(09-22) · 恒生电子 AI 面(09-24) · 阿里千问 Agent 开发二面(10-04) · 南方基金 AI 应用笔面试(10-12) · 美团全栈日常实习一面(10-12) · 字节 Agent 研发一面(10-14)(10-14) · 网易 Agent 开发一面(10-17) · 小厂 Agent 开发一面(10-18)(10-18)
-
区别、怎么选:快手效果营销日常二面(08-25) · 美团 Agent 开发日常一面(08-25) · 名创优品 Agent 开发实习一面(08-26) · 北京小厂日常实习(9.1)(09-01) · 百度后端开发一面(09-23)(09-23) · 快手二面 AI 应用(9.15)(09-24) · 恒生电子 AI 面(09-24) · 字节业务中台 AI 全栈日常(10-12) · 美团全栈日常实习一面(10-12) · 得物 Java 开发二面(10-16) · 网易 Agent 开发一面(10-17)
-
ReAct 的缺点:名创优品 Agent 开发实习一面(08-26) · 百度后端一面(海外 AI 产品)(08-30) · 阿里边缘 BU 一面(09-03) · 美团后端开发一面(09-22)(09-22) · 百度后端开发一面(09-23)(09-23) · 南方基金 AI 应用笔面试(10-12) · 字节二面(10.12)(10-12)
-
长任务:计划放哪、怎么不跑偏:腾讯 WXG 微信读书一面(08-24) · 快手效果营销日常二面(08-25) · 百度后端 Go/Agent 一面(08-28) · 虾皮一面(27 届秋招)(08-31) · 阿里国际 Agent 开发三面(08-31) · 新旦智能 AI 应用开发一面(09-14) · 蚂蚁一面(9.15)(09-15) · 百度 Agent 后端三面(09-21) · 蚂蚁二面(9.21)(09-21)
-
和 Workflow、状态机的关系:名创优品 Agent 开发实习一面(08-26) · 百度后端一面(海外 AI 产品)(08-30) · 阿里优酷二面(09-09) · 度小满 AI 全栈二面(09-22)(09-22) · 经纬恒润 AI 应用开发一面(10-03) · 字节业务中台 AI 全栈日常(10-12) · 字节全栈二面(10-17)(10-17)
-
Plan 模式怎么设计:淘天日常 AI 应用开发一面(08-18) · 欢乐互娱前端实习一面(08-24) · 小鹏 Agent 开发实习一面(08-28) · 字节二面(Trae)(09-03) · 字节秋招二面(09-04)(09-04) · 华顺信安 Golang 实习(10-16) · 腾讯 WXG 实习一面(10-16)
-
计划错了怎么办:小红书 Agentic 端侧实习一面(09-14) · 美团后端开发一面(09-22)(09-22) · 百度后端开发一面(09-23)(09-23) · 恒生电子 AI 面(09-24) · 字节业务中台 AI 全栈日常(10-12) · 华顺信安 Golang 实习(10-16)
-
Planner、Executor、Critic:B 站 AI 应用 Agent 一面(08-18) · 阿里 Token Foundry 二面(09-08) · 美团 AI 后端一二面(食杂零售)(10-01) · 字节内部跨转抖音开放平台一面(10-11)
-
正文引了但没计数:小红书 Agent 开发二面(08-25) · 影石移动端一面(09-30)
-
外部资料:论文 ReAct(2022)、Chain-of-Thought(2022)、Plan-and-Solve(2023)、Tree of Thoughts(2023)、ReWOO(2023)、Reflexion(2023)、LLMCompiler(2023)、ADaPT(2023)、TravelPlanner(2024)、LLM-Modulo(2024)、Pre-Act(2025)、CaMeL(2025)、Design Patterns for Securing LLM Agents(2025)· LangChain Plan-and-Execute Agents(2023-05-10)、Plan-and-Execute Agents(LangGraph)(2024-02-13)、Deep Agents(2025-07-30)、Deep Agents 文档(11-06 读取)· Anthropic Building effective agents(2024-12-19)、The "think" tool(2025-03-20)、How we built our multi-agent research system(2025-06-13)、Effective harnesses for long-running agents(2025-11-26)、Harness design for long-running application development(2026-03-24)· Thariq Shihipar Seeing like an agent(2026-04-10)、Prompt caching is everything(2026-04-30)、A Field Guide to Fable(2026-07-04)、The new rules of context engineering for Claude 5 models(2026-07-25)· Claude Code 文档 How Claude Code works、Best practices、Permission modes、Model configuration、Tools reference、Track todos、Keep Claude working toward a goal(11-06 读取)· Claude Prompting Claude Fable 5.1· OpenAI Codex Slash commands、Follow a goal(11-06 读取)· Yichao Ji Context Engineering for AI Agents: Lessons from Building Manus(2025-07-18)· Cursor Introducing Plan Mode(2025-10-07)· Andrew Ng Agentic Design Patterns Part 1(2024-03-20)· 代码 Hermes Agent tools/todo_tool.py、OpenManus app/agent/react.py、app/flow/planning.py(11-06 读取)
-
我自己的文章:Grok Build:马斯克给 P+ 用户的一份厚礼(06-02)· Claude Code + GPT-5.6 Sol + Grok-4.5 = 多快好省(07-13)· Fable 实战指南:找出你的未知(译)(07-14)· 炸裂,Anthropic 给 Opus 5 删掉了 80% 的系统提示词(07-25)· 云端大模型 API 速度大起底(08-30)· AI 又升级了,我攒的提示词该大扫除了(09-06)


