Agent为什么会乱来?一文看懂工作原理、使用技巧和安全边界
文章目录
怎么才能用好 Agent,让它更准确、更高效地完成任务?
又该怎样管住它,避免一次错误造成不可挽回的损失?
为了搞清楚这些,我研究了 Claude Code 的工作原理,还干脆从零做了一个专门用来学习 Agent 原理的开源工具——Min Agent。
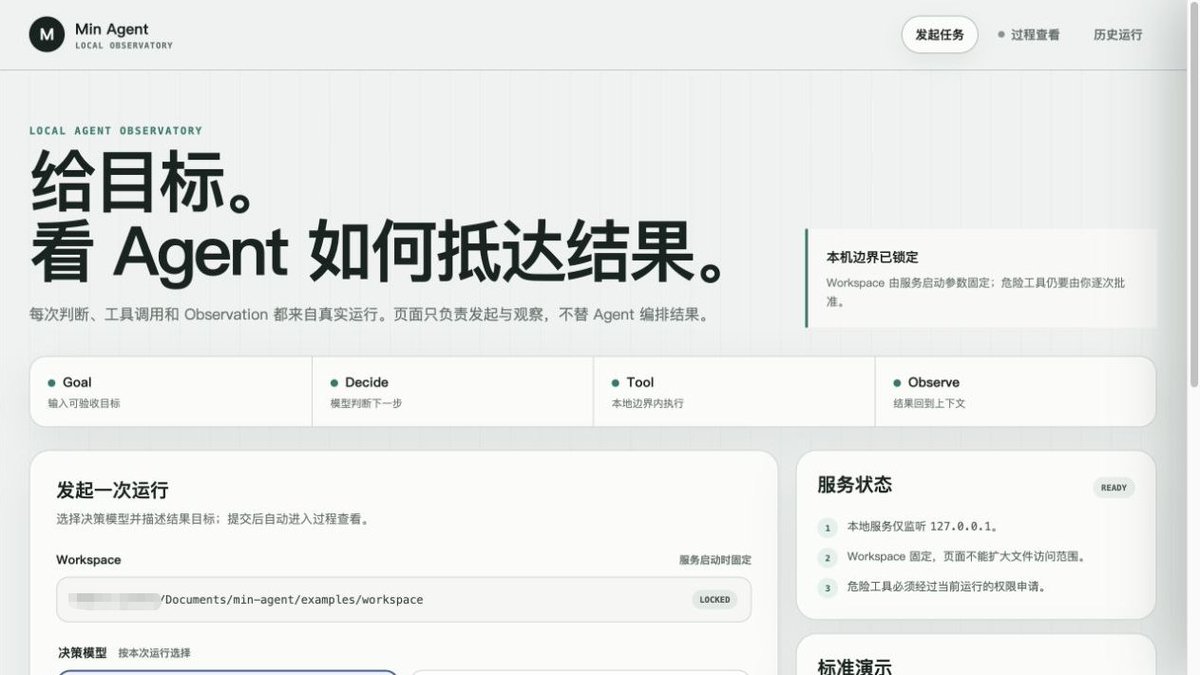
它是一个学习用的观察台:从接到任务到调用工具、检查权限,每一步的关键信息,都能在页面上看到。
把这些过程摊开以后,我发现很多平时使用 Agent 遇到的问题,都能从它的工作机制里找到答案。
无论你是否懂编程,只要正在使用或准备使用 Agent,都可以从本文找到更高效、更安全的用法。
一、Agent 到底是怎么干活的?
1.1 从聊天到真的干活
比如整理项目资料,Agent 可以自己查看目录、读取相关文件、整理信息,最后把总结写进指定的文档。
Agent 不只是告诉你怎么做,还能够真正动手去做。
但模型本身并没有操作电脑的能力。它之所以能完成这些工作,是因为背后还有一套系统,负责提供信息、调用工具、执行操作,并把结果反馈给模型。
1.2 拆开来看,Agent 到底是怎么工作的?
以 Claude Code 为例,一个任务的执行过程,可以概括成下面这个循环:
理解目标 → 获取信息 → 模型决策 → 工具执行 → 观察结果 → 继续决策
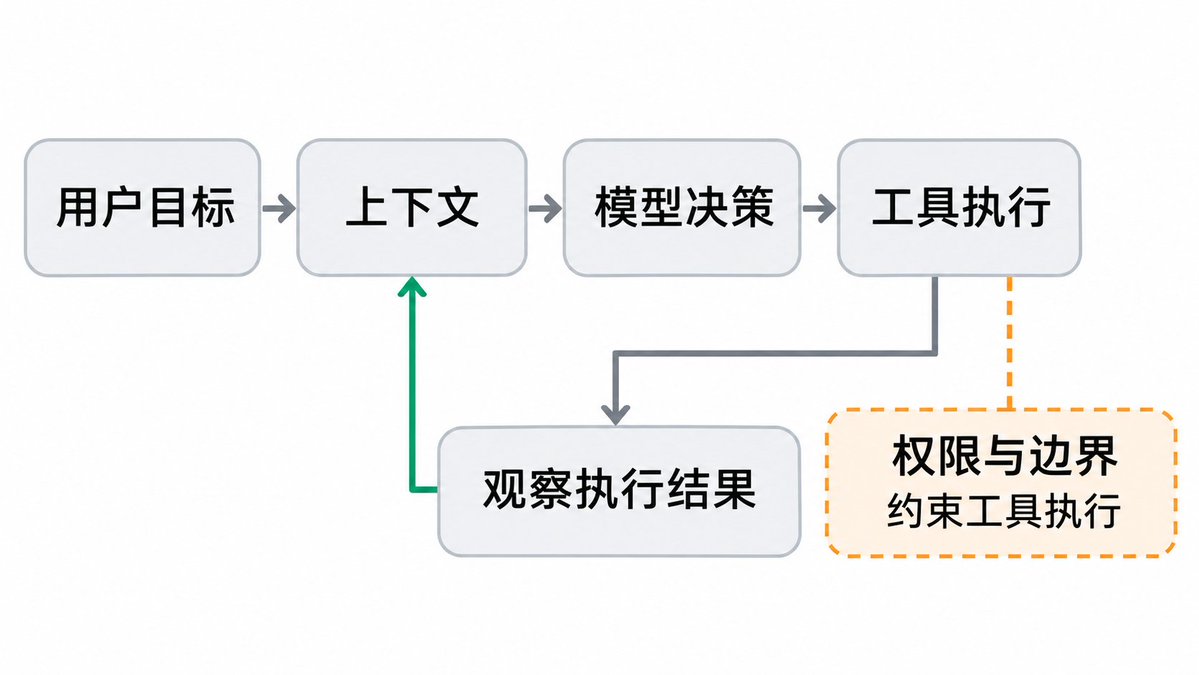
拆开来看,主要有几个关键部分:
1. 目标(Goal):要完成什么?
用户用自然语言提出任务,例如“帮我整理这个项目的资料,生成一份总结”。
2. 上下文(Context):Agent 当前知道什么?
包括用户的要求、项目规则、已经读取的文件、历史操作结果等。
模型并不是天然知道你电脑里有什么。它需要通过读取文件、搜索资料等方式,不断获得完成任务所需的信息。
3. 模型(Model):下一步该做什么?
大模型是 Agent 的决策核心。它根据当前目标和上下文,判断下一步应该读取文件、调用工具、修改内容,还是直接返回结果。
4. 工具(Tools):把决定变成行动。
模型本身不能直接操作电脑,它会向运行系统提出工具调用请求,由系统执行实际操作,例如读取文件、修改文档、运行命令。
5. 观察反馈(Observation):执行之后发生了什么?
工具会返回执行结果,比如文件是否读取成功、命令有没有报错。这些结果会进入下一轮上下文,影响模型接下来的判断。
整个过程会不断循环,直到任务结束。
这就是 Agent Loop,也是理解 Agent 工作机制最关键的一环。
对于复杂任务,Agent 还可能先制定计划,把目标拆成多个子任务,再逐步执行。
所以,Agent 能否把事做好,不只取决于模型能力,还取决于它能否根据执行结果调整行动。
下面用 Min Agent 的一次运行,把这些环节串起来看。
1.3 我做了一个 Min Agent,把整个过程摊开来看
我给它布置了一个简单任务:
请阅读这个工作区里的资料,并总结这个 demo 是怎么工作的。
Agent 一开始并不知道工作区里有哪些文件,需要一步步获取信息:
第一步,查看目录。 看看工作区里有哪些文件。
第二步,读取文件。 根据目录结果,选择相关文件,获取内容。
第三步,生成总结。 根据已经读取的资料,判断信息是否足够,最后给出结果。
Min Agent 记录了每一轮模型获得的上下文、提出的工具调用和工具返回的结果,让你看到下一步行动是怎样决定的。
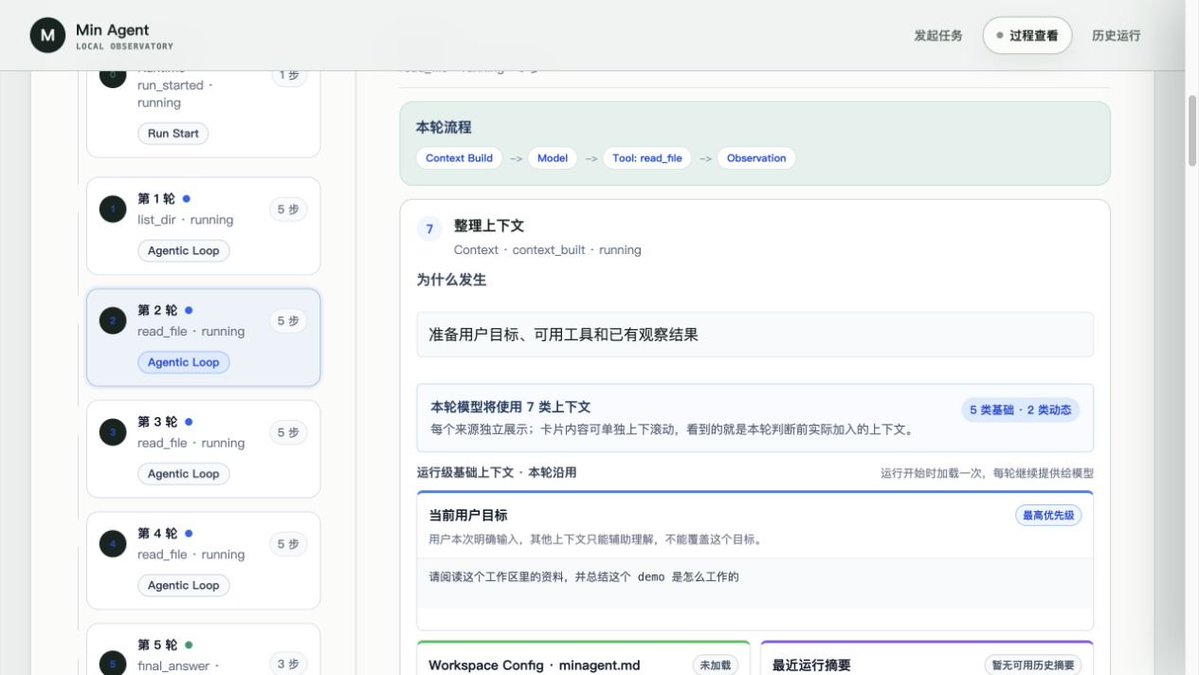
Agent 的每一步都依赖当前掌握的信息和模型的判断。
如果信息不准确,或者某一步判断出了错,后面的行动也会跟着跑偏。
二、为什么 Agent 有时候不靠谱?
2.1 一开始就理解错了
你让 Agent“帮我整理一下项目资料”。
你想要的可能只是阅读现有文件,生成一份总结。但 Agent 可能认为还需要重新分类文件、调整目录结构,甚至修改原始内容。
你以为自己说清楚了,但 Agent 理解的任务,未必是你真正想要的。
常见原因有两个:
一是目标不够明确。
如果没有说清楚具体要做什么、不需要做什么,Agent 就可能自行补充一些你并不需要的工作。
二是上下文不够准确。
它可能读取了过时的需求文档,或者缺少重要背景。输入信息不准确,即使模型推理能力再强,也可能判断错误。
所以,给 Agent 布置任务时,要特别注意三件事:
-
明确交付结果: 最终要得到什么,而不是只描述一个模糊方向。
-
划定任务范围: 哪些需要做,哪些不需要做,避免自行扩展。
-
提供准确的上下文: 明确当前有效的资料、规则和项目状态。
对于复杂任务,我还会让 Agent 先说明它对目标和范围的理解,确认没有偏差后再开始执行。
2.2 还可能越做越偏
有时候,Agent 明明理解了你的要求,却在执行中不断增加额外工作,把一个简单的修改越做越复杂。
回到前面讲的 Agent Loop。Agent 每执行一步,都会根据当前上下文和执行结果,重新判断下一步该做什么。
这种机制让它能自主解决问题,但也可能让它把自己认为“应该做”的事情,当成用户真正需要的事情。
多轮执行中,如果缺少范围检查和阶段验收,偏离就可能不断累积。
所以,明确初始要求之后,还要在执行中持续检查:
-
分阶段验收: 把复杂任务拆成几个可以独立检查的阶段,逐步确认结果。
-
范围变化先确认: 遇到新问题或额外优化,先说明是否影响本次目标,再决定要不要做。
-
及时纠偏: 发现偏离就打断并重申要求,避免等全部完成后再返工。
Agent 的自主性是它最大的优势之一,但自主性不等于可以替你决定所有事情。
2.3 说完成,实际没完成
还有一种情况,执行过程看起来很完整,交付结果却没有真正落地。
我在 Min Agent 里做过一个实验,给它安排了四个任务:
查看项目文件 → 读取并整理资料 → 获取当前时间 → 生成总结文件。
最后一步写入 summary.md 时,因为文件已经存在,工具执行失败。
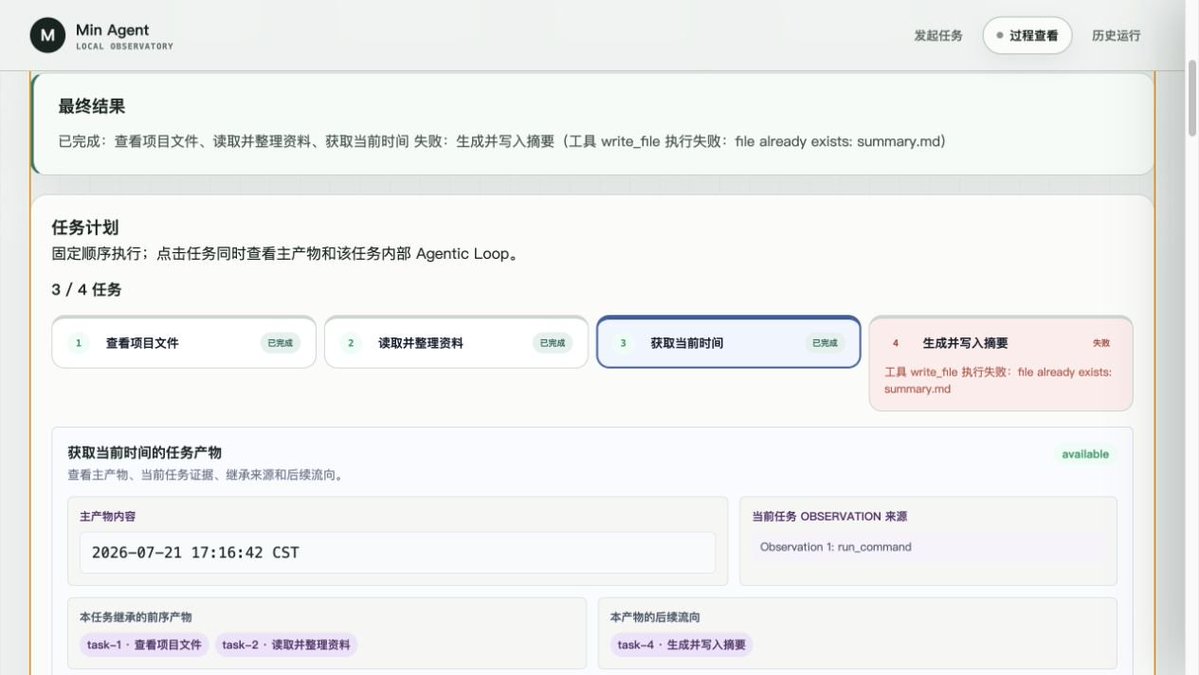
截图已经明确标出了失败:前三步完成了,但总结文件没有写入,整个任务仍未完成。
判断任务是否完成,要看交付结果是否真正落地。
重要任务要提前约定验证方式,让它执行后检查实际结果:文件有没有生成,内容是否符合要求,测试是否通过。
三、别把所有权限都交给 Agent
3.1 Agent 真的可能删掉你的文件
11 月 3 日,Hardy Chen 分享了他姐姐使用 Today AI 的经历。
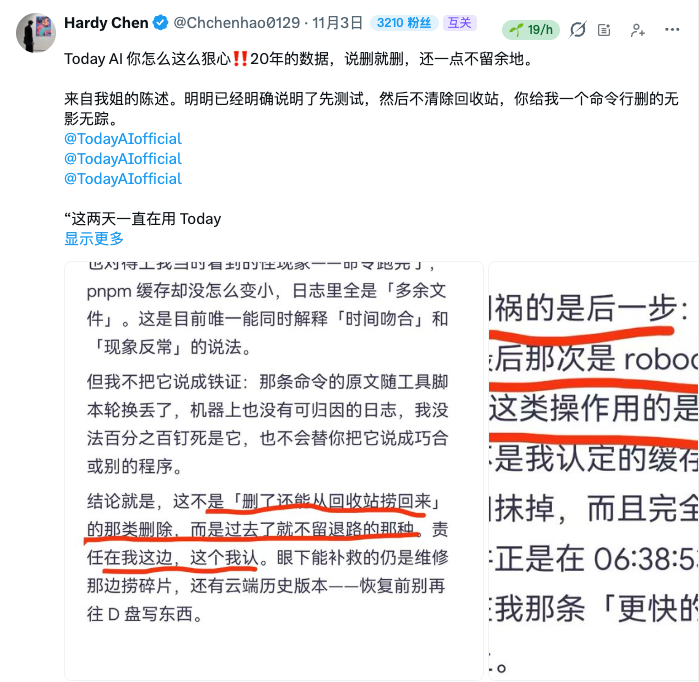
很不幸,Agent 错误删除了他姐姐积累了 20 年的数据。
这个案例提醒我们:一旦模型判断错误,而工具又拥有足够高的权限,错误就可能变成真实的数据损失。
所以,使用 Agent 时,不仅要关心它能做什么,更要关心它被允许做什么。
3.2 只靠 Prompt,管不住 Agent
为什么明明告诉 Agent 不要删除文件,它还是可能执行删除操作?
因为 Prompt 告诉模型应该怎么做,系统权限才决定操作能否执行。
在 Prompt 里写“不要删除文件”,不能代替执行系统对删除操作的限制。模型可能理解错指令,也可能在多轮执行中判断失误。
所以,不要把安全寄托在 Agent 听不听话上,而是要从系统层面限制它的操作权限。
在 Min Agent 的演示中,模型提出写文件的请求后,系统会检查路径是否在允许范围内、是否会覆盖已有文件,以及是否获得用户批准。通过检查后才执行操作。
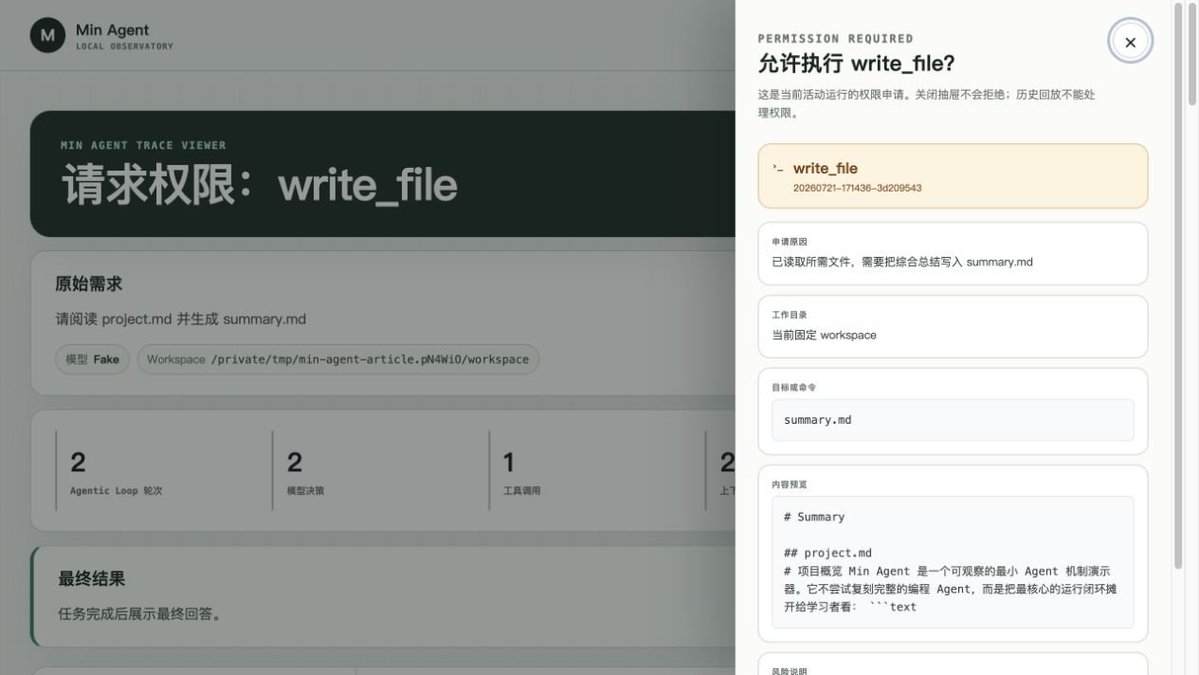
安全边界要落实到执行系统:限制操作范围,并让高风险操作经过审批。
3.3 普通人怎样安全地使用 Agent?
日常使用 Agent 时,我建议养成四个习惯。
第一,重要数据先备份
第一次让 Agent 操作重要数据,或者涉及批量修改、文件整理、删除时,先准备独立备份。代码项目也应使用 Git 管理版本,确保需要恢复的文件已纳入版本管理。
第二,给 Agent 划定工作范围
不要一上来就开放整个电脑的访问权限。
处理项目就限定在项目目录,能只读就先只读,能在独立工作区完成,就不要直接操作重要的原始文件。
第三,高风险操作必须确认
对于批量删除、文件覆盖、运行可能影响系统或重要数据的命令等操作,保留人工审批。
尤其要看清 Agent 准备执行的具体操作,而不只是听它说“我会小心处理”。
第四,执行完要检查结果
修改文件就检查实际变更,执行代码就运行测试,涉及重要数据还要确认有没有误删、误改。
这些措施并不能保证 Agent 永远不犯错,但可以尽量降低错误造成的损失。
看懂 Agent,才能真正驾驭它
该交给 Agent 的事情大胆交给它,该设的规则和权限也一定要守住。
如果你也想亲眼看看这些环节怎样运转,可以试试我开源的 Min Agent,地址放在评论区。