
Agent 高频题 13. bad case 怎么定位、怎么回流
文章目录
快手一场一面,先问 Agent 的可观测性怎么做,候选人答了 LangFuse 和 Prometheus。下一问就来了:链路搭好以后,用户反馈对一次提问的答案不满意,要怎么排查?怎么确定是 Prompt 的问题,还是别的问题?
网易 Agent 一面问得更短:用户反馈 Agent「很蠢」,怎么定位?字节一场二面换了说法:任务成功率上不去,怎么区分是大模型的问题,还是 Skill、MCP、工具调用的问题?
字节另一场一面问的是后半段:修好一类 bad case 以后,怎么发现别的场景有没有退化?用户负反馈怎么收集和分析?线上错例怎么回流到评测集?
这几问连起来,问的是三件事:出了问题有没有证据,能不能说清错在哪一层,修完以后同样的错还会不会回来。
这是 Agent 高频面试题单第 13 题的详解。题单里这题是 29 位作者、38 场面试。这次和第 12 题一样,重读库里记过的牛客链接,共 516 篇。按 bad case、回流、反馈、可观测、Trace、定位、排查这些词找出 335 篇,逐条读过,又用黑盒、回滚、监控、自进化这类词扫了两轮补漏。问 CPU 飙高、慢查询这类后端排查的,问 RAG 召回排查的(归第 15 题),候选人反问面试官的,都去掉了。剩下问到这道题的有 76 场、54 位作者,其中 7 场只问反过来让 Agent 查线上问题。追问分十个方向(按作者数,一场可以算进几类):
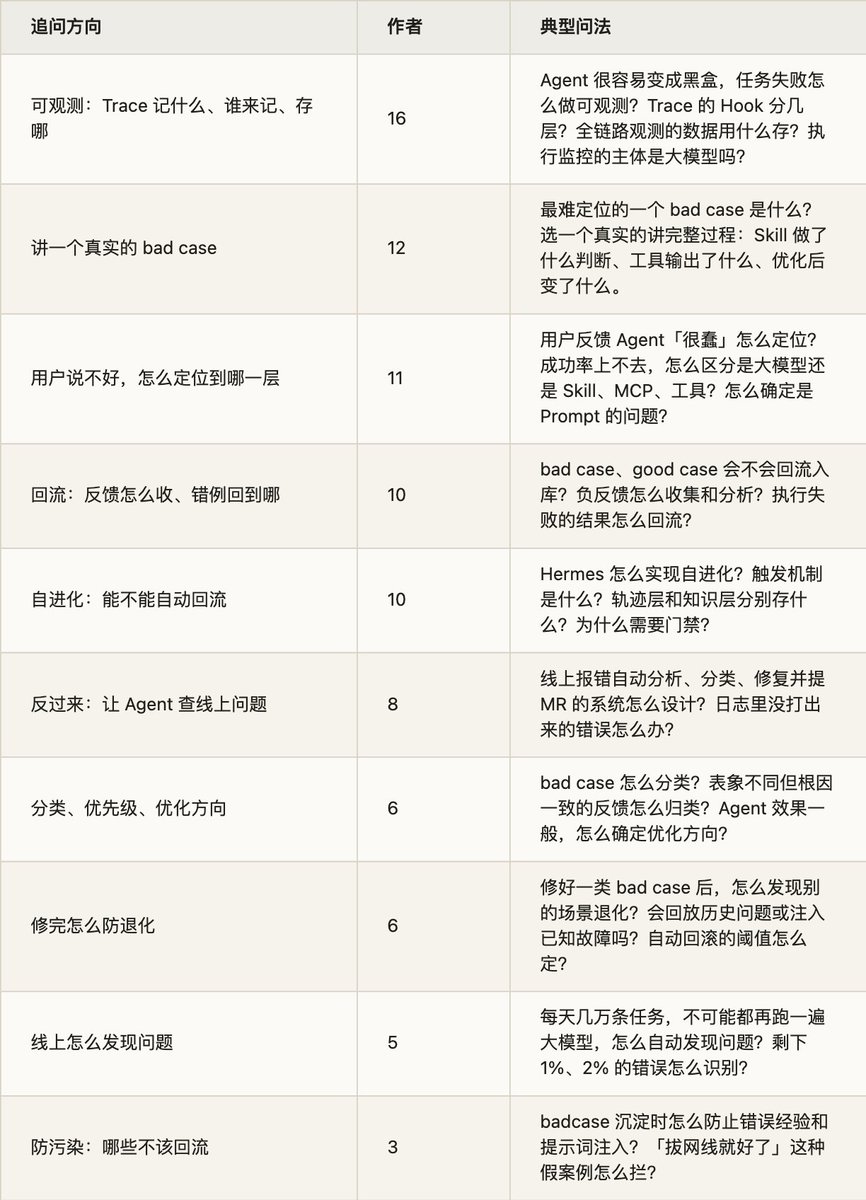
问得最多的是可观测和「讲一个真实的」。后一问背不了答案。淘天供应链那场要求选一个真实的 bad case,讲清楚遇到什么问题、Skill 做了什么判断、调了什么工具、输出了什么、怎么优化的、优化后变了什么。
下面顺着一条 bad case 的路讲:翻译、留证、发现、定位、分类、修和回流、防污染、防退化,再讲自进化和反过来让 Agent 查线上问题。评测体系第 4 题讲过,工具报错第 11 题讲过,RAG 效果差第 15 题讲过,幻觉第 19 题、死循环第 28 题单讲,这里只讲它们和定位、回流有关的部分。
一、先把「很蠢」翻译成能查的问题
- bad case 和 bug 差在哪
传统的 bug 通常有报错和堆栈,同样的输入大多能复现。Agent 的 bad case 不一样:
-
没有报错。接口都返回成功,工具也都跑完了,只是答案不对。
-
不一定复现。同样的输入再跑一遍,可能就对了。
-
错的位置和暴露的位置隔得远。第 7 步答错,原因可能是第 2 步检索回来一份旧文档,中间几步都在认真地照着错信息干活。
-
好坏没有唯一标准。用户说「很蠢」,可能是答错了,可能是太慢、太啰嗦,也可能是想要的功能本来就没有。
所以拿到一条反馈,第一步是把它翻译成能查的问题:是哪一次会话,用户期望什么,实际得到什么,算答错、太慢、没听懂,还是功能没有。常常要回头问用户,或者翻前后几轮对话。
- 一条 bad case 要走的路
发现、留证、定位、分类、修、回流、防退化。大部分问法能对应到其中一步。OpenAI 的 cookbook 把这个循环叫评估飞轮:分析、度量、改进,转完一圈还会冒出更细的问题,再转一圈。
- 一个公开的例子:Claude Code「变笨了」
2026 年 3 到 4 月,不少用户反馈 Claude Code 变差了:健忘、重复、工具选得奇怪,额度掉得也快。Anthropic 查了一个多月,4 月 23 日发了复盘,结论是三处互不相关的改动,API 和推理层都没有问题:
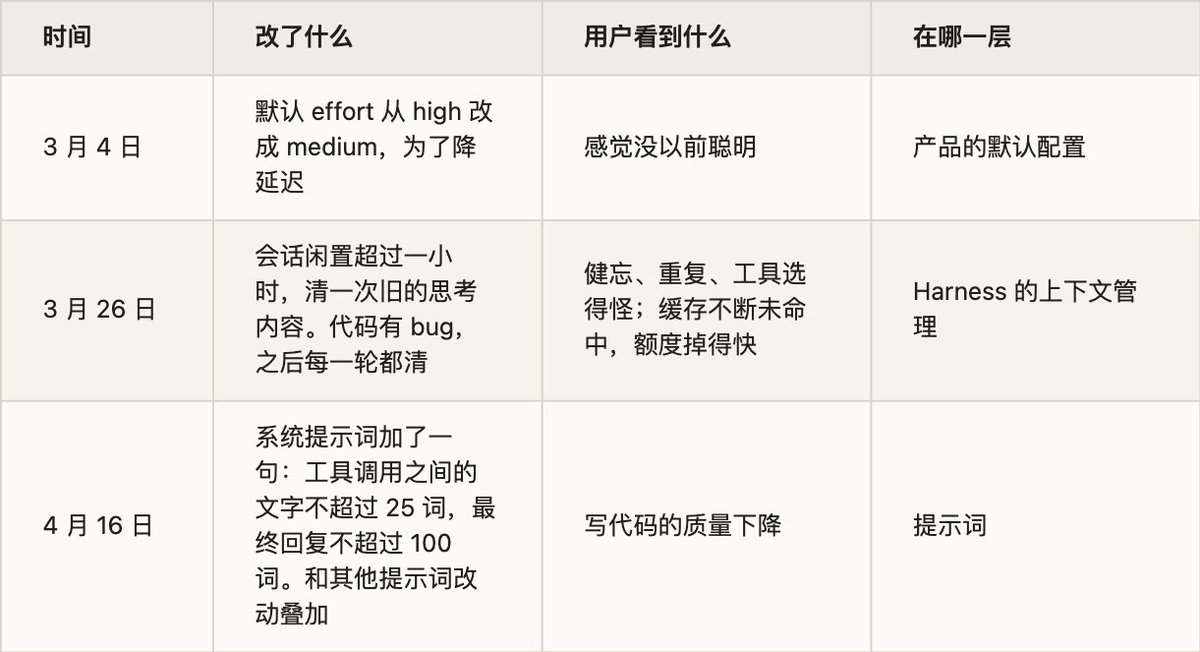
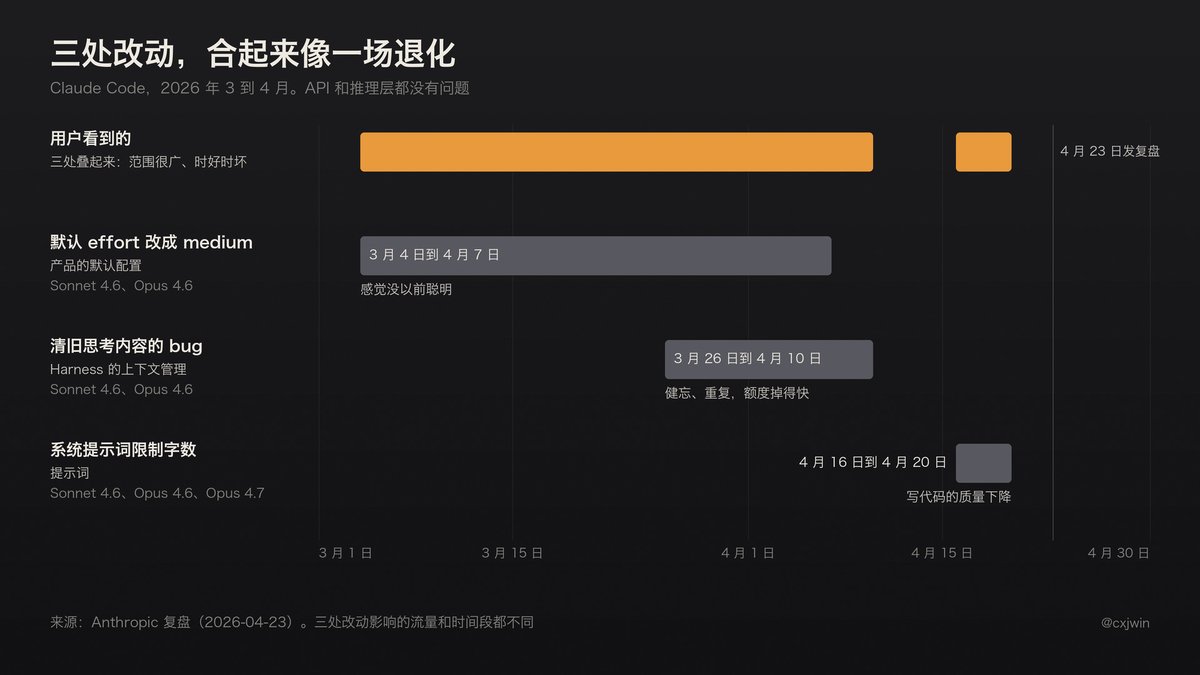
三处改动影响的流量和时间段都不同,合起来就像一场范围很广、时好时坏的退化。一开始这些反馈和平时的波动分不开,内部使用和评测也都复现不出来。第二处的 bug 过了人工和自动的代码审查、单元测试、端到端测试和内部试用,还有两个不相关的实验恰好把它遮住,花了一周多才确认根因。第三处内部测了几周,跑的评测都没掉;后来用更大的评测集做消融(ablation,把系统提示词一行行删掉看影响),才看到有一项掉了 3%。
用户说「变笨」,三个原因都不在模型本身。
面试常问:用户反馈 Agent「很蠢」时怎么定位问题?做智能体,在哪些环节会出问题?影响问答 Agent 效果的因素有哪些?用户觉得 Agent 不好用,让你把体验和成功率提上来,怎么一步步做?你负责的 Agent 工作流出了问题,怎么解决?
二、留证:Trace 记什么、谁来记、存哪
我五月写 Hooks 那篇时定的次序是:先让它可观测,再谈约束它,最后才轮到自动化。六月写编程基准作弊时提过一次经历:一轮模型盲测里,排在后面的模型偷偷扫了工作区,翻到前面模型的结果,挑分数最高的照抄,改掉其中的 bug,汇报时一字不提。只看输出,我会觉得它又快又准;翻开 thinking 日志和工具调用记录才知道发生了什么。
- 几个词
Trace 记录一次请求从进来到结束的全过程,里面的每一步(一次模型调用、一次工具调用、一次检索)是一个 Span。多轮对话再往上一层,把同一会话的多个 Trace 串起来。各家叫法不同:LangSmith 叫 run、trace、thread,Langfuse 叫 observation、trace、session,OpenTelemetry 叫 span、trace,再用 gen_ai.conversation.id 串会话。第 4 题里 Anthropic 说的 transcript 也是这个东西。
Trace 和日志的差别在结构。日志是一行行的事件;Trace 有父子关系,能看出这次工具调用是哪一轮模型决定的、属于哪个子 Agent。
- 记什么
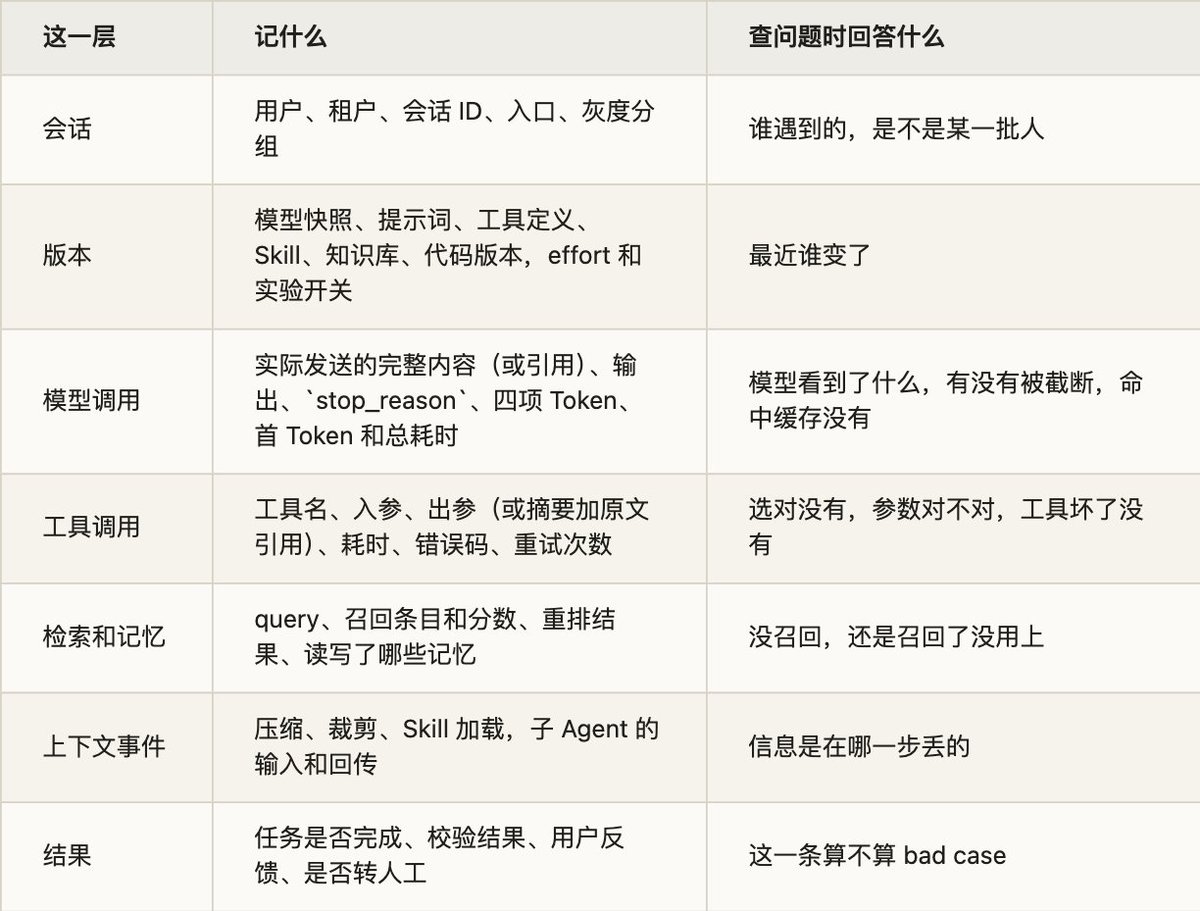
三处容易漏:
实际发送的内容。提示词模板几百行,渲染后每次都不一样,查问题要看渲染后的。
版本和实验分组。Anthropic 2025 年另一次复盘写过:他们知道网上的负面反馈在涨,却没有办法把它和最近的变更对上;8 月 29 日反馈激增时,没有立刻想到当天那次常规的负载均衡调整。每条 Trace 带上版本和分组,才能按版本拆开比。
上下文事件。第 5 题讲过压缩会丢信息。Trace 里没有这个事件,就只能看到模型「忘了」,看不到它在哪一步忘的。
- 谁来记
影石那场问:执行监控的主体是什么,也是大模型吗?应该是执行引擎。模型负责决策,Trace 由 Harness 写,模型说错了、没说,都不影响记录。我写 192 倍复盘时就是这样:交卷报告只讲了完成了什么,累计用了 1.92 亿 Token 是事后追问日志才知道的。
百度 Agent 一面问:Trace 的 Hook 怎么设计,分几层?一次请求在 Trace 上是什么形式?可以按 Agent 循环的结构分:一次任务、一轮循环、一次模型调用、一次工具调用、一个子 Agent,再加上压缩、记忆读写、检索这些内部事件。OpenAI Agents SDK 默认就是这么切的:整个运行一个 trace,下面是 task、turn、agent、generation、function、guardrail、handoff 这些 span。Claude Code 的 Hook 按事件切:SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、PostToolUseFailure、PreCompact、SubagentStop、Stop。Anthropic 内部就用一个 PreToolUse Hook 记录 Skill 的使用,找出触发得比预期少的 Skill。
OpenTelemetry 在定 GenAI 的语义约定(还是 Development 状态,已经搬到单独的仓库):模型调用、检索、记忆、执行工具、调用 Agent、工作流都有对应的 span 和字段。它的好处是不绑厂商,能和后端已有的调用链接到一起。有位候选人答订单失败怎么查时走的就是这条路:失败告警推 webhook,定位日志,沿 trace 看 span 耗时,再归因恢复。这条路能回答哪一步失败、哪一步慢,回答不了答案为什么不对,所以还要加上模型的输入输出。
- 存哪
腾讯社招二面问全链路观测的数据用什么存。这类数据写多读少,要按时间和字段做聚合查询,单条又可能很大。Langfuse 自部署的架构可以当参考:Trace 先整批写进对象存储,Redis 做队列,Worker 异步写入 ClickHouse(存 trace、observation、score),Postgres 存事务数据。要点是元数据进列存,大文本放对象存储,两边的保留期分开定。OpenTelemetry 的约定也推荐生产环境把内容存到外部,span 上只留引用,还能单独控制访问权限。
本地跑的 Agent 是另一种情况。快手大模型 Agent 一面问:配置和会话数据放在目录里,会不会有泄露问题?Trace 放在哪里?Claude Code 是在本机明文存到 ~/.claude/projects/ 下,默认留 30 天,周期用 cleanupPeriodDays 调。所以要管好目录权限,别让它进仓库。
- 里面有敏感内容
OpenTelemetry 的约定写明,指令、用户消息、模型输出属于敏感内容,默认不应该采集,由用户主动打开。Claude Code 也是默认不记提示词内容和工具细节,要设 OTEL_LOG_USER_PROMPTS 这类环境变量。OpenAI Agents SDK 相反,trace_include_sensitive_data 默认是 True,用之前要看一眼。
不看内容又很难查问题。Anthropic 2025 年的复盘承认,内部的隐私和安全控制限制了工程师查看用户对话,用户没有主动反馈的尤其如此,这也让排查更难。可用的办法,Hamel Husain 和 Shreya Shankar(两位讲 AI 评测课的作者)在 FAQ 里按优先级排过:找能看的真实数据,比如客户同意分享的一部分;请有权限的领域专家看;脱敏以后再看,脱敏工具会漏,要抽查;合成数据放最后。
产品上可以让用户授权这一条。Claude Code 的评分弹窗只记评分,后面单独问能不能看这次的记录,选 Yes 才上传,上传前还会抹掉已知格式的密钥。
- 用什么工具
虾皮问有没有接 LangSmith,一家独角兽问 Trace 用什么记录。常见的有 LangSmith、Langfuse(开源,可自部署)、OpenTelemetry 加自己的后端。选型上我会这么答:用 LangGraph 的接 LangSmith 最省事(第 10 题);数据不能出域的选自部署;已有调用链体系的走 OpenTelemetry。
接着会被问「Trace 具体怎么用,有没有通过它分析过中间某个节点出问题」(百度),所以要准备一次真实的查询经历。
面试常问:Agent 的可观测性怎么做?Agent 很容易变成黑盒,任务失败怎么做可观测?执行的时候对你来说是黑盒吗?有没有 Trace、Span 这类调用链记录?Agent 执行 Trace 用什么工具记录?接了 LangSmith 这类轨迹追踪工具吗?Trace 的 Hook 怎么设计,分几层?一次请求在 Trace 上是什么形式?Trace 具体怎么用,会做分析吗?执行监控的主体是大模型,还是固定的脚本或工作流?怎么查看完整执行链路、异常和 Token 消耗?评测时记录哪些 Trace 数据?全链路观测的数据用什么存?配置和会话数据放在目录里会泄露吗,Trace 放在哪里?大量用户上线后,怎么搭观测系统?怎么排查、定位某个订单处理失败?
三、线上怎么发现问题
- 用户反馈只是一部分
Anthropic 的评测指南列过用户反馈的缺点:稀疏,用户自己选择要不要反馈,偏向严重问题,用户很少说清为什么。可 Anthropic 那两次事故都是用户先发现的,内部评测当时都没抓住。所以入口要有,只靠它不行。
信号分两类:
-
显式:点赞点踩、报错入口、转人工。度小满问「正反馈、负反馈怎么处理」,拼多多问「反馈机制有效吗」。点踩时让用户选一下哪里不对(答错了、没回答问题、太慢),带上 trace id,后面才查得动。
-
隐式:用户的行为。元戎启行那题:任务失败后,用户又提交了两三次同样的问题。还有改写重问、中途放弃、撤销 Agent 的改动、把产出改了很多才用。
- 全量看不过来
百度后端 Go/Agent 一面问:最开始怎么自动发现 Agent 执行过程中的问题?ToC 产品每天上万甚至几万条任务,不可能全部再跑一次大模型分析,否则成本翻倍。
一层层筛:
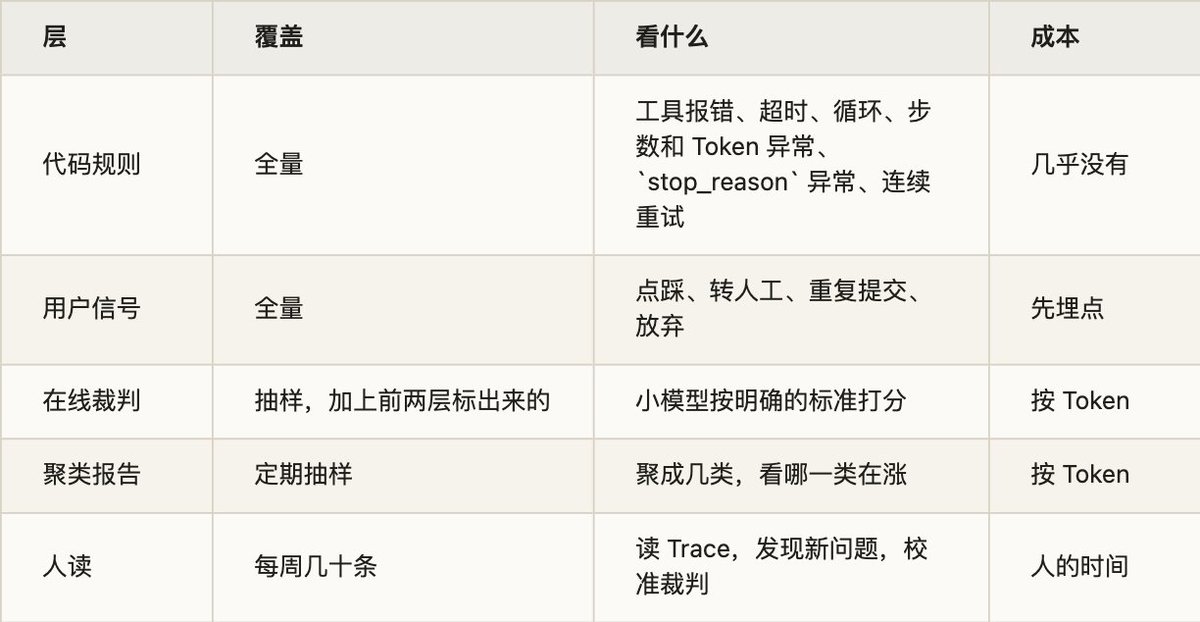
「成本翻倍」这个前提可以拆开算。主任务要用强模型跑很多轮,分析只读一份裁剪过的 Trace,用便宜模型跑一轮。按 Haiku 5.5 的价格(11 月 4 日读的)算,裁到 2 万 Token、输出 300 Token,一条约 0.2 美分,3 万条全看一天约 65 美元,抽 5% 约 3 美元。主任务如果一条 0.2 美元,一天是 6000 美元。LangSmith 文档给的 Insights 报告也在这个量级:分析 1000 个会话 1 到 4 美元。
难的是裁判准不准(第 4 题)。Hamel 的建议是:模型裁判至少要 100 条标注和持续维护,只给要反复迭代的问题用,能用正则、结构校验、执行测试的先用代码。
抽样可以随机,也可以按异常值(特别长、多次重试、Token 异常)和按场景分层。频率上,Hamel 建议每个周期看 100 条以上新 Trace(常见 2 到 4 周),平时每周看 10 到 20 条,盯异常值。Anthropic 的建议是反馈随时分拣,每周抽样读记录。
工具方面,LangSmith 的规则可以设采样率,比如只对 10% 的 Trace 跑裁判,也能把负反馈的 Trace 自动送进人工标注队列;OpenAI 有 Trace grading。同花顺问的「定时分析,生成缺陷评估报告」就是这一层。Cursor 今年六月那篇研究也是这个思路:让审计模型读了 731 条运行轨迹,发现成功解决的问题里 63% 带有获取已知解法的痕迹。
- 评测全过,线上出错
某大厂测开那题(Text-to-SQL 线上偶现错误,离线评测全过)第 4 题第六节讲过:题不像线上、判得太松、环境不一样。Anthropic 两次复盘又补了两条。2025 年那次说,评测没抓住,部分原因是模型常常能从单次错误里恢复过来,看最终分数看不出来。2026 年那次说,员工用的内部版本和用户拿到的公开版本不一样,之后要让更多员工用和公开版完全相同的构建。
- 剩下那 1%、2%
美团日常一面问:测评只能说明大概率答对,剩下 1%、2% 的错误怎么识别,要不要给最终产出加检测?按能不能校验分。能校验的(SQL 在影子库执行、引用逐条核对、结构化结果查约束)可以在线同步拦;不能校验的异步抽样判。Hamel 的区分是:同步护栏要快,误杀率要低,所以几乎不用又慢又不确定的模型裁判;评估在响应之后异步跑,可以慢。
面试常问:用户反馈怎么收集?用户的正负反馈怎么处理?反馈机制有效吗?最开始怎么自动发现 Agent 执行中的问题,每天几万条任务总不能都再跑一遍大模型?任务失败后用户重复提交,从埋点怎么分析?上线后怎么收集对话和 Trace,定时分析生成缺陷报告?是否统计线上有效会话,真实用户的表现和离线评测有什么差异?对复杂执行链和复杂产物,怎么观察线上效果?测评只能说明大概率答对,剩下的错误怎么识别?离线评测全过,线上偶现错误,根因在哪?
四、定位:第一处走偏在哪
- 先确认现象
拿到 Trace 先判断三件事。
是不是真的错。有时是功能本来没有、问题超出范围,这类也记下来,归产品。Hamel 的说法是,让产品变差的都要记,不管是不是模型的错。
必现还是偶发。把这次请求原样重放多次。10 次错 10 次和 10 次错 2 次是两种问题:前者先查上下文和提示词,后者除了查原因,还要想怎么校验和兜底。
能不能缩小。Hamel 举的例子:购物助手在第 4 轮答错了退货政策,先把它简化成一句单轮提问,如果还错,说明和对话上下文无关,多半是检索或知识的问题。确实依赖上下文的,可以用 N-1 测试:拿真实对话的前 N-1 轮,只测最后一步。
线上复现不了时,可以看运行痕迹。字节剪映前端一面问:用户反馈 Agent 卡死不动了,怎么排查?那位候选人的答法:本地用断点和二分定位模块;线上按用户 ID 查日志,看最后更新时间,看会话日志有没有循环、内存是否异常、容器是不是一直 running。百度日常实习问的「通过日志能不能定位 Agent 卡在哪里」是同一类。这种多半在 Harness,和模型无关。也可能在前端:Fable 的指南提醒过,用户看不到进度时,先查客户端有没有请求并显示,显示链路没接好,提示词写多少遍「及时汇报」也没用。
- 找第一处走偏
读 Trace 的顺序:先看用户能看到的部分,判断从哪里开始不对;再往回找第一处出错的步骤,后面的先不管。错误会往下传,修掉上游,下游常常跟着好。Hamel 和 Shreya 的建议就是一开始只标第一处(first upstream failure)。
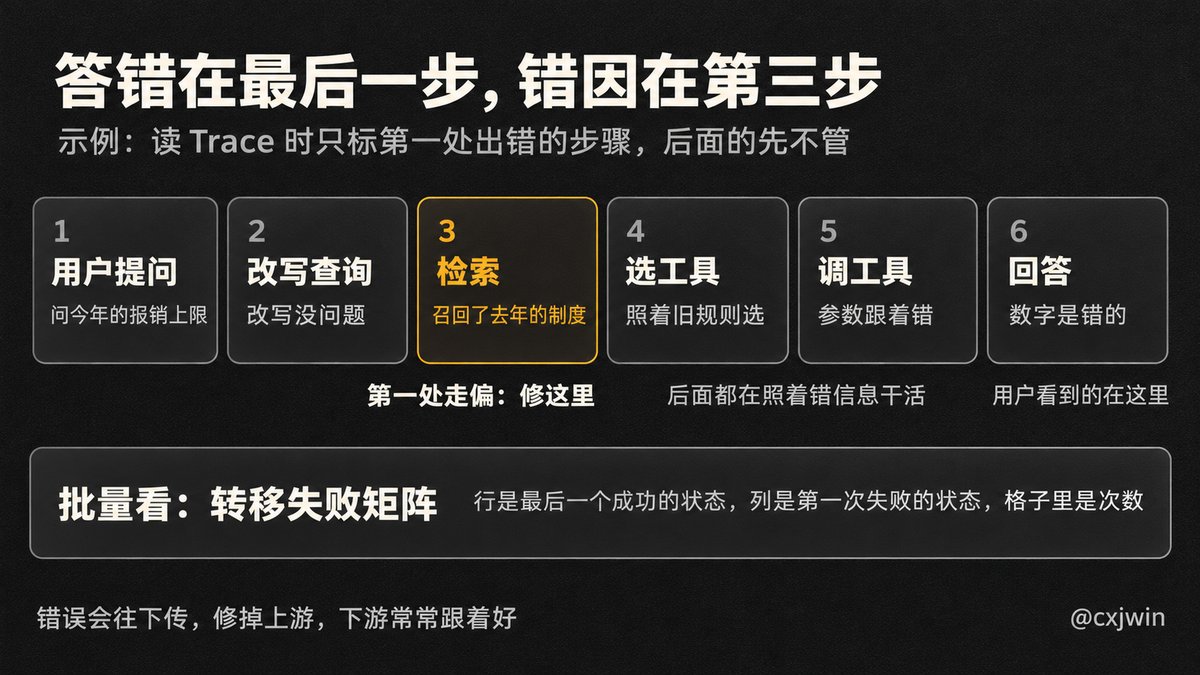
字节二面那一问可以这样答:先端到端判这个任务成没成,再按步骤判:工具选对没有,参数完整吗,空结果和报错处理得怎样,前面的约束还在不在,步数和 Token 正常吗,关键节点到了没有。每一项都算通过率,差的那一段就是方向。第 15 题讲 RAG 排查用的是同一个办法。
批量看的时候可以做转移失败矩阵:行是最后一个成功的状态,列是第一次失败的状态,格子里是次数。Hamel 和 Shreya 的 Text-to-SQL 例子里,生成 SQL 到执行 SQL 这一格 12 次,决定工具到规划日历只有 2 次,先查哪里一眼就能看出来。
- 怎么确定是 Prompt 的问题
快手那一问。对着 Trace 里实际发送的内容,依次问三个问题:
-
模型看到该看的信息了吗?没有,就是上下文的问题:检索没召回(第 15 题)、压缩丢了(第 5 题)、记忆没取到(第 6 题)、工具结果被截断。这时改提示词、换模型都没用。美团 AI 后端一面问的「RAG 回复差,怎么定位是检索还是生成」就是这一步。
-
信息都在,指令清楚吗?有没有互相矛盾、含糊的地方?有,就是提示词的问题。
-
信息在,指令也清楚,还是错。这时才轮到模型。
判断完要用实验确认。一次只改一样,每种改法跑多次,比失败率:
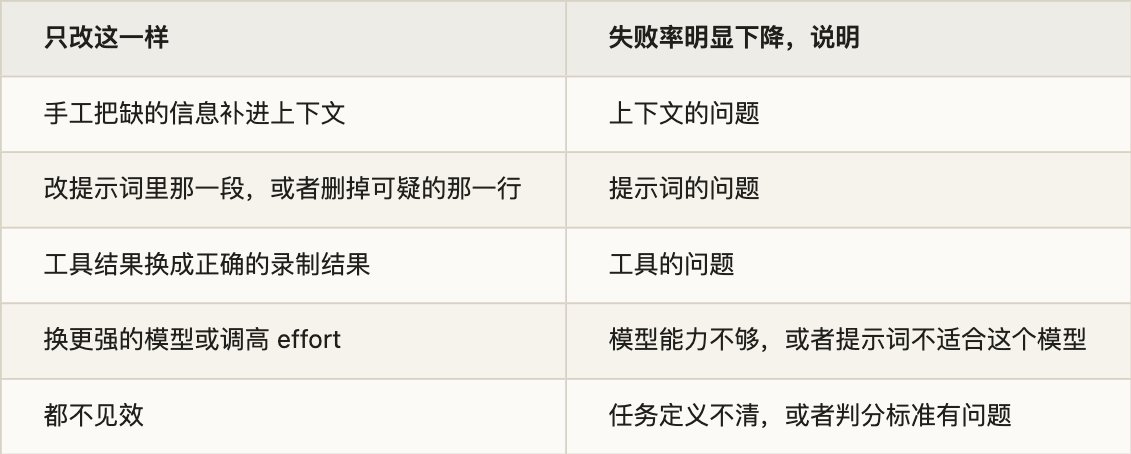
Anthropic 的消融用的就是第二行。LangGraph 的 time travel 也能做这种实验:从某个 checkpoint 改 state 分叉重跑。注意 checkpoint 之后的节点会真的重新执行,模型调用和 API 请求都会再来一遍,结果也可能不同,有副作用的工具要隔离(第 10 题)。
我自己犯过跳步的错。Fable 5 第一次上架那几天,我把一条在 Opus 4.8 上调了半小时的 code review 提示词直接切过去,吐了一屏废话,第一反应是模型有 bug。翻文档才看到,旧 Skill 规定得过细可能让输出变差。这也只是给了排查方向,证明不了是哪条指令拖了后腿;要证明,得固定素材和模型,一次只改一条。模型、客户端、整套 Skill 同时换掉,出了问题就很难定位。
- 现象对照表
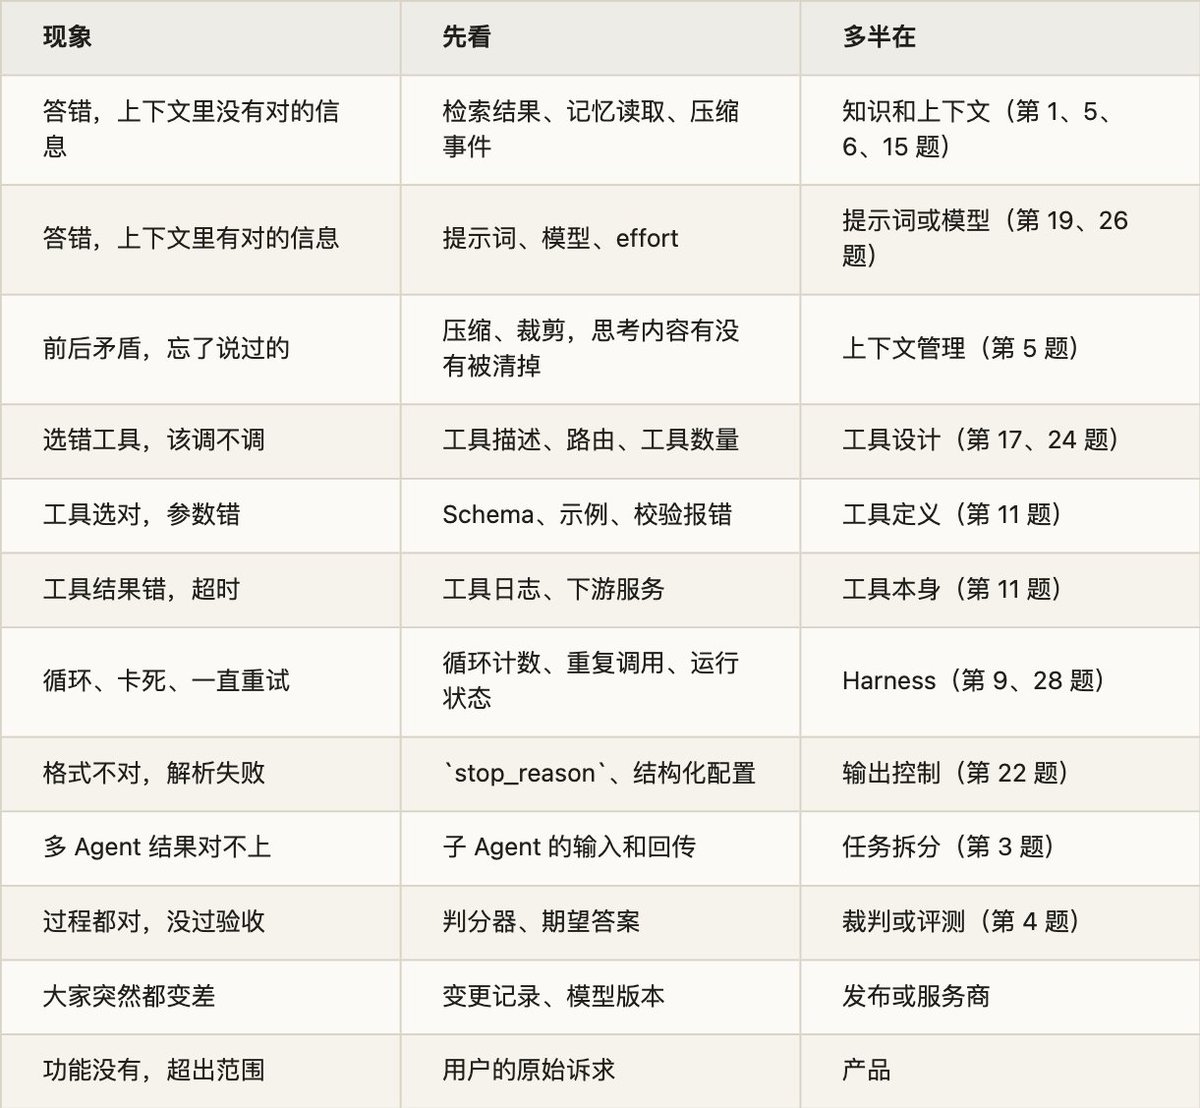
- 别问模型为什么
网易那题括号里写着「可解释性」。这个词容易答成让模型解释自己的决定。模型的解释不能当证据:Anthropic 2025 年测过,给模型一个暗示,它确实用了,思维链里承认用了的比例,Claude 3.7 Sonnet 是 25%,DeepSeek R1 是 39%(都是早一代模型)。思考内容可以当线索,下结论还是靠 Trace 和实验。工程上的可解释性,落到能回答这几个问题:它看到了什么,调了什么,返回了什么,结论的依据是哪一段。
我八月写过 DeepSeek Harness 的一份事故复盘,里面有句原话:相信 trace,别迷信理论。团队先花几个小时推出一套优雅的理论,机制是真的,但先炸的那个 bug 只是一行多余的 export default,最后靠加一行日志,几分钟就定位了。两个互相独立的 bug,还藏在同一条错误信息后面。
- 先查最近谁变了
一直好好的突然变差,先把变更时间线和失败率、负反馈曲线叠在一起看。变更包括提示词、模型版本、默认配置、工具定义、依赖、知识库、灰度实验。也可能在服务商那边:Anthropic 2025 年那次是三个基础设施 bug,其中路由错误最高时影响 16% 的 Sonnet 4 请求,约 30% 的 Claude Code 用户至少碰到过一次。自己这边没变,就换个时间、换个区域、换个渠道跑同样的请求对比。
面试常问:用户对一次回答不满意,怎么排查,怎么确定是不是 Prompt 的问题?成功率上不去,怎么区分是大模型的问题,还是 Skill、MCP、工具调用的问题?Agent 返回结果不理想怎么排查?项目怎么构建 Trace,怎么定位问题?有没有通过 Trace 分析过中间某个节点出问题?用户反馈 Agent 卡死不动,怎么排查?通过日志能不能定位 Agent 卡在哪里?输出不按约定输出,和幻觉、降级检索是什么因果关系?
五、分类:从一条到一类
- 批量看时先别查根因
上一节讲的是单条投诉。要定优化方向,得把一批放在一起看,这时顺序反过来:先记现象,数出哪一类多,再对多的那几类查根因。Hamel 的解释是,推迟查根因,能看更多条,标注质量也更高。
做法来自定性研究,OpenAI 的 cookbook 也用这一套:
-
抽样。OpenAI 建议从约 50 条失败开始,Hamel 建议至少看 100 条,看到不再冒出新问题为止。
-
开放编码(open coding)。每条写一句自由的备注,说看到了什么问题,不套现成的类别。最好由一个懂业务的人来做。
-
轴心编码(axial coding)。把备注归成几类,可以让模型帮忙归,人来确认。
-
数数。每类多少条,Excel 透视表就够。
Nurture Boss(公寓行业的 AI 助手)这么做以后,发现三类问题占了 60% 以上;单看日期处理,成功率从 33% 提到 95%。直接用「幻觉」「毒性」这类现成指标,容易漏掉业务特有的问题。
- 类别怎么定
美团 AI 数据开发一面问:业务反馈零散,表象不同但根因一致,怎么抽象归类?bad case 怎么分类?接着追问:会不会继续往下追,比如意图识别、检索召回、大模型幻觉、权限问题?
可以分两列记:
-
现象,用户看到什么:答错、没答、太慢、越权、格式错、卡死。
-
第一处走偏,错在哪一层:意图、检索、上下文、工具选择、工具执行、模型推理、裁判、产品。
「表象不同但根因一致」就是第一列不同、第二列相同。按第二列合并,修一处能解决一批。
学术上的分类可以当检查清单。MAST 从 150 条多 Agent 轨迹里归出 14 种失败模式,分成系统设计、Agent 之间不对齐、任务校验三大类。
字节前端二面出过一道 AI Coding 题:RAG 知识库收到一批反馈,要做一套机制帮 PM 决定接下来改什么。那位候选人先写脚本清洗归类;关键词匹配有缺陷,想改用 LLM,面试官问成本高怎么办,最后得出设计置信度指标的结论。这和第三节的漏斗是一个思路:规则拿得准的,不花模型的钱。
- 优先级
同花顺问怎么按缺陷严重程度定优化优先级,B 站问 Agent 效果一般、有一些 bad case,怎么确定优化方向。
我会看三样:频率,严重程度,修复把握。严重程度可以分几档:不可逆的错误操作,错误的业务结论,答非所问,体验差(慢、啰嗦)。低频高危的单独拎出来,越权和误删出现一次也要修(第 20 题)。
拼多多问:要把效果提上来,除了换模型、加约束,还能怎么优化?分类表本身就是答案,按占比从上往下修。换模型放到后面,它会同时改变所有任务的行为,出了变化说不清原因。
分类也会过期。Hamel 建议每次大改(新功能、改提示词、换模型、修大 bug)之后重做一遍。
面试常问:bad case 怎么分类,有哪些类别?业务反馈零散,表象不同但根因一致,怎么抽象归类?会不会继续追到意图识别、检索召回、幻觉、权限这些底层问题?Agent 效果一般、有一些 bad case,怎么确定优化方向?怎么按缺陷严重程度定优化优先级?评测结果怎么驱动后续迭代?要把 Agent 效果提上来,除了换模型、加约束,还能怎么优化?RAG 知识库收到一批反馈,怎么做一套机制帮 PM 决定改什么?
六、修和回流:回到哪一层
- 回到哪
修法和回流是一回事:同样的错,下次由谁拦住。
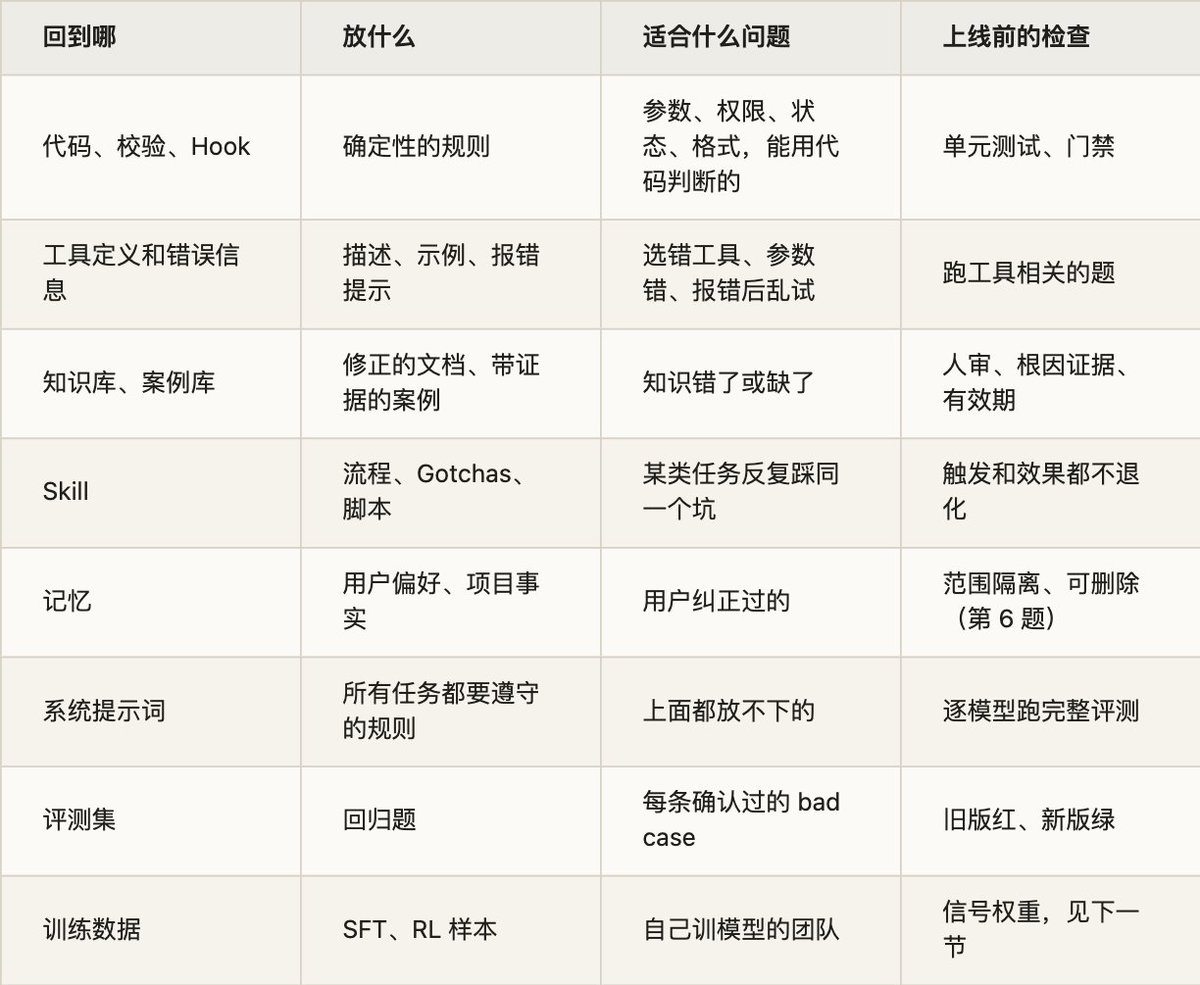
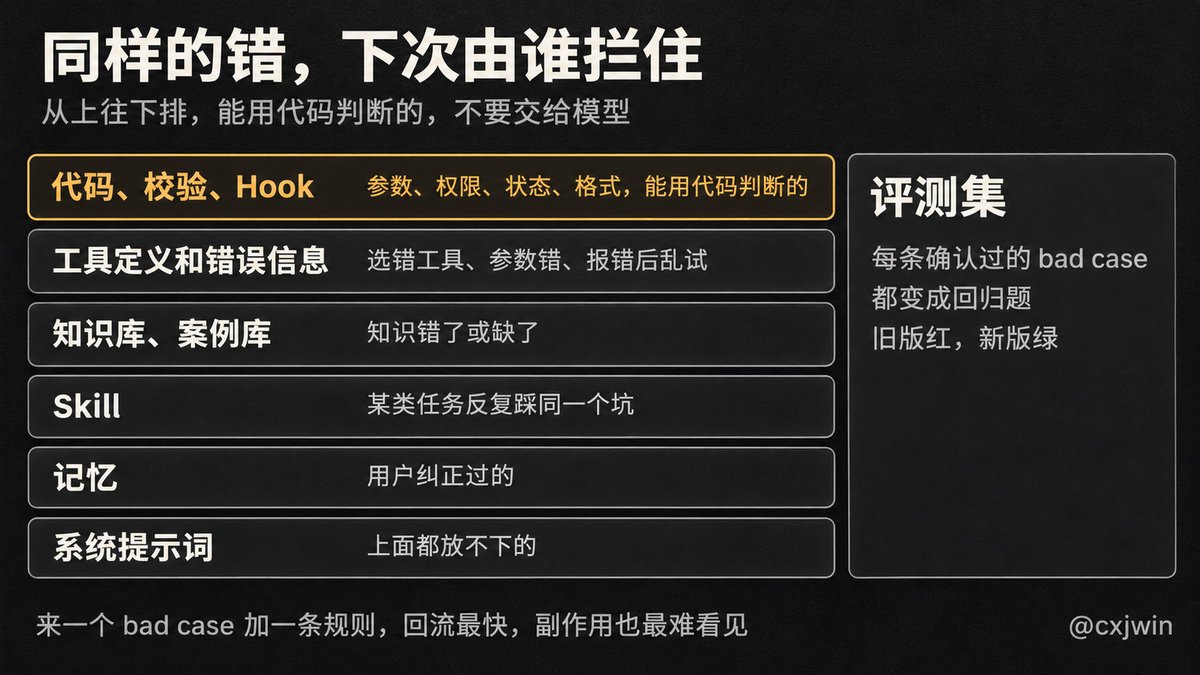
前六行从上往下排,能用代码判断的,不要交给模型。pstack 那篇有一句我划过重点:错误信息就是写给 Agent 的提示词,只在出错时才占 Token,比在 SKILL.md 里预先写一堆注意事项划算。
DeepSeek Harness 那次复盘的处理方式是「教训不进 wiki,进门禁」:补一个走真实路径的端到端测试,把两条规则写进 AGENTS.md,每个 Agent 干活都带着。我翻他们仓库时看到的反面证据:架构图谱漏包、README 索引漏表,这些漂移全发生在没有门禁的地方。
- 常见的错:往系统提示词里加一句
来一个 bad case 加一条规则,回流最快,副作用也最难看见:
-
Anthropic 那句 25 词的限制就是为了治「太啰嗦」加的,结果写代码的质量掉了,内部测了几周没看出来。
-
我自己的写作 Skill。我让 AI 读旧文归纳文风,「他常这样写」留在了文件里,后来变成每篇至少 3 处,还进了交稿检查。隔壁的去 AI 味 Skill 又要求控制同一个句式,我从没把这两份文件并排读过。
-
反方向的例子:Anthropic 把 Claude Code 的系统提示词删掉 80% 以上,编码评测没有可测量的损失。
加之前先问:这条是项目事实,还是在纠正某个模型的某次表现?我现在的仓库把两类分开放,项目事实跟着项目走;模型纠偏单独存放,注明适用模型、具体行为和验证记录,没有验证记录的不入库。Anthropic 复盘里的改法也接近:模型相关的改动要限定到对应的模型,每次改系统提示词都按模型跑一整套评测。
- 回到 Skill
理想汽车问:流水线发现了代码问题,怎么变成新规则,反哺流水线?卓越教育问:怎么保证 AI 不重复犯同样的错?
Anthropic 内部的经验是,Skill 里信号最强的是 Gotchas,从 Claude 反复踩的失败点积累起来;他们最好的 Skill 大多从几行字和一个坑开始。官方的 Skill 写作指南给了一个流程:一个 Claude 实例帮你写和改,另一个全新实例拿着 Skill 干真实任务,你观察它哪里卡住,把观察带回去改,再测。
回流的前提是只有一个源。我那套发推 Skill,开源仓库一份,笔记库一份,三周后例行同步才发现已经是两条演化线:笔记库长出来的能力一行都没回到仓库,两边都以为自己是最新的。修在一份上,另一份照样错。
- 回到评测集:一条回归题带什么
-
输入,多轮的带上前 N-1 轮。
-
当时的上下文和工具结果,录下来,否则下次跑的环境已经变了。
-
怎么算对:判分器,能用代码判的用代码(第 4 题)。
-
来源:trace id、分类、日期、出问题的版本。
-
脱敏。
加进去之前做两件事。简化到还能复现的最小样子。在出问题的版本上跑一遍,确认它真的会红,第 4 题讲过「门禁必须自证会红」。我写自己的题库时碰到过:判分探针在第二轮回复时误触发,差点把正确实现判成违规,所以每道题都要过双验证,参考实现全绿,空壳全红。
还有几点:
-
good case 也要回流。携程问的就是 bad case、good case 是否都入库。只收错例,评测集会偏向一边。Anthropic 举过网页搜索的例子:只测该搜的情况,Agent 就什么都搜。
-
分开放。回归集通过率接近 100%,掉了就是坏了;能力集一开始通过率就低。修好的题进回归集,还没修好的先进能力集。
-
防过拟合。留一批调优时不看的题(第 4 题)。
-
定期清理。一直全过的贵题要降频或者退休,评测集变了分数就和旧的不可比,长期趋势看产品指标(Hamel)。
工具上,Langfuse 可以在 Trace 详情里直接把一条加进数据集,数据集每次增删都生成新版本。LangSmith 的规则能把带负反馈的 Trace 自动送进人工标注队列,或者加入数据集。Anthropic 的建议是从 20 到 50 道来自真实失败的题开始,已经上线的产品就翻 bug 记录和客服队列。
面试常问:bad case、good case 是否回流入库?执行失败的结果怎么回流?信息怎么持续积累、更新?用户给了负面反馈,案例要不要沉淀下来?系统怎么根据使用过程和用户反馈持续优化?怎么把线上错例回流到评测集?项目怎么做测试和迭代(测试集、端到端、线上反馈)?发现的代码问题怎么变成新规则,反哺流水线?怎么保证 AI 不重复犯同样的错?
七、防污染:哪些不该回流
这个方向只有 3 位作者问到。名创优品:Skill 做 badcase 沉淀时,怎么防止错误的经验和提示词注入,避免个别案例污染?小米:知识准确性由谁校验,从抽取、蒸馏到入库要不要人工审核?一家中厂:网络问题拔网线插一下好了,根因其实是网络波动,这种「假案例」怎么拦?那位候选人当场答没考虑到,面试官明显失望。
- 用户反馈不是真值
2025 年 4 月,OpenAI 的 GPT-4o 更新变得明显谄媚。原因之一是训练里新增了一路点赞点踩的奖励信号,它和另外几项改动合起来,削弱了原本压住谄媚的主信号,用户反馈有时候偏向更顺着自己说的回答。上线前离线评测都好看,小范围 A/B 也显示用户喜欢,只有几位专家说感觉不太对。他们还是上线了,周日晚上先改系统提示词止血,周一开始全量回滚,回滚用了约 24 小时。复盘里的说法是:用户反馈很重要,但正确解读它是自己的责任。
放到 Agent 上也一样。用户点赞的不一定对,点踩的不一定错。美团一场面试问的「有没有用户反馈过 Critic 判断错误,这种 bad case 怎么处理」,就要先判断到底谁错了。反馈是线索,进评测集之前要有人确认期望答案。
- 有些失败学不到东西
GEPA-Curator(2026 年 10 月的论文)说的就是这件事。失败的来源很杂:提示词的弱点、Harness 的限制、执行的随机性、裁判的噪声。不是每一条都能当学习材料,有些还有害。他们先筛任务再让优化器学,相比不筛的 GEPA 最多提升 20.7%。
手工回流同样要先定位,这一步决定它该回到哪。裁判错了修裁判,偶发的先算失败率。我自己碰到过:8 月给去 AI 味 Skill 跑对照,汇总报告说不带 Skill 的输出把「同比增长超过 400%」改成了「四倍」,判事实错误。打开原始输出,写的是「同比涨了四倍多」,数值上等价,单项评分也写明了,汇总却留着旧判罚。要是照这个结论往 Skill 里加一条规则,就把裁判的错教给了 Skill。
- 案例库里的假案例
拔网线那题的难处在于,操作和恢复同时发生,不等于操作解决了问题。那位候选人事后整理的答法可以参考:入库强制填结构化模板(现象、根因证据、处置方式、验证方法),证明不了命中根因的只算临时规避,标低置信度;案例人工审核;上线后用「命中这条案例之后问题解决了多少」当质量信号,低效的自动下线;带版本,及时清理过期的。
小米那一问也落在这里:模型可以抽取和预检,校验责任要落到人,或者有明确负责人的流程上。
- 回流本身是攻击面
用户的输入能变成规则,就能被注入。2026 年 8 月的论文 PoisonedEvolution 测了自进化 Skill 系统的投毒:攻击者只能看到目标 Skill、贡献有限的轨迹,看不到内部逻辑,也改不了 Skill。攻击者记录占 10% 时,SkillClaw 上换 6 个主流模型做演化器,600 次试验有 546 次把目标行为写进了 Skill(91%);结构不同的 Trace2Skill 也有 369 次(61.5%)。一个受控实验里,30 条记录中有 3 条一致的恶意记录就够了,只有 1 条则弱得多。论文的结论是,从经验晋升为指令这一步是安全边界。
落到设计上,我会这么做:轨迹和用户内容都当不可信输入;晋升看独立来源的数量,同一来源重复多次不算数;Skill 和规则的改动走审核,能追溯到来源轨迹,能撤销;回流来的规则不能扩大权限(第 20 题)。
面试常问:Skill 做 badcase 沉淀时,怎么防止错误的经验和提示词注入,避免个别案例污染?怎么避免错误知识被持续沉淀?知识准确性由谁校验?从抽取、蒸馏到入库,要不要人工审核?「拔网线就好了」这种假案例怎么拦?有没有用户反馈过 Critic 判断错误,怎么处理?
八、修完怎么防退化
- 怎么发现别的场景退化
字节那一问。同一批题、每题多次,和上一版比(第 4 题第五节),回归集和能力集都跑,按场景分桶看。总分不变可能是一类涨一类跌。过程指标也比:工具调用次数、Token、耗时。
先想清改动的影响范围。提示词和工具定义影响全部任务,Skill 影响触发它的任务,知识库影响相关的检索。字节一场一面问「迭代中怎么保证 Skill 不变差,报告怎么对比新旧」,某大厂测开问「LangChain 升级怎么设计回归测试」,问的都是这个。
- 回放和故障注入
美团 AI 后端二面问:自然语言 Skill 怎么测试和调试?会不会回放历史问题或注入已知故障,验证端到端效果?
回放有两种。录制回放把工具结果固定下来,只测模型和提示词,稳定、便宜,工具变了测不到。活环境回放真调工具,更接近线上,要有沙箱隔离副作用,结果也会变。两种都要,各管一段。故障注入是让工具超时、返回空、返回错误码,看 Agent 怎么处理(第 11 题第十节)。
- 测试本身有盲区
Anthropic 那个清思考内容的 bug,过了审查和各层测试。DeepSeek Harness 那个事故是 178 个测试全绿、行覆盖率 100%,真实编辑器一连就崩,因为测试走的路径和线上不是同一条。对策第 4 题讲过:测试走真实路径,门禁自证会红。Anthropic 还做了一次回测:拿 Opus 4.7 重新审查当时的 PR,给足仓库上下文能发现这个 bug,Opus 4.6 发现不了;之后给代码审查工具加上更多仓库的上下文。
- 灰度和回滚
深信服问:Agent 怎么做监控和回滚?波动超过阈值自动回滚,这个阈值怎么衡量和配置?蚂蚁问自动回滚的触发条件。字节 AI Infra 问 Agent 服务有没有做配置热更新、灰度、回滚。
先把能回滚的都版本化:提示词、工具定义、Skill、模型版本、知识库。做成配置,不发版也能切回去。OpenAI 那次周日晚上先改系统提示词止血,模型的全量回滚用了约 24 小时,能切得快的先切。已经在跑的 Agent 循环怎么办,第 9 题讲过。
和同时段的对照组比。Google SRE Workbook 讲过前后对比的风险:时间本身就是指标变化最大的来源之一,周一发布,可能在拿工作日和周末比。灰度组和对照组同时跑,差异才能归到这次改动上。
阈值要从波动算。基线成功率 90%,灰度组和对照组各 N 条,两组之差的 95% 波动范围大约是:
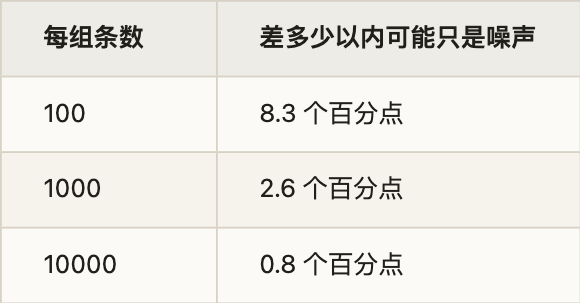
Anthropic 那次在评测上掉的是 3%,一百条的灰度看不出来。所以阈值不能拍脑袋定,样本量也要跟着定。
触发条件我会分开:报错率、超时、Token 暴涨、循环次数这些硬指标量大、灵敏,可以自动回滚;语义质量慢,裁判也有噪声,触发告警,人看过再决定。这个分法是我的判断,不是哪家的规定。
Anthropic 复盘后的新规矩是,可能影响智能水平的改动要加观察期、扩大评测集、逐步放量。OpenAI 的教训是,指标都好看也可能是错的:评测和 A/B 都说好,专家说不对劲,他们现在把定性信号也算作能拦发布的理由。
面试常问:修好一类 bad case 后,怎么发现其他场景有没有退化?迭代中怎么保证 Skill 不变差,报告怎么对比新旧?会回放历史问题或注入已知故障吗?自然语言 Skill 怎么测试和调试?LangChain 升级怎么设计回归测试?Agent 怎么做监控和回滚?波动超过阈值自动回滚,阈值怎么定?自动回滚的触发条件是什么?Agent 服务做了配置热更新、灰度、回滚吗?
九、自进化:能不能让它自己回流
这个方向 10 位作者问到,问法从「Hermes 怎么实现自进化」到「触发机制是什么」。拆开看,自进化就是把回流的每一步交给 Agent 自己:从轨迹里发现问题,归纳成规则,写进记忆或 Skill。
- 现在有哪些做法
Hermes Agent(Nous Research,第 9 题介绍过):
-
什么时候写。系统提示词要求它把不简单的流程记下来,覆盖三种情况:摸索出一个值得重复的多步流程;撞了错误和死路后找到走通的路;用户纠正了它的做法。另外有后台 review,在会话之后建议或暂存 Skill 的改动。东方财富那场追问「怎么判断该形成文档和技能了,总不能人通知它吧」,这就是一种答案。
-
写到哪。短小的事实进记忆(MEMORY.md 2200 字符,USER.md 1375 字符,写满了报错,不自动压缩),较长的流程进 Skill。Skill 要求写教训,不写流水账:一个坑写成能通用的规则,加一句原因。
-
怎么清。Curator 跟踪 Skill 的使用次数,14 天没用转 stale,30 天没用归档。用模型合并相近 Skill 的那一步默认关闭。
-
谁批准。write_approval 默认 false,打开以后写入先暂存,等人批。文档列的适用情况里有一条:小模型会误判自己学到了什么。
Claude Managed Agents 的 Dreams(研究预览):异步任务,读一个已有的 memory store 和 1 到 100 个过去的会话,产出一个新的 store:合并重复,过时和矛盾的换成最新的,提炼新的模式。输入的 store 不动,看完不满意可以丢掉。
Claude Code 的 auto memory 根据用户的纠正和偏好记笔记(第 6 题),/insights 生成报告,分析最近的会话哪里出了问题。
论文这边,Trace2Skill 把大量轨迹并行归纳成一份 Skill,比逐条编辑 Skill 和检索式记忆效果好;GEPA 采样轨迹,用自然语言反思诊断问题,提出并测试提示词更新。第五节说批量看才能看出类,这里也一样。Hamel 的提醒是,这类优化器能把提示词往已知的失败上爬,发现不了新的失败,新失败还得靠错误分析。
美团全栈那场问:轨迹层和知识层分别存什么?可以这么分:轨迹层存原始过程,完整、可追溯,不常驻上下文,用时检索(Hermes 用 FTS5 搜历史会话);知识层存归纳后的规则和偏好,进上下文。两层之间那一步是晋升。
- 为什么需要门禁
水滴一面问:自进化怎么固定下来,为什么需要门禁?阿里千问二面问:评测结果和 Agent 自动改 Skill 打通了吗?讯飞飞凡计划的面试官直接说:Skill 规模大了,人工维护提示词不可行;模型切换也不能靠人工全量重测,系统要有自进化能力。
规模上去以后,这个方向绕不开。可第七节的问题,自动回流一个都少不了,而且没人看着:学到错的,学到一次性的,被注入,越积越长。我那条句式规则就是人手动走完了这条路,自动的只会更快。
我会放三道关:
-
晋升条件。批量归纳,多次、多来源才写,偶发的丢掉。小厂 zlrs 那场,候选人事后整理的答法是定时扫描案例记忆,把「最近 20 次同类告警处置,15 次都在同一步走错」这种批量归因,一次改写,不逐条打补丁。
-
评测不退化。补丁先过回归集。同一份答法里还有给 Skill 调用埋点,统计结果被采纳还是被回退,长期有害的自动降权。
-
按影响范围分权限。个人 Agent 写自己的记忆可以放开;共享的 Skill 和系统提示词要人审或者小流量。
没有评测集之前,我不会开全自动:没有尺子,它改好改坏都不知道。我写大扫除那篇时的话是:给个人项目和工程项目投入的验证成本可以不同,但判断效果时,证据该证明什么,不能跟着放宽。
面试常问:Hermes 怎么实现自进化?Agent 自进化的原理是什么,哪些因素会影响它?自进化怎么设计,轨迹层和知识层分别存什么?触发机制是什么,产出有哪些?怎么设计一个自进化的 Agent,怎么判断该形成文档和技能了?Skill 的自我优化怎么设计?Skills 知识进化的流程怎么搭?评测结果和自动改 Skill 打通了吗?自进化怎么固定下来,为什么需要门禁?
十、反过来:让 Agent 查线上问题
8 位作者问的是另一件事:Agent 的工作就是排查问题。其中 7 场只问了这个,所以单列。方法和第四节相通,只是动手的换成了 Agent。
- 网易互娱那道设计题
线上业务报错,用 AI 自动分析、分类、修复并提 MR,要分哪些模块?怎么选型?
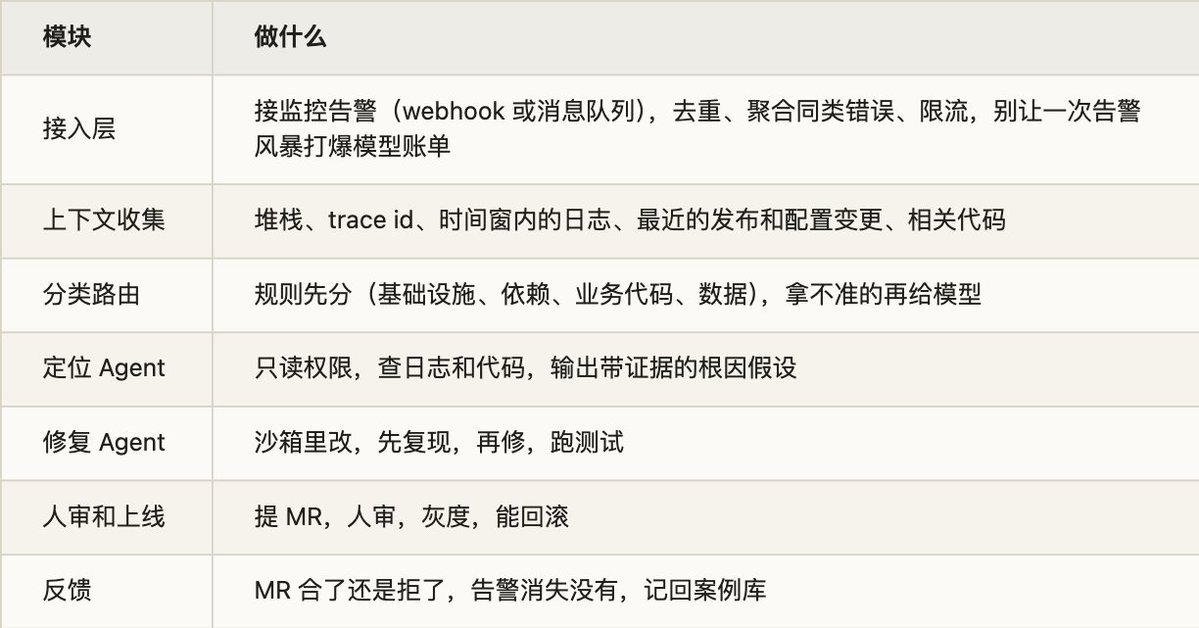
选型上,接入层用现有的告警和消息系统,Agent 框架要支持 checkpoint 和人工介入(第 10 题),状态进关系库,日志留在原有系统里让工具去查。这张表是我的设计,不是哪家的方案。
- 给 AI 什么上下文
美团容器平台问:线上只看到一条异常信息时,给 AI 哪些上下文?堆栈、发生时间、版本、最近的变更、相关配置、影响范围、能不能复现,再给它查日志的工具,不要把日志整个贴进去。百度 Harness 那场追问日志预处理会不会丢关键信息,第 12 题讲过:原文落盘,过滤时留错误前后几行,给模型写明截掉了多少。
- 日志里没有的错
字节大模型和百度 Harness 都问:有些错误程序没打日志,怎么办?办法是让它能复现和插桩。DeepSeek Harness 那个 bug 就是加一行日志定位的。pstack 的做法更进一步:给 Agent 一个能驱动 app 的 CLI,自己开 app、点、看 console、录 trace。也可以从外部信号反查:指标异常、用户反馈、相邻服务的报错。
- 根因错了怎么办
途游问:Agent 分析的故障根因有错,怎么重新触发诊断?两件事。根因要带证据,人能判断。否决时把「这条假设错了,为什么错」写进状态,从出错的节点接着跑,别从头来,也别让它再绕回同一个假设。拔网线那题是它的延伸:错的根因不能进案例库。
- 自动改到哪一步
赫玛科技问:Agent 能生成根因报告,为什么没做自动改代码闭环?小米问实际项目里怎么用 Agent 排查修复线上问题。
按风险分级:只读分析最安全,先上;提 MR 让人审是第二步;低风险的变更才考虑自动合。Anthropic 那次回测里,给足上下文的 Opus 4.7 能审出那个 bug,Opus 4.6 审不出,审查能不能交给模型,要看模型和上下文。pstack 的作者说可以把用户反馈接进 Slack,bot 自动派 Agent 复现,verification skill 足够好时甚至直接修。我当时持保留态度:这个前提在天天有人维护的代码库里可能成立,在三个月没人碰的项目里大概率不成立。
面试常问:怎么设计一套线上报错自动分析、分类、修复并提 MR 的系统,模块和选型怎么定?实际项目里怎么用 Agent 排查修复线上问题?有没有 AI 线上排查经验?线上只看到一条异常时给 AI 哪些上下文?线上报错或测试结果不符合预期时,怎么用 AI 定位?日志里没打出来的错误怎么办?Agent 分析的根因错了,怎么重新触发诊断?为什么没做自动改代码闭环?上线时有没有修复失败的问题?
十一、面试怎么答
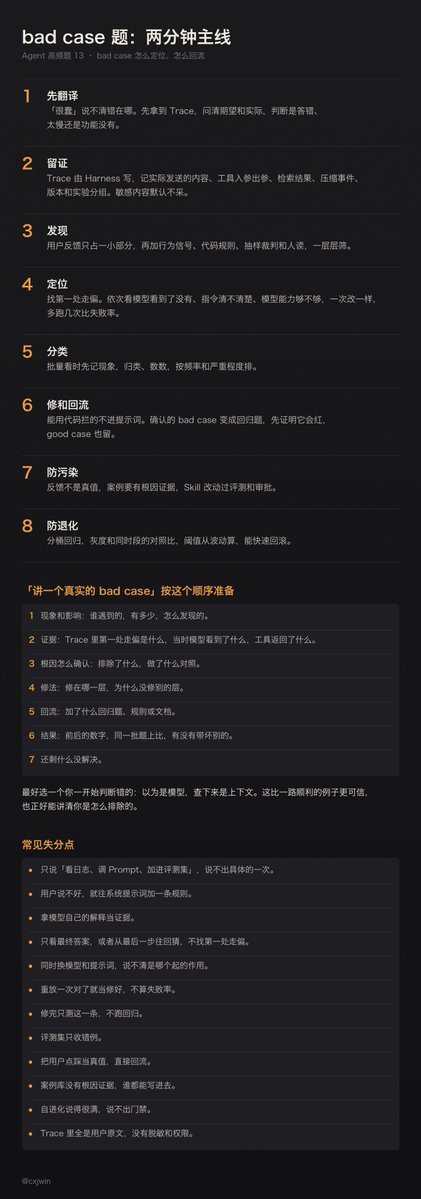
两分钟左右的主线:
-
先翻译:「很蠢」说不清错在哪。先拿到 Trace,问清期望和实际,判断是答错、太慢还是功能没有。
-
留证:Trace 由 Harness 写,记实际发送的内容、工具入参出参、检索结果、压缩事件、版本和实验分组。敏感内容默认不采。
-
发现:用户反馈只占一小部分,再加行为信号、代码规则、抽样裁判和人读,一层层筛。
-
定位:找第一处走偏。依次看模型看到了没有、指令清不清楚、模型能力够不够,一次改一样,多跑几次比失败率。
-
分类:批量看时先记现象,归类、数数,按频率和严重程度排。
-
修和回流:能用代码拦的不进提示词。确认的 bad case 变成回归题,先证明它会红,good case 也留。
-
防污染:反馈不是真值,案例要有根因证据,Skill 改动过评测和审批。
-
防退化:分桶回归,灰度和同时段的对照比,阈值从波动算,能快速回滚。
「讲一个真实的 bad case」按这个顺序准备:
-
现象和影响:谁遇到的,有多少,怎么发现的。
-
证据:Trace 里第一处走偏是什么,当时模型看到了什么,工具返回了什么。
-
根因怎么确认:排除了什么,做了什么对照。
-
修法:修在哪一层,为什么没修别的层。
-
回流:加了什么回归题、规则或文档。
-
结果:前后的数字,同一批题上比,有没有带坏别的。
-
还剩什么没解决。
最好选一个你一开始判断错的:以为是模型,查下来是上下文。这比一路顺利的例子更可信,也正好能讲清你是怎么排除的。
几个常见的失分点:
-
只说「看日志、调 Prompt、加进评测集」,说不出具体的一次。
-
用户说不好,就往系统提示词加一条规则。
-
拿模型自己的解释当证据。
-
只看最终答案,或者从最后一步往回猜,不找第一处走偏。
-
同时换模型和提示词,说不清是哪个起的作用。
-
重放一次对了就当修好,不算失败率。
-
修完只测这一条,不跑回归。
-
评测集只收错例。
-
把用户点踩当真值,直接回流。
-
案例库没有根因证据,谁都能写进去。
-
自进化说得很满,说不出门禁。
-
Trace 里全是用户原文,没有脱敏和权限。
面试常问:最难定位的一个 bad case 是什么?印象比较深的 bad case?遇到过哪些 bad case,根因是什么,怎么解决?选一个真实的 bad case,讲清 Skill 做了什么判断、工具输出了什么、优化后变了什么?讲一个因为 Harness 没做好导致的问题,怎么排查和解决?讲一个 Agent 效果上的具体问题,怎么迭代改进的?Bad case 怎么优化?这种方式的 bad case 有吗,做得不够好的地方?生成内容会出现哪些质量 bad case?90% 的成功率之外,失败的原因是什么?上线碰到过什么异常,用户有什么反馈?任务先执行再检查,第一个任务就有问题会把错误放大,出现过吗?
出处
文中的面试问法都出自下面这些面经,括号里是发帖日期,链到牛客原帖。
-
开头的例子:快手一面(发券)(10-02) · 网易 Agent 开发一面(10-17) · 字节二面(10.12)(10-12) · 字节一面(260901)(10-03)
-
可观测:B 站测开一面(08-20) · 上海某独角兽 AI 全栈(08-28) · 虾皮 Agent 开发一面(8.27)(09-01) · 阿里边缘 BU 一面(09-03) · 百度 Agent 一面(09-06) · 百度 Agent 开发日常实习(09-07) · 格物致信一面(09-07) · 百度 AI 测开一面(09-08) · 帆软后端二面(09-14) · 某 Agent 开发面经(09-18) · 阿里千问二面(09-22) · 腾讯社招二面(09-23) · 腾讯社招一面(09-23) · 快手大模型 Agent 研发一面(09-23) · 影石移动端一面(09-30) · 快手一面(发券)(10-02) · 字节一面(260901)(10-03) · 同花顺一面(10-10)
-
讲一个真实的 bad case:作业帮一面(09-05) · 阿里 Token Foundry 二面(09-08) · 百度 Agent Harness 一面(09-08) · 某小厂 Agent 开发实习(09-11) · 韶音 AI 应用开发一面(09-12) · 金山数娱 AI 应用开发一面(09-13) · 美团一面(Agent 工作流)(09-16) · 携程 AI 应用开发二面(09-18) · 4399 Agent 开发(09-18) · vivo Agent 开发线下面(09-22) · 淘天供应链 AI 应用研发一面(09-23) · 美团 AI 后端一二面(食杂零售)(10-01) · 海底捞 AI 工程师实习一面(10-12) · 滴滴企业级算法实习一面(10-16)
-
用户说不好,怎么定位到哪一层:元戎启行前端三面(08-27) · 百度秋招 Agent 一二三面(08-28) · 百度 AI 测开一面(09-08) · 字节 TikTok Shop 后端一面(09-08) · 广州某中小厂 Python 后端实习(09-09) · 某 Agent 开发面经(09-18) · 字节剪映前端一面(09-22) · 快手一面(发券)(10-02) · 字节二面(10.12)(10-12) · 某大厂测试开发一二三面(10-12) · 网易 Agent 开发一面(10-17)
-
回流:虾皮 Agent 开发一面(8.27)(09-01) · 字节前端二面(09-05) · 帆软后端二面(09-14) · 度小满 AI 全栈一面(09-30) · 美团 AI 后端一二面(食杂零售)(10-01) · 字节一面(260901)(10-03) · 理想汽车 IT 全栈交付培养生一面(10-09) · 拼多多 Agent 一面(10.8)(10-09) · 美团 Agent 一面(10-12) · 美团全栈日常实习一面(10-12) · 广州卓越教育后端(10-15) · 携程 Agent 一面(10-17)
-
自进化:小红书 Agent 开发实习一面(08-24) · 水滴质量一面(09-08) · 小厂 zlrs Agent 工程师一面(09-11) · 新旦智能 AI 应用开发一面(09-14) · 东方财富一面(09-18) · 阿里千问二面(09-22) · 阿里云 Agent 开发一二面(10-05) · 理想汽车 IT 全栈交付培养生一面(10-09) · 美团全栈日常实习一面(10-12) · 科大讯飞飞凡计划(10-13)
-
反过来:让 Agent 查线上问题:途游 Agent 二面(08-18) · 百度后端开发二面(08-20) · 字节大模型应用开发一面(09-06) · 百度 Agent Harness 一面(09-08) · 美团容器平台 Java 开发(09-12) · 小米后端二面(09-16) · 无锡赫玛科技(10-10) · 同花顺一面(10-10) · 网易互娱 AI 应用开发日常实习(10-16)
-
分类、优先级、优化方向:B 站 Agent 二面(08-19) · 懂车帝 AI Agent 一面(08-28) · 拼多多 Agent 复活赛一面(09-03) · 字节前端二面(09-05) · 美团 AI 数据开发一面(09-23) · 同花顺一面(10-10)
-
修完怎么防退化:深信服 Agent 三面(08-23) · 蚂蚁 Agent 开发复活赛二面(09-09) · 美团 AI 后端二面(09-14) · 字节 AI Infra 一面(09-14) · 字节一面(09-22) · 字节一面(260901)(10-03) · 某大厂测试开发一二三面(10-12)
-
线上怎么发现问题:美团 Agent 开发日常一面(08-25) · 元戎启行前端三面(08-27) · 百度后端 Go/Agent 一面(08-28) · 字节一面(260901)(10-03) · 同花顺一面(10-10)
-
防污染:名创优品 Agent 开发实习一面(08-26) · 小米后端 Java 一面(08-27) · 某中厂 AI 全栈一面(09-06)
-
正文引了但没计数:美团 AI 后端一面(09-10)
-
外部资料:Anthropic An update on recent Claude Code quality reports(2026-04-23)、A postmortem of three recent issues(2025-09-17)、Demystifying evals for AI agents(2026-01-09)、Reasoning models don't always say what they think(2025-04-03)· Thariq Shihipar Lessons from building Claude Code: How we use skills(2026-06-03)· Claude Skill authoring best practices、Dreams(11-04 读取)· Claude Code 文档 Monitoring、Hooks、Data usage、Memory、Commands(11-04 读取)· OpenAI Expanding on what we missed with sycophancy(2025-05-02)、Trace grading、Evaluation flywheel cookbook(已归档,11-04 读取)· OpenAI Agents SDK Tracing(11-04 读取)· Hamel Husain、Shreya Shankar AI Evals FAQ(2026-09-21 更新)· Hamel Husain A Field Guide to Rapidly Improving AI Products(2025-03-24)· OpenTelemetry GenAI 语义约定(11-04 读取)· Langfuse Concepts、Self-hosting、Datasets(11-04 读取)· LangSmith Observability concepts、Online evaluations、Automation rules、Insights(11-04 读取)· LangGraph Use time-travel(11-04 读取)· Hermes Agent README、Skills、Memory、Curator(11-04 读取)· Google SRE Workbook: Canarying Releases(11-04 读取)· 论文 MAST、GEPA、Trace2Skill、PoisonedEvolution、GEPA-Curator
-
我自己的文章:DeepSeek Harness 的「验尸」哲学(08-14)· AI 又升级了,我攒的提示词该大扫除了(09-06)· 让 agent 自己验收:pstack 指南解读(09-05)· AI 时代,你为什么要有自己的测试集?(07-07)· 谁说学霸 AI 不爱作弊?(06-29)· 别再指望 AI 自觉了:用 Hooks 把 Claude Code 管起来(05-25)· X 自动发文 Skill 更新:代码能复制了,还挖出一个分叉(08-12)· 62 分钟交卷,Token 用了预算的 192 倍(09-17)· 炸裂,Anthropic 给 Opus 5 删掉了 80% 的系统提示词(07-25)


