从业务的视角去了解 super agent 解决了什么问题
文章目录
哈喽大家好,我是欧呦,这篇文章带大家一起读懂 DeepSeek 团队最新发布的 《Super-agent 设计探索:迈向更自主的 Agent 系统》。
很多人点开 DeepSeek 这篇原文后的第一反应是“看不太懂”。这非常正常,因为原文是一篇面向底层工程实践的架构探讨,里面密集使用了大量操作系统与计算机体系结构领域的专业术语——比如全局序点(Sequence Point)、Prefill 批处理、Fast Path / Slow Path、Inline & Spill、投机执行(Speculative Execution)、半双工与全双工、存算分离以及外部控制回路(Control Loop)。
但如果从我们平时用 AI 干活的实际需求和产品落地的视角,把这层偏技术的术语外壳剥开,你会发现它里面的每一项设计,解决的其实都是我们在日常使用 AI Agent 时最真实的痛点。
下面我们就顺着原始文章的章节结构,把里面的核心技术原理逐个讲清楚,同时结合实际工作流,聊聊每一项设计到底解决了什么具体问题。
一、多任务痛点与定位差异
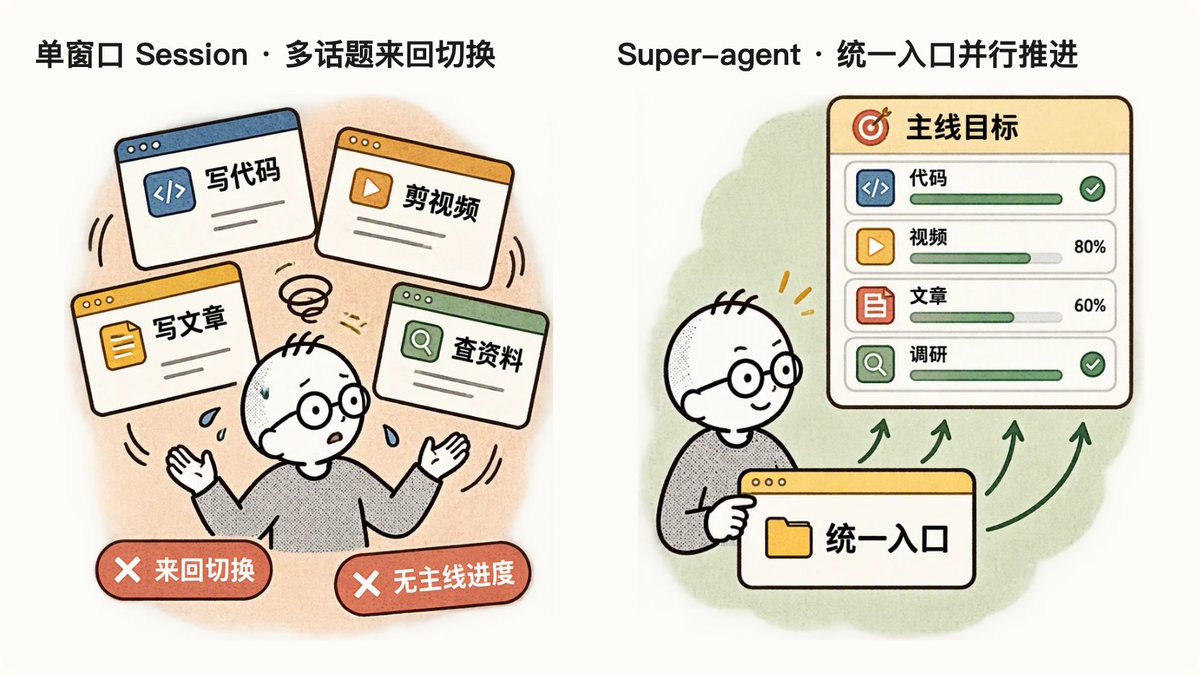
1. 单窗口 Session 的瓶颈:为什么话题一多注意力就不够用?
过去一年里,像 Claude Code、Codex、Antigravity 这类单任务 Agent 的执行能力已经非常强了,给一个明确的目标,它能自己调用工具一步步做完。
但在实际工作中,我们面临的瓶颈已经不再是“单个任务 AI 能不能做好”,而是多任务并行时人的注意力不够用。
以我自己的日常工作为例,同一段时间里我往往需要并行推进好几类事情:一边在进行 Vibe Coding 写项目代码,一边在做视频内容创作,一边在写课程文章,同时手里还挂着几个新技术的调研任务。平时我也会同时打开 Antigravity、Claude Code、Codex 等多个不同的 AI Agent 工具。
因为现有的 Agent 工具都是以单个 Session(也就是单个对话窗口、单个话题)为基本单位来工作的,不同话题之间彼此独立,这就会带来两个非常明显的使用痛点:
◆ 第一,在不同软件和话题之间来回切换非常麻烦
为了不让不同任务的背景信息互相干扰,我们往往需要同时开很多个话题窗口。正如 DeepSeek 在原文中观察到的,一个人通常最多只能同时跟进 3 到 5 个活跃话题——当并行的话题一多,注意力就会一直在不同窗口之间跑来跑去,单任务的上限取决于模型能力,而多任务的上限直接取决于人的注意力。
◆ 第二,缺少统一的进度提醒与主线目标管理
当七八个话题散落在不同窗口里同时推进时,很难在一个统一的地方直观看到「哪个任务已经做完了、哪个任务正在跑、哪个任务卡住了等待确认」,只能靠人挨个点开窗口去检查。更重要的是,每个独立话题只知道自己手头那一个小任务,至于「当前的整体主线方向是什么、这些零散任务怎么围绕主线目标配合」,全得靠人自己脑子记着。
为了打破「一个任务绑定一个手动对话窗口」的限制,DeepSeek 提出了 Super-agent 的概念,核心是让 Agent 具备四个基础特征:
-
连续:不管你在飞书聊天还是 GitHub 评论区跟它交互,感觉面对的始终是同一个 Agent,不需要自己去记“某条信息当时聊在哪个话题窗口里”。比如你先在飞书里说采用方案 A,过一会儿去 GitHub 代码合并请求(Pull Request,简称 PR)评论区改成方案 B,它能自动关联并调整方向。
-
高效:交互响应快,后台能同时并行推进多个复杂任务,不需要等上一个任务跑完才能发下一条指令。
-
主动:不需要等用户逐条敲命令,能持续观察工作环境里的消息和事件,主动推进值得处理的事项,不需要介入时就保持安静。
-
持久:始终在线,直接接入真实的工作环境,长期运行遇到异常时能自动恢复。
单个传统的执行循环无法同时满足这四个特征。为此,DeepSeek 用五个底层模块共同支撑起这套体系:通过**双层架构(第二部分)兼顾连续交互与高效并发,通过事件驱动(第三部分)实现主动响应,通过面向人的交互设计(第四部分)在对话体验上同时做到连续与高效,再通过存算环境分离与外部 Watchdog(第五部分)**实现跨设备的持久在线与异常自愈。
2. 这套架构算不算创新?它和其他 Personal Agent 有什么区别?
看到这里,很多关注 AI 行业动态的朋友自然会问:市面上已经有不少主打持续在线的 Personal Agent(个人助手)——比如开源社区里非常火的本地优先网关与助手 OpenClaw(小龙虾),以及海外厂商近期推出的个人助手(如 Meta 的 Muse、OpenAI 的 Dots、Manus 的 Cue 等)。DeepSeek 的这套 Super-agent 架构到底算不算创新?它和这些其他 Personal Agent 有什么区别?
DeepSeek 在原文结语里说得很坦诚:整套设计并没有提出全新的理论,而是把计算机系统里经典的工程思想(分层路由、快慢路径、缓存局部性、投机执行、存算分离等)用到了 Agent 系统里。
从底层技术方向来看,它和其他 Personal Agent 属于同一条演进路线,核心都是让 Agent 摆脱单次对话窗口、通过接入聊天软件或事件流 7×24 小时在线处理事务(比如 OpenClaw 本身也具备主会话 main、子 Agent 会话 sessions_spawn、Skill 扩展以及在 Discord 等部分渠道的子话题绑定能力;OpenAI 的 Dots 除了云端托管环境外,也支持连接并控制用户自己本地电脑上的话题)。
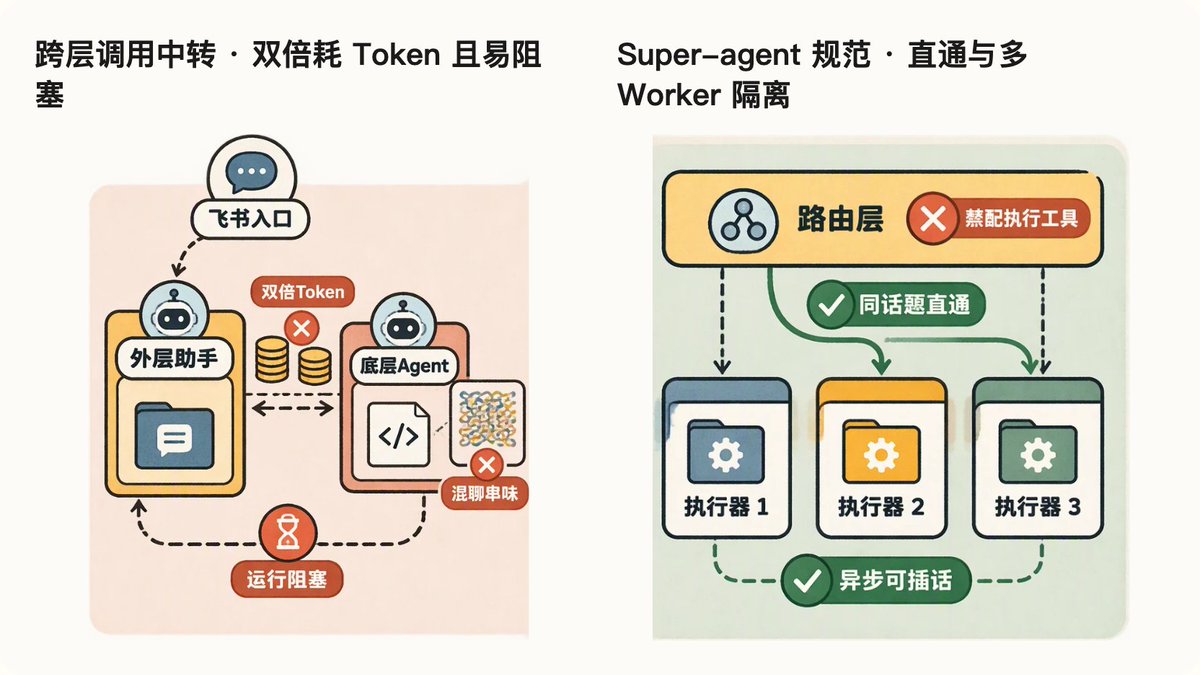
但在具体日常使用和工程落地上,当我们通过 OpenClaw 等网关在飞书里对话,再让它去调用电脑上的其他编程 Agent(如 Claude Code 或 Codex)干活时,或者在主 Agent 与执行子 Agent 之间没有直接打通当前话题时,往往会碰到三个具体问题:
-
跨层转述带来的双重 Token 消耗:每次我们在聊天框里跟 OpenClaw 说一句话,OpenClaw 自己的模型要先读一遍上下文理解意图,再去调用底层的编程 Agent;底层 Agent 执行完后,又要返回给外层汇总回复。只要追问和修改没有直接打通到底层执行会话(比如在飞书等不支持原生子会话直接绑定的入口,或者用一层 Agent 去驱动另一层 Agent 时),每一次来回沟通都在消耗双份 Token。
-
同步执行期间的插话与改向阻塞:当底层 Agent 正在跑一个耗时较长的任务循环时,当前对话往往处于等待状态;如果中途想临时补充一句要求、或者发现方向偏了想立刻改向,很难做到零延迟的顺畅打断。
-
单入口混聊时的上下文互相干扰:如果我们在同一个主对话入口里一会儿聊代码修改、一会儿聊视频脚本和文章草稿,没有在架构上强制把“只做分发的路由层”和“只做单一任务的执行层”拆开,多个话题的上下文很快就会互相污染。
而 DeepSeek 这篇架构探索的价值,正是把解决这三个痛点的机制做成了一套完整的系统规范:用强制卸掉执行工具的 Router + 多 Worker 隔离解决多任务上下文污染,用飞书/GitHub 同话题订阅直通(Thread Subscription)省掉主路由中转的双重 Token 消耗,并用异步全双工循环(start / stop 拆开)+ 投机执行解决任务运行中随时插话改向的问题。
这里补充一个我个人的观点:很多时候虽然大家都在用类似的技术,但架构的统一命名和标准规范,往往还是需要有头部大厂站出来梳理和定义的。 最典型的例子就是 Anthropic(Claude)推出的 Skill——从技术本质上看,Skill 其实就是一套文件夹的组织规范(把提示词 SKILL.md、参考文档和脚本按约定放在一个目录里,按需渐进式加载),在它出来之前很多开发者私下也是这么干的;但只有当头部模型厂商把它正式命名为 Skill 并定下统一规范后,整个行业的工具链才有了共同的语言和复用标准。DeepSeek 这次对 Super-agent 的系统化拆解也是同样的道理:当一家头部模型大厂把 Router / Worker、Fast / Slow Path、Inline & Spill、Thread 订阅 和 投机执行 这些散落在各家工程实践里的做法统一命名、明确边界并拿出消融实验数据时,它实际上是在为下一阶段的自主 Agent 系统建立一套通用的工程参考规范。
下面我们就顺着这套架构规范,先看最核心的第一层设计:为什么必须把 Router 和 Worker 拆成两层?
二、Router 与 Worker 双层架构
1. Router 层与 Worker 层分工:解决「全局连贯」与「多任务并发」的矛盾
回到原文第 2 节。为了同时做到跨渠道对话连续(用户不用管底层有几个窗口)和多任务高效并发(同时推进写代码、做调研、写文章互不干扰),系统在底层必须面对一个核心权衡:
-
如果把所有消息都交给同一个 Session 处理:上下文最连贯,但单个“思考 → 调用工具 → 看结果”的执行循环(即 ReAct Loop)只能串行干活,一个任务跑慢了后面全得排队,而且多个任务的中间过程信息混在一起,很容易互相干扰。
-
如果每来一条消息就直接新开一个独立 Session:并发速度最快,但各个窗口之间缺少全局记忆,做出来的东西彼此割裂,还会同时向用户发消息造成混乱。
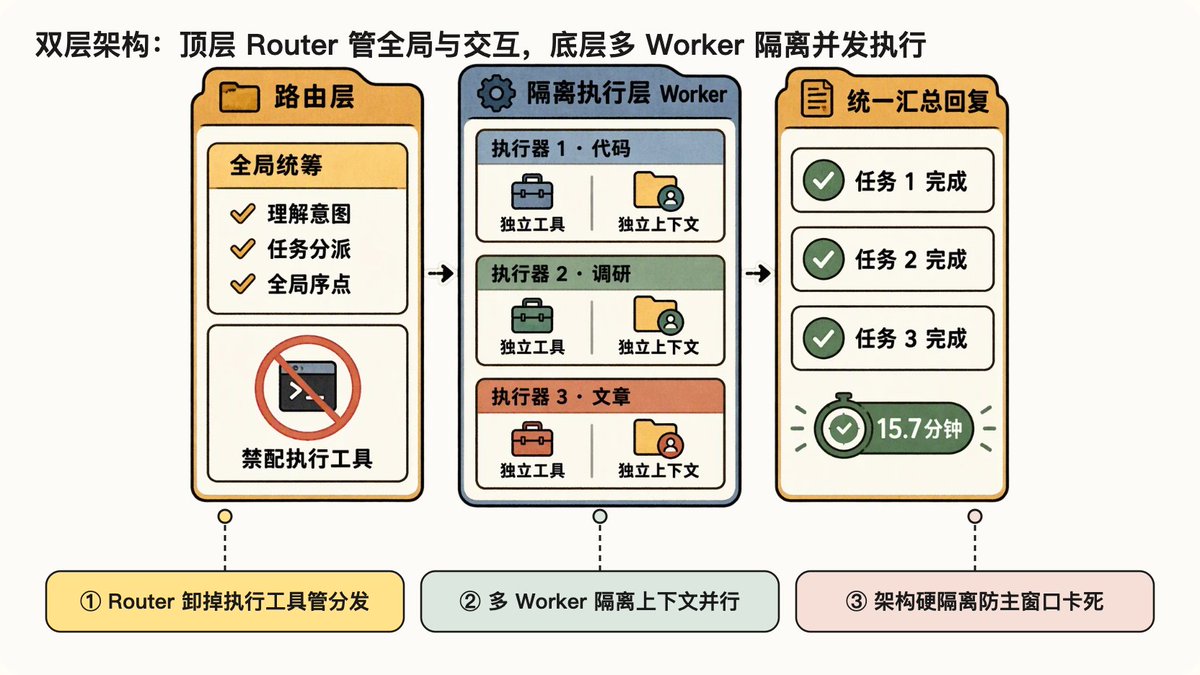
为了兼顾这两头,DeepSeek 采用了 「Router 层 + Worker 层」的双层架构——在底层接管了多会话管理与并发执行,让用户始终感觉只面对同一个 Super-agent。正如原文所说,让用户手动去管理一个个 Session,很大程度上只是从底层大模型接口延续下来的设计惯性;Session 应当是系统底层的实现细节,而不应成为用户的认知负担。
◆ 第一层:常驻的 Router 层(负责全局记忆与对外交互)
全系统由一个常驻的 Router 层 统一承接所有入口(如飞书、GitHub)的人类交互。所有跨渠道、跨任务的信息与决策都在 Router 层中汇总,并按到达顺序排定先后关系——这就是原文所说的充当全局序点(Sequence Point),保证你在飞书和 GitHub 两边先后改主意时,系统能理清哪句话在前、哪句话在后,不会出现状态冲突。
同时,这里有一个极其关键的工程设计:为了防止 Router 层自己变成卡死系统的瓶颈,Router 层在设计上严禁直接执行具体任务,甚至可以直接不给它配置执行命令行的 Bash 工具。 它只负责听懂用户意图、管理全局进度,然后把具体工作分派下去;因为职责纯粹,Router 层甚至可以使用更轻量、响应更快的模型。
原文还专门区分了它和常见 Agent Team(多智能体团队) 的不同:常见的 Agent Team 主要用于把单个复杂任务拆成几个紧密耦合的子步骤协作完成,Team Lead 必须深入理解任务细节并高频协调各个成员,自身推理负担很重;而 Super-agent 的 Router 层 只管不同任务之间的高层关联与分派,完全不介入单个任务内部的拆解。
◆ 第二层:上下文隔离的 Worker 层(负责并发干重活)
Worker 层 由多个相互隔离的执行会话组成,每个 Worker 挂载完整的开发与读写工具,配置能力最强的模型,在各自独立的上下文里专注完成单一任务(比如 Worker 1 专门改网站代码,Worker 2 专门做技术调研,Worker 3 专门改文章)。
Worker 绝不直接跟人类对话,它内部翻看了多少文件、跑了多少次测试日志,全部留在自己的会话里,执行完后只把精简结论汇报给 Router 层,由 Router 层统一回复用户。这其实和我们在 《怎样用好子 Agent》 里讲的主从分工理念高度一致。而且每个 Worker 在执行复杂单任务时,自己内部还可以继续创建子 Agent 或组成一个小 Agent Team,这些对顶层的 Router 完全透明。这套结构既适用于团队代码协作,也适用于个人助手(前端只有一个统一聊天页维持连贯,底层则为每个话题分别派发 Worker 并行推进)。
◆ 为什么不能只靠写提示词,让单个窗口自己决定派不派子 Agent?
很多人会问:现在的 Agent 本身就有调用子 Agent(Subagent)的工具,我直接在一个主窗口里写一段提示词,叮嘱它“遇到具体任务请交给子 Agent 做”,不就等于双层架构了吗?
DeepSeek 在原文第 7.1 节专门做了一组对比实验(用包含约 300 条闲聊、跟进、叫停和 20 个工作请求的消息流连跑 5 次),实验结果直接解释了为什么“只靠写提示词”在实际业务里行不通:
-
只给普通提示词时:在 5 次运行中,单窗口主 Agent 1 次都没有调用子 Agent,所有活全揽在主窗口里自己干,结果不断被群里的新消息打断,任务完成耗时(p95)高达 29.5 分钟。
-
把提示词写死“优先委派给子 Agent,自己只做小事”时:5 次里有 4 次它确实派给了子 Agent,但剩下 1 次它依然自己判断“这个任务很小”,选择亲自下场执行,导致主窗口当场被卡住,拉出了一条很长的慢响应尾巴。
-
采用 Super-agent 双层架构时:因为从系统层面直接拔掉了 Router 层的执行工具,Router 100% 只能把活派给 Worker,任务完成耗时(p95)稳定缩短到了 15.7 分钟。
从产品和工程落地的角度看,这个实验结论非常有价值:在高频消息场景下,不要指望靠写提示词让大模型自觉守规矩去分工;只有从架构上做物理隔离(不给路由层配执行工具),才能彻底杜绝主窗口被卡死的问题。
这里也可以补充一个我自己在实测过程中的经验:不同的模型对于子 Agent 的调度以及任务的规划能力差别很大。比如 Claude 这个模型对子 Agent 的调度就做得很好,而 GPT 就做得没有那么好。
2. Router 层的自动批处理(Batching):消息密集涌入时为什么不会卡顿?
既然所有新消息和跨任务协调都要经过那个常驻的 Router 会话,那如果群里讨论很激烈、一分钟涌进来几十条消息,单个 Router 会话会不会排队堵死?
DeepSeek 在实际压测(原文 2.1 节与 7.2 节)中发现,单个常驻 Router 会话比预想中能扛得多,核心原因有两个:消息自动打包(Batching 批处理),以及大模型在 读取输入阶段(Prefill 预填充) 的并行特性。我们把这两个概念拆开来看:
◆ 第一步:什么是 Router 层的“自动批处理(Batching)”?
平时我们自己跟大模型聊天,是“发 1 条消息 → 等它回完 → 再发第 2 条消息”。如果群里同时来了 3 件事,按传统做法就得连续调用 3 次大模型,排 3 次队。
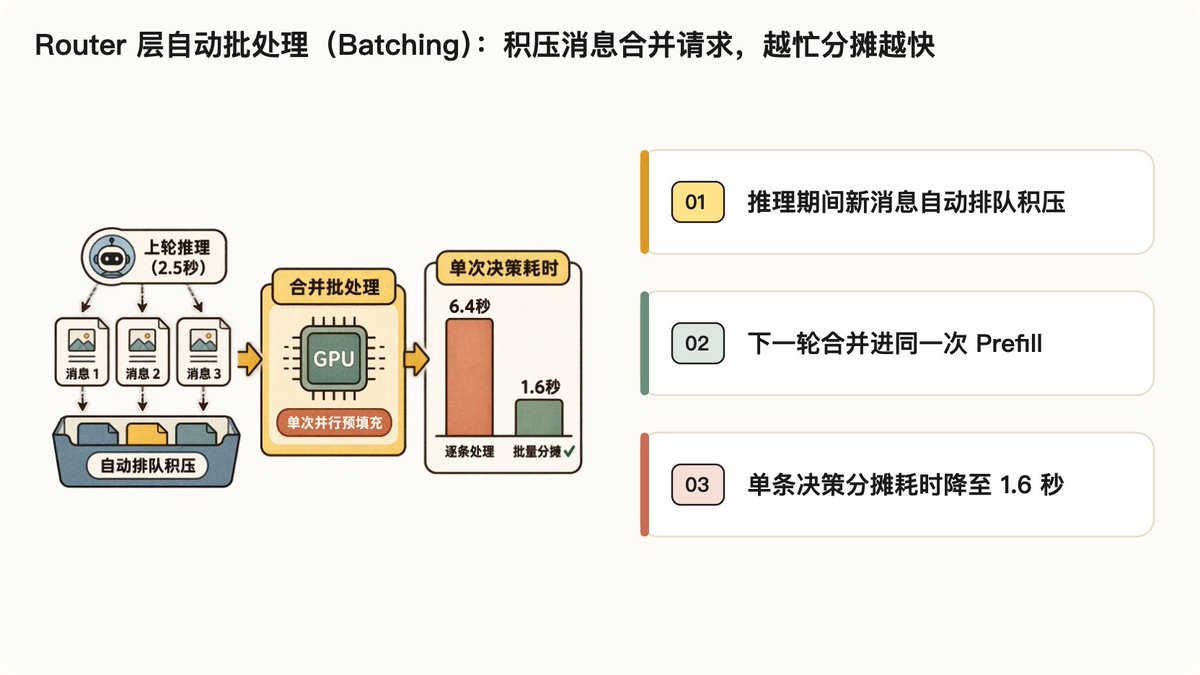
而这里的自动批处理(Batching),其实就像攒单发货:
-
当群里消息不多时,来一条消息,Router 就立刻调一次大模型处理;
-
当群里消息密集涌入,比如 Router 正在花 2.5 秒 思考上一条消息时,这 2.5 秒内群里又陆续进来了 3 条新消息(比如同事 A 问日志报错、同事 B 要周报草稿、GitHub 发来测试通过通知)。
-
系统不会分 3 次排队去调用 3 次大模型,而是把这 2.5 秒内攒下的 3 条新消息打包拼进下一次大模型请求的同一个输入里(相当于一次发给模型:“刚才这 2 秒里新收到了这 3 件事,请一并判断并分派”),让 Router 一次性看完、一次性把 3 个活分派出去。
◆ 第二步:为什么 3 条消息打包一起算,耗时不会变成 3 倍?(Prefill 预填充的作用)
你可能会问:把 3 条消息拼在一起发给大模型,字数变多了 3 倍,大模型处理的时间难道不会也变长 3 倍吗?
不会,这就涉及大模型干活时的两个不同阶段(我们在 《大模型底层原理:注意力机制与 KV Cache》 中做过完整拆解):
-
第一阶段是“读入你发的内容”,叫预填充(Prefill):当你把一段文字发给大模型时,显卡并不是一个字一个字去读的,而是把整段输入同时并行计算的。因此在算力充足的情况下,一次性读入 1 条消息和一次性读入打包后的 3 条消息,花费的“阅读时间”几乎差不多。
-
第二阶段是“一个字一个字往外吐回答”,叫解码生成(Decode):这一步没法并行,必须写完前一个字才能算后一个字。平时我们觉得大模型慢,主要就慢在它长篇大论写代码、写文章的“吐字阶段”。
想明白这两步的区别,就能看懂为什么 Router 层天生适合打包批处理:
Router 层的工作特点是 “多读输入、少写输出”——它不需要写长篇代码或长文,只需要读完积压的几条群消息,然后输出一两句极简短的分派指令(比如调用工具把任务 1 派给 Worker A、任务 2 派给 Worker B)。把 3 条消息合并成 1 次请求后,“读输入(Prefill)”因为显卡并行计算,耗时几乎不增加;而“吐回答(Decode)”本来就只有短短几行指令,同时还省掉了分 3 次调用时的多轮来回请求开销。
原文第 7.2 节的压测数据正好印证了这一点:
-
当每分钟进来的事件从 1 条 暴增到 40 条 时,每次请求平均打包处理的事件数从 1.0 条升到了 2.8 条,但单次大模型请求耗时仅仅从 2.5 秒 微增到 3.9 秒(远不是乘以 3 倍)。
-
更关键的是,Router 单独处理 1 件事往往要连续调 2 到 3 轮模型与工具,累计要花 6.4 秒;而当多条积压消息打包进同一次循环一并判断分派后,平摊到每件事上的模型决策耗时反而从 6.4 秒降到了 1.6 秒。也就是说,外部消息越密集,打包分摊的效率反而越高,在日常团队规模下完全不需要过早把 Router 切碎成多个窗口。
三、事件驱动与上下文治理
要让 Agent 从“你说一句、它动一下”变成主动推进事务,系统的输入源就不再只是用户在输入框里敲的指令,而是工作环境里持续产生的各类事件(原文称为 Trigger)——比如飞书群消息、邮件与日程提醒、GitHub 代码评论、CI 自动测试报错等。
围绕一条外部事件从进入到处理完的全过程,原文第 3 节设计了四个环环相扣的机制。
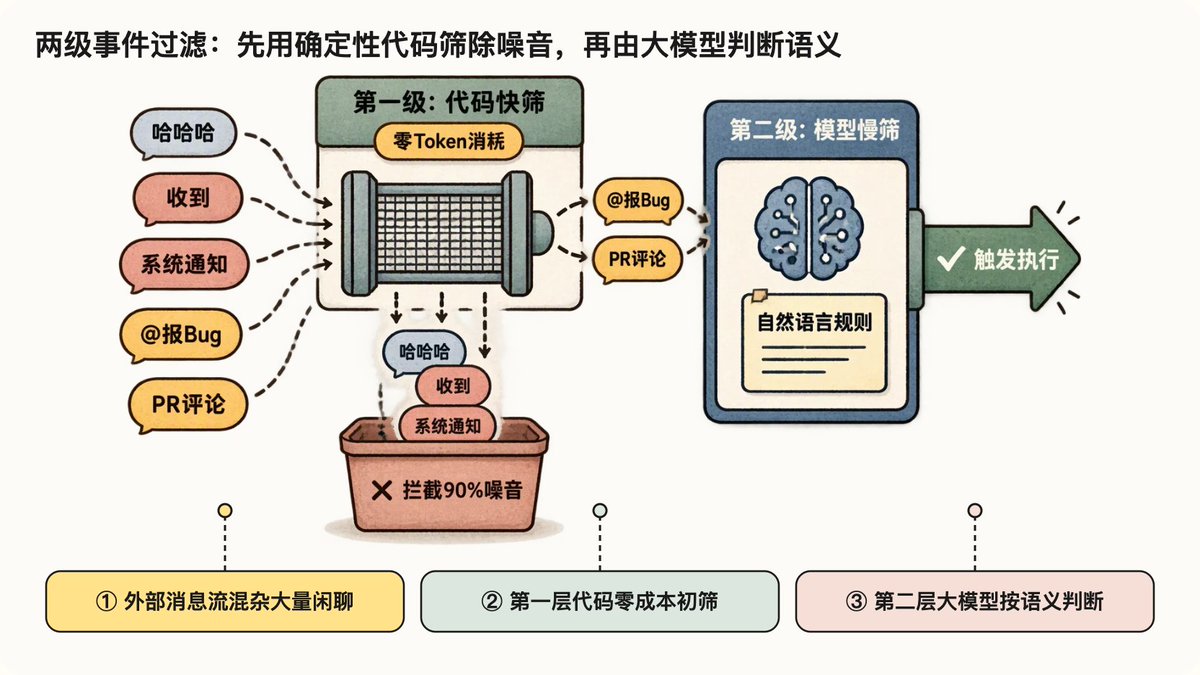
1. 两级事件过滤(Fast Path / Slow Path):先用普通代码挡住日常噪音
一旦把 Agent 接入真实的飞书工作群或代码平台,第一个迎面撞上的业务痛点就是群聊噪音太大与算力成本过高:每天流进来的消息 90% 以上都是日常闲聊、“收到”、“哈哈”或者跟 Agent 无关的系统通知。如果每来一条消息都调用一次大模型去判断“这件事需不需要我介入”,算力账单和响应延迟根本承受不起。
为此,DeepSeek 借鉴了计算机系统里的 快路径(Fast Path)与慢路径(Slow Path) 思想,把过滤拆成了两步:
第一级:程序层策略(Fast Path,代码快路径)
在调用大模型之前,先用写死的普通代码做毫秒级的准入检查——比如检查消息来自哪个群、发送人是否在白名单内、是否满足特定触发条件,直接把每个渠道标记为“仅响应明确请求”“作为候选事件”或“直接忽略”。这一步不消耗任何 Token,直接挡掉绝大部分无关噪音。
第二级:语义层策略(Slow Path,模型慢路径)
只有通过了代码初筛的少数“候选事件”,才会真正发送给大模型,由大模型结合上下文和提示词策略判断要不要行动。同时,这一层也是留给用户的自然语言配置入口——平时你想临时增加一条新规矩(比如“这周只要群里有人提登录页样式问题,就自动记录下来”),直接改一句提示词就能生效,不需要重新改代码发版。
2. 同话题订阅与直通路由(Thread Subscription):省掉每次中转的双重 Token 消耗
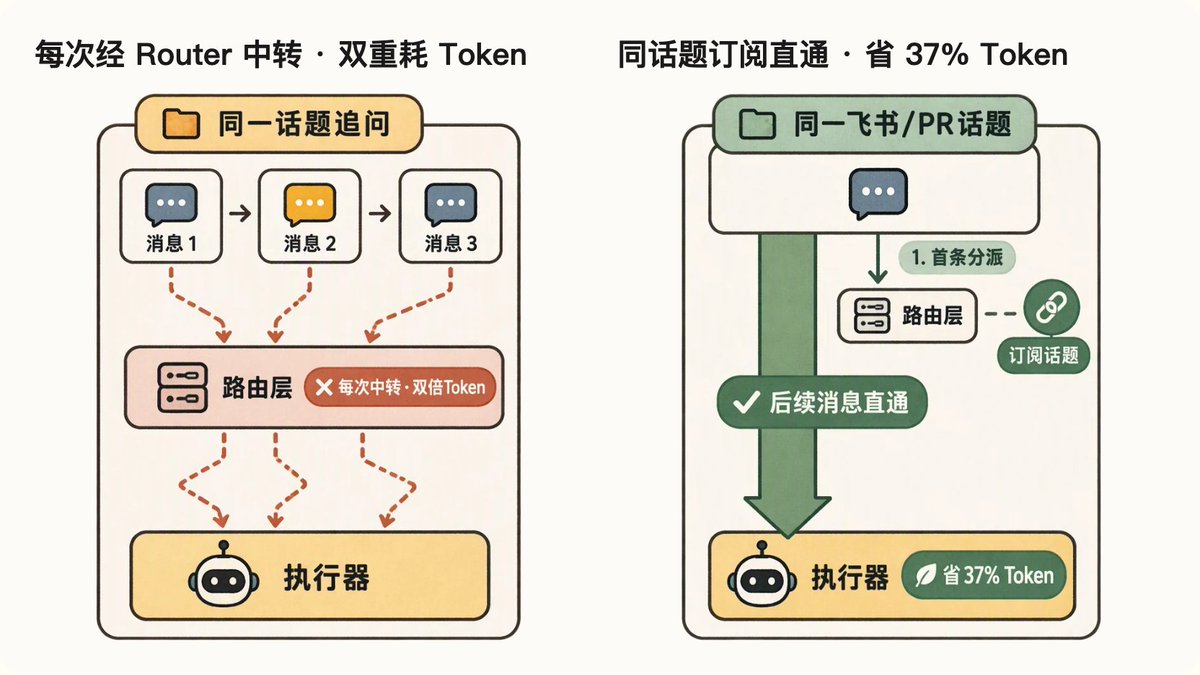
消息过滤进来之后,第二个痛点是同一任务反复追问时的中转开销:如果围绕同一个页面或功能跟 Agent 来回沟通十几次修改细节,每一次对话都要先经过顶层路由理解一遍、再转发给底层的执行会话——不仅每句话都要多等一轮模型推理,而且两边重复消耗了双倍的 Token。
在实际工作流里,飞书里的同一个话题、同一个 GitHub Pull Request 下的评论区、或者同一封往来邮件,里面的连续消息天然构成一条事件流(原文称为 Thread)。
DeepSeek 同样用快慢路径拆解了消息路由:
-
首次新话题(Slow Path 经过 Router):当你在飞书的某个新话题或某个新 PR 下发出第一条需求时,消息先进入 Router 层;Router 判断后创建一个专门的 Worker 会话 来接手,同时让这个 Worker 直接订阅(Subscribe)当前这个话题。
-
同一话题的后续消息(Fast Path 直通 Worker):一旦建立了订阅关系,接下来你在这个飞书话题或 PR 底下发的所有后续追问和修改意见,底层程序识别出话题 ID 后,直接绕过 Router 层,把消息原封不动直通发给对应的 Worker。如果中途你在该话题里聊了超出当前任务范围的新需求,Worker 可以主动取消订阅或交回给 Router 重新分派。
原文第 7.1 节的消融实验测算过这一招的实际收益:因为 Router 维护着全局历史,上下文非常庞大,开启同话题直通机制后,单次实验里 Router 需要做出的判断减少了约 30%,重复读取历史上下文缓存(KV Cache)的 Token 消耗直接省掉了约 37%(从 3177 万降到 2323 万)。
此外,话题与 Worker 之间还支持多对多订阅:比如来自两个不同群聊任务的 Worker 1 和 Worker 2 恰好都在修改同一个 PR 下的代码时,它们都会订阅这个 PR,任何一方提交操作后另一方都能同时收到事件通知,从而自己发现并解决代码冲突,不需要人工在中间同步信息。
3. 上下文 Inline & Spill 与链式召回:怎么在长期运行中按需找回历史信息?
当 Agent 持续在线跑了几天甚至几周后,第三个痛点就出现了:历史信息越攒越多,全塞进上下文会稀释注意力,塞太少又会导致跨天提起旧任务时找不到先前的背景信息。
如果把所有历史事件详情和长文档都塞进当前窗口,不仅浪费 Token,还会降低模型对当前核心指令的关注度;可如果一开始只给一句话,模型每处理一条消息都得连续调用好几次工具去查前因后果,等待时间又会变长。
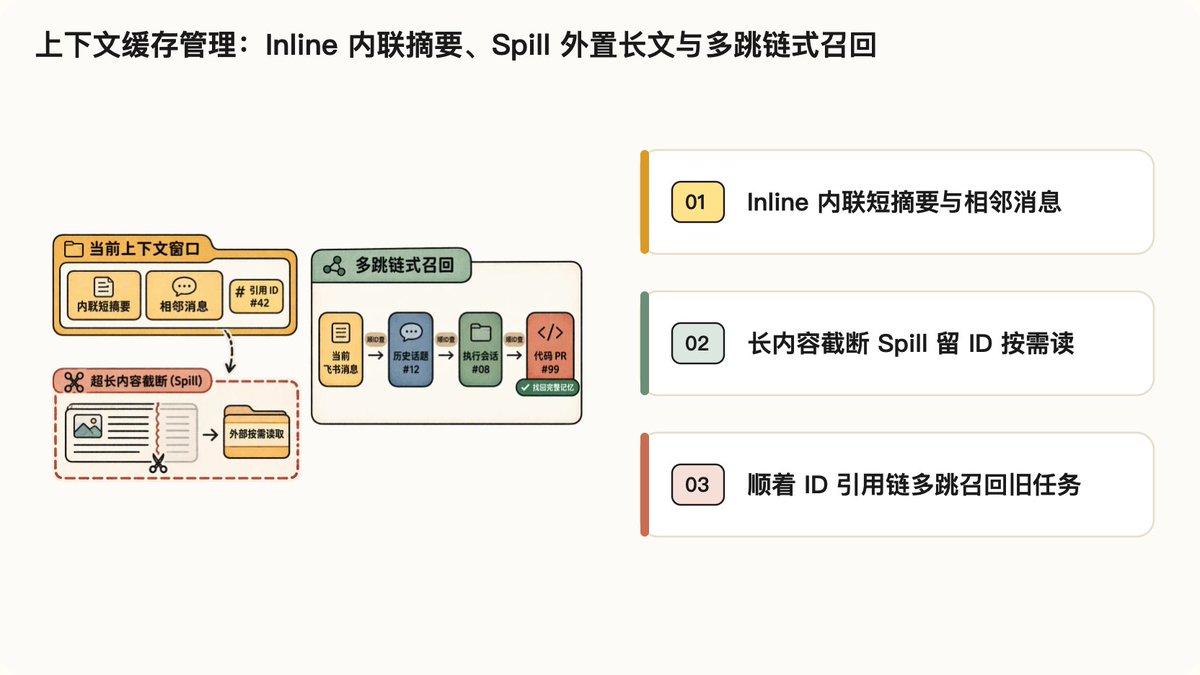
为了解决这个矛盾,DeepSeek 把有限的上下文窗口当作缓存(Cache)来管理,设计了两个基础动作和一套按需检索机制:
1. Inline(把高频相邻信息直接拼进当前输入,省得模型再去查)
比如有人在飞书里回复了一条消息说“就按上面说的改”。如果只把这 7 个字发给大模型,模型根本不知道“上面”指什么,还得专门调用一次工具去查原消息。
因此系统在把这条消息送进模型之前,利用局部性原理(Locality),顺手把被回复的那条原消息、飞书里紧挨着的前后几条相邻消息,以及关联话题/任务的编号(ID)和前 50 字摘要,直接拼进当前上下文里(这就是 Inline 内联)。这样模型一眼就能看清前因后果,省去了反复调用工具查询的等待时间。
2. Spill(把超长内容截断留在窗口外,只留编号按需读取)
反过来,如果有人在群里发了一篇两万字的长文档,或者贴了一段几千行的报错日志,全塞进对话框会直接占满上下文窗口。系统会对超长内容设定严格的长度上限:超出部分直接截断留在上下文窗口之外,只在窗口里保留前几百字预览和一个引用编号(ID)(这就是 Spill 溢出外置),等模型真需要看完整内容时,再拿着编号调工具去读。
3. 链式召回(Chain of Recall,顺着编号引用链跨天找回旧任务)
系统给每一条消息(Trigger)、每一个话题(Thread)和每一个执行会话(Worker Session)都分配了唯一编号(ID),并在每次 Inline 时自动带上关联对象的编号,底层就形成了一张相互连接的引用网。
更重要的是,每一次调用工具召回的对象本身也遵循 Inline & Spill,它的返回结果里又会自带下一跳关联对象的摘要和编号。 这样一来,Router 平时不需要在上下文窗口里保存所有历史长文,只需要保留近期事件与话题的简短摘要和编号。当你几天后在飞书里突然提起上周的某个旧任务时,Router 只需要顺着编号链条一步步按需调工具展开:当前飞书消息 → 关联的历史飞书话题 #12 → 当时负责执行的 Worker #08 → 该 Worker 绑定的 GitHub PR #99,沿着引用关系检索两三步,就能把当时的完整上下文重新找回来。
4. 投机执行(Speculative Execution):后台先静默试修,确认修好才发出来
做“主动式 Agent”最容易翻车的地方,就是把握不好主动帮忙与群聊刷屏之间的边界:如果群里一有人讨论问题,Agent 就立刻在群里回复一大段“我正在帮您分析……抱歉这个问题我暂时没法复现”,很快就会造成群聊刷屏;但如果不让它提前介入,每次等大家讨论完再去手动给它下指令,又要多花十几分钟等待执行。
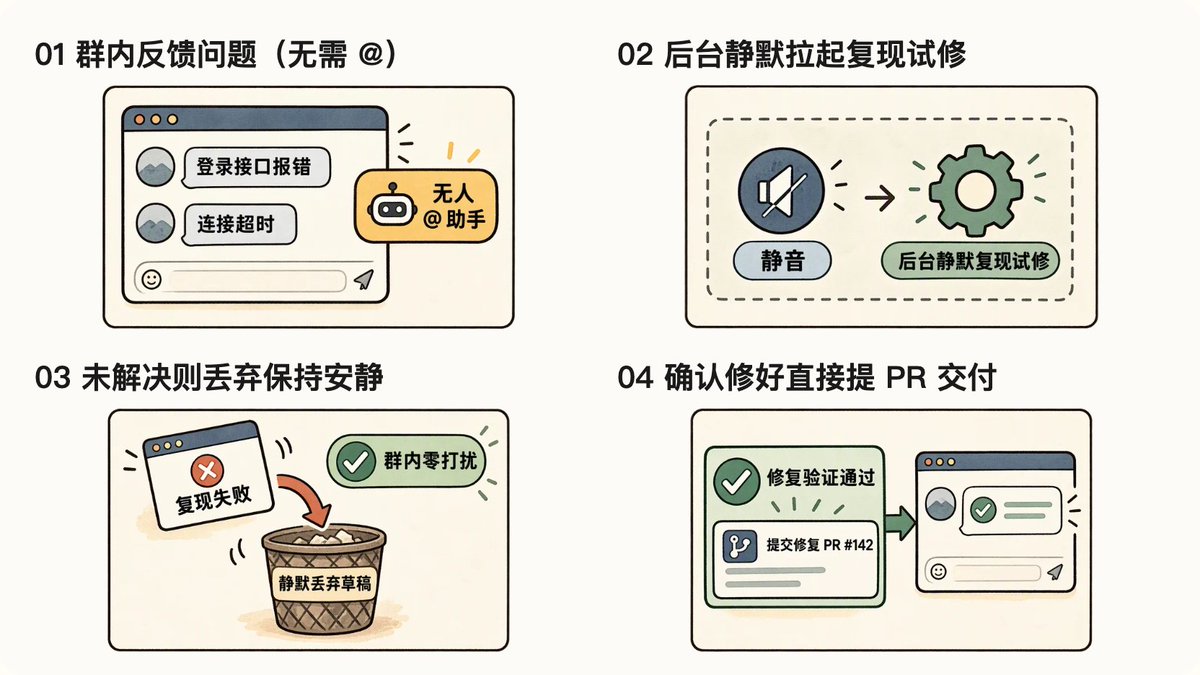
DeepSeek 借用了 CPU 设计里的 投机执行(Speculative Execution) 思想,给出了一套非常克制的产品方案:在还不确定结果最终会不会被人类采用时,根据环境信号先花一点后台算力提前把活干了试试;结果有价值就端出来交付,没价值就直接丢弃、一声不吭。
比如在 DeepSeek 内部用户群里,他们配了一条“静默复现并修复”策略:
-
群里有人反馈某个功能报错,或者正在讨论修改方案(全程没有人 @ Agent);
-
Super-agent 看到消息后,不在群里发任何回复,而是先在后台悄悄拉起一个 Worker,尝试复现这个问题并寻找修复方案;
-
如果后台复现失败,或者发现改起来太复杂没把握,它就直接把后台草稿扔掉,全程保持安静,零打扰;
-
只有当它在后台成功复现了问题,并且写好了简单可靠的修复代码后,才会把已经提交好的 GitHub 修复 PR 链接发到群里,让大家直接过目合并。
放在个人助手场景里也是一样:收到一封会议邀约邮件时,先在后台默默核对日程冲突、查好背景资料并写好回复草稿,人点开时只需要点一下确认发送即可。这种「后台消耗算力试错、前台只交付确定性成果」的设计,非常值得所有做 AI 产品的人借鉴。
四、全双工交互与多渠道规范
双层架构解决了后台并发,但落到用户每天直接接触的对话体验上,原文第 4 节还解决了两个非常具体的交互痛点。
1. 异步 ReAct Loop(全双工交互):后台跑耗时任务时,前台随时插话调整方向
看到“随时插话”这一点,平时经常用 Codex、Claude Code 或 Antigravity 的朋友可能会有个疑问:“我现在用的 Agent 在干活的时候,输入框明明也是可以发消息排队或者点 Steer 插话的呀,DeepSeek 这个全双工和它们有什么区别?”
如果把现在 Agent 在运行期间处理新消息的方式拆开看,其实有三个不同的层级:
第一层:Queue(排队模式——等“整轮任务”全部跑完才处理)
在 Codex 等工具里如果选了 Queue(排队),当 Agent 正在连续执行一个包含十几步工具调用的大任务时,你发出去的消息会被一直扣在队列里,必须等它把这一整轮的十几步全部干完、彻底停下来之后,才会把你的话作为下一轮新对话发进去。
第二层:Steer(步间插话——在“两步工具之间的空隙”塞进去,但遇到长耗时单步工具依然要等待)
Codex 默认的 Steer(插话转向) 以及 Claude Code 运行中直接回车,比 Queue 更进一步:它不需要等整轮十几步全做完,而是会在当前这一步工具刚刚执行完、下一步推理还没开始的空隙(Step Boundary),把你的话塞进当前回合里纠正方向。
但 Steer 有一个局限:它没法打断正在执行中的单步工具。 因为底层大模型接口规定“发起了工具调用就必须先拿到工具返回结果”,如果当前这一步正好是个需要跑 10 分钟的同步长命令(比如跑全站测试、编译打包或等待子任务),你的 Steer 消息就会一直停在 Pending Steer(等待插入) 状态,等这 10 分钟跑完才能生效——除非你直接点停止按钮(Stop / Esc)把正在跑的测试手动中断重来。
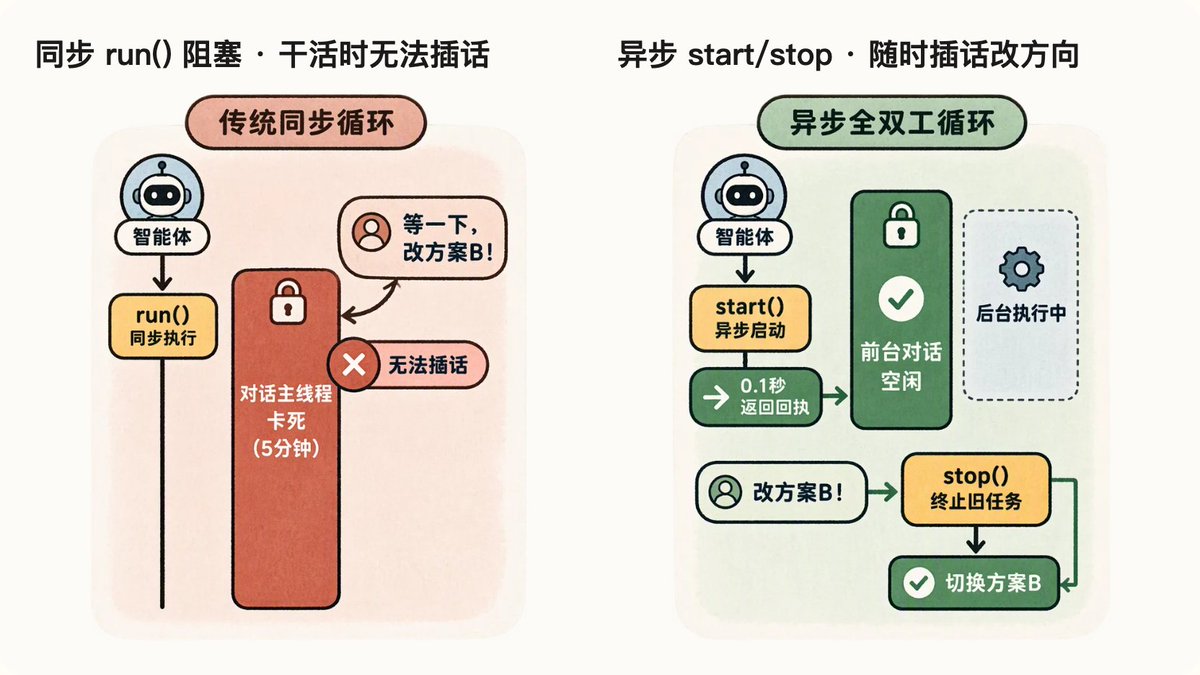
第三层:异步 start/stop 全双工(把 10 分钟长命令变成 0.1 秒启动,消除单步工具阻塞)
DeepSeek 这里讲的异步 ReAct Loop(以及 Claude Code 的后台命令 run_in_background、Antigravity 的后台异步任务),解决的正是 Steer 在长耗时工具上的等待问题——不让耗时命令占用当前这一步工具调用的时间:
-
模型通过 start() 把 10 分钟的测试放到后台运行,0.1 秒就拿到“已启动”回执并结束当前步,所以你的插话不会停在 Pending Steer 里等待,任何时候发消息都能立刻响应;
-
更灵活的是,模型读到你的插话后可以按语义决定怎么处理后台任务:如果你只是顺便问个问题或补充后续要求,前台立刻回复你,后台测试继续跑、完全不受影响;如果你明确说“方向错了,换方案 B”,模型再主动调用 stop() 把后台旧测试停掉。
◆ 底层技术上是怎么实现的?
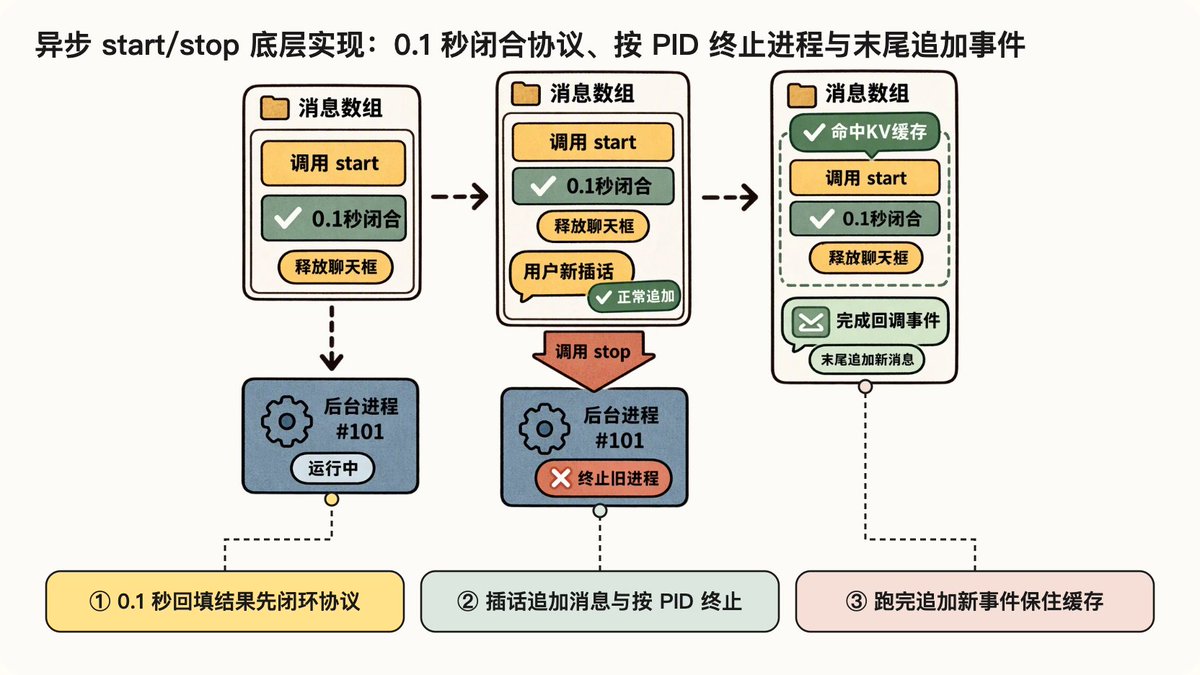
为了做到这种“后台照跑、前台即时响应”,DeepSeek 把原本同步等待的 run() 工具,拆成了异步的 start()(启动) 和 stop()(停止),底层只需要三步就能跑通:
第 1 步(0.1 秒先回填“任务号”闭环协议,当场释放聊天框)
当模型调用 start("跑全站测试") 时,框架把测试放到后台子进程去跑(在任务表里记下任务号 #101 和系统进程号 PID),但不等测试跑完,在 0.1 秒内就立刻给大模型返回一句工具结果 "Started: #101"。大模型拿到返回值后,当前这一轮对话就合法走完并结束了,前台聊天框当场恢复空闲。
第 2 步(后台运行期间随时插话,按需调用 stop 终止进程)
因为上一轮对话已经结束、消息数组(messages[])是干净完整的,你在后台运行期间发任何新消息都能立刻开启新一轮推理。不需要停后台任务时就正常聊;需要叫停时,模型调用 stop("#101"),框架直接按进程号 PID 终止后台旧测试。
第 3 步(跑完后作为新事件追加到末尾,不改历史、保住 KV Cache)
如果中途没打断,5 分钟后后台测试跑完时,系统不会倒回去修改 5 分钟前那条历史消息(否则既会打乱中间这 5 分钟的新对话,又会让前面攒下的 KV Cache 缓存失效),而是把最终测试结果包装成一条全新的系统通知消息("[后台事件] 任务 #101 已执行完毕,结果如下……")直接追加到对话最末尾,重新唤醒模型向你汇报。(原文也提到,这套异步任务机制目前已在 DeepSeek Harness 中实现,但尚未默认开启。)
2. 多渠道交互规范:在飞书群里限 100 词以内,在 GitHub PR 里写完整报告
另一个直接影响用户体验的细节是不同工作软件的信息密度差异。我们在自己的单人终端里用 Claude Code 或 Codex 时,看它刷几百行思考过程和命令日志觉得很踏实;但如果把这套输出原样搬进十几人的飞书工作群,刷屏的长篇大论立刻就会造成严重的信息过载,没人愿意看。
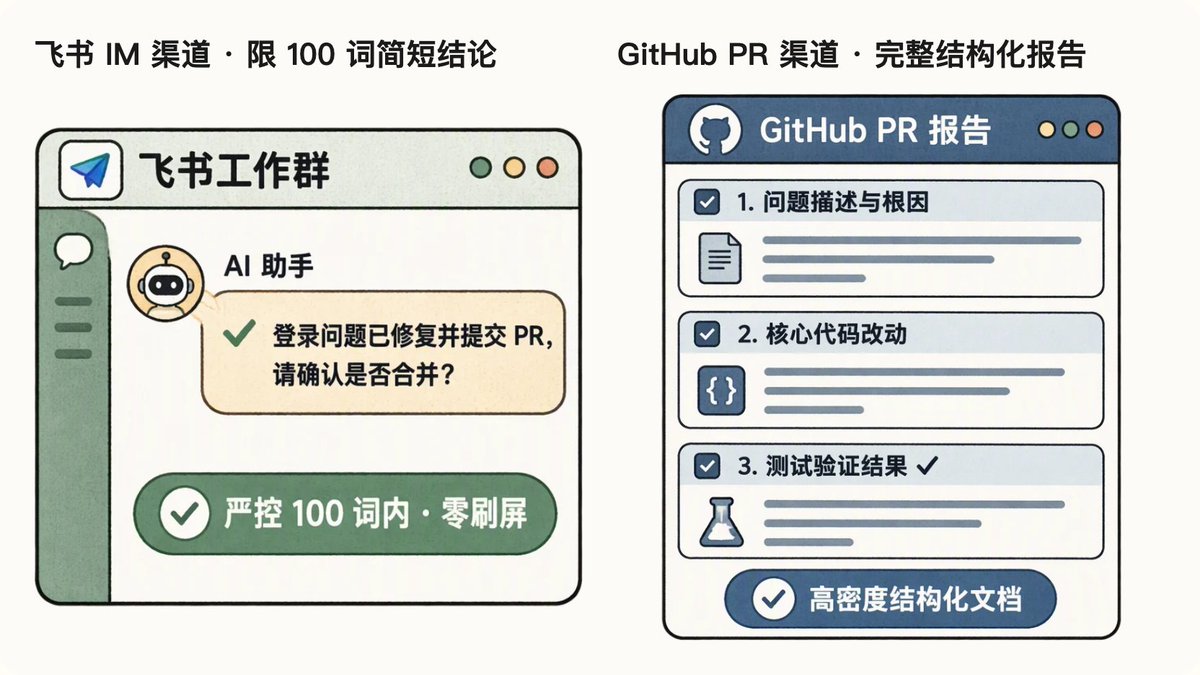
在 Super-agent 中,具体任务里冗长的推理过程和密集的工具调用全部被关在底层的 Worker 会话内部,绝不往外吐;负责对外说话的 Router 层 则通过提示词,针对不同渠道执行截然不同的输出标准:
-
飞书等即时通讯(IM)渠道:追求低打扰的轻量沟通,只在需要人类做决策或验收结果时才发通知,只问最直接的问题、给最简短的结论。DeepSeek 在内部验证过一条非常简单有效的硬性规定——IM 渠道单次回复严格不超过 100 个词(约一两百字)。
-
GitHub、邮件与文档等异步渠道:追求高信息密度的结构化交付。比如在创建或更新代码 PR 时,按项目规范老老实实写出完整的问题背景、代码改动说明与测试验证结果。
五、存算分离与巡检防跑偏
要让 Super-agent 真正做到 7×24 小时持久在线,并且能操作我们真实的开发环境、在长期运行中不跑偏,原文第 5、6、8 节给出了最后两块基础设施拼图,并指出了目前尚未彻底解决的四个开放问题。
1. 计算、状态与执行环境分离(BYOM):云端保持在线,本地保留真实环境
现在的本地 Agent(比如装在自己 Mac 上的桌面端或 CLI)有一个天然限制:它的思考循环(计算)、聊天记录(状态)和本地代码库(执行环境)全绑在你这一台电脑上。一旦你下班合上笔记本盖子、电脑休眠断网,Agent 就彻底停止工作了,也没法跨设备去操作你家里的另一台电脑。
反过来,如果完全搬到纯云端沙箱(云电脑)上跑,又会撞上另一个难题:你真实工作电脑里往往有还没提交的本地代码修改、公司内网环境、私有登录凭据以及特定的本地软件工具链,想把这些环境完整同步到云端沙箱不仅成本极高,还很容易漏东西。
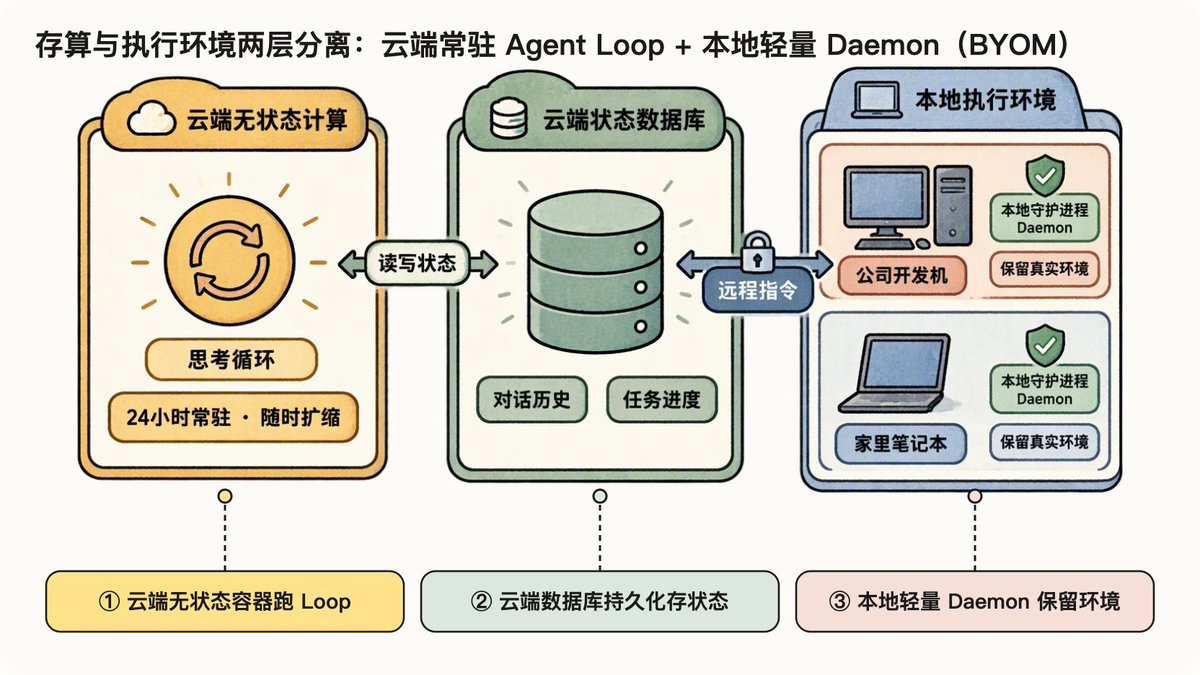
为此,DeepSeek 借鉴了数据库领域的存算分离(Compute-Storage Separation)思路,分两层做了彻底解耦:
第一层:计算与状态分离(实现云端 24 小时常驻)
把推进思考循环的 Agent Loop 放进云端无状态的弹性容器里(随时可以重启、扩缩容),而把需要长期保存的对话历史与任务状态存进云端数据库。这样 Agent 就彻底摆脱了单台本地电脑关机休眠的限制,始终在云端保持在线。
第二层:云端计算与本地执行环境分离(通过本地 daemon 实现 BYOM 自带电脑)
既然最难搬上云的是你本地电脑里的真实环境,那就干脆让执行环境留在原地,不要跟着 Agent 上云。具体做法是在你日常使用的个人电脑或开发机上,只安装一个极轻量的 daemon(守护进程)。
什么是 daemon?它在技术上是怎么和云端配合的?
-
概念上:daemon(中文常译作“守护进程”或“后台常驻服务”)指的是在电脑后台静默运行、没有复杂界面窗口的小程序(就像电脑开机自启的网盘同步客户端、Docker 后台服务一样,常驻在系统后台)。
-
职责边界上(不做推理、无状态,只负责本地执行):这个本地 daemon 自己不做任何大模型推理,也不保存任何聊天记录或任务状态;它里面只封装了最基础的本地操作能力——比如读写本地文件(read/write)、在本地终端执行命令(bash 以及前面讲的异步 start/stop)。
-
网络连接上(为什么家里或公司内网的电脑不用配公网 IP 就能被云端调用?):我们平时的个人笔记本连在家里 Wi-Fi 或公司内网里,是没有公网 IP 的,云端服务器没法主动往你的电脑发请求。因此 daemon 的工作方式是“本地主动向云端发起长连接”——只要你的电脑一开机连上网,本地 daemon 就会主动向云端 Super-agent 服务器建立一条加密的持久通道(如 WebSocket 或 gRPC 长连接),并定时发送心跳包汇报设备在线状态。当云端的 Worker 需要读取你电脑里的代码或跑测试时,直接顺着这条已经连好的通道把指令下发给本地 daemon;daemon 在你本地真实环境里跑完命令,再顺着通道把结果传回云端。
这种模式直接实现了 BYOM(Bring Your Own Machine,自带设备接入):同一个云端 Super-agent 可以根据任务需要,随时在你公司的开发机、家里的个人电脑以及云端测试服务器之间自由切换执行命令;哪怕你的个人笔记本中途合盖断网了,云端的 Agent Loop 和任务状态依然保留在云上,等下次你一开盖重新连上网、本地 daemon 自动重连成功,云端 Agent 就能立刻接着把需要在你这台电脑上跑的任务继续做完。
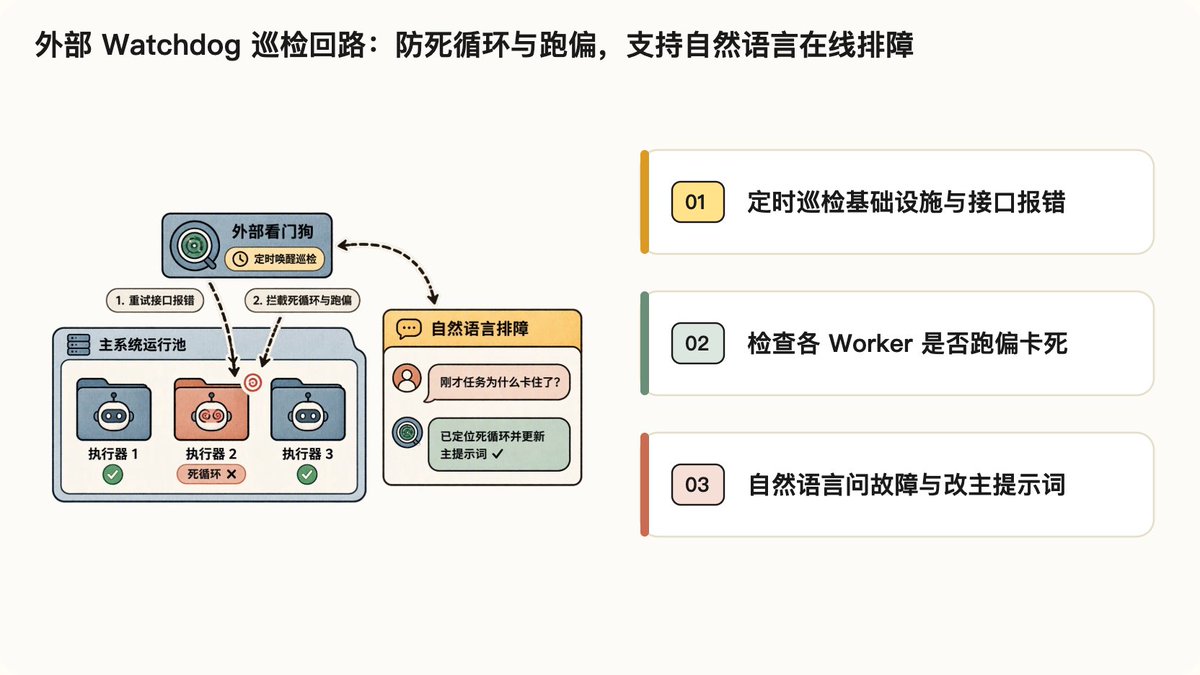
2. 外部 Watchdog 巡检回路:防止任务陷入死循环或偏离主线目标
一个 24 小时跑在后台的 Agent 系统,最怕的往往不是程序直接崩溃报错(程序崩了重启就行),而是进程还活着,但某个 Worker 模型在执行中陷入无效的重复循环,或者越改越偏离最初交代的主线目标。传统的运维监控脚本只能检测“服务器进程死没死”,没法判断“AI 的任务进展是否正常”。
为了解决这个问题,DeepSeek 在主系统外面单独配置了一个由定时消息唤醒的独立 Watchdog Session(外部看门狗控制回路 Control Loop)。
这个 Watchdog 本身也是一个挂载了完整工具的 Agent 会话,它定时在外部做两件事:
-
一是处理接口报错、状态恢复失败等基础设施故障,遇到外部偶发故障时持续复查直到恢复;
-
二是直接用大模型去检查各个正在干活的 Worker 有没有取得实质进展、执行方向有没有偏离整体主线目标,发现死循环或跑偏时及时介入修正。
更实用的一点是:因为 Watchdog 自己就是一个懂自然语言的 Agent,当系统行为不如预期时,维护人员不需要去翻晦涩的后台日志,直接用自然语言发消息问 Watchdog“刚才那个任务为什么卡住了?”,甚至可以直接让 Watchdog 在线帮你修改主系统的提示词和触发规则。
3. 留给所有 AI 产品经理与开发者的四个开放问题
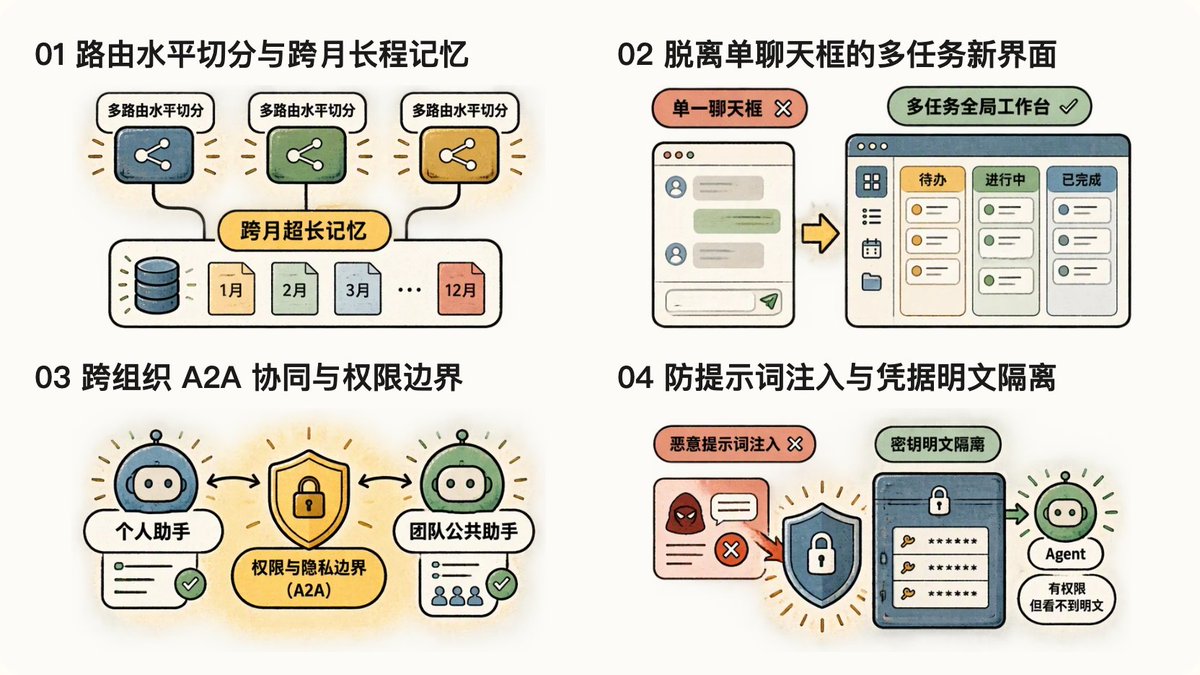
在这套架构能够稳定跑通日常研发协作之后,DeepSeek 在原文第 8 节非常客观地列出了往更大规模走时还没完全解决的四个开放问题——这恰恰也是未来一两年 AI Agent 产品演进最值得关注的方向:
◆ 第一,规模继续扩大后的架构切分与跨月长程记忆
目前“单个常驻 Router + 同话题订阅直通”足以应付中小团队的日常并发;但如果任务规模再翻十倍、耦合度更高,Router 层什么时候该水平切分成多个、Worker 之间什么时候需要直接通信,以及运行周期跨月甚至跨年后的超长程记忆怎么管理,依然需要继续探索(包括针对 Router 的批量分派与召回做专门的模型微调)。
◆ 第二,脱离聊天窗口(Session)之后,人机协作的新界面应该长什么样?
双层架构帮用户在底层隐藏了多会话管理,但正如原文所说:以聊天窗口为中心的交互,很大程度上只是历史路径依赖的结果。
当界面上的一个对话框不再死板对应底层的一个执行会话后,未来的交互完全可以更多发生在具体业务领域的特化界面里(比如像 DeepSeek 内部实例那样,让 Super-agent 直接在 GitHub 的 Issue 和 Pull Request 中工作,或者做成面向不同工作流的任务看板与定制工作台)。同时,在模型能力演进的过渡期里,很多复杂任务依然需要人类在中途参与——如何在产品设计中兼顾“后台自主推进的效率”与“人类在后台执行过程中随时介入、接管或实时协同”,同样是非常值得探索的产品方向。
◆ 第三,组织内的上下文边界划分与跨 Agent 协作(A2A)
当团队里每个人都有一个自己的个人 Agent,同时团队又共用一个公共的 Super-agent 时,哪些个人上下文需要隔离保密、哪些项目上下文需要共享?在不同权限边界的 Agent 之间(A2A,Agent-to-Agent),怎么在互不暴露底层隐私上下文的前提下安全可靠地协同办事?
◆ 第四,跨设备连接下的安全与隐私红线
将云端的 Agent Loop 通过轻量 daemon 连接到存有私有代码、敏感数据和本地凭据的个人电脑上,在带来便利的同时,也带来了明显的安全风险:
-
一旦云端的 Agent 在读取外部网页、邮件或群消息时遭遇了提示词注入(Prompt Injection,即外部文本里藏着恶意指令诱导模型执行危险操作),攻击者就有可能借云端 Agent 的权限控制所接入的本地设备;
-
哪怕没有外部攻击,只要本地电脑里的密码或 API 密钥明文进入了大模型的上下文,在正常对话中也有泄露风险。因此,如何设计一套隔离机制,让 Agent 能够在完全不接触凭据明文的情况下正常使用凭据完成操作,是这套架构走向更广泛应用必须解决的问题。
回顾整套设计,DeepSeek 并没有提出晦涩的新理论,而是用经典的系统工程思想回答了一个核心问题:当单个任务已经越来越少需要人工逐步干预时,怎么把人的注意力从繁琐的“管窗口、转述上下文、等待命令执行”中解放出来? 通过双层架构、事件驱动、异步多渠道交互、存算环境分离与外部 Watchdog,系统在底层接管了繁琐的会话管理与上下文同步,让人得以把精力上移到更高层的决策与验收上(DeepSeek 也在 GitHub 上放出了验证这套技术路线的原型仓库 dsh-superagent-prototype 供开发者参考)。无论你是在设计 AI 产品,还是在日常组合使用多个 Agent 工具,这套系统思路都很有参考价值。
本文收录于欧呦的 AI 实战课程与资源站 Oil Book(book.oiloil.org),点击链接可直达网站阅读。