聊一聊我常用的去 AI 味儿、过朱雀、原稿改写的工具
文章目录
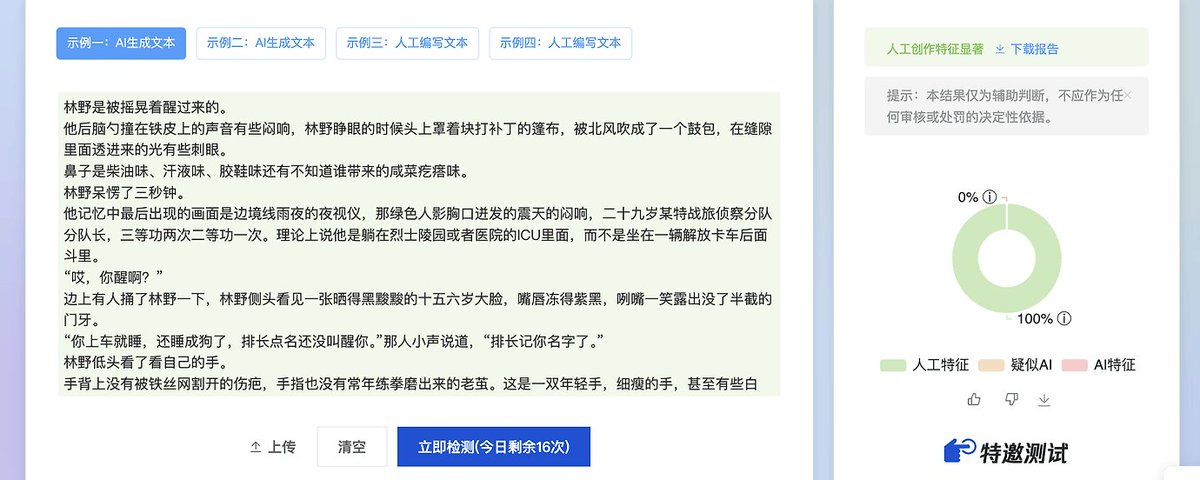
平时高频用大模型辅助码字、写文章、整理材料的朋友,大概率都经历过 AI 味儿的折磨,想用 AI 辅助,但出来的文章完全没法读,采用率很低,从而导致人工手改量很大。
试过几十种 Prompt 约束和改写方案后,我现在固定留下了一套工具组合,能够大量减少人工的环节,个人觉得比较好用,分享给各位做参考。
一、Monica 在线重写文本
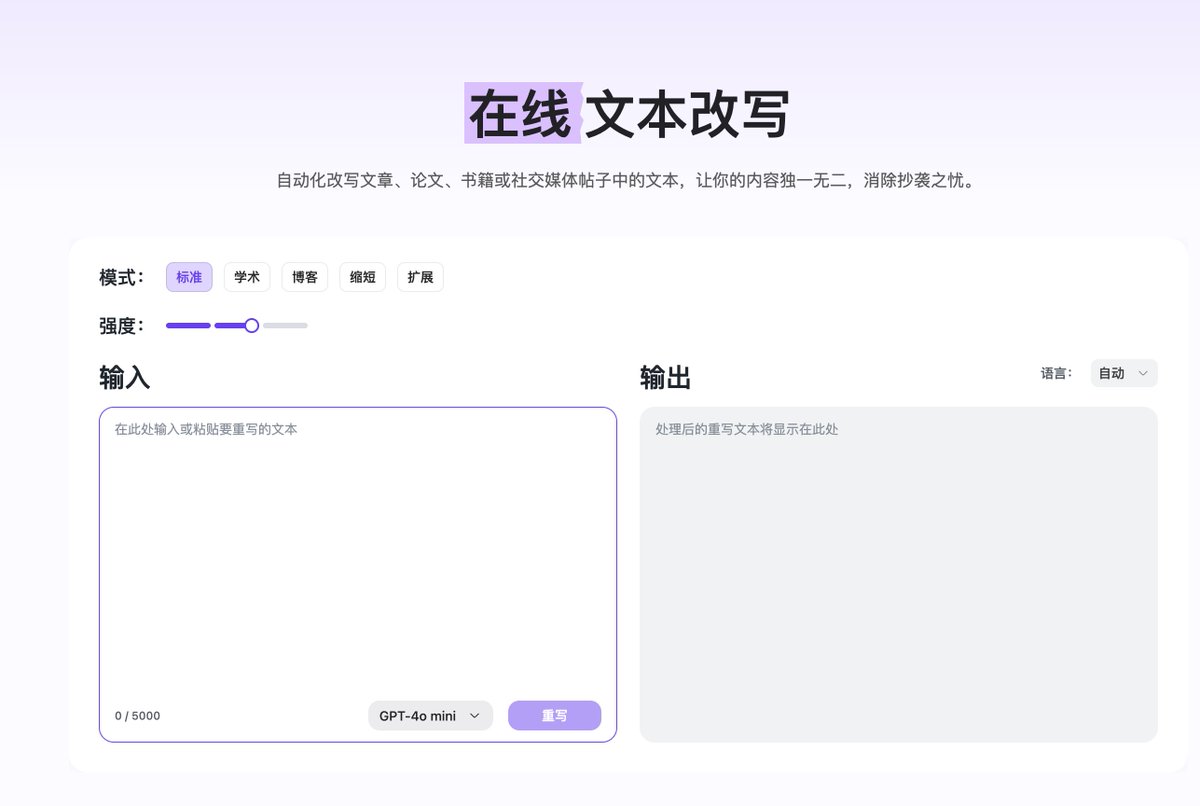
Monica 这款一款一站式、多功能的 AI 助手相信大家都用过,它有一个非常非常好用的能力,自动化改写文章、论文、书籍或社交媒体帖子中的文本,让你的内容独一无二,消除抄袭之忧。
并且这个能力是免费的!!甚至无需注册即可使用!!实测 GPT-4 mini 的模型改写效果已经非常优秀,是我使用率最高的工具,没有之一。地址是:https://monica.im/zh_CN/tools/rewrite-text
如果手头的任务只是把一段略显生硬的资讯、博客段落、社媒文案或邮件快速换个说法,Monica 在线重写文本工具是我最顺手的。
主要特点
-
网页端无需注册即可直接上手,单次支持最多 5000 字符输入,内置了标准、学术、博客、缩短、扩展五种预设模式,还能自由调节改写强度。
-
除了网页版,它还支持 Chrome 与 Edge 浏览器插件以及 Windows、Mac、iOS 和 Android 客户端,浏览网页或写文档时可以随时划词呼出,并能联动其工具箱里的「AI 文本人性化工具」与「绕过 AI」模块(部分能力是收费的)。
实战技巧
几个自己常用的实战技巧如下:
-
分段短改,不要一次性塞入几千字长文,按自然段切分后喂给模型,语义保留得更完整,句式重构也更自然。
-
巧用多语种回译洗稿,遇到极其顽固的中文 AI 句式时,可以先用 Monica 自带的 100+ 语言翻译器转成德语、法语或西语,再翻回中文并用「博客」模式顺一遍,原有的句法骨架会被彻底打散。
-
避开生僻套话,尽量使用日常高频表达,改写完后顺手用它自带的内容检测器和语法检查器做一次复核。
盗亦有道
兄弟们,切勿直接搬运和洗稿,使用时要注意
-
先查有没有人发过,X 只对自己平台的作品审查较严格,其他平台搬运时一定要注意原作者有没有在 X 或者已经有人发布了该作品
-
换个角度,用自己的观点评价下,比如:发现了一个宝藏 Skill,xx 的这个视频太有创意了
-
切勿频繁和连续,容易伤号甚至封号
-
缩短、扩展、加自己,洗稿的精髓在于缩短和扩展,并加入自己的内容
二、「落笔」(Luobi)与开源 novel-humanize-4b 模型
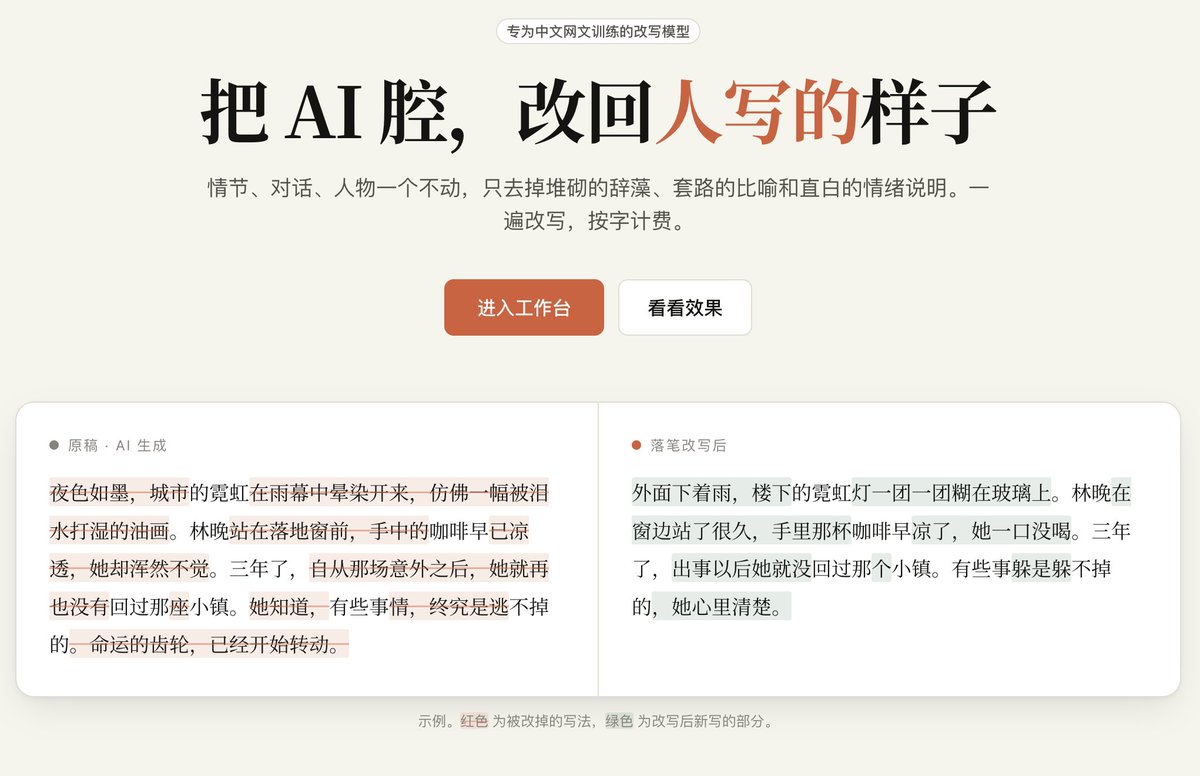
LINUX DO 社区开发者 jocker (GGbang)(Hugging Face ID: gugujiji)推出的在线改写站「落笔」(https://luobi.18283745.xyz/)以及近期从头重训并开源的 novel-humanize-4b,从模型权重层面的去 AI 味方案。
该方案支持开源部署,也支持在线访问,可通过在 LINUX DO 向作者申请获取永久额度,或者使用 LDC 支付额度。
它是怎么训出来的?
完整技术链路与评测数据:
-
线上版「落笔」运行的是 8B 模型,而开源的 novel-humanize-4b 是采用完全相同流程训练的 4B 版本。它以 Qwen/Qwen3-4B 为底座,先用约 4,000 章「AI 稿 → 真人稿」配对数据做 LoRA SFT(监督微调),接着跑了 100 步 GRPO 强化学习,最后合并成约 8GB 的 bf16 完整权重,一张普通家用显卡甚至 Mac 就能本地部署(README 详情)。它的唯一目标就是在不改动剧情、对话、人物和事件顺序的前提下,砍掉刻意雕琢的辞藻、套路化比喻和直白的情绪说明,换成真实网文作者克制、有节奏的语感(novel-humanize-4b)。
-
实测量化指标(158 章验证集),改写后平均篇幅为原文的 0.90 倍(略有精简),与原文逐字相同的比例约为 60%(意味着约四成的字词表达被重塑)。在使用 Qwen3.6-35B 模型的盲测下,线上 8B 版的严苛合格率为 54%,开源 4B 版为 48%;同时通过 20 字片段重合率比对(训练集 0.39% vs 未见章节 0.41%),证实模型并没有死记硬背训练原书(README 评测)。
使用指南
-
严守固定提示词与半角标点。本地调用时必须一字不差地使用官方给定的 SYSTEM 提示词与 --- 包裹格式(标点必须为英文半角),并且必须关闭 Qwen3 的思考模式(enable_thinking: false),否则模型不知道该如何改写或会陷入思考死循环(novel-humanize-4b)。
-
按“整章”长度喂入(1,000–2,500 字最佳)。因为模型是按整章训练的,千万别喂几百字的短片段。作者实测喂入 300 字左右时,模型有 54% 的概率会“意犹未尽”自己往下编新剧情(改出 1.3 倍以上长度);而喂入 1,000–2,500 字时,乱编续写的比例直接降到 0%–3%。
-
用 fix_tools.py 实现“小模型去味 + 大模型捉虫”。4B 模型体量小,改完偶尔会有错别字、“的地得”混用,或者第三人称突然蹦出个“我”。如果直接让大模型全文重写修错,好不容易去掉的 AI 味又会全部回来。为此作者在仓库里提供了零依赖脚本 fix_tools.py:先由本地 4B 模型改写,再调 DeepSeek/GPT 等大模型 API 只挑出需要改的错字位置,由脚本逐字替换,并锁死三条硬保险——每处最多改 2 个字、全文高频出现的专有名词(人名/地名)不碰、整篇改动超过 8% 直接作废,彻底杜绝大模型好心办坏事。
具体帖子链接见:https://linux.do/t/topic/3073575
三、Gemini 3.1 Pro
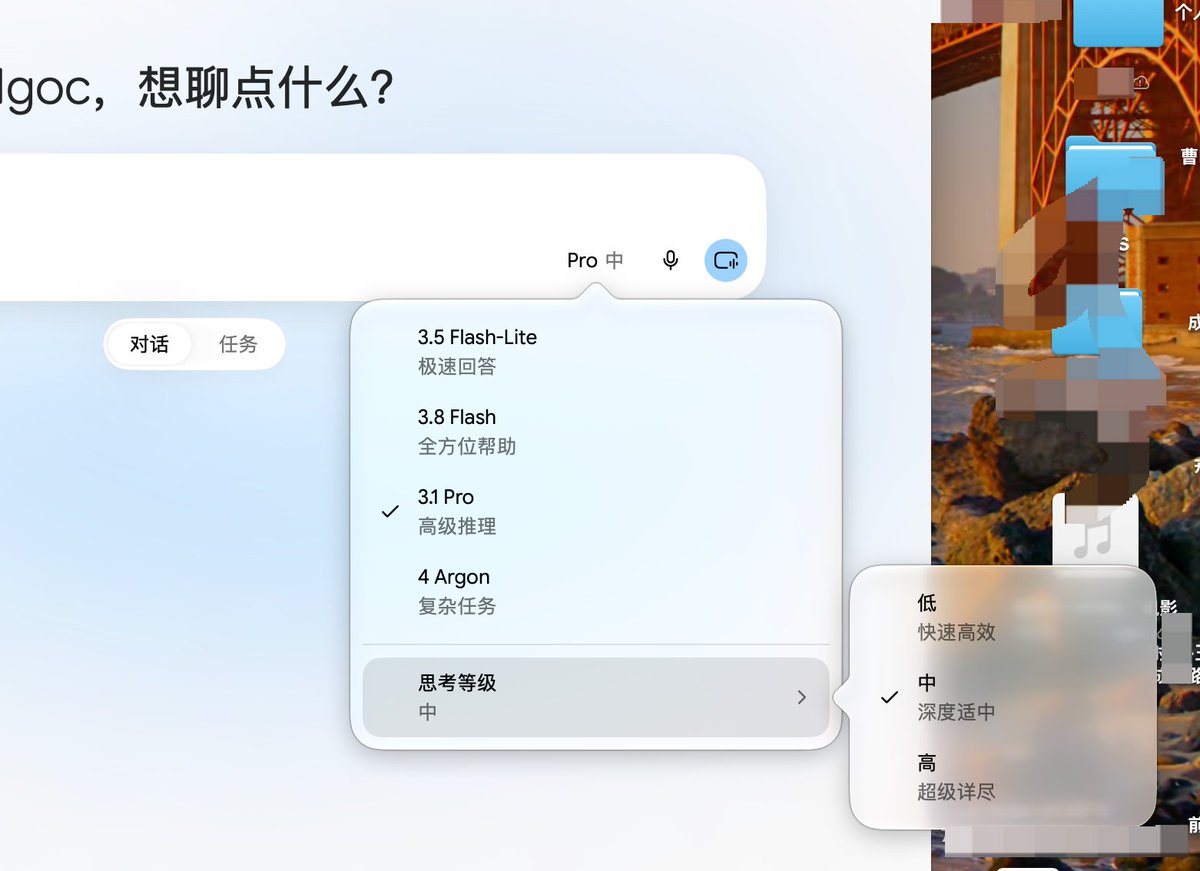
Gemini 3 Pro 在写作层面的优势,我个人认为遥遥领先,甚至优于 deepseek4.1 和 opus5.5,我个人的大部分文章都是使用 Gemini 3 Pro 改写或者直接书写。
个人的一些技巧如下:
-
明确要求不使用多层级有序/无序列表,文内标题只能使用一级、二级标题,尽可能不使用表格;
-
明确要求字数,万字长文就明确要求 10000 字左右;
-
明确风格和类型,比如我要发布成第一人称自然语言描述的播客文章。
四、最后
归根结底,去 AI 味并不是单纯追求检测器上的那个 0%,而是找回文字里真实可感的呼吸节奏与分寸感。
日常短文案求快用 Monica,网文长章去套路、过朱雀用「落笔」及开源 4B 模型,而到了需要立住个人文风、打磨长篇干货与学术论文的时候,把历史原稿喂给 Gemini 3.1 Pro 做深度重构,基本就能覆盖 95% 以上的改写场景了。