
自己动手做LoRA 从 0 到 1 实战
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
每一张照片里,都藏着一段温暖的回忆。训练一个专属的 LoRA,让她出现在任何一张照片里,都还是那个她。
AI 生图已经这么强了,还需要自己训练 LoRA 吗?
我一开始是怀疑的,直到我亲手把它训练出来。
这次的目标很简单:训练一个专属的马尔福角色。
用 GPT Image 2 生成训练数据,再让 MOSS-Image 学会这个人物。
最终只用了 56 张图片,一张 RTX 4090 48GB,训练约 65 分钟。第 300 步,就已经能比较稳定地画出这个角色了。
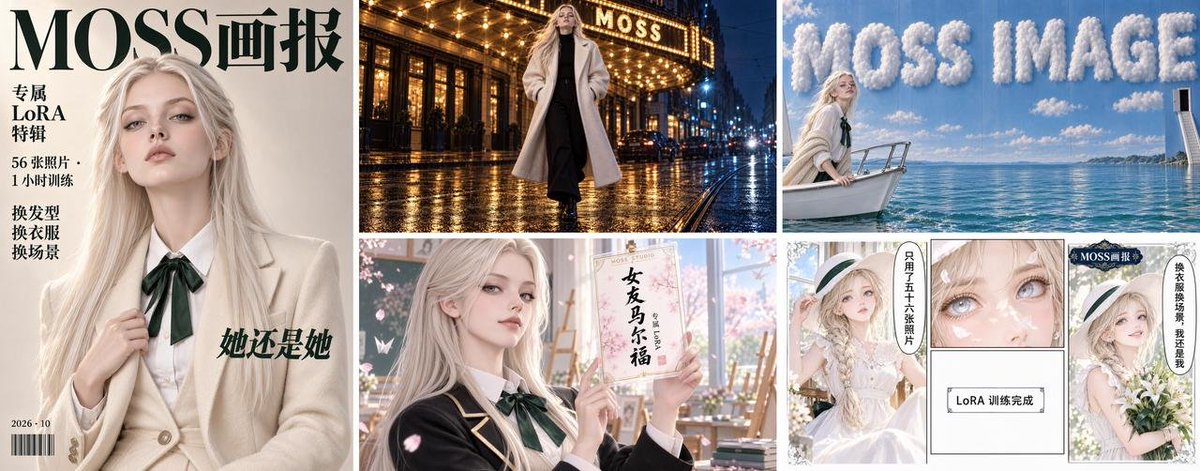
先看效果。
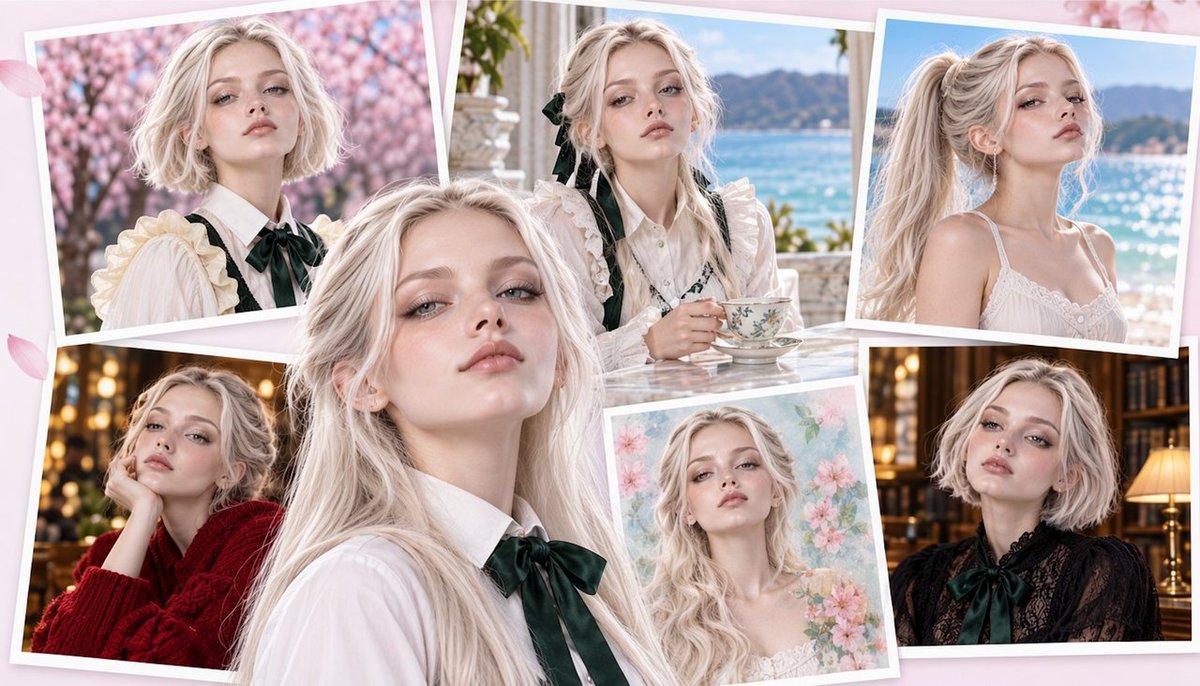
训练后,加载这个 LoRA,就能让她换衣服、换场景、换角度,同时尽量保持同一张脸。
不过,训练 1 个小时左右,准备这 56 张图片却花了 3 个多小时。
于是为了大家学习时免去收集数据,我还把流程整理成了 GitHub 项目,准备了运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,方便大家自己复现。
这篇文章讲四件事:准备数据、训练 LoRA、验收效果,以及在 ComfyUI 里使用。
目的不是让大家照着生成几张图,而是从头到尾走一遍,真正学会图像 LoRA 的训练流程。
一、AI 已经这么会画了,为什么还需要 LoRA?
现在 GPT Image、MOSS-Image 这些模型,输入一段提示词,就能生成相当不错的图片。
LoRA可以做的更强:比如做电商、漫画、短剧、虚拟 IP 需要锁定产品外观和人脸。
还有人想用自己以前的照片,训练一个专属形象,留下当年的样子。
配合像Moss-image这样的宽审核模型,可以用AI 给人物脱掉袜子,同时保持良好的腿型。
这类特定细节、服装和人物风格,都可以尝试用针对性的训练来改善稳定性。
重点是,一通百通。
LoRA 是什么?LoRA(Low-Rank Adaptation,低秩适配):冻结原模型的权重,只在部分网络层增加两个很小的低秩矩阵,通过训练它们产生权重增量。不需要重新训练整个模型,就能让它学会特定人物、产品或画风。训练完成后,这些增量可以单独保存、加载和替换。
为什么选择 MOSS-Image?
MOSS-Image 最新图像生成模型,采用 5B 参数的 Diffusion Transformer 架构,使用 Apache-2.0 协议。
它的宽审核能力是最强的,强过Qwen Image 2.1,因此我们能做很多事情。
它提供 Base 和 SFT 两个版本。这次我选择适合继续微调的 MOSS-Image-Base。
训练完成后,得到的 LoRA 文件大约 150MB。
以后想画这个人物,把 LoRA 加载到原模型上就行,不需要重新训练整个 5B 模型。
二、数据准备:用 GPT Image 2 给 MOSS-Image 当老师
这次的虚构人物叫 Malfoid。
灵感来自马尔福:银金色头发、冰灰色眼睛、英伦学院风,带一点高傲的贵族气质。
采集真实的人物比较麻烦,这是为了学习用途。我先通过 Claude 调用 GPT Image,生成一张满意的定妆照。
之后用GPT Image生成不同场景的图片,都以这张定妆照为参考,尽量保持人物身份一致。
这有点类似蒸馏中的老师和学生,但严格来说,并不是把 GPT Image 2 的全部能力蒸馏给 MOSS-Image,而是用合成数据对开源模型进行定向微调。
不过,GPT Image 生成的图片,因为给的参考图,脸基本是拷贝的,会损失多样性,有条件的,可以拿实拍图集来训练。
第一批的部分图片:脸很一致,但问题同样明显。
第一轮,我设计了 48 个镜头,覆盖正脸、侧脸、背影、不同服装和场景。
检查下来有不少问题,侧脸不听话、喜欢抬下巴,大量校园场景,略微重复。
于是我针对缺口补拍 20 张,重点增加侧脸、背影、不同表情和便装。
最终得到 68 张候选图,剔除 12 张重复图片,留下 56 张。
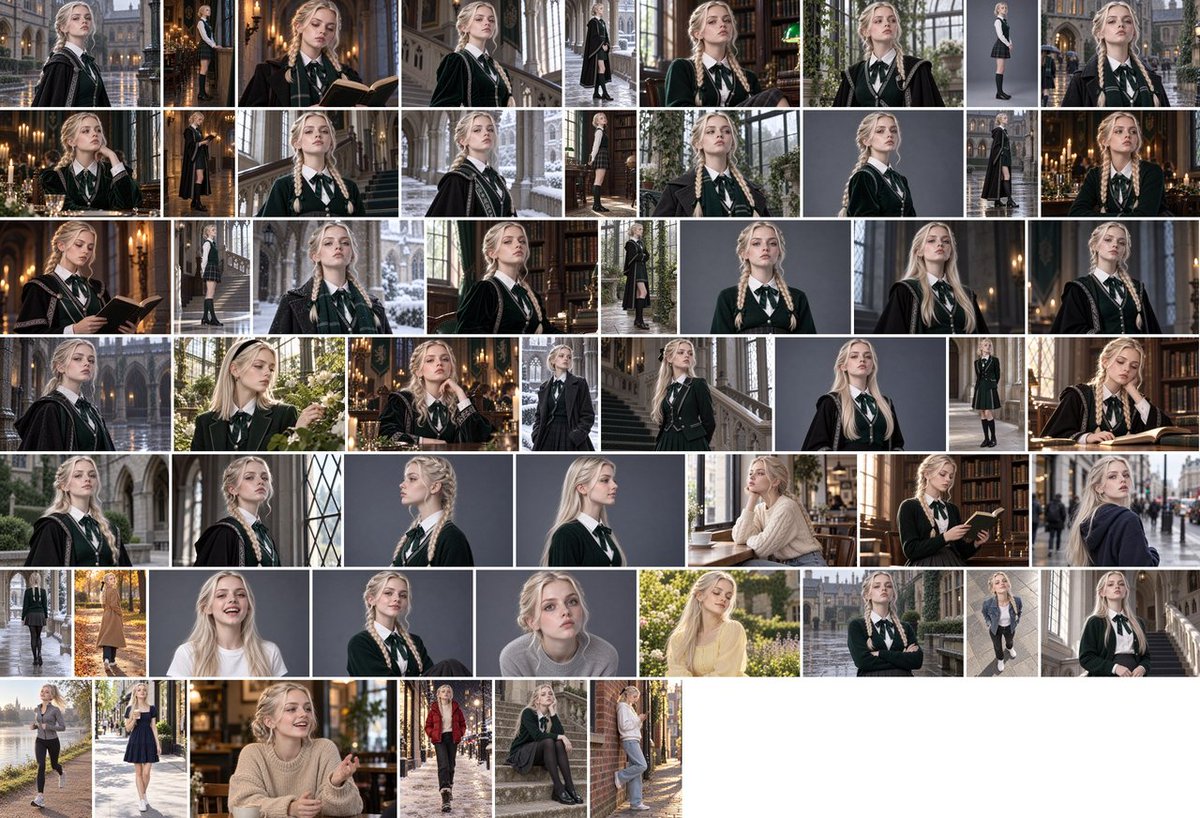
最终的 56 张训练图片。
这批数据有 17 张全身照、4 张侧脸,但依然存在一个问题:
44 张都是校服,占了 79%,问题不会太大。
图片准备完,还要给每张图片写对应的文字描述,以前是人打标的,现在可以让Agent来直接做。
这里了解几个概念:触发词(Trigger Word):人物的专属身份标识。这次使用 Malfoid,希望模型看到这个词,就能识别 Malfoid。Caption:训练阶段使用的图像描述,本质上也是一种 Prompt。通常包含触发词,以及图片里的服装、姿势、表情、场景等信息。生成 Prompt:训练完成后,告诉模型这次具体想画什么。
比如,同一个人物的两张训练图,服装和场景不同。我们希望模型把人物身份与这些可变化的属性分开学习。
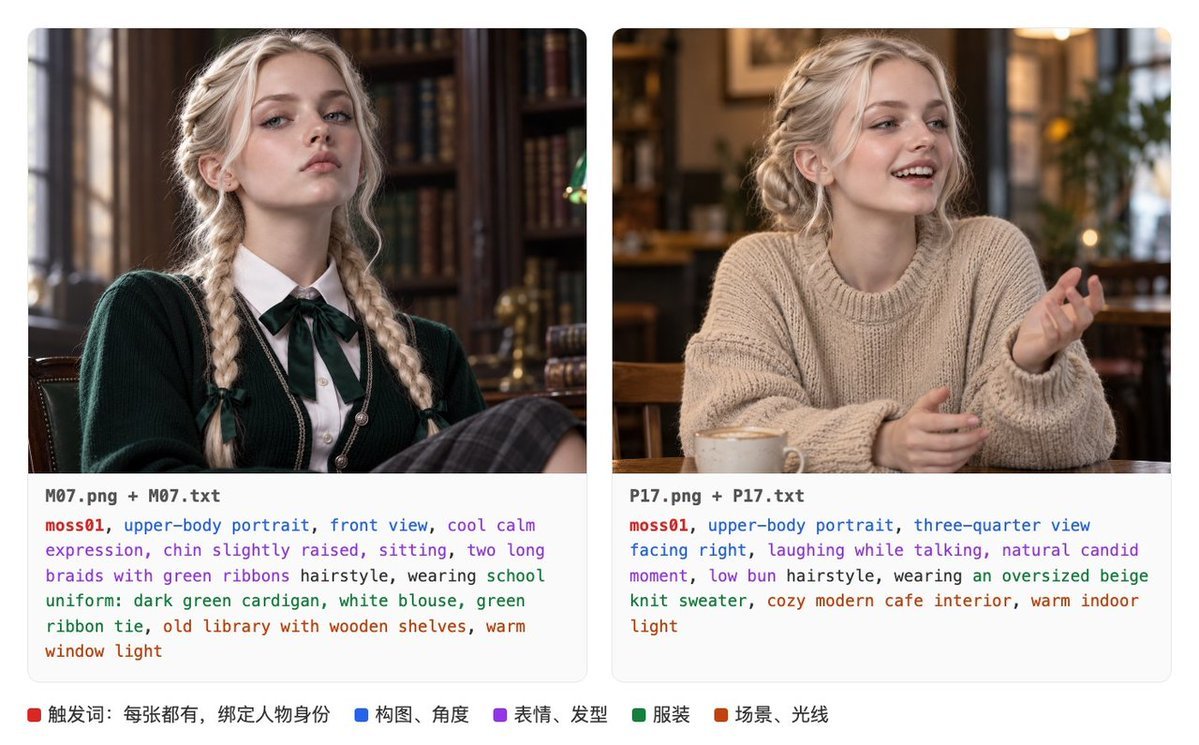
现在像 Qwen-Image、MOSS-Image 这样的新一代模型,已经能够理解更长、更完整的自然语言描述。
这次我还是选择了传统的标签式caption写法。
为了方便逐张审核、统一字段,也方便检查哪些属性没有描述准确。
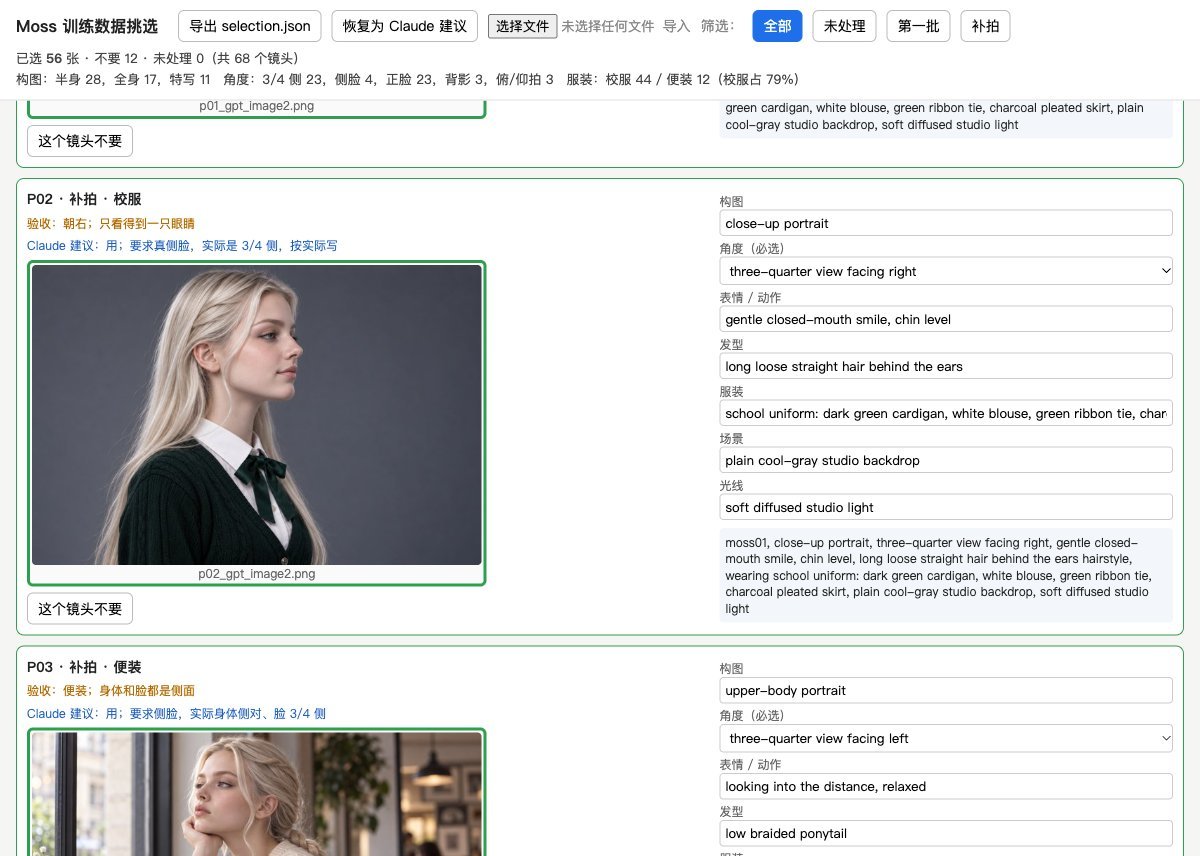
比如生成时要求侧脸,实际却画成正脸,Caption 就必须按实际图片标注,而不是照搬原来的生成提示词。
为了提高效率,我还做了一个图片挑选页面。整个数据准备过程花了约 3 小时 15 分钟。你这次如果也需要做实验,可以跳过这个环节,直接先用我的数据。
用 AI 生成数据不难,难的还是人工参与,确保数据真正符合训练目标。
三、正式训练:一张 4090,65 分钟
数据准备完成,训练反而简单了。
这次使用 KohakuMossTrainer,一个支持 MOSS-Image 微调的第三方训练框架。
主要配置如下:
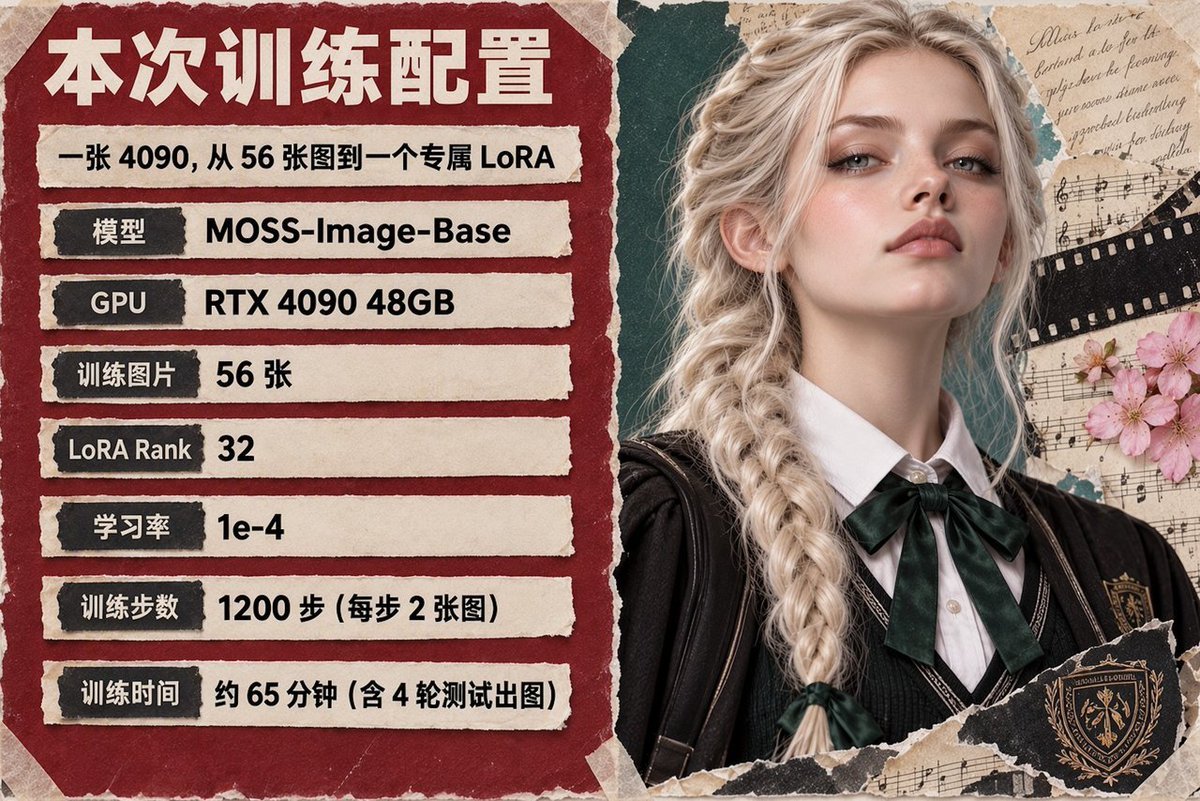
训练过程每 150 步保存一个 Checkpoint,每 300 步生成一组固定测试图片。
Checkpoint(检查点):模型在某个训练阶段保存的权重。可以理解成不同时间点的存档,方便训练完成后回头比较,选出效果最好的版本。
这次训练到第 300 步,人物就已经能认出来了。
通常训练Lora不会默认最后一个checkpoint就是最好的,你可以测试中间的效果,找到最适合的。我也设计了一个验收方法。
Loss 重要吗?
这次训练过程中,Loss 一直在 0.4~0.65 之间来回跳,看不出明显的下降趋势
Loss(损失值):衡量模型在训练目标上的误差。它可以帮助检查训练是否存在异常,但并不直接代表最终图片的质量、人物一致性或提示词遵循能力。
验收图像 LoRA,Loss还不够,重点看三件事:
人物像不像、提示词听不听、有没有学到不该绑定的特征。
四、效果验收:模型到底学会了什么?
我自己设计了五组固定测试,来判断这个 LoRA 究竟学到了什么。
每隔 300 步,使用相同的测试提示词和随机种子生成图片
这样就能把不同 Checkpoint 放在一起比较。
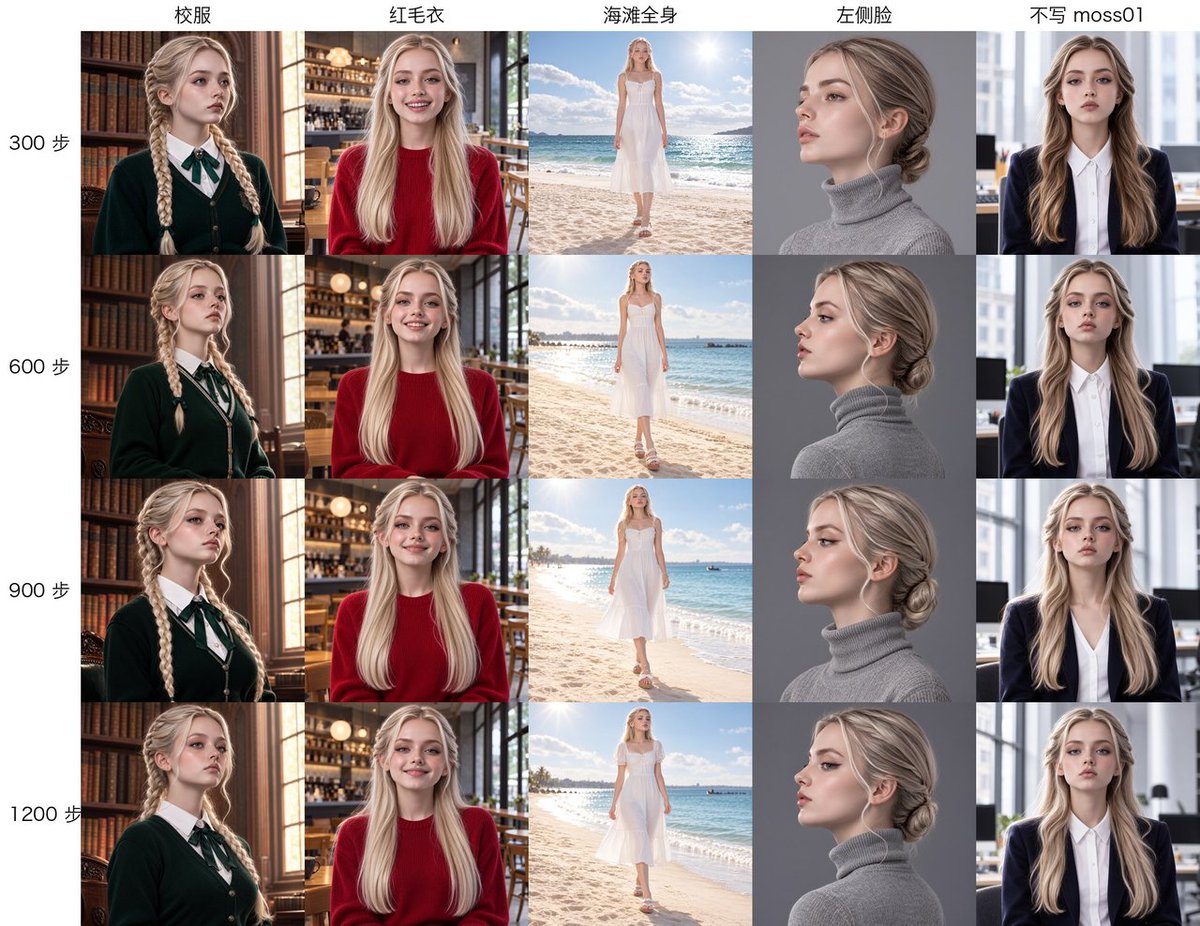
第 300 步,基本达到目标
到了第 300 步,Malfoid 的五官和整体形象已经比较一致。来看一下效果
之前我用一批以头肩肖像为主的数据训练过人物 LoRA,结果训练久了,模型总喜欢把全身照拉回大头照
这次训练集角度还是比较丰富,所以各种构图保持的都是不错。
这说明一个很重要的思路:
基座模型Moss-Image本来就会画全身照、侧脸和各种服装,LoRA 主要负责让它学会这个新人物。
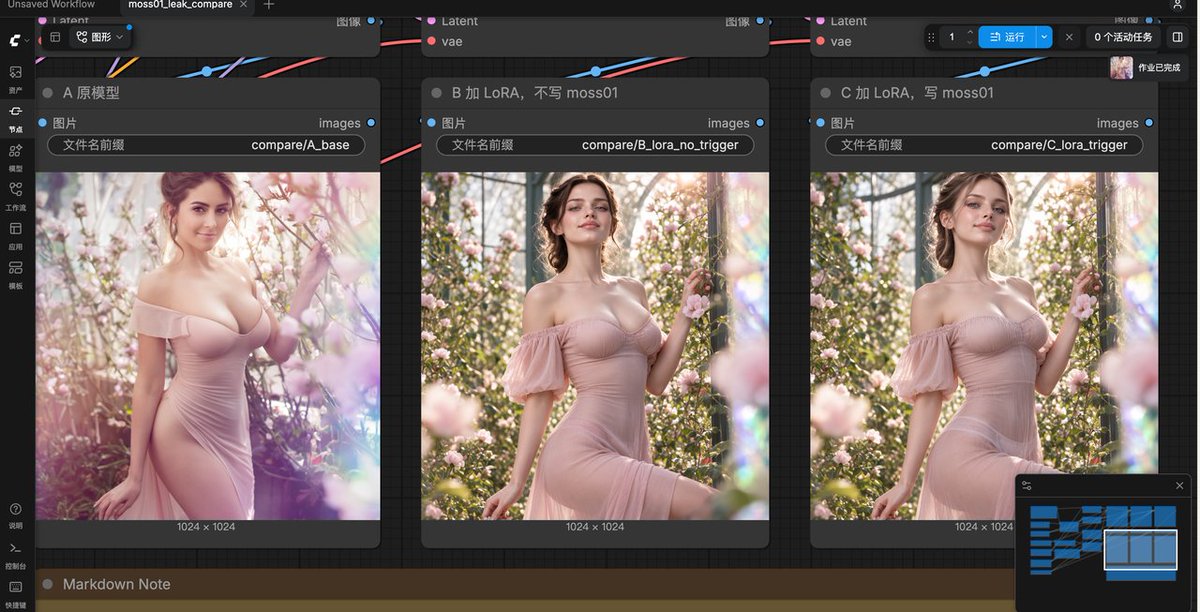
意外发现:加上 LoRA,所有人都变成了 Malfoid 最后一列测试,提示词里没有 Malfoid,只写了一个普通的年轻女性。照理说,它应该和不加 LoRA 的原模型画得差不多。原因不难理解。有点过拟了,没加正则数据的话触发词没啥用,rank太大了很容易过拟合。但是没有关系,Lora圈很多模型是这样的。我们可以配合comfyui + Moss,想用的时候才加载这个 LoRA,不想要她就不加载。其他服饰相关,因为校服占79%,反而没有泄露。验收时一定要拿原模型做对照,才看得出来。
LoRA 练好了,日常出图更方便的方式是 ComfyUI。
镜像里已经装好了 ComfyUI,开机自动启动。
五、GitHub 完整开源,建议亲手跑一次
这次我把整个流程整理到了 GitHub,准备了运行环境镜像和 Jupyter Notebook。
Jupyter Notebook:可以理解成一本能够直接运行代码的交互式教程。每一步都有说明和对应的代码,运行一格、查看结果,再继续下一格。
整个流程已经按顺序拆开:
检查 GPU 环境、准备图片、整理 Caption、下载模型、缓存数据、启动训练、比较 Checkpoint,最后导出 LoRA,生成自己的角色图片。
完整配置和代码都在镜像和仓库里,正文就不重复贴了。
Notebook 里边训练边看:进度、Loss 曲线和最新一轮测试图都直接显示在格子下面。
如果你没有GPU,但想复现这个实验,可以注册复制镜像,里面已经有所有的环境跟数据集,一键开始训练: UCloud
github:https://github.com/limin112/Lora
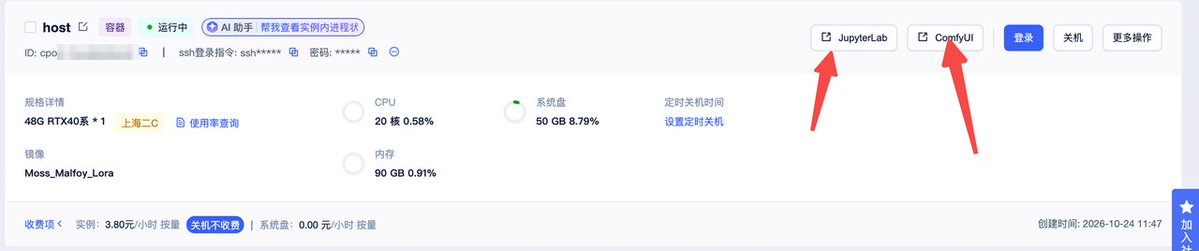
这次用的实例:48G RTX 40 系 × 1,按量 3.80 元/小时。点右上角的 JupyterLab 就能打开 Notebook。按照 Notebook 一步一步运行,我设置了一个60步的训练,30分钟能跑完。跑完后体验一下预装的ComfyUI + LoRA。
训练完成记得关机,别让 GPU 一直计费,新用户可以免费用1-2小时,做一次训练略微进展,也是足够的。
最后,给想学习的朋友一个建议
现在大家都习惯用 Agent。
你完全可以把文章或者整个 GitHub 仓库丢给 Claude Code、Codex,让 AI 帮你部署运行。
它可能很快就能把事情做完。
但我还是建议,第一次尽量亲手跑一遍 Notebook。
不用从零写代码,也不用背下所有训练参数。
只需要运行一格,看看输出,想一想这一步为什么存在,再继续下一格。
为什么需要 Caption?为什么要缓存数据?为什么保存 Checkpoint?为什么训练完成还要验收?
这些问题,亲自跑一次,比单纯看教程更容易理解。
而且实际操作并没有想象中复杂。Notebook 已经准备好执行步骤,主要成本是 GPU 计算资源和你愿意投入的学习时间。
跑完一遍,学到的不只是怎么训练这个「女友马尔福」,而是整个图像 LoRA 从数据准备、训练到验收的方法。
以后不管换成人物、产品还是特定画风,都知道应该从哪里开始。
等真正理解了,再把全部流程交给 Agent 自动完成也不迟。
AI 可以帮你把事情做完,但亲手做一次,才真正知道它做了什么。
暂时不想部署的话,Moss支持直接在线体验。


