
AI 生图还能用 JSON 控制排版?我拿 5B 开源模型做了次商业海报实验
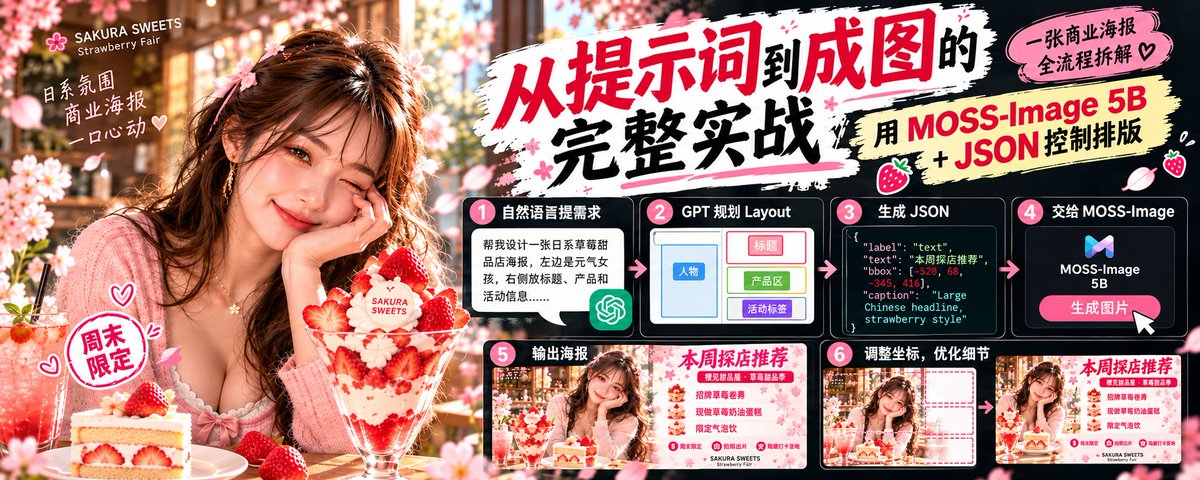
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
我靠!现在的 AI 生图,已经开始支持直接用 JSON 来控制画面布局了?!
最近研究开源生图模型的时候,发现了一个挺有意思的项目:MOSS-Image
只有 5B 参数,却同时把「文字渲染」和「结构化布局」作为重点能力。
这让我突然想到一个问题: 能不能把一张商业海报,像写前端页面一样,把人物、产品、标题、文案的位置全部定义好,然后直接交给 AI 生成? 毕竟现在让 AI 生成漂亮图片,已经不是什么新鲜事了。
但真正做过商业设计的人应该都懂:漂亮和能用,完全是两回事! 你想把标题放在右上角,它偏偏给你放在中间;想让产品大一点,人物反而占满画面;再加上中文乱码、文案被遮挡、信息层级混乱……经常是图挺好看,最后还是要打开 PS 重新做排版
所以这次我想认真测试一下,MOSS-Image 的 JSON Layout 到底能解决多少实际问题!
直接上真实商业案例:日系美女 × 草莓甜品店广告海报! 既要有漂亮的成年女性模特、诱人的美食和日本时尚杂志的摄影质感,还得能把中文标题、英文副标题、活动标签和品牌信息安排明白。 不只是测审美,更要测它的控制能力。
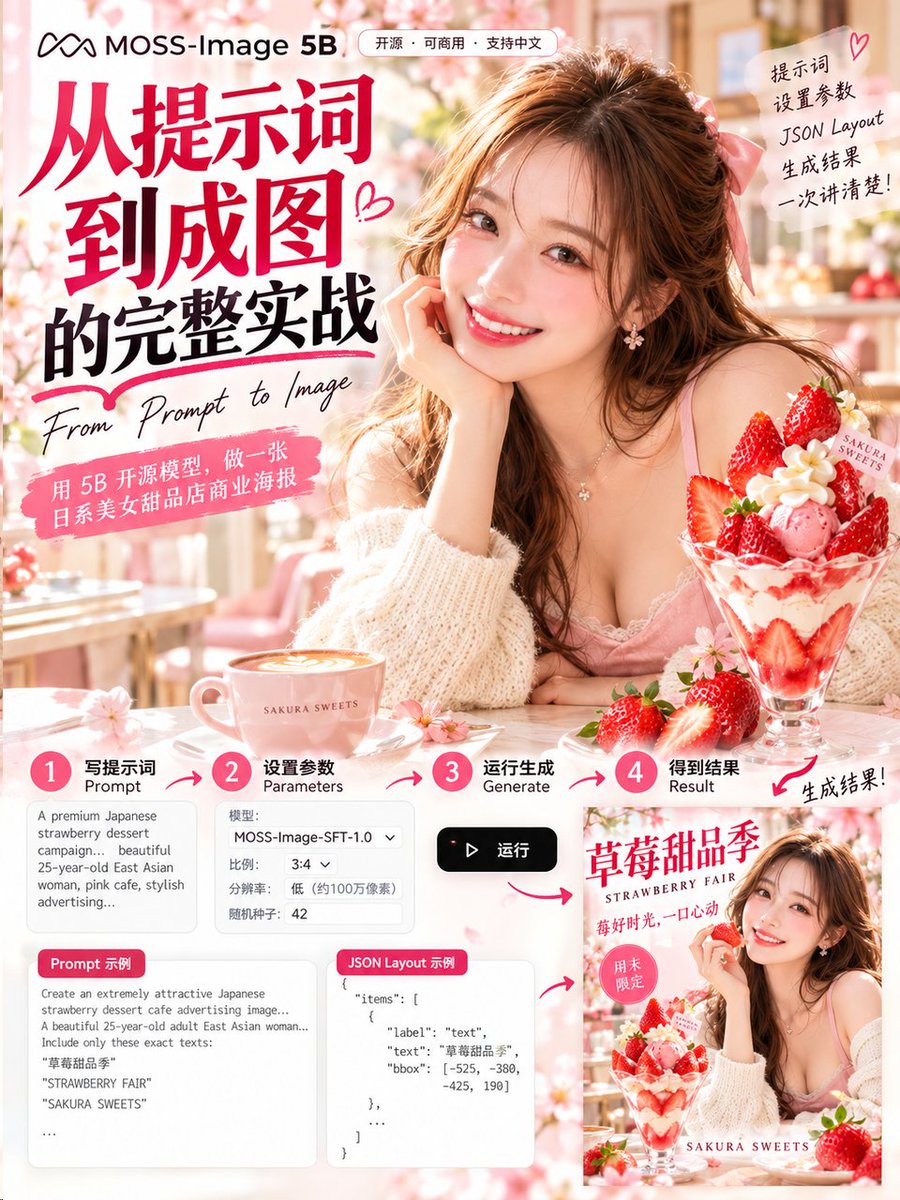
01. 先认识 MOSS-Image:为什么我会关注这个 5B 模型?
MOSS-Image 是模思智能(MOSS)与 OpenMOSS 团队推出的开源图像生成模型。 它的核心是 5B 参数的 DiT 架构,使用国产 PPU 算力平台训练 和单纯追求画质的模型不同,我这次特别关注它的三个特点
第一,图像中的文字渲染 官方重点强调中英文文字生成能力,可以把标题、标签、多行文案直接作为图片内容生成。 对于海报、菜单、信息图、电商广告来说,这比单纯提高画质更有实际价值。
第二,JSON Layout 结构化布局 这是我最感兴趣的!它允许把画面拆分成若干个元素,分别描述内容、样式和位置。 比如:
-
人物出现在左侧
-
草莓芭菲位于右侧前景
-
中文主标题安排在左上角
-
英文副标题放在右上角
-
品牌名称放在底部
这些不再只是自然语言中的模糊要求,而可以进一步用坐标框表达。
第三,开源和可扩展性 MOSS-Image 提供 Base 和 SFT 两个版本,公开模型权重与代码,支持最长 4K tokens 的提示词,还有 ComfyUI 等工具链支持。 这意味着它不仅适合在线体验,也给开发者做自定义工作流、训练 LoRA 留出了空间。
官方 GitHub:https://github.com/OpenMOSS/MOSS-Image
02. 我的测试案例:把一家日系甜品店的海报需求交给 AI
我先虚构了一个甜品品牌:SAKURA SWEETS|樱见甜品屋 它准备上线草莓甜品季,需要制作一张能发布到社交媒体的商业海报。
为了让测试更贴近真实需求,我给它设置了几个条件。 人物: 25 岁左右的成年东亚女性,元气甜美、轻熟时尚,穿浅色针织衫,有一点日杂广告里的微性感氛围。 产品: 一份草莓芭菲,必须突出新鲜草莓、奶油、玻璃杯和甜品的诱人质感。场景: 明亮的日式甜品咖啡馆,以樱花粉、奶油白和草莓红为主色调。
海报文字: 主标题:草莓甜品季 英文标题:STRAWBERRY FAIR 活动标签:周末限定 产品名称:草莓芭菲 品牌:SAKURA SWEETS
这里有一个关键点: 我不仅要让 AI 知道画面里应该有什么,还要告诉它每个东西应该出现在哪里。
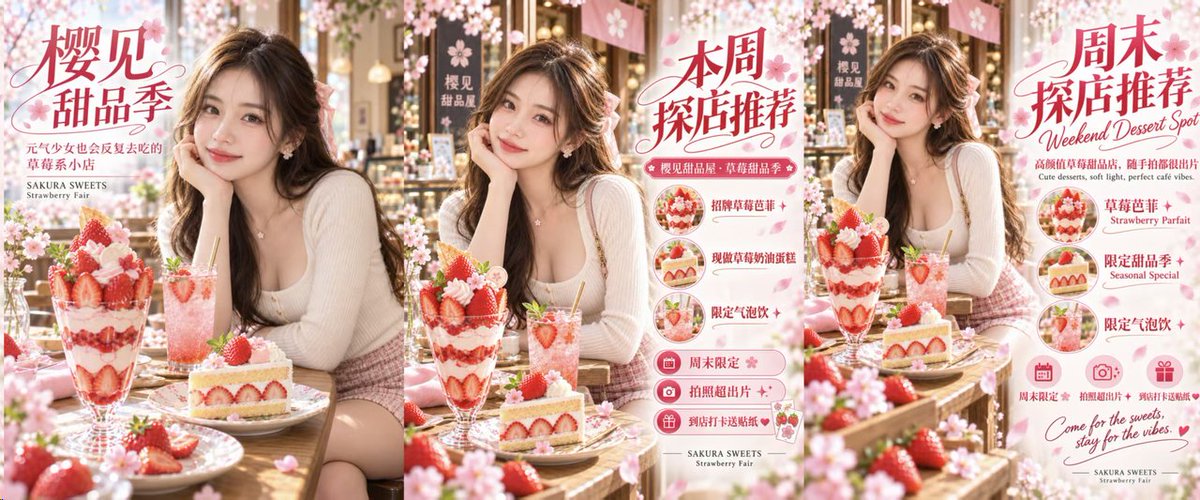
所以,我把整个测试设计成三轮。这是跑出来的三个海报图
03. 第一轮:普通 Prompt 和 JSON Layout,到底有什么区别?
先说最简单的方式。 传统生图基本都是这样,把人物、场景、摄影风格、海报文字,以及构图要求写成一大段自然语言,然后等待模型理解。
一张高质感、写真级、商业海报风格的日系甜品店探店宣传图。画面主角是一位 24 岁左右的东亚成年女性,漂亮,元气感强,带轻微性感气质,五官精致,皮肤通透,长发微卷,妆容清新自然。她坐在日系甜品店靠窗位置,穿浅色修身针织上衣和短裙,整体时尚、甜美、干净,有轻熟日系时尚感。

桌上摆放一份超高颜值草莓芭菲、一块草莓奶油蛋糕和一杯粉色气泡饮,甜品细节丰富,奶油、草莓果肉、玻璃杯质感清晰。店内环境温暖明亮,有木质桌椅、柔和灯光、日系杂志感装饰,整体氛围像高端探店写真。人物看向镜头,表情自然有感染力,画面有明显的社媒传播感。

构图为竖版商业海报,人物与甜品都清晰突出,前景有甜品特写,中景是人物,背景柔和虚化。整体色调以奶油白、樱花粉、草莓红为主,视觉元气、清爽、时尚、精致。

海报中需要清晰呈现中文标题「樱见甜品季」,副标题「元气少女也会反复去吃的草莓系小店」,英文小字「SAKURA SWEETS / Strawberry Fair」。文字排版整洁,适合社交媒体封面与商业宣传海报。照片级写实,细节清晰,时尚杂志大片质感。
这当然能表达我们的意图。但里面的“左侧”“右侧”“顶部”,对于模型而言依然是相对模糊的语言信息。
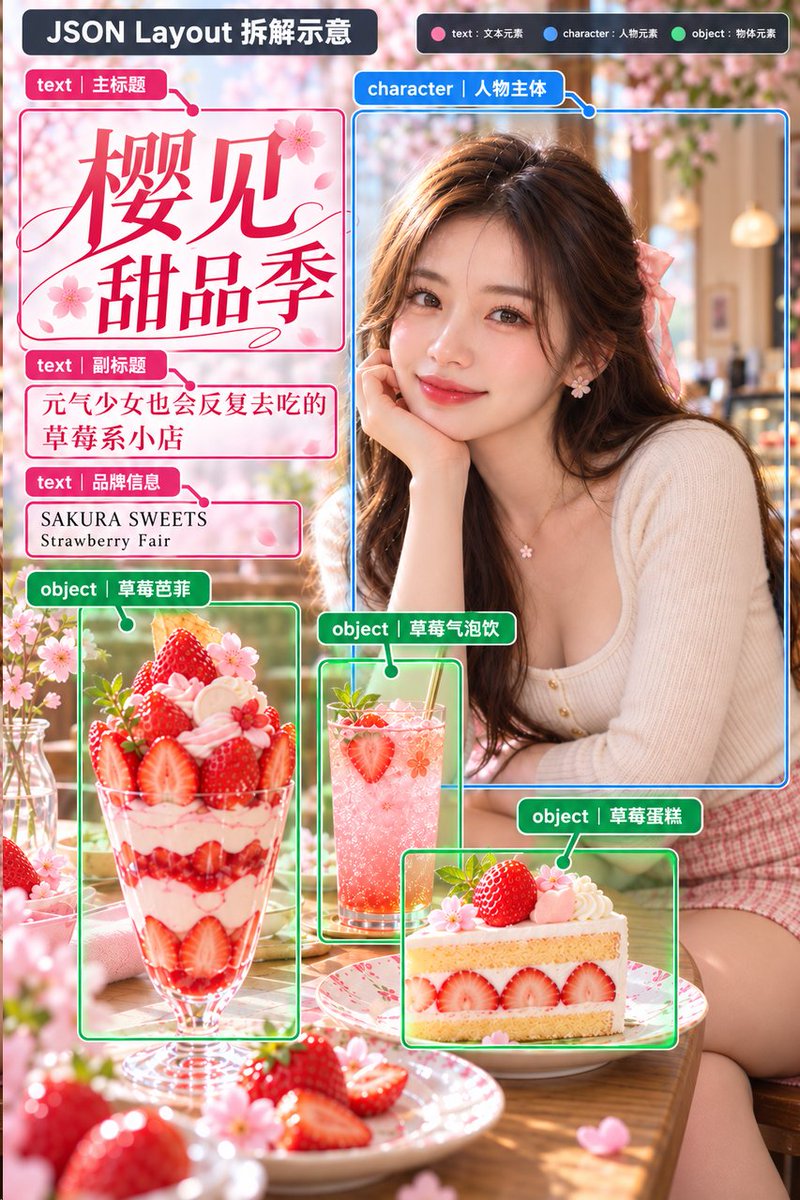
如果我们希望进一步控制构图,就可以换一种输入方式。 这就是 MOSS-Image 的 JSON Layout 在它的结构中,最重要的其实只有几部分:
-
summary:整个画面的场景与风格
-
items:需要出现在画面中的元素
-
label:元素属于文字、人物还是物体
-
text:需要直接渲染的文字
-
bbox:这个元素的空间范围
比如我们把中文标题单独拆出来:
{
  "label": "text",
  "text": "樱见\n甜品季",
  "caption": "Very large elegant flowing strawberry-red Chinese headline, two lines, upper left.",
  "bbox": [-535, -422, -290, -43]
}
这段 JSON 可以理解为: 我要在画面中生成一段叫「樱见甜品季」的文字,它采用草莓红色的粗体商业字体,并且应该出现在指定范围内。
类似的方式,也可以分别定义人物、甜品以及其他广告信息。
原来的一段自然语言,现在被拆成了多个能够独立描述的视觉元素。
04. 第二轮:从主视觉到商业活动海报,我用 JSON 重新设计了整张图的排版
接下来才是我觉得 MOSS-Image 真正有意思的地方!
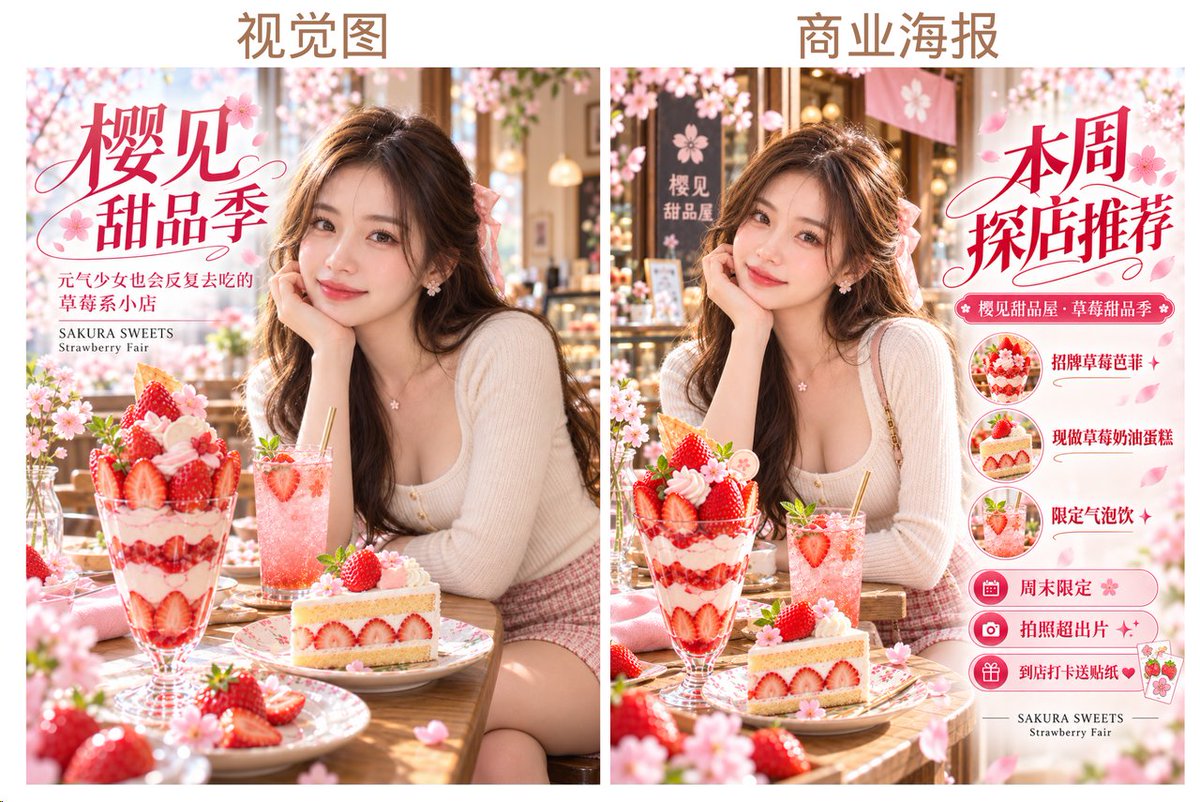
前面那张「樱见甜品季」,更偏向日系时尚杂志的主视觉:漂亮的模特、精致的草莓甜品、醒目的品牌标题,整体好看就够了。
但如果这家甜品店真的要做周末营销呢?
商家肯定还希望展示招牌产品、活动卖点、促销信息,甚至要引导顾客到店打卡。
这时候,需要改变的就不只是文案,而是整张海报的信息结构。
所以我继续沿用「樱见甜品屋」这套视觉设定,尝试用 MOSS-Image 的 JSON Layout,重新规划一张更完整的探店活动海报。
第1步:先把画面拆成不同元素
我希望新版海报保留原来的粉色日系氛围,但把整体布局调整为左右分区:
-
左侧: 美女模特、草莓芭菲、奶油蛋糕、气泡饮,负责视觉吸引力。
-
右上: 「本周探店推荐」大标题和品牌活动名称。
-
右侧中部: 三款招牌产品的缩略图及对应卖点。
-
右侧下部: 「周末限定」「拍照超出片」「到店打卡送贴纸」等活动标签。
-
底部: 品牌英文名称 SAKURA SWEETS。
这样一来,海报就从一张偏重审美的宣传图,变成了信息更完整的商业营销素材。
第2步:用 JSON Layout 给每个元素安排位置
MOSS-Image 的 JSON Layout 可以把图片拆分成不同的 items。
每个元素主要通过三个字段描述:
-
label:元素类型,例如 text(文字)、character(人物)、object(物体)
-
caption / text: 描述元素的外观,或者指定需要生成的文字
-
bbox: 指定元素在画面中应该占据的区域
举个例子,我希望新版「本周探店推荐」出现在右上方,就可以写: "text": "本周\n探店推荐" "bbox": [-520, 68, -345, 416]
人物则安排在左侧: "label": "character" "bbox": [-510, -435, 285, 80]
接着再分别给商品缩略图、产品名称和活动标签设置自己的区域。 这里使用的是 MOSS-Image 的 abs_centralized 坐标体系,也就是以画布中心为原点。
它的 bbox 顺序是: [y_min, x_min, y_max, x_max] 注意,第一个数字是 Y,不是 X。
比如在 880 × 1168 的画布里,我们就可以根据中心坐标,把标题安排在右上方、人物放在左侧,再让商品信息沿着右侧依次排列。
整个过程有点像在写前端页面:先规划布局,再交给模型完成视觉生成。
第3步:让模型把布局和商业视觉结合起来
当然,JSON 不是简单地给图片画几个方框。
除了元素的位置,还需要在 summary 中描述整张图的视觉风格,比如日系甜品店、樱花粉配色、自然光摄影、时尚杂志排版等。
然后在不同元素的 caption 中,继续约束人物妆造、甜品质感、字体颜色和产品展示形式。
这样模型既能知道每个元素应该放在哪里,也能理解整张海报应该长什么样。
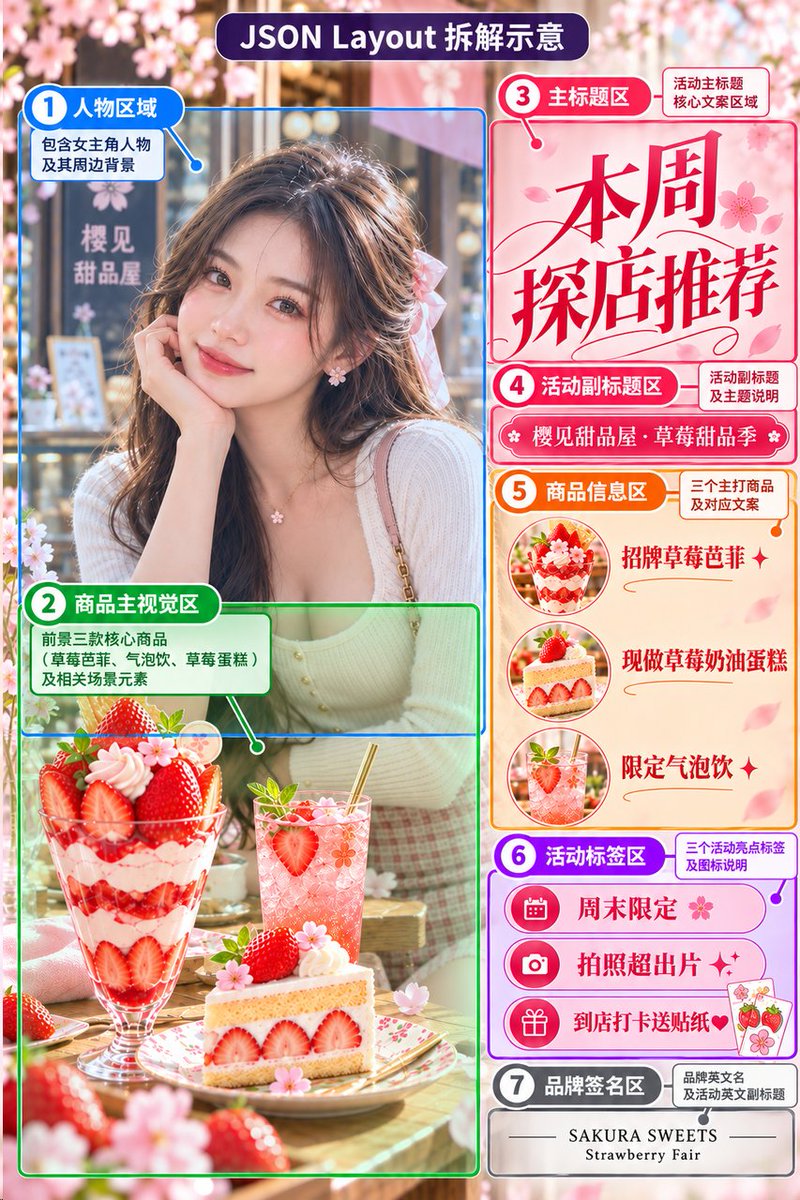
相比普通 Prompt,这种方式最大的不同,是我们可以把原本模糊的排版要求,变成具体的结构化描述。
尤其是制作探店海报、电商商品图、活动宣传图这类信息较多的内容时,可以分别规划各个元素,而不是完全依靠模型自由发挥。
不过这里也要注意: JSON Layout 是生成时的空间约束,不是 PS 那种精确的图层编辑。
从图 1 到图 2,并不是在原图上直接移动几个组件,而是沿用品牌视觉,重新定义元素布局,再生成新的海报。 因此,人物五官、甜品细节和场景也可能发生变化,布局也不一定百分之百符合指定坐标。
但这套方法最吸引我的地方就在于: 以前我们只能告诉 AI「帮我设计一张好看的海报」,现在可以进一步告诉它「这张海报应该怎样排版」。
这才是我觉得 JSON Layout 对商业设计真正有价值的地方。
05. 第三轮:中英文文字直接生成,能不能满足商业需求?
只控制画面布局,还不够。 做商业海报,还有一个非常现实的痛点:文字。尤其是中文! 以前用不少生图模型做中文海报,经常是远看挺高级,放大一看全是奇怪的笔画和错别字。
对于纯视觉作品,这可能不算太严重。但如果是店名、商品名称、活动优惠信息,错一个字都可能影响实际使用。 所以这轮我准备专门测试文字。
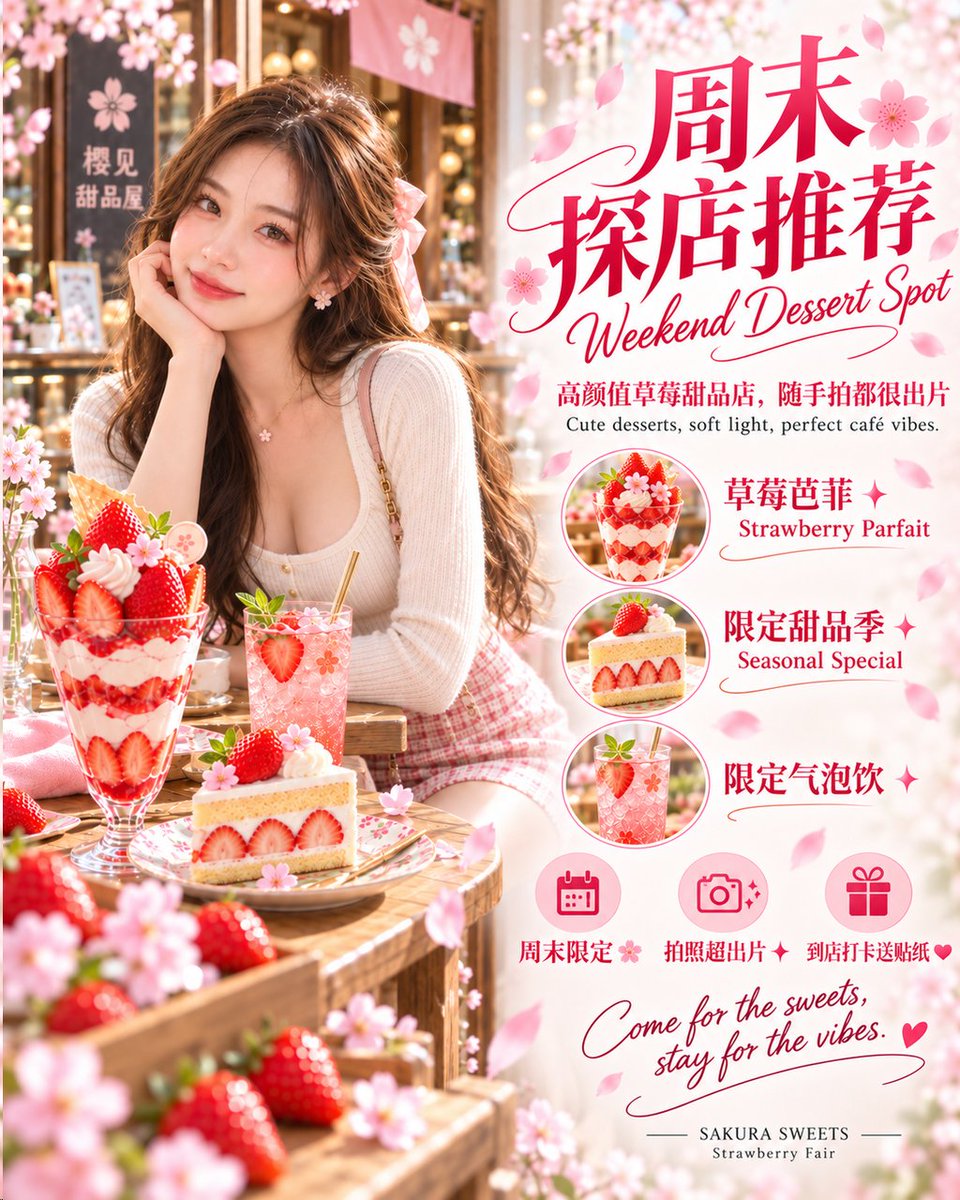
先固定相同的布局结构,再替换文案:
中文版本: 「草莓甜品季」 「周末限定」 英文版本: 「BERRY WEEK」 「WEEKEND ONLY」
重点观察三个方面: 文字正确率: 有没有拼写错误、漏字、额外生成的文字? 版式适配: 文案变长或变短之后,是否仍能放在指定区域? 文字与视觉融合: 字体有没有与背景、人物和产品产生不自然的遮挡?
这里还有一个非常实用的小技巧! 如果要精确控制文字内容,在 JSON 里应该把实际文字放进 text 字段,而不是只写在 caption 里。 因为 caption 主要用来描述它的外观、颜色和字体风格。 官方用户指南也提到,模型支持自动换行,但结果未必完全符合预期;需要控制换行时,可以在文字里主动加入 \n
完整 JSON Layout:
{
 "summary": {
  "meta": ["bilingual social media ad", "Japanese fashion magazine", "dessert campaign"],
  "canvas": "single",
  "caption": "Full-bleed Japanese strawberry cafe campaign. Beautiful 25-year-old adult East Asian model, chestnut wavy hair, pale-pink ribbon, ivory knit top, pink plaid skirt; smiling on left, with strawberry parfait, pink soda and cake foreground. Airy ivory-pink editorial info area at right; crisp red bilingual typography, sakura blossoms, spring light. No mockup, no extra text."
 },
 "items": [
  {
   "label": "character",
   "caption": "Beautiful energetic adult East Asian fashion model, wavy chestnut hair, pink ribbon, rosy makeup, cute smile, ivory knit top, looking at camera.",
   "bbox": [-530, -430, 300, 65]
  },
  {
   "label": "object",
   "caption": "Photorealistic strawberry parfait, strawberry soda and layered strawberry cake on cafe table, lower left.",
   "bbox": [-100, -420, 545, 70]
  },
  {
   "label": "text",
   "text": "周末\n探店推荐",
   "caption": "Very large red Chinese headline with elegant modern brush-like editorial lettering in top-right.",
   "bbox": [-532, 65, -395, 415]
  },
  {
   "label": "text",
   "text": "Weekend Dessert Spot",
   "caption": "Red fashionable cursive English heading under Chinese headline, legible and accurate.",
   "bbox": [-386, 65, -330, 418]
  },
  {
   "label": "text",
   "text": "高颜值草莓甜品店,随手拍都很出片",
   "caption": "Compact clear Chinese subtitle, strawberry-red letters, two short lines if necessary.",
   "bbox": [-309, 68, -251, 415]
  },
  {
   "label": "text",
   "text": "Cute desserts, soft light, perfect café vibes.",
   "caption": "Small black English supporting subtitle, readable.",
   "bbox": [-247, 68, -203, 414]
  },
  {
   "label": "object",
   "caption": "Circular catalog photo thumbnail of strawberry parfait.",
   "bbox": [-185, 68, -96, 155]
  },
  {
   "label": "text",
   "text": "草莓芭菲\nStrawberry Parfait",
   "caption": "Chinese name in larger red type and English translation smaller below.",
   "bbox": [-183, 165, -96, 413]
  },
  {
   "label": "object",
   "caption": "Circular catalog photo thumbnail of strawberry cream cake.",
   "bbox": [-65, 68, 24, 155]
  },
  {
   "label": "text",
   "text": "限定甜品季\nSeasonal Special",
   "caption": "Chinese name in larger red type and English translation smaller below.",
   "bbox": [-60, 165, 26, 413]
  },
  {
   "label": "object",
   "caption": "Circular catalog photo thumbnail of pink strawberry soda with ice.",
   "bbox": [55, 68, 144, 155]
  },
  {
   "label": "text",
   "text": "限定气泡饮",
   "caption": "Larger red Chinese label for sparkling pink soda.",
   "bbox": [60, 165, 142, 413]
  },
  {
   "label": "text",
   "text": "周末限定  ·  拍照超出片\n到店打卡送贴纸",
   "caption": "Three neat pink promotion badges with tiny icons and accurate Chinese wording.",
   "bbox": [190, 65, 289, 415]
  },
  {
   "label": "text",
   "text": "Come for the sweets,\nstay for the vibes.",
   "caption": "Elegant dark-red handwritten italic English closing slogan on two lines.",
   "bbox": [325, 68, 438, 413]
  },
  {
   "label": "text",
   "text": "SAKURA SWEETS\nStrawberry Fair",
   "caption": "Small centered premium English brand signature at very bottom right.",
   "bbox": [478, 80, 545, 404]
  }
 ],
 "bbox_coord_space": "abs_centralized",
 "bbox_format": "yxyx"
}
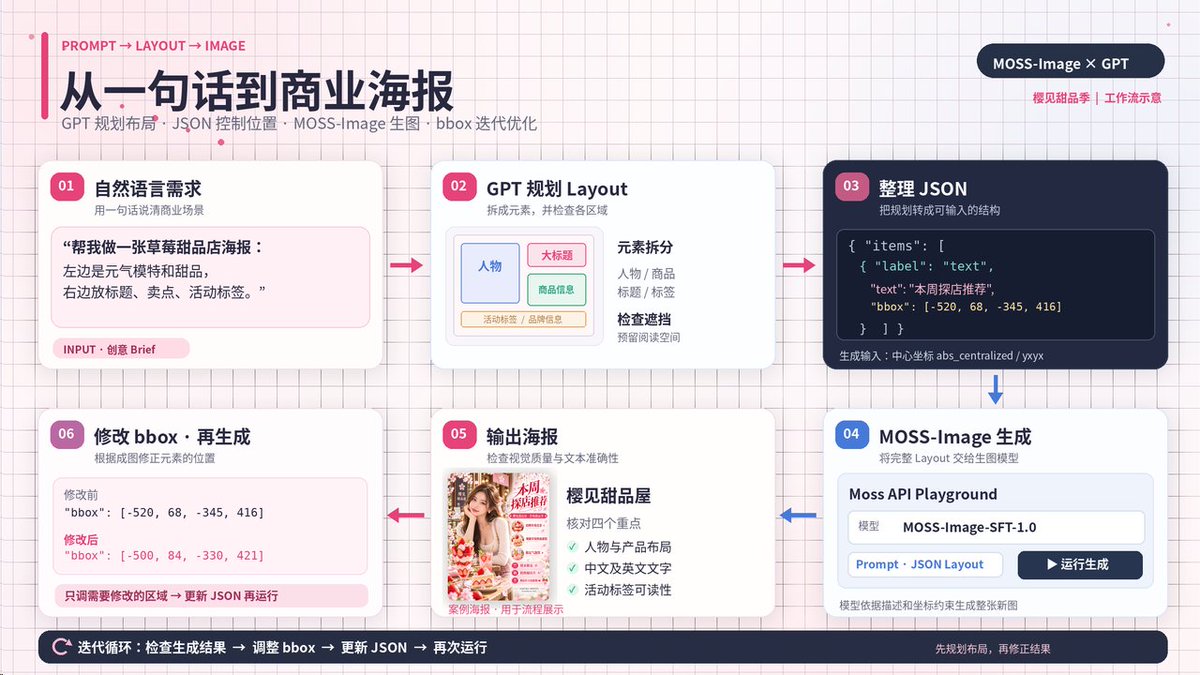
06. 进阶玩法:让 GPT 帮我写 Layout,再交给 MOSS-Image 生图
做完前面的步骤,我觉得还可以把工作流进一步简化。 因为对于普通创作者来说,最麻烦的地方其实不是理解 JSON,而是手动算坐标。 如果每次都要自己去计算文字框、人物框、产品框,时间成本也不低。
所以可以尝试让 GPT 先承担“布局规划师”的角色。
整个流程可以这样设计:
第1步:自然语言提出需求 例如:“帮我设计一张 896 × 1120 的日系草莓甜品店海报,左边是元气成年女性,右边是草莓芭菲,左上方是中文大标题,右上方是英文标题,底部是品牌名称。”
第2步:让 GPT 将需求拆成元素和坐标 GPT 负责规划每个元素的矩形区域,检查是否越界、是否存在明显遮挡,并输出结构化 JSON。
第3步:把 JSON 输入 MOSS-Image 模型负责根据布局描述生成具体的图片
第4步:根据实际输出,修改文字或 bbox,再次生成 这个思路其实很像开发一个简单的设计系统: 自然语言负责提出需求,JSON 负责表达布局,生图模型负责实现视觉。
更有意思的是,MOSS-Image 官方本身已经提供了一个开源的 Prompt Enhancer Skill。 它可以把图像创意整理成详细 Prompt 或结构化 Layout,并提供坐标转换脚本。
不过这里需要注意:官方 Skill 的草稿格式使用 xyxy、左上角原点,而直接给 MOSS-Image 生成时使用 yxyx、中心原点。
两者不是可以直接混用的格式,需要经过转换。
另外,Prompt Enhancer Skill 本身不会帮你生成图片,它主要解决的是提示词整理和布局编译。
项目地址👇 https://github.com/OpenMOSS/MOSS-Image/tree/main/skills/moss-image-prompt-enhancer
07. 这套方法,真正有价值的应用在哪里?
我觉得 MOSS-Image 的 Layout 能力很值得做商业应用探索。
尤其是那些既需要视觉吸引力,又有明确排版要求的内容。
比如咖啡店每个月的新品宣传。
同样一套品牌风格,需要反复更换产品名称、活动文案、价格和促销信息。
又比如跨境电商,一个产品需要制作中文、英文甚至更多语言的广告素材,还要适配不同平台的图片尺寸。
再比如自媒体内容生产,推文封面、小红书封面、活动预告、教程信息图,都有一些相对固定的视觉元素和排版规范。
对于这些场景,如果能够通过结构化 Layout 减少构图试错,意义就不仅是生成几张漂亮图片了。
当然,目前的 Layout 控制仍然是实验性能力,它不意味着可以完全跳过文字校对、品牌规范审查和最终设计检查。尤其是价格、优惠条件、产品规格等不能出错的商业信息,仍然需要人工确认。
但我觉得这个方向非常值得关注: AI 生图正在尝试从“描述我想要什么画面”,进一步走向“明确规定画面应该怎样组织”。
这可能是比单纯堆参数、卷分辨率更贴近实际生产需求的一步。
08. 最后,附上体验入口和开源资源
如果你平时也会做海报、社媒封面、电商视觉,或者想研究结构化生图,可以直接拿这次的思路去测试自己的案例。
在线体验👉 https://platform.mosi.cn/?utm_0=muaqAv
MOSS-Image GitHub👉 https://github.com/OpenMOSS/MOSS-Image
Hugging Face 👉 https://huggingface.co/spaces/OpenMOSS-Team/MOSS-Image
我的建议是,先从元素较少的海报开始,只放一个人物、一个产品、两到三个文字区域,确认布局工作正常,再逐步增加复杂信息。
最值得做的也不只是比较哪张好看,而是认真观察:每次修改输入,模型到底执行了多少我们的设计意图?
你们觉得以后 AI 商业设计的核心能力,会不会从写 Prompt,慢慢发展到管理一套结构化的视觉 Layout?
如果以后连这些布局信息都能复用,那确实有点像用代码设计海报了。
这里是麻酱AI实验室 @zhongying14 ,主要关注 AI 应用、运营提效、AI SaaS 站、AI人像图片和视频的实操路径。持续分享我自己正在验证的方法、踩过的坑,以及普通人也能直接上手的经验。感兴趣的话,欢迎关注,一起边学边做
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


