
5B 参数就能做到这种效果?开源生图模型太卷了!
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
大家好,我是李岳。
最近抖音上的AI大模型拟人化视频非常火,特别是Claude和DeepSeek的拟人形象,太好磕了。
于是我也想着给他们设定一下人物形象,拿来做AI视频的人物参考图。
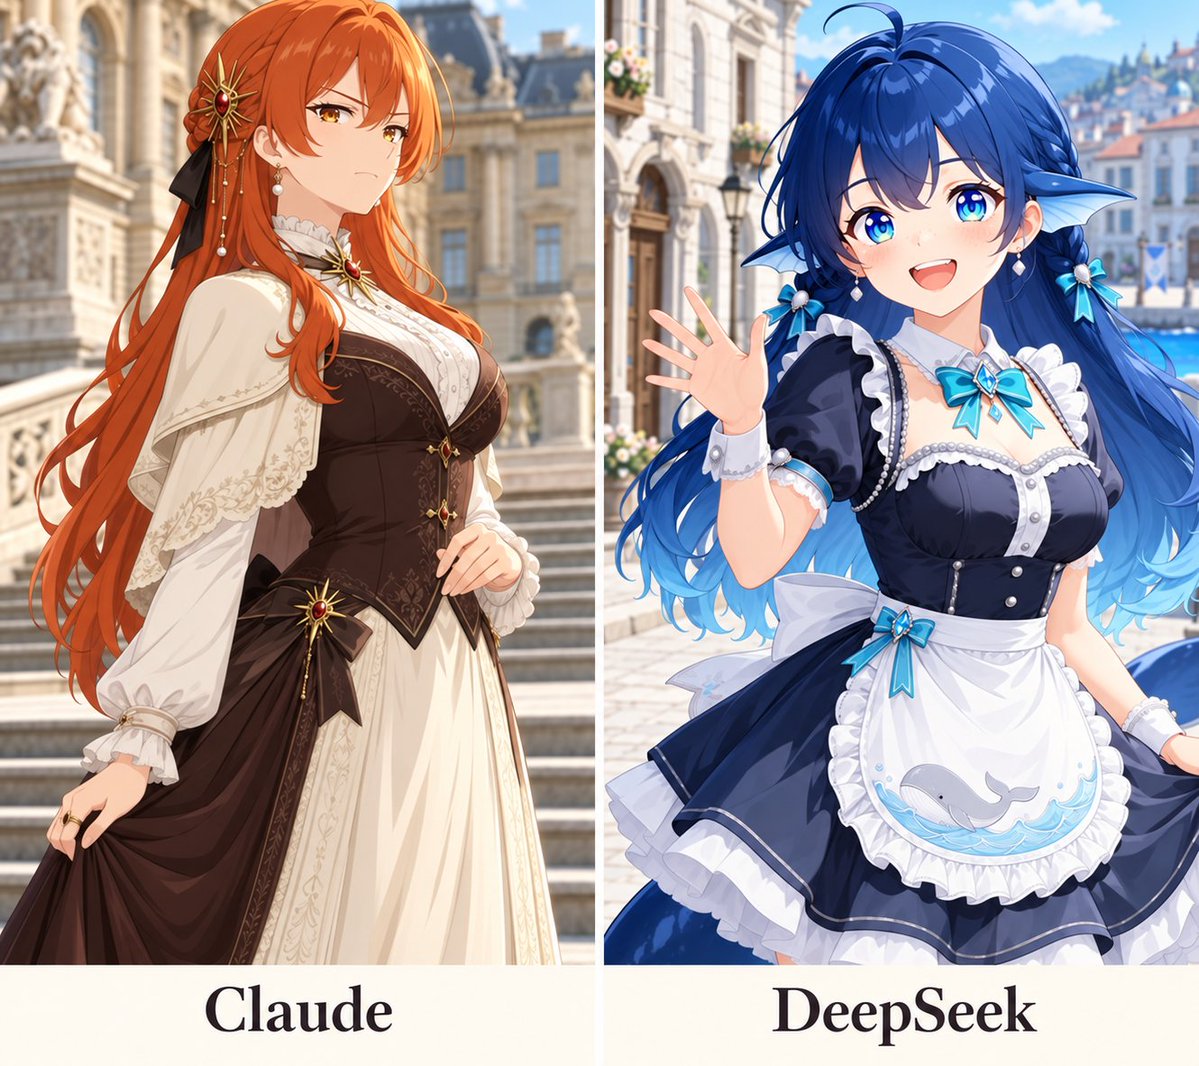
这次我尝试用模思智能(MOSS)开源的图像生成模型 MOSS-Image,把这两个想法做成了图,也想看看目前开源的生图模型纠结进化到什么程度了。
先说结论:做完最直接的感受就是生成超级快,画面质量也很高。
两张成图、设计思路和完整提示词,我都放在下面。
想给自己喜欢的 AI 设计一个形象,可以直接拿去试。
人物形象设计思路
我给 Claude 选了橙色、深棕色和奶油色。
橙色想必大家都知道这是来源Claude的logo配色,奶油白则是它的背景色,加上深棕色让服装裁剪的更加符合人物身份。
这套配色指向的气质是温暖、沉稳,带一点复古感。
DeepSeek 的蓝色和鲸鱼,很适合延伸成一套海洋主题的角色设计。 蓝色是DeepSeek经典配色,加上这一套女仆活泼的形象,非常贴合DeepSeek的模型设定。
提示词该如何写
做拟人形象时,先把角色的视觉特点想清楚,提示词就有了方向。
把这两份提示词拆开看,其实都能找到同一条线:颜色、外形、服装、表情动作,再到人物所处的环境。
写提示词有点像给角色准备一张设定单。每加一个细节,都想一想:它能不能让这个角色更鲜明?
这也是我觉得这次尝试好玩的地方。平时我们认识一个 AI,靠的是名字、Logo,以及聊天窗口里的回答。做成拟人形象以后,就能用另一种方式表达自己对它的印象。
MOSS Image也想到了这一点,他们推出了一个适配MOSS Image的提示词增强Skill,可以用来辅助用户创作,而不需要一个一个的去写提示词。
如果你不知道该怎么写提示词,完全可以借助MOSS-Image里的Prompt Enhance功能。
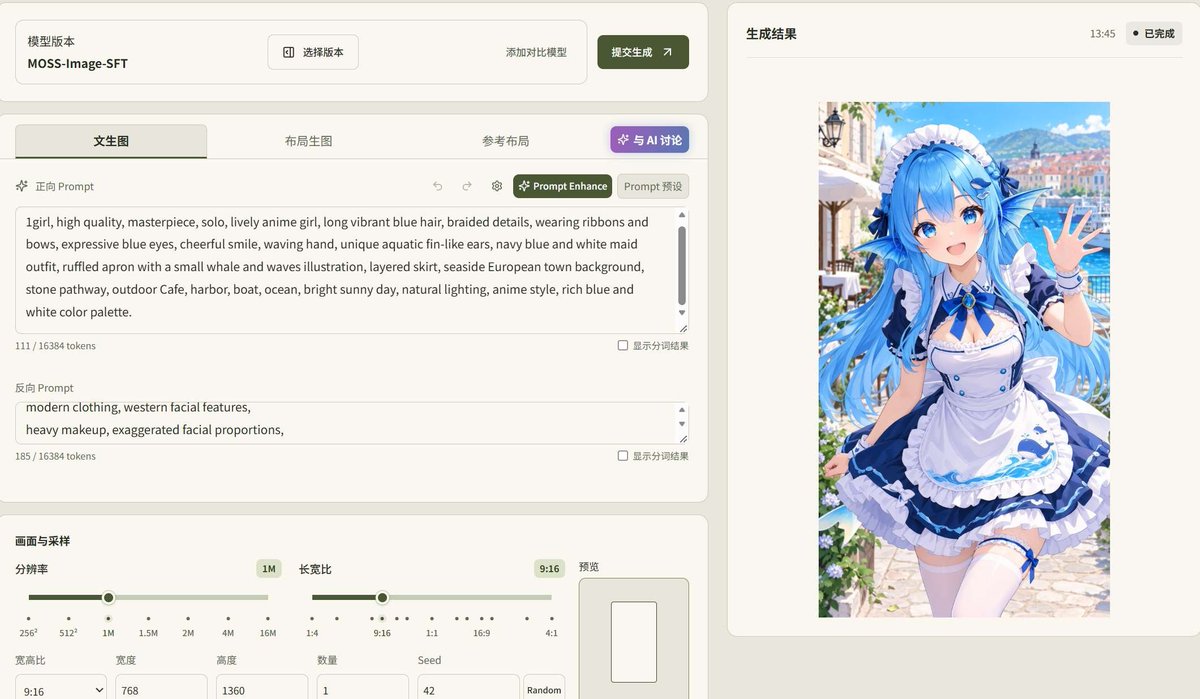
例如我这里写了一段简单的中文描述: 一只拟人化的DeepSeek二次元少女,可爱,充满活力,有鲸鱼尾巴,女仆装站在海边小镇上微笑
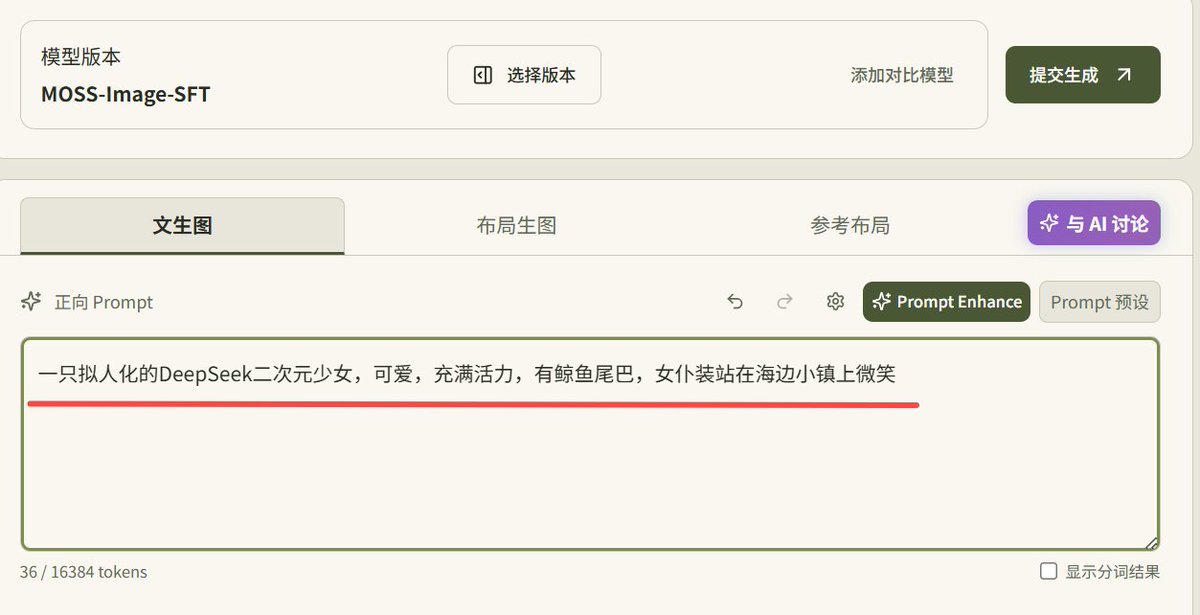
点击这个“Prompt Enhance”按钮,就可以自动生成下面这段提示词了,然后点提交生成就搞定了。
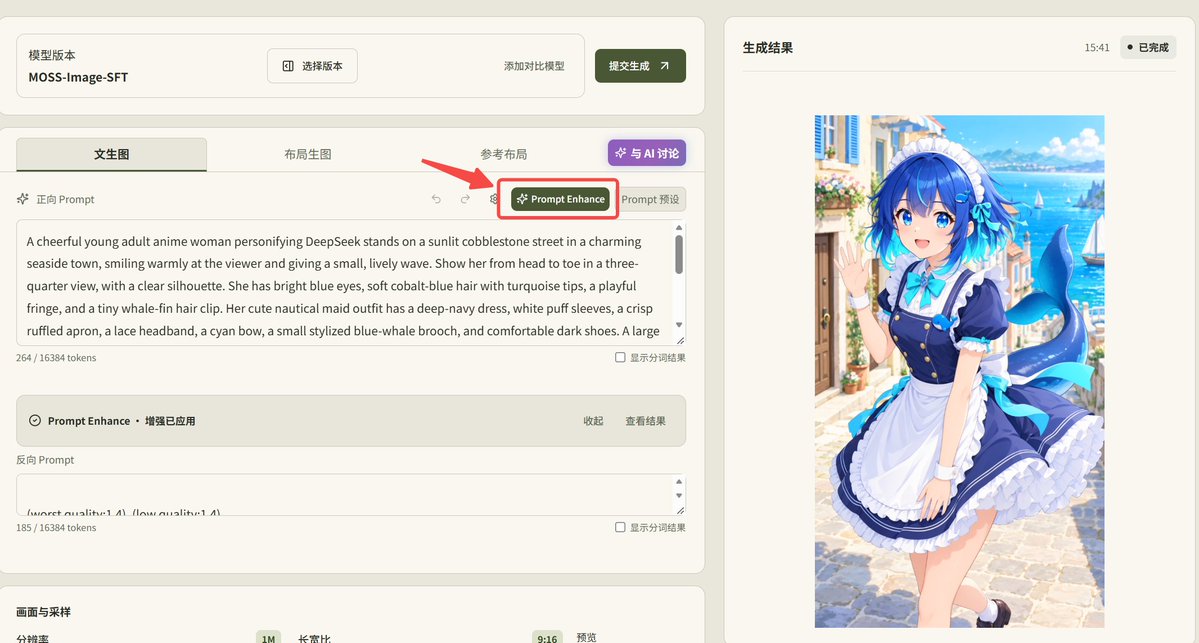
这是Prompt Enhance对应提示词的图片效果,怎么感觉比我自己设计的效果还好?
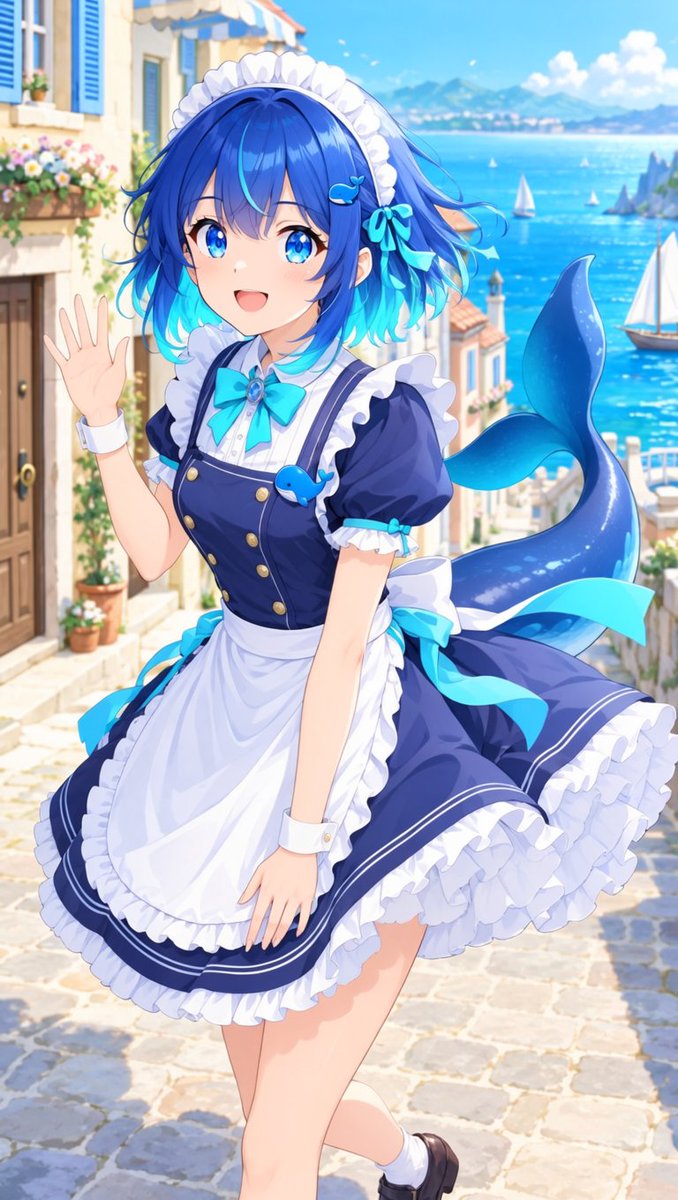
MOSS-Image出图又快又准
我这次一个很明显的感受是快和准。
这里的“快”,是我做这两张图时最直观的体感。对我来说,速度和画面质量同时让人满意,这个体验就很加分。
可以看下视频中图片生成的效果,没有做任何加速。
不知道有没有用过Stable Differen或者ComfyUI的兄弟,那生图步数决定了你的生图效率,生图步数越多生成的速度越慢,MOSS-Image这速度绝对比他们快不止一两倍。
做角色设计的时候,脑子里经常会冒出新想法:头发换个颜色会怎样,服装再复古一点会怎样,背景从建筑换成海边又会怎样。
出图反馈快,尝试这些变化就更有动力。你能顺着当下的想法继续做下去。
除了速度快,能生成正确的中文也是很多开源生图模型不能比拟的,强如Flux也会经常生成错误或者模糊的中文文字。
做封面、海报或者产品介绍图,经常会需要把字直接放进画面。MOSS-Image 支持中英文文字渲染。
比如,给角色做一张带名字和介绍的海报,就可以进一步尝试这项能力。具体文案生成后,逐字检查一遍,也方便决定哪些部分直接使用、哪些部分再调整。
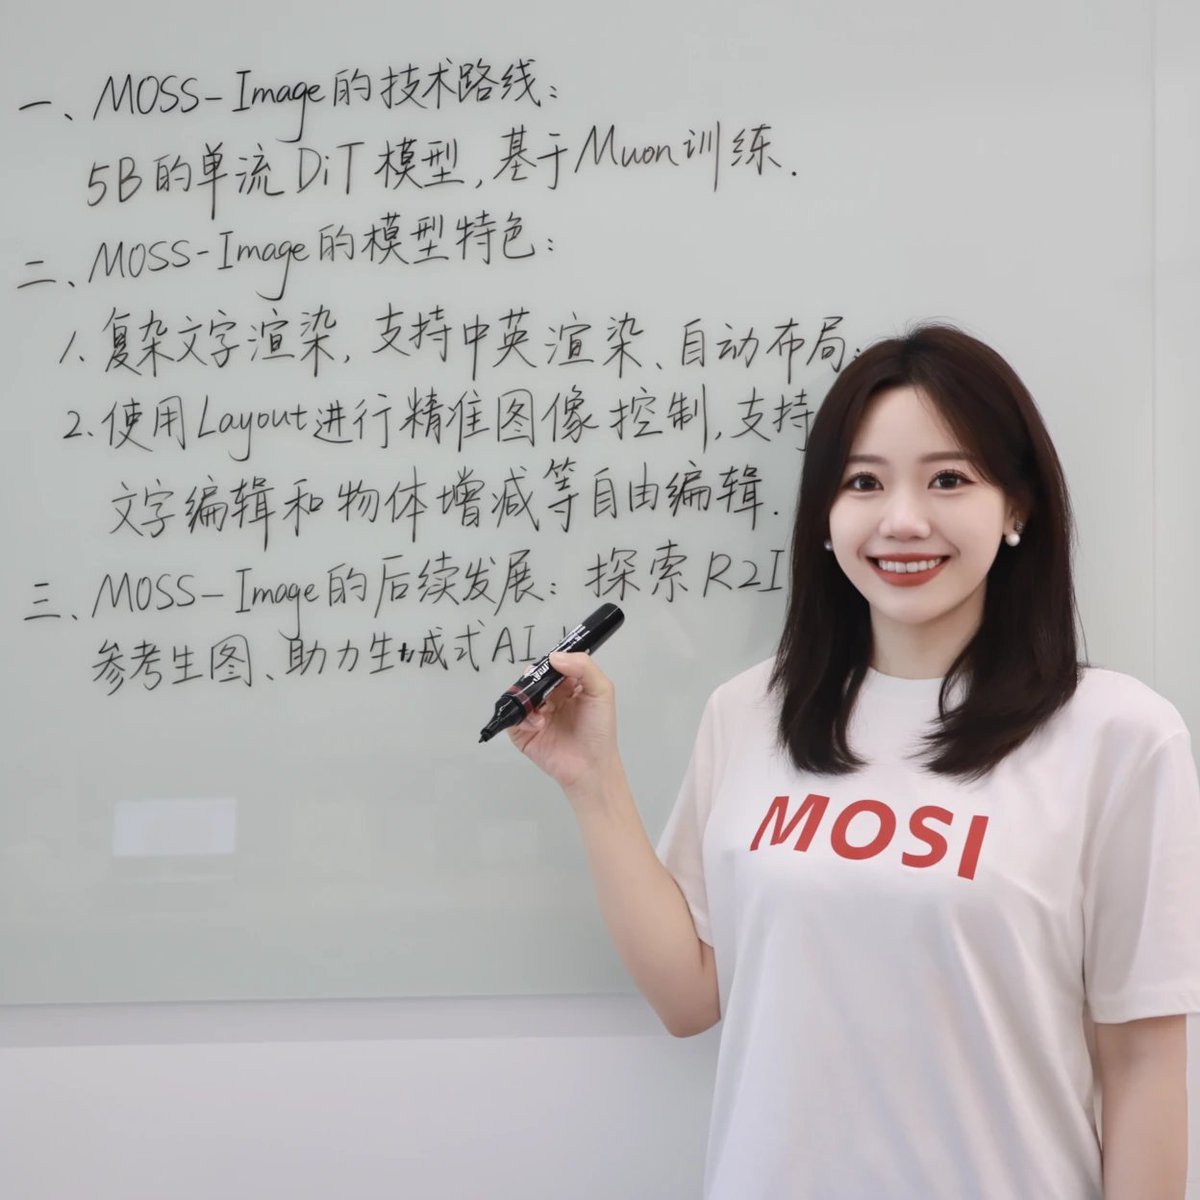
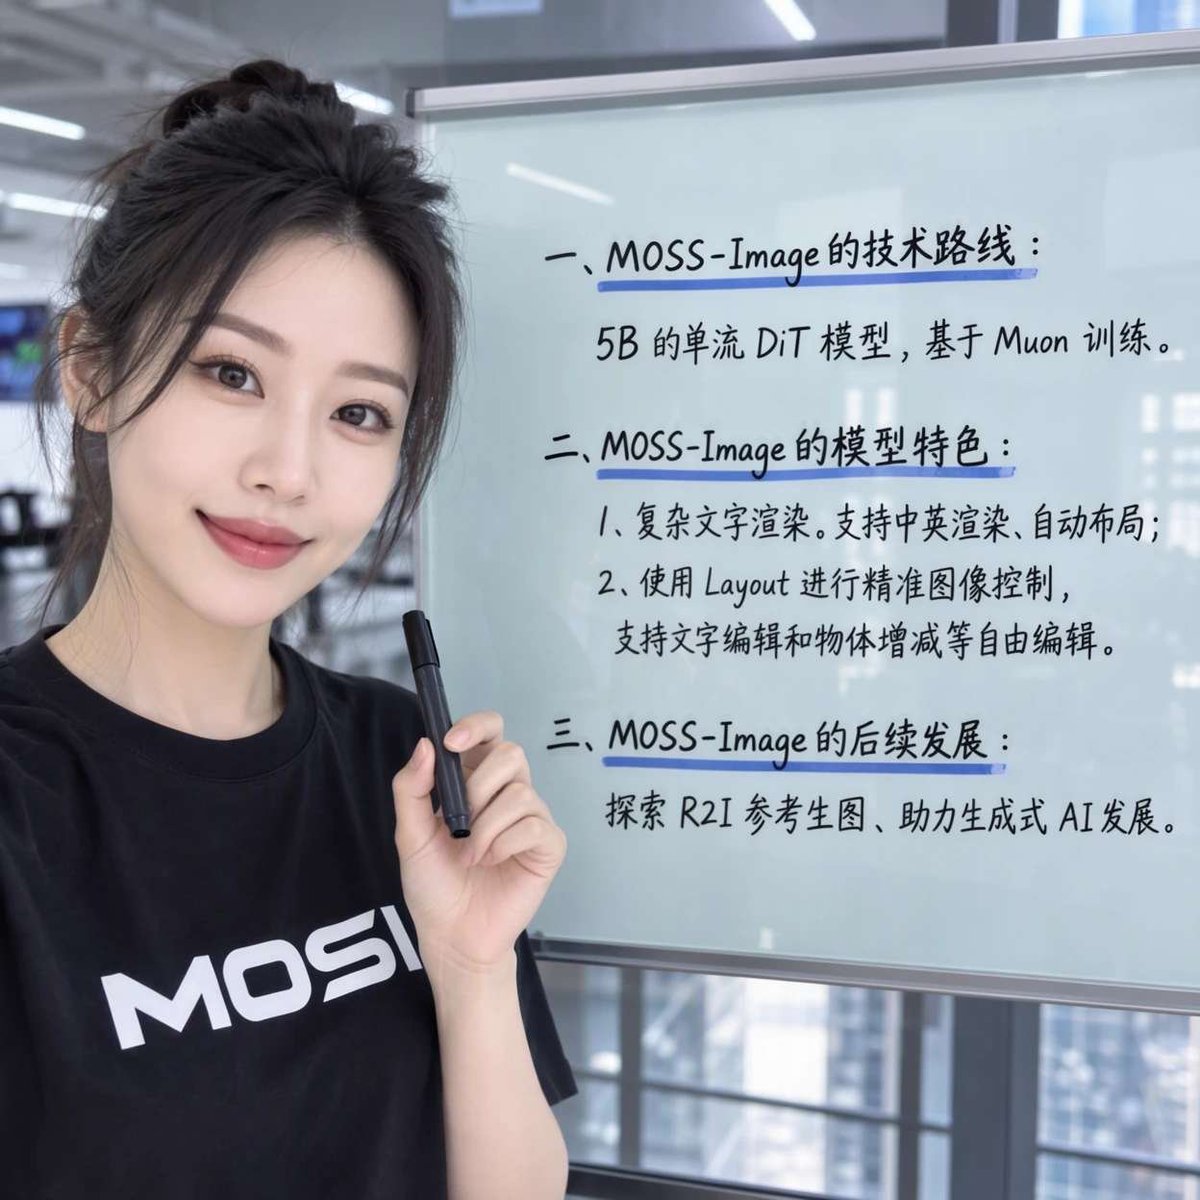
另一个是 JSON Layout 布局控制
简单理解,就是把画面里有哪些元素、各自放在哪里,写得更明确。模型支持通过结构化 JSON 描述文字和视觉元素,并指定它们的位置。
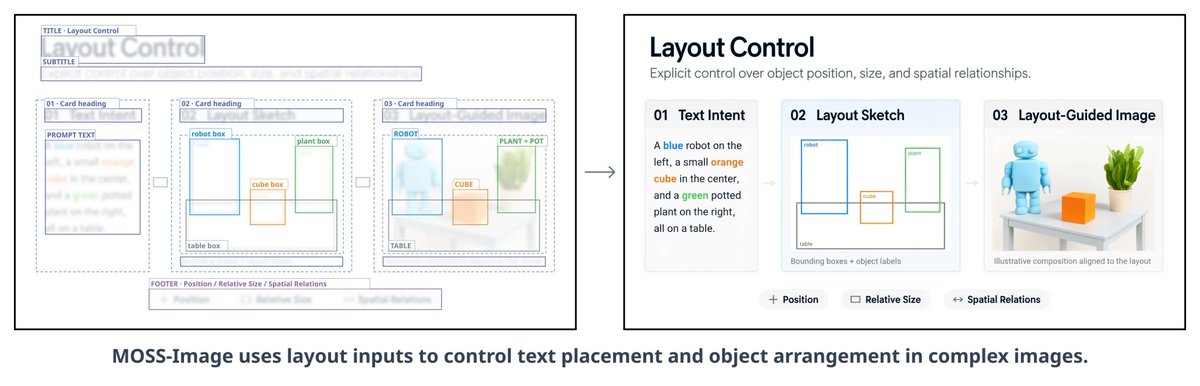
假设要把 DeepSeek 的拟人形象延伸成一张海报,我可以尝试这样安排:人物放右侧,左上留给标题,左下放介绍,背景继续使用海洋元素。
这个例子说的是下一步可以尝试的设计方向。前面两张拟人图,展示的是这次的角色创作效果。
对广告海报、电商产品图、社媒封面来说,画面中要同时容纳人物、产品和文字。能提前安排这些元素的位置,就多了一种控制构图的方式。
MOSS-Image模型其它特点
除了上面几个优点,MOSS-Image还有以下几个特点。
MOSS-Image 的 DiT 主干网络为 5B 参数规模,支持动漫、插画、照片级写实等多种视觉风格,我这次选的是动漫方向。
根据Github上的资料,它还采用了国产 PPU 算力平台进行训练。这个背景,也让我对它多了一份关注。
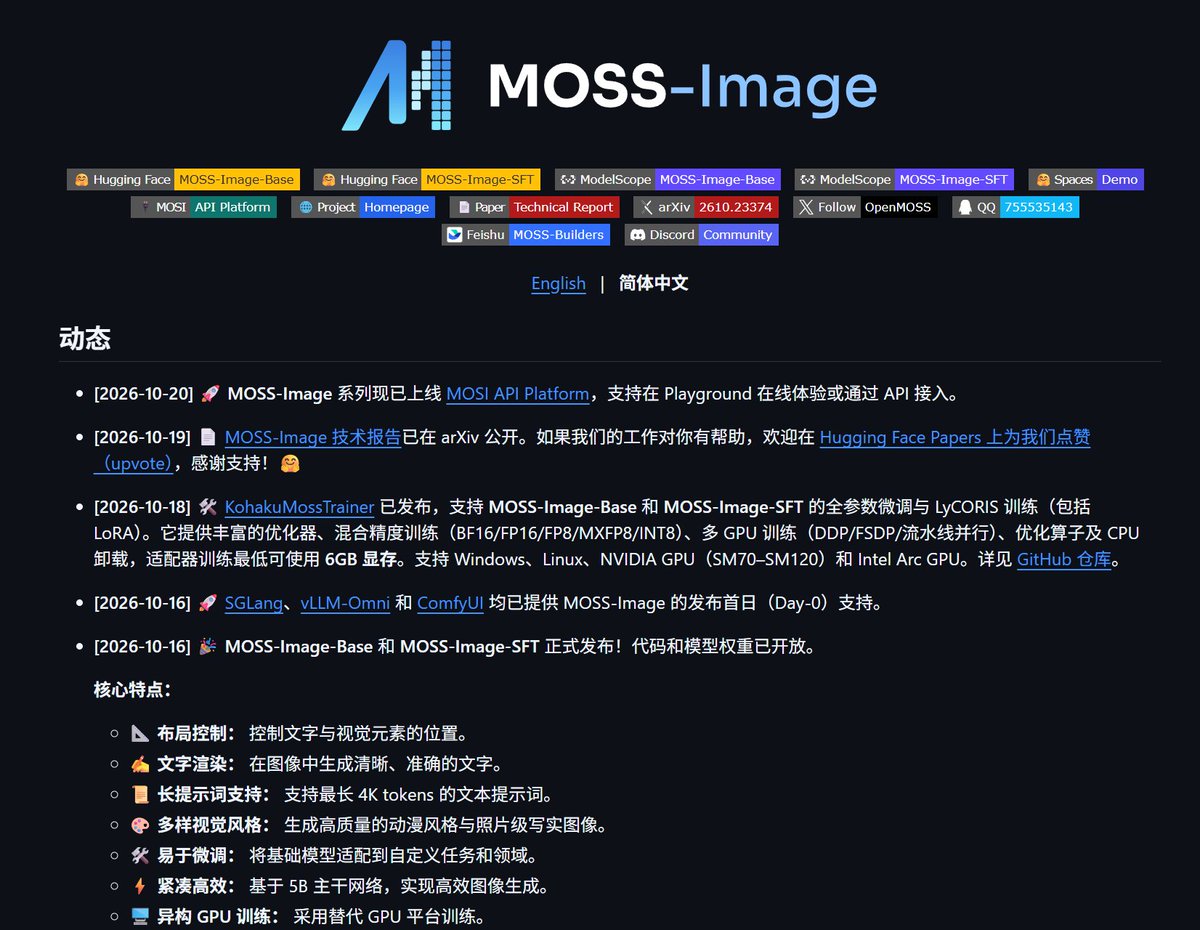
此外MOSS-Image 还支持最长 4K tokens 的提示词。
这给复杂场景留出了描述空间:人物是什么样、穿什么、做什么动作、站在哪里,都可以交代得更完整。
我自己的写法还是会先抓住最重要的设定。
比如 DeepSeek 这张,蓝白配色、海洋元素和活泼的状态,就是整份描述的中心。
其他细节围绕它们展开,方向会更清楚。
两份完整提示词
下面是这次使用的两份完整提示词。
Claude:
1girl, high quality, masterpiece, solo, orange hair,
 long wavy hair, looking at viewer, expressive determined gaze,
 elegant Victorian-inspired gown, dark brown corset bodice
with gold embroidery, cream-colored ruffled undershirt,
oluminous dark brown layered skirt with intricate gold patterns over
a cream petticoat, decorative gold brooch at collar and waist,
 bow in hair, earrings, outdoor setting, grand European historical building,
stone staircase, balustrades, architectural details, sunny day,
natural lighting, cinematic composition, anime style,
rich warm colors.
DeepSeek:
1girl, high quality, masterpiece, solo, lively anime girl,
 long vibrant blue hair, braided details, wearing ribbons and bows,
expressive blue eyes, cheerful smile, waving hand,
unique aquatic fin-like ears, navy blue and white maid outfit,
ruffled apron with a small whale and waves illustration,
 layered skirt, seaside European town background,
stone pathway, outdoor Cafe, harbor, boat, ocean,
bright sunny day, natural lighting, anime style,
rich blue and white color palette.
想自己试,可以从官方 Hugging Face 体验页入手,把上面的提示词复制进去生成,看看你会得到怎样的角色。
也可以只改其中一个部分。保留 Claude 的配色,给她换一套现代服装;或者保留 DeepSeek 的鲸鱼元素,把场景换成水族馆。每次集中改一处,更容易看出变化来自哪里。
如果想继续做微调或者接入自己的工作流,项目也已经开放了 Base 和 SFT 两个版本的模型权重,以及代码和使用指南。
Base 是基础文生图模型,SFT 则是在精选数据上进一步微调的版本。SGLang 和 vLLM-Omni 也提供了发布首日支持。
对我来说,这次先从两个熟悉的 AI 入手,就已经玩出了乐趣。
一个走暖色复古路线,一个走蓝色海洋路线。同样的创作主题,可以长出完全不同的角色设定。
MOSS-Image 这次的生成速度和画面质量,也让我愿意继续尝试更多想法。
提示词已经放出来了,点开体验链接。
API平台 https://platform.mosi.cn/?utm_0=muaqAv
目前可以免费体验。


