
AI名人换脸从 0 到 1 小白教程
文章目录
前几天我做的马斯克《流星雨》爆火,看完这篇文章,你可以让道明寺爱上花泽类。
完整的换脸工作流架构
一部片子从开工到结束,所有东西都按顺序放在下面这几个文件夹里。
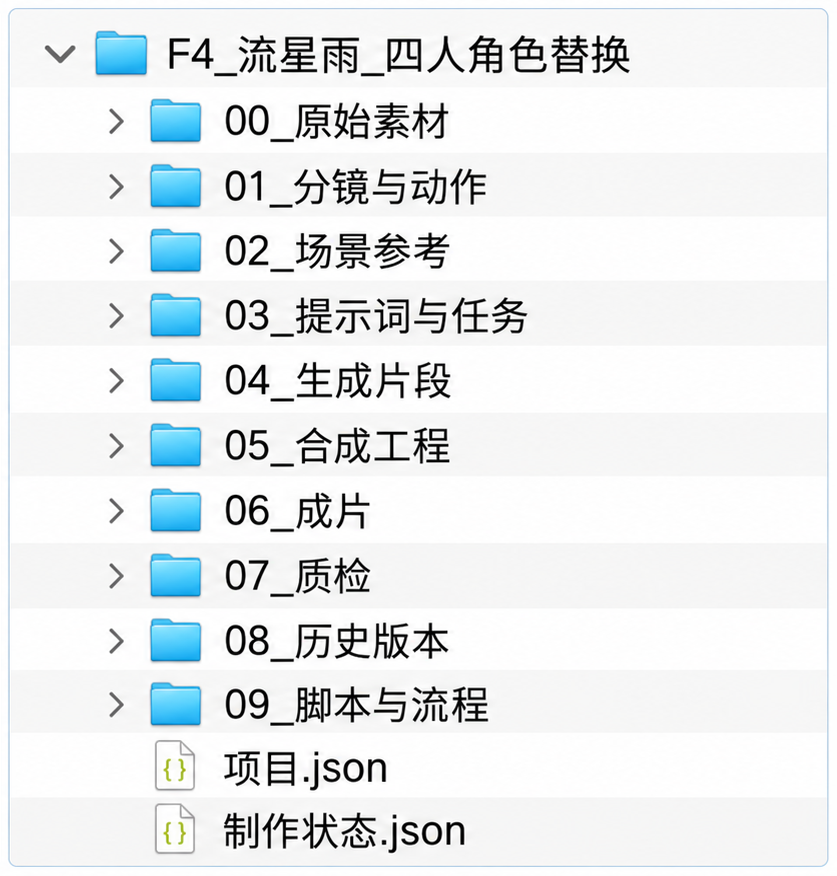
第一步,原始素材
是什么:
一切从原片开始,对应 00_原始素材 文件夹。
先说一个后面老会提到的词,帧。
视频其实就是一张张图片快速连着播,每一张就叫一帧。
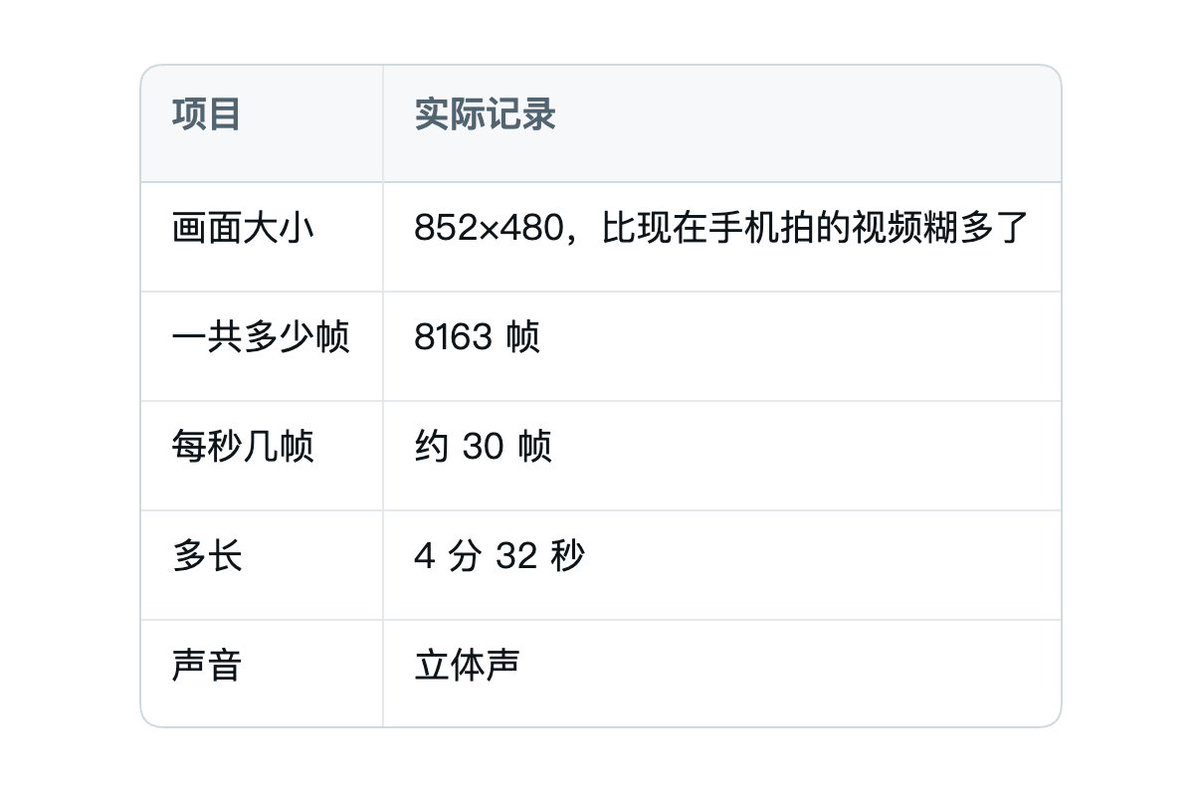
以流星雨为例,整支 MV 一共 8163 帧。
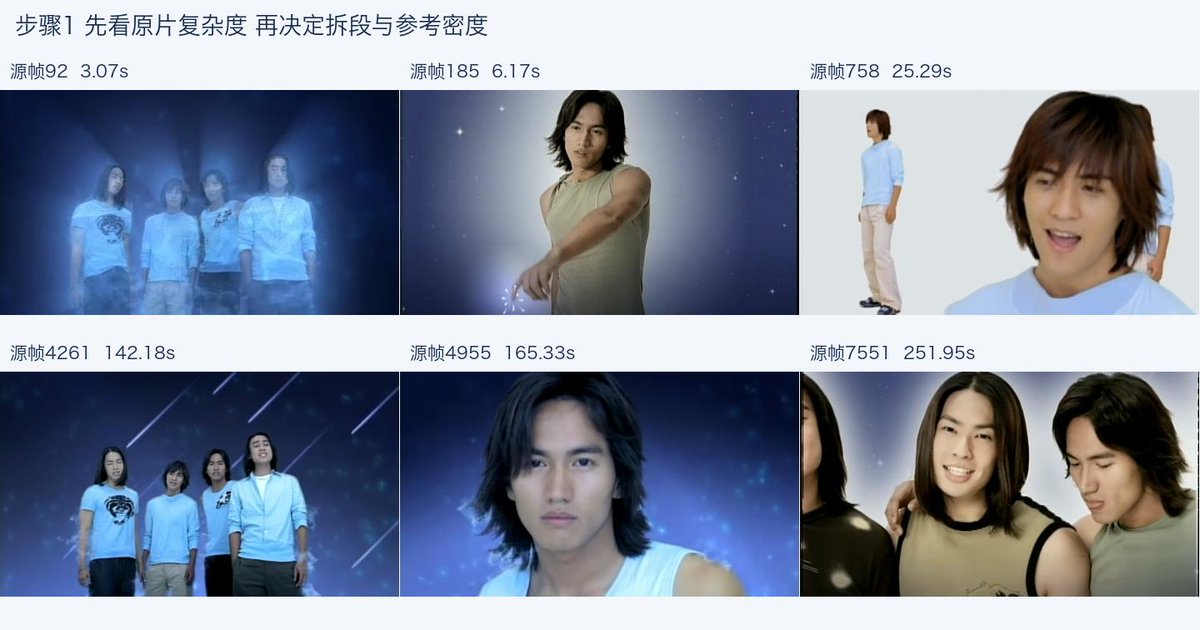
这一步要干的,就是把官方完整版 MV 放进来,把它的底细摸清楚,记到一份信息文件里。
做完以后,文件夹里就两个文件,MV 本身和这份信息文件。
怎么做:
-
下载官方完整版 MV 放进来,这次用的是 4 分 32 秒的完整版。
-
用 ffprobe 这个工具,读出它一共多少帧、每秒几帧、声音是什么格式。
-
用 shasum 算一个校验码,相当于给文件按个指纹,以后拿错文件一对就知道。
-
从头到尾看一遍原片,记下哪些镜头难搞,比如好几个人同框、带手势特效的、脸怼得很近的特写。
注意点:
别信播放器上显示的时长。播放器会四舍五入,要以工具读出来的帧数为准。
别拿短版本凑合。最早做过一个 30 秒的副歌小样,正式做必须换成完整版,不然后面的帧号全对不上。
帧号从 0 开始数。第一张画面叫第 0 帧,不叫第 1 帧。两段视频交界的那一帧,只能算给其中一段,不然拼起来会多出一帧。
第二步,拆镜头、定角色
是什么:
原片定好了,接下来要拍板两件事,谁演谁,整支 MV 切成哪几段。
对应 01_分镜与动作 文件夹,里面就 6 份记录文件,没有图也没有视频。
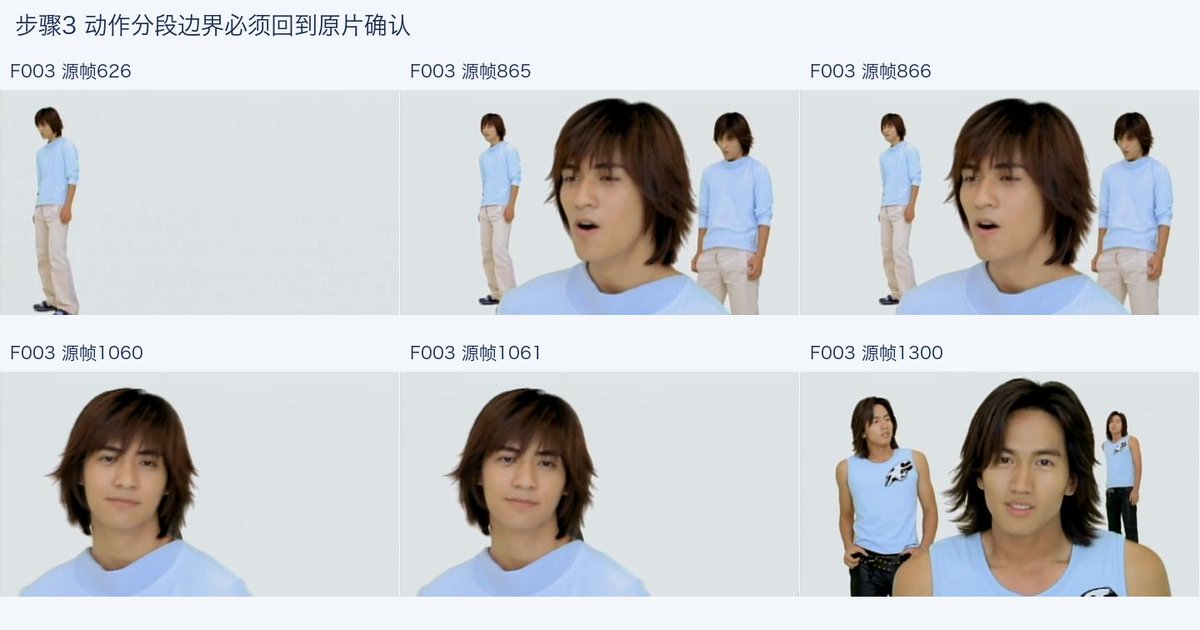
简单讲,就是让 AI 把整支 MV 剪成一小段一小段,在动作停顿的地方下刀,然后一段一段换人。
怎么做:
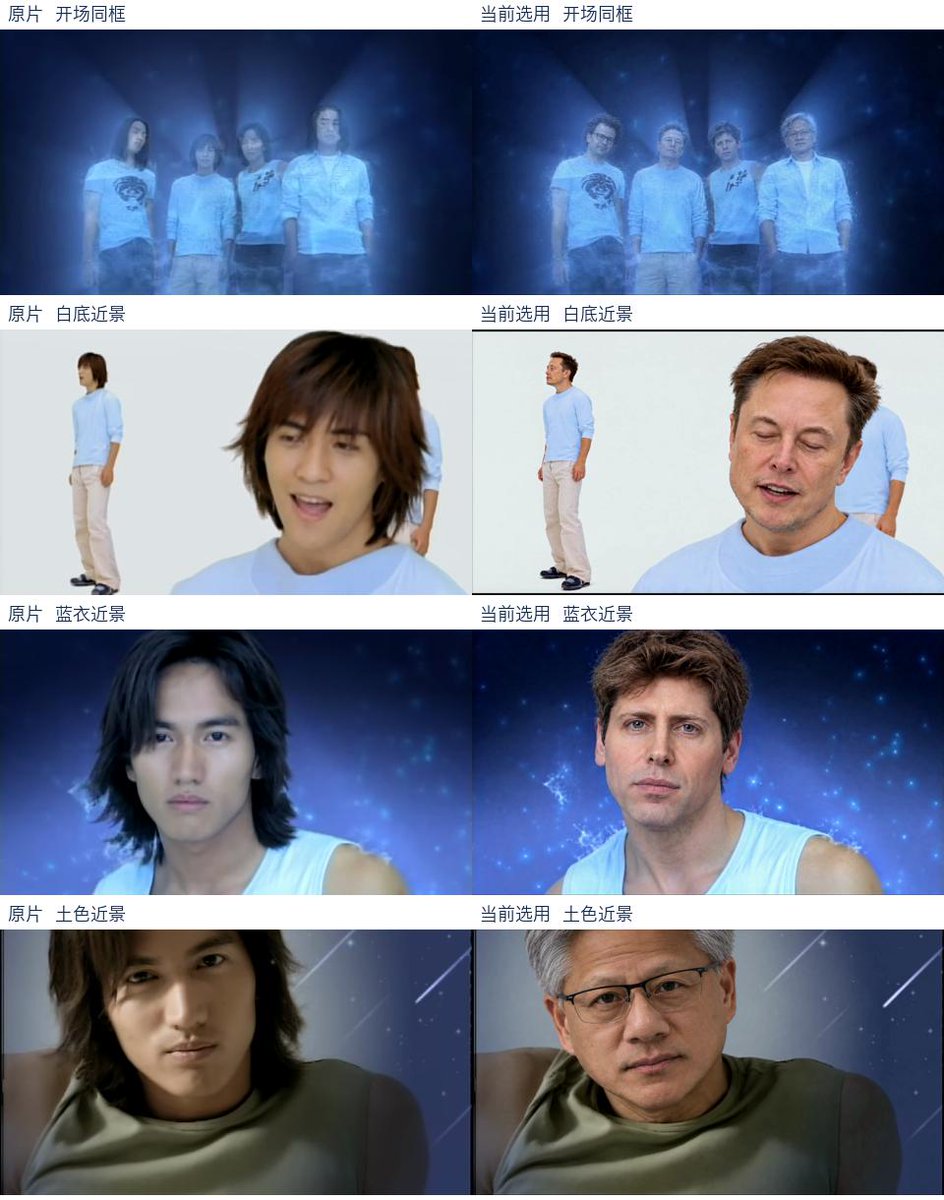
- 定好谁演谁。言承旭换黄仁勋,周渝民换马斯克,朱孝天换 Sam Altman,吴建豪换 Dario Amodei。
-
让机器自动找切点。切点就是在哪儿下刀。机器先找出 41 个可能的切点,再把灵敏度调低跑一遍,捞回漏掉的。
-
人工再看一遍切点。原片里有拼贴、卡片翻转、渐变转场这些花活,机器很容易切错,每个切点前后几帧都得亲眼看看。
-
长镜头按动作再拆小。模型一次只能生成一小段,这次最长的一段也就 10 秒出头,比如有一个 40 多秒的长镜头,就拆成了六小段。
-
写执行计划,每一段都写清楚谁出场、穿什么、从第几帧到第几帧、参考哪几帧。
注意点:
按动作切,别按秒数切。像抬手摸脸这种动作,要是从中间切开,接起来手会突然跳一下。
机器找的切点只能当参考。41 个候选,最后变成了 54 段,以执行计划为准。
好几个人同框,先认位置再认人。光写四个名字不够,要写清楚谁穿哪件衣服、站在画面哪边、挡住了谁。
检查记录都存在 07。切点为什么这么切,相关记录放在 07_质检 里,回头随时能查阅。
第三步,每个镜头先做剧照
是什么:
知道谁演谁、怎么切以后,先别急着生成视频。
对应 02_场景参考 文件夹,这一步先给每个镜头做几张换好人的静态图,也就是剧照。
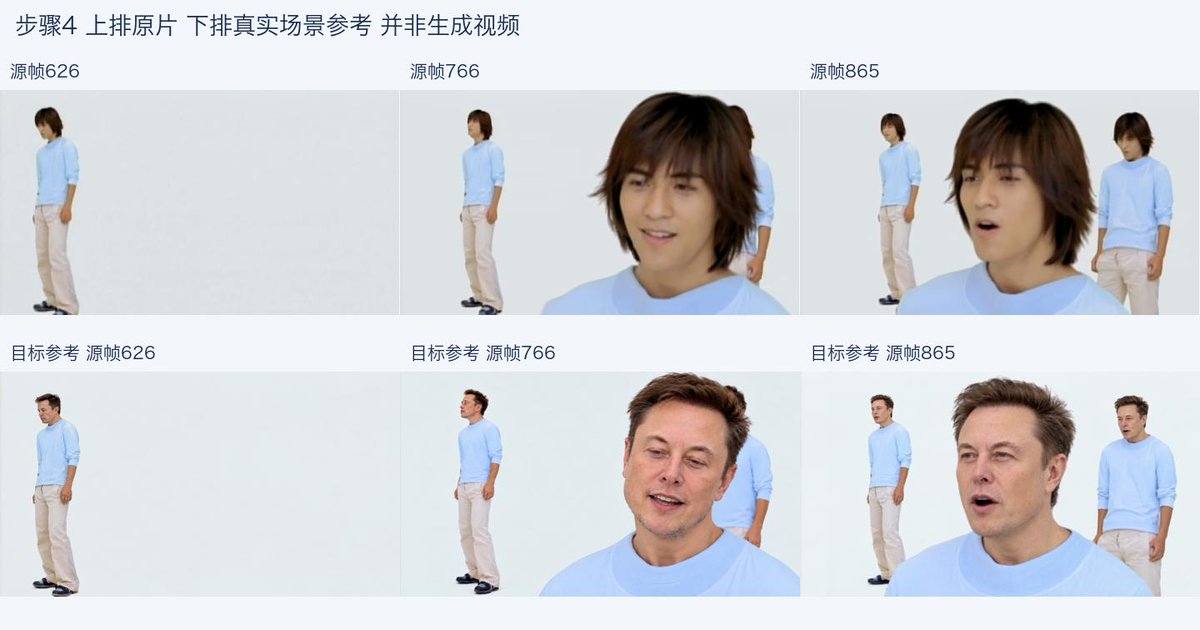
上排是原片,下排是 AI 做的剧照。这时候还没开始生成视频,脸、衣服、站位先在图上对一遍。
每个镜头一个小文件夹,里面放着原片截图和换好人的剧照,还有一份记录,写着每张图对应原片的哪一帧、检查过没有。
怎么做:
-
从原片截图。每段至少截开头、中间、结尾三张,动作变化大的地方多截几张。
-
让 AI 做换人剧照。构图、背景、站位、衣服都照原片来,只把人换掉。
-
一张张检查。脸、衣服、头发、头型、手指、姿势、谁挡着谁,都得跟原片对得上。
-
合格的标上通过,不合格的写下原因,再做一版。
注意点:
先出图,再出视频。图上一眼能看出来的问题,别等视频跑了一个多小时才发现。
别看文件名,要看图。文件名写着“中间帧”,不代表这张图就合格,得亲眼看过。
定妆照和剧照别混着用。定妆照只管脸,衣服和站位看这里的剧照。
补图能救一部分,救不了全部。后面要讲的马斯克早闭眼,就是补了图也没完全修好。
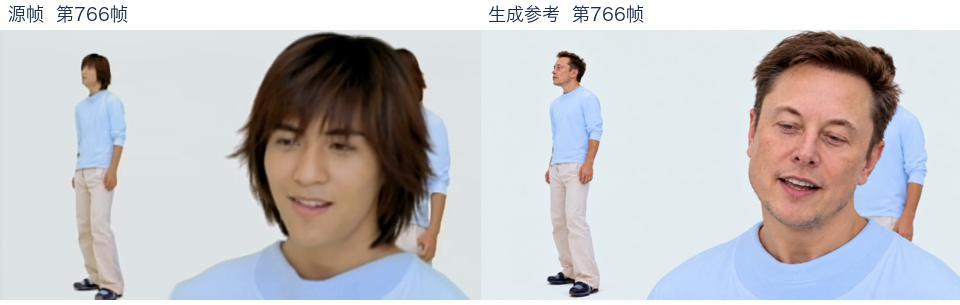
左边是原片里的一帧,右边是专门补的半睁眼剧照。仔细看,剧照的头部角度和嘴张开的大小,跟原片还是有点差别。
第四步,把要喂给模型的东西打包
是什么:
剧照过关了,就可以准备生成视频了。对应 03_提示词与任务 文件夹。
打个比方,上一步是备菜,这一步就是把菜配好、装盘,准备下锅。顺便说一下,文件夹名里的提示词,就是你写给 AI 的文字要求。
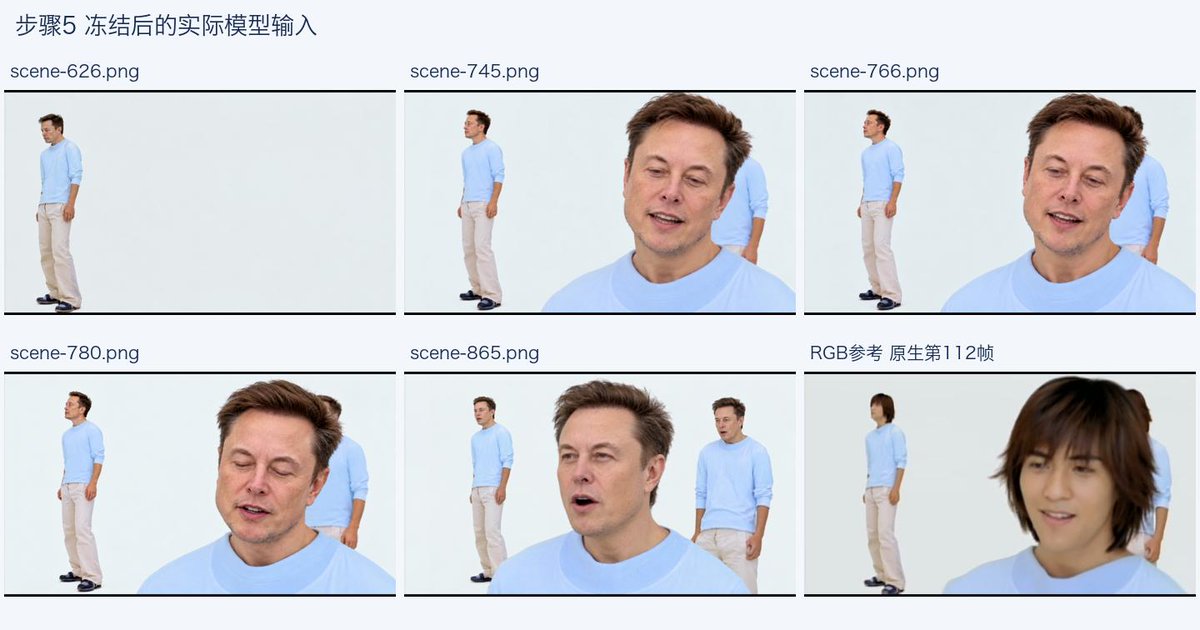
这就是一个镜头真正喂给模型的东西。
一个包里有这么几样。几张调好尺寸的剧照。
一小段原片视频,让模型照着学动作。
一份写给模型的动作说明。
一份 ComfyUI 工作流文件。
ComfyUI 是一个搭积木式的 AI 软件,工作流就是搭好的积木,相当于这次生成的操作说明书。
还有一张清单,记着包里每个文件的指纹。
怎么做:
-
把剧照缩成模型要的尺寸。模型分两轮画,先画小图再画大图,所以要准备两个尺寸,第一轮 1280×736,第二轮 1920×1088。
-
把原片这一小段转成每秒 24 帧的参考视频。
-
写动作说明。看着画面写,谁在张嘴、谁在闭眼、头往哪边转、手什么时候抬。
-
如果这一段要接着上一段,就把上一段真正生成出来的最后一帧也放进来,当作开头的参考。
-
用打包脚本一键打包。脚本就是一段帮你自动干活的小程序。
注意点:
要改就新建一版,别覆盖旧的。每一版用了什么都留着,出了问题才能查。
动作说明写画面,别写音乐。后面翻车里那个闭着嘴却在唱歌的镜头,就是这里多写了一个“唱歌”。
接上一段,一定要用真的最后一帧。拿计划里的图来冒充,接起来就会跳。
第五步,让机器开跑
是什么:
包打好了,交给机器去生成。对应 04_生成片段 文件夹。
用的模型叫 MiniMax H3,这是一个能下载到自己电脑上跑的视频模型,它能看着参考图和参考视频,生成一段新视频。
整个过程在 ComfyUI 里跑。
模型分两轮画,第一轮先打个低清草稿,第二轮在草稿上精修成高清。
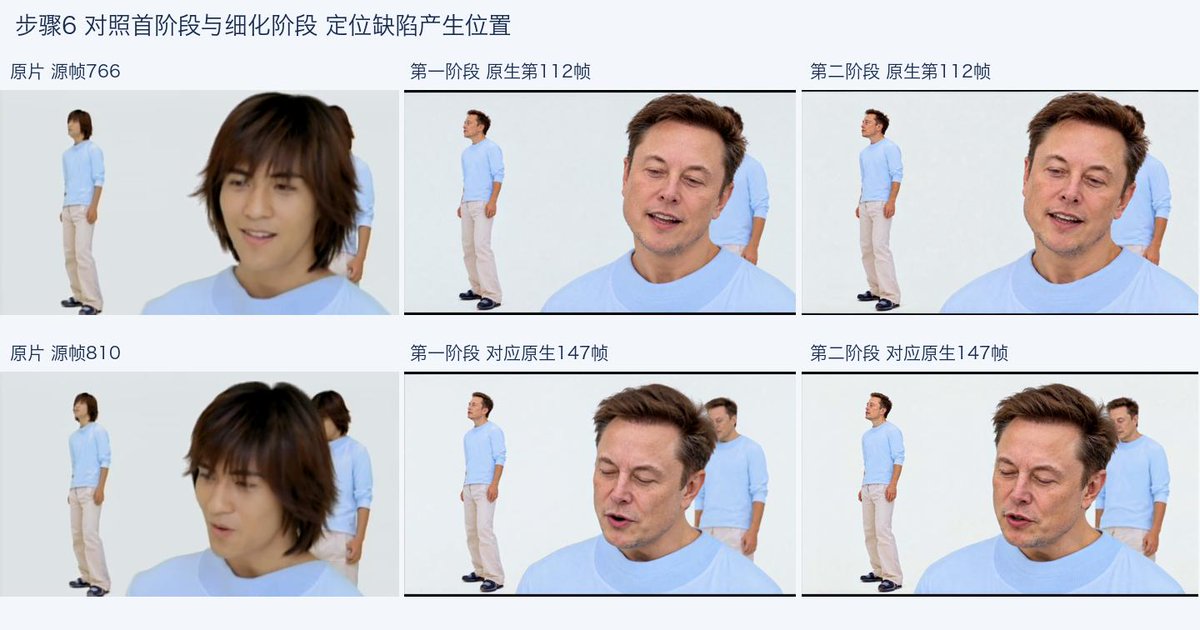
左边是原片,中间是第一轮画的草稿,右边是第二轮精修后的样子。
每跑一次,就多一个文件夹,名字里带着镜头编号、第几版和日期。里面有两个视频,一个是草稿,一个是精修后的。
剩下的几份记录,写着这次任务啥时候交的、跑到哪了、有没有正常结束。这次三台机器一共跑了 78 次,比最后的 54 段多出来的 24 次,全是返工。
怎么做:
-
用提交脚本把打好的包传到一台 DGX Spark 上,开始生成。DGX Spark 是英伟达出的一种 AI 小主机,这次一共用了三台。
-
一台机器同一时间只跑一个任务。脚本会给机器上把锁,有任务在跑,就不会再开第二个。
-
前后有关联的段得排队,上一段跑完、最后一帧检查过,下一段才能开始。互不相关的段,三台机器可以同时跑。
-
跑完把结果取回来。
如果一个任务已经交过了,就别再交一次。提交脚本有个“接着跑”的模式,只是接着盯进度、取结果,不会重复生成。
注意点:
别低估时间。一段 8 秒的 1080p 镜头,大概要跑 1 小时,10 秒的要 1.5 到 4 小时,排计划时一定算进去。
看程序有没有正常结束,别光看进度条。程序结束时会报一个状态码,0 就是正常结束,再加上结果文件也拿回来了,才算真跑完。进度条走满只代表画完了,后面还得把画面转成视频文件再保存。
网断了,任务不一定挂了。先去机器上看看任务还在不在跑,别急着重新交,不然会白跑一遍。
两轮的视频都留着。出了问题,能看出是草稿就画歪了,还是精修时才出的错。
第六步,把节奏对回原片
是什么:
视频生成出来了,但还不能直接用。对应 05_合成工程 文件夹。
模型生成的视频每秒 24 帧,原 MV 每秒差不多 30 帧,直接拼回去,动作就和歌对不上了,这一步就是把两边的节奏对齐。
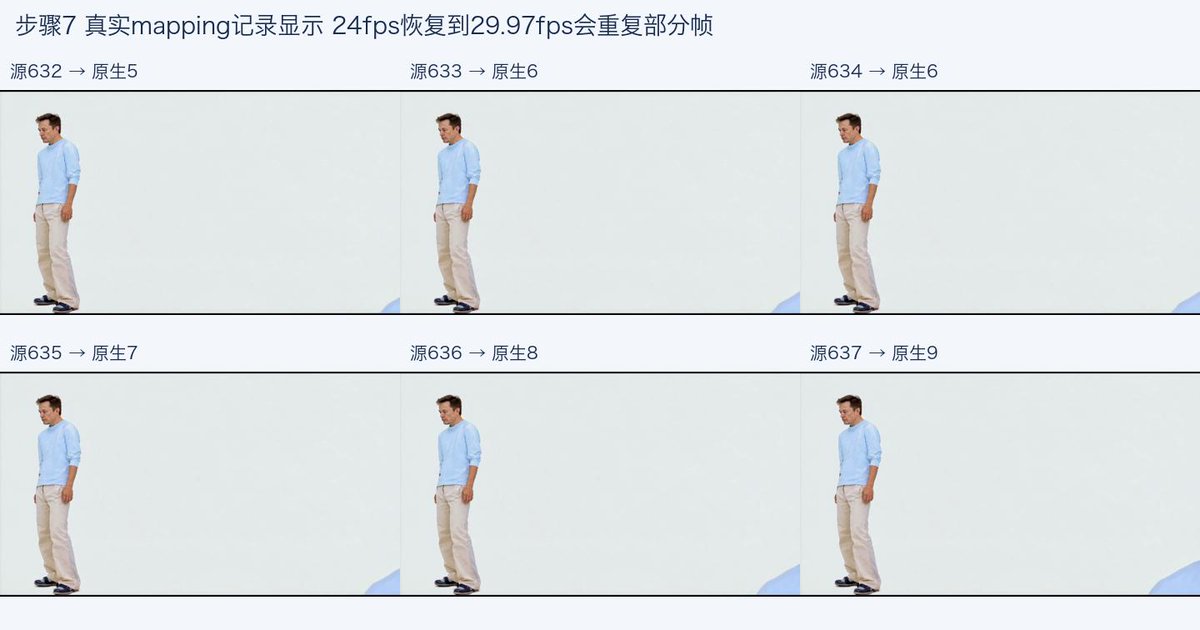
按批次分文件夹,前后一共做了五批,每批里每个镜头一个小文件夹。
里面放着对齐好的高清片段,可以直接拿去拼。
另外还有一张对照表,记着原片的每一帧,用的是生成视频里的哪一张。
怎么做:
-
拿第二轮的视频,先对一下指纹,确认没拿错。
-
按时间对齐,原片的每一帧,都去找时间上最接近的那张生成画面。
-
把模型多画的尾巴剪掉,只留原片这一段的长度。
-
用检查脚本过一遍,清晰度、帧数,还有每一帧该在第几秒出现,都得对上。
注意点:
别把 24 帧直接快进成 30 帧。那样动作会变快,跟歌就对不上了。
机器检查过了,不代表演得对。这一步只管时间,嘴形、眼神、手势错了,在这儿修不了。
接着上一段生成的镜头,要扣掉多出来的那一帧。这种镜头开头带着上一段的最后一帧,对齐时得把它扣掉,不然交界那一帧在成片里会出现两次。
检查结果存在 07。每一段的机器检查结果,都在 07_质检 的技术检查里。
第七步,拼成完整的一支
是什么:
54 段都对齐好了,最后一步,把它们拼成完整的一支。对应 06_成片 文件夹,按顺序把 54 段接起来,配上原片的音乐。
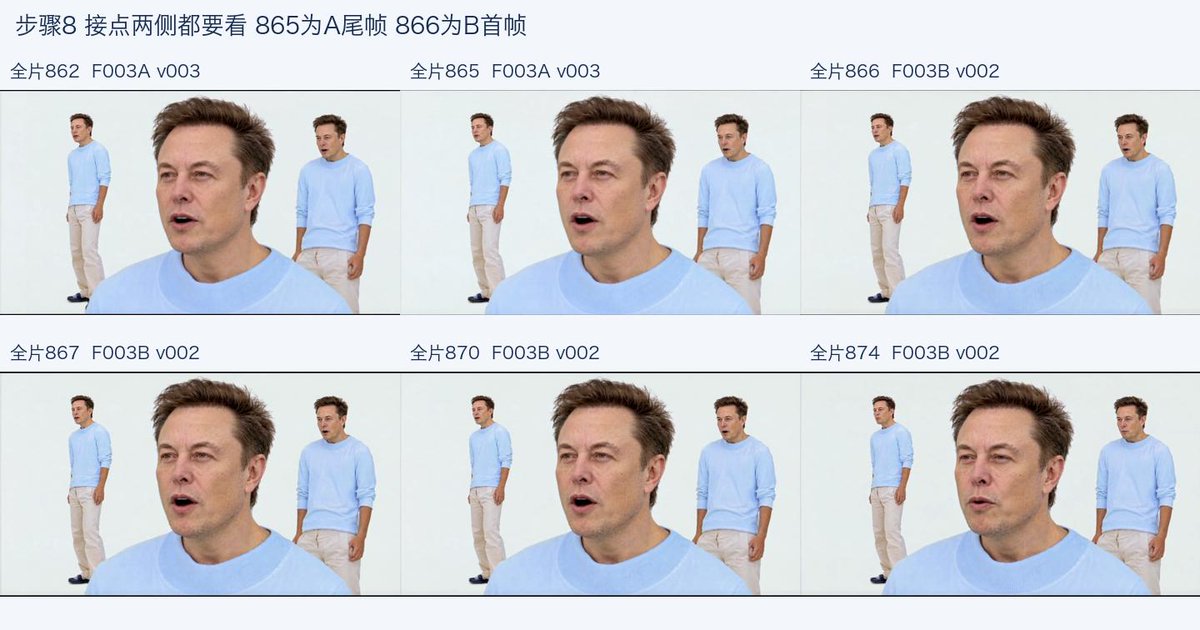
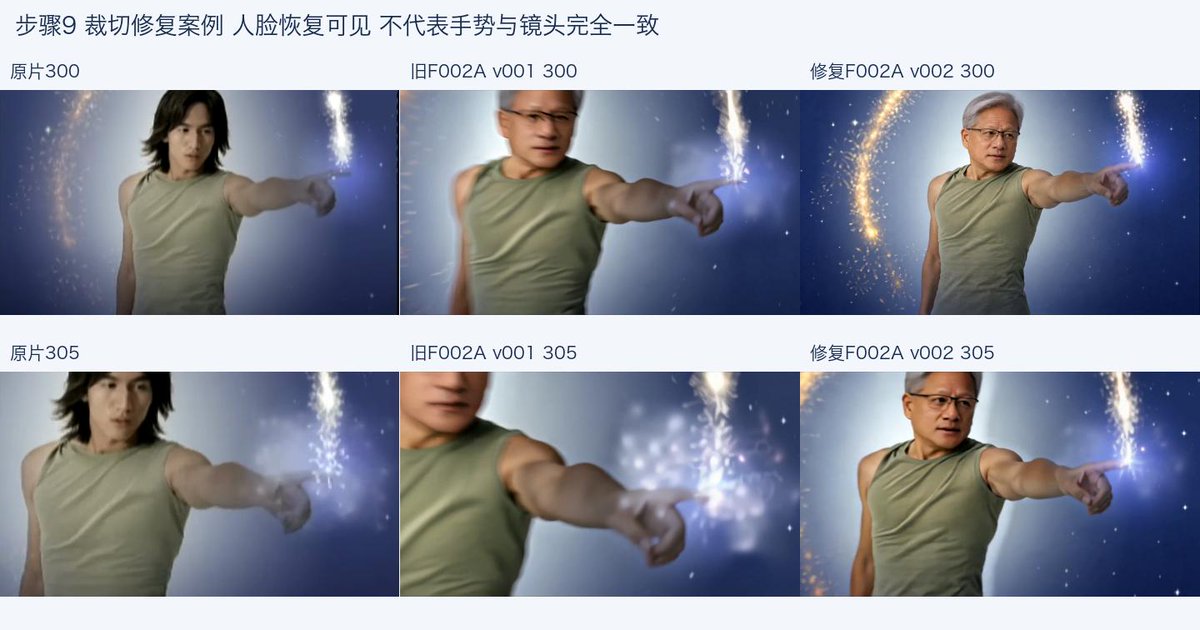
拼好以后,从整支片子里抽了 6 帧,从第 3 秒到第 267 秒。四个人的脸和衣服,从头到尾都得是同一个样子。
每拼一次,就是一个候选版本,这次一共拼了四版。
每一版的文件夹里,都有成片视频、一份合成清单,记着 54 段各用了哪一版,还有三份检查报告。
早期还有两个只拼了前 165 秒的预览,那是半成品,别当全片看。第四版的检查结果是这样的。
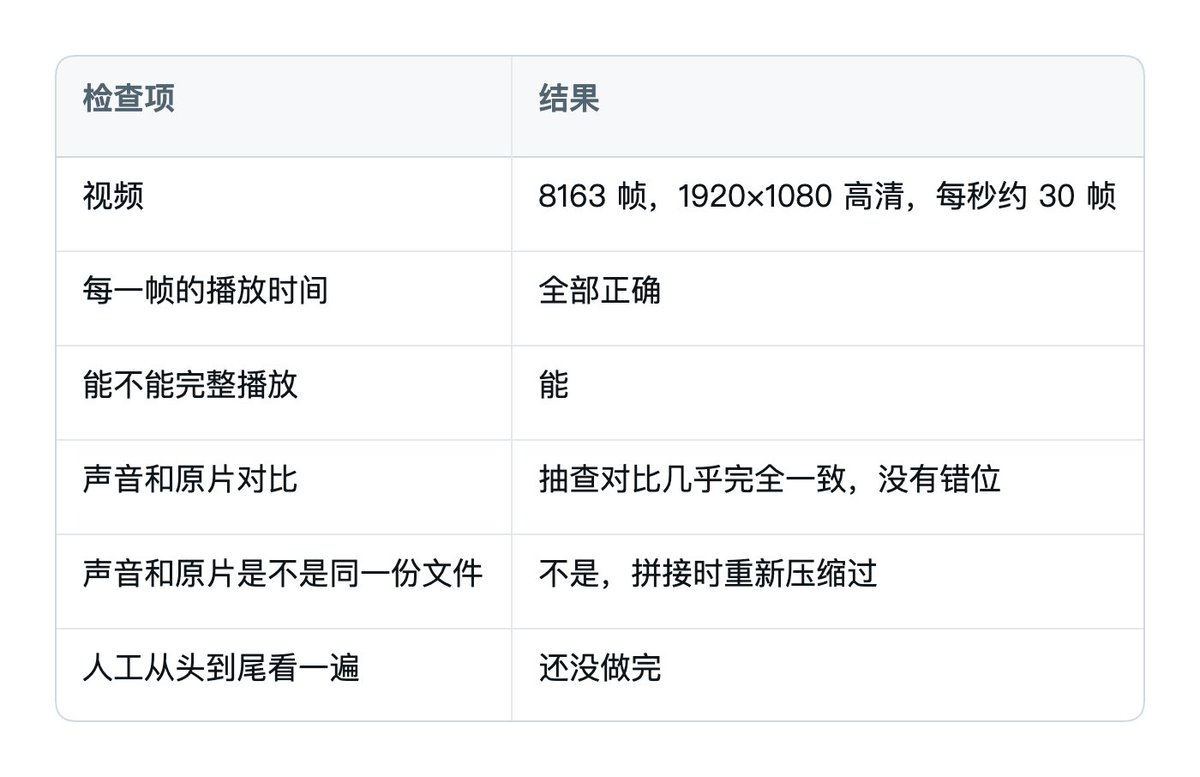
怎么做:
-
写合成清单,定下 54 段每一段用哪一版。
-
检查接口。每一段的结尾,都要正好接上下一段的开头,最后一段要停在第 8163 帧,中间不能空着,也不能重叠。
-
拼起来,配上原片音乐,导出 1920×1080 的完整版。
-
整片再查一遍,每一帧的播放时间对不对、能不能顺畅播完、声音和原片对不对得上。
-
包装一下,加片头、水印和歌词字幕。包装好的视频不放在 06 里,放在工程最外层的文件夹。
注意点:
不能拿原演员的片段来补空。哪段没生成好,就回去接着修那一段。
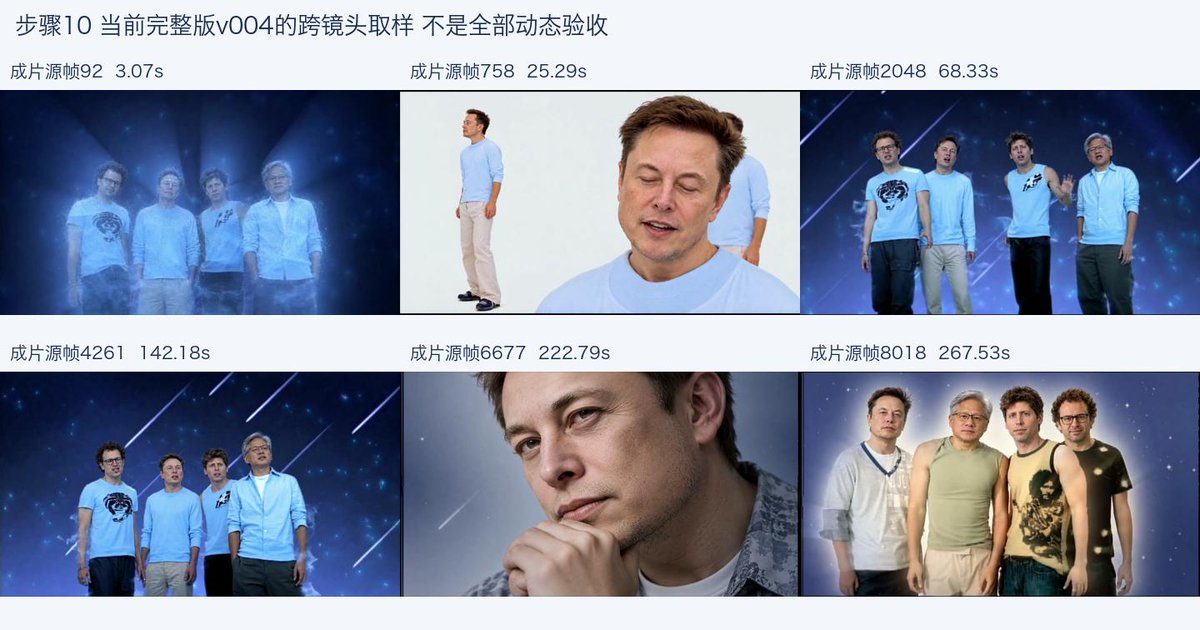
包装版和成片是两码事。加了水印和歌词,不代表里面每个镜头都过关了。
这是加了片头和水印的包装版,它的时间从自己的第 0 秒算起,跟原片的帧号对不上。
歌词字幕一定要人工核对。自动识别出来的歌词,不一定准。
帧数对了,播放时间不一定对。最早直接拼的时候,出现过越往后时间越偏的情况,所以拼完要把每一帧的播放时间从头查一遍。
交片的时候,把四件事说清楚。交的是哪一版,272 秒是不是全覆盖了,机器检查和人工审看各做到哪一步,还有哪些已知问题。
全片的检查记录也在 07。原片和成片的左右对比、全片换脸抽查、歌词字幕的核对,都放在 07_质检 里。
质检,每一步都要回来看
是什么:
07、08、09 这三个文件夹不算单独的一步,前面七步每一步都用得上。
08历史版本 最简单,换下来的旧版拼好的片子和修复前后的对比都挪到这里,最新的东西不跟旧的混在一起。剩下两个重点说,先说质检,对应 07质检 文件夹。检查不是最后才做的事,每做完一步,都要回这里留个记录。
这是检查两段的接口。把交界前后几帧放在一起,看头的位置、背景里的人、衣服和嘴形有没有突然跳。
这里存着每一步的检查结果。切点复查来自第二步,每个返工镜头的小文件夹来自第三到第六步,技术检查来自第六步,左右对比视频、全片换脸抽查和歌词核对来自第七步。
怎么做:
-
先看同一帧。原片和生成版截同一帧放一起,看脸、衣服、头发、手,还有谁挡着谁。
-
再看连贯动作。把原片和生成版左右并排做成视频,正常速度从头看到尾,看不清就慢放,盯着抬手、摸脸、放手的顺序和时机。
-
查接口。上一段最后几帧和下一段开头几帧连起来播,看有没有跳。
-
发现问题就记下来,哪几帧、什么毛病、原片是啥样、生成出来是啥样、下次查哪儿。
注意点:
截图会骗人。两张截图都没问题,中间的动作照样可能是错的,很多毛病只有并排播放才看得出来。
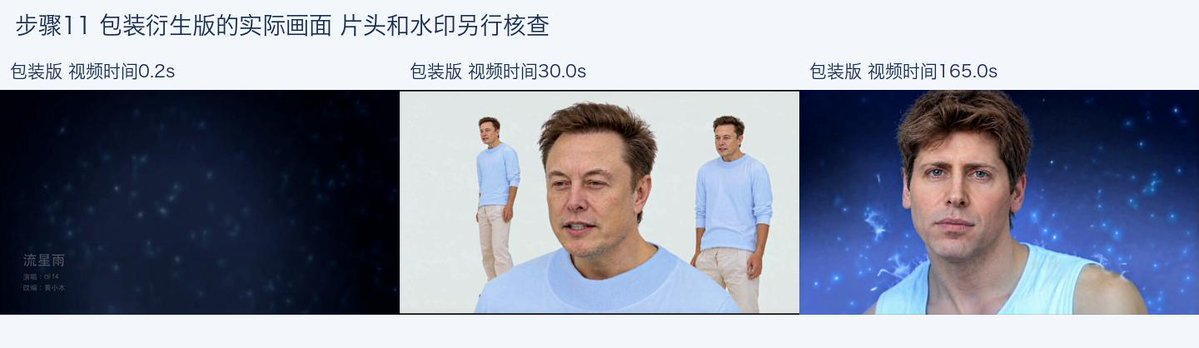
这就是并排看出来的问题。原片里言承旭伸手往前一指,AI 第一版把镜头推得太近,黄仁勋的脸被切掉了一半。右边是修好以后的样子。
新版本不一定更好。有个镜头前后改了五版,成片里用的还是第三版。改得多,不代表越改越好。
打开过视频,不等于看完了。得从头到尾老老实实播一遍,才算看过。
网页播放器拖进度条,可能会骗你。有时候一拖就跳回 0 秒,要看它实际播到了哪。
定位不准,就把那一段单独剪出来再看。
改了一段,前后都要重看。前一段重新生成以后,后一段就算没动,也得重新看看两段还接不接得上。
脚本与流程,工具都放在这
是什么:
再说脚本与流程,对应 09_脚本与流程 文件夹。这里只放工具,不放素材。
整个流程是这么分工的。Mac 上做准备,三台 DGX Spark 各跑各的生成,结果再回到 Mac 上对齐、拼接、检查。
三台机器各干各的活,没有把一个任务拆成三份。
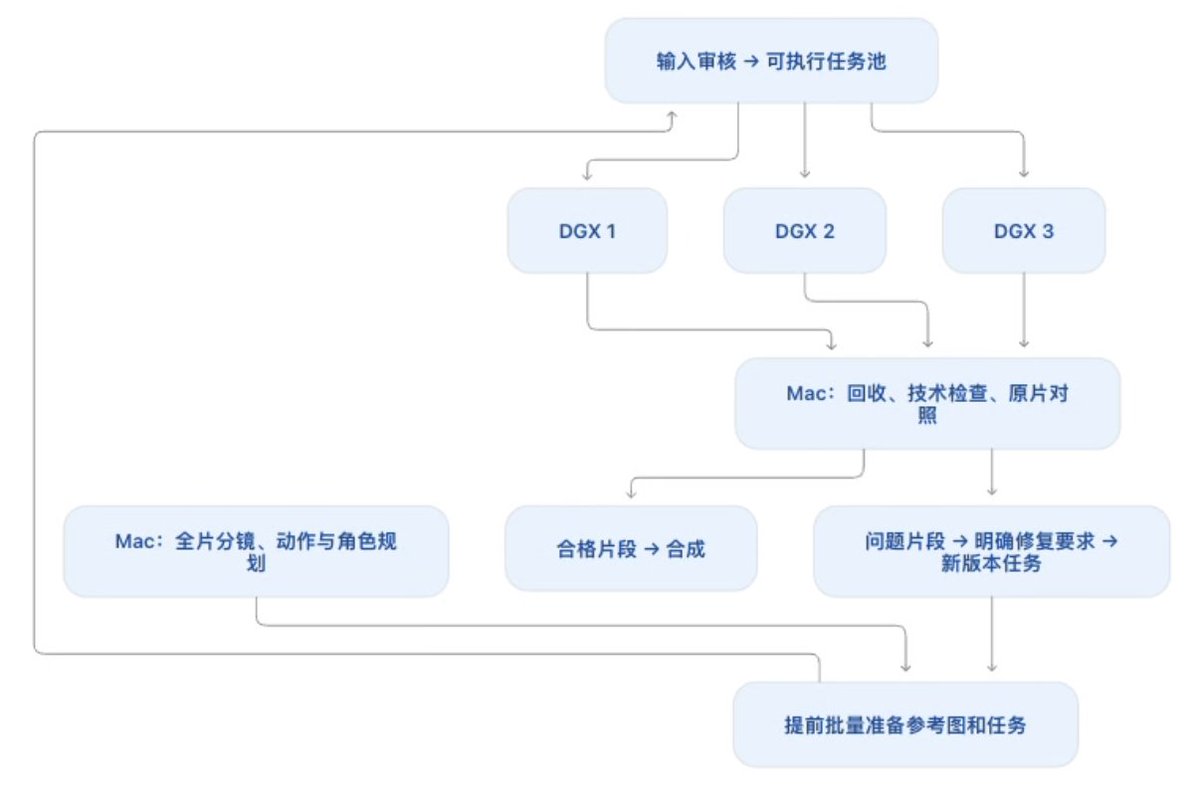
它给前面每一步提供脚本,也记着整个项目的进度。每个镜头的动作说明也在这里。还有一份交接记录,写着现在做到哪了、哪里失败过、我啥时候喊的停。
怎么做:
前面用到的脚本都在这儿,打包的、交任务的、对节奏的、做检查的,各有一个。
注意点:
脚本里写死了我自己的路径。想在你的电脑上用,得先把里面写的文件地址,也就是路径,改成你自己电脑和服务器上的。全片检查时用过的几个临时脚本,也不在这个文件夹里。
分享工程之前,先把密钥删掉。登录服务器的密钥、各种服务的密码、账号信息,千万别跟着文件一起发出去。
想复查某一帧,就倒着走
成片里看到哪一帧有问题,可以顺着文件夹倒着查。
先在 06 的合成清单里,找到它属于哪个镜头、用的哪一版。
再去 05 看它是怎么对齐的,去 04 看那次生成的记录,去 03 看当时喂进去的图和描述,去 02 看剧照是怎么审的,最后去 01 确认它在原片里的位置。这
个镜头所有的检查结论,都在 07 里。
容易翻车的点
七步讲完了,再聊聊这次印象最深的几次翻车。说实话,看 AI 怎么出错,比看它做对更能明白它是怎么想的。
三个人突然一起弯腰
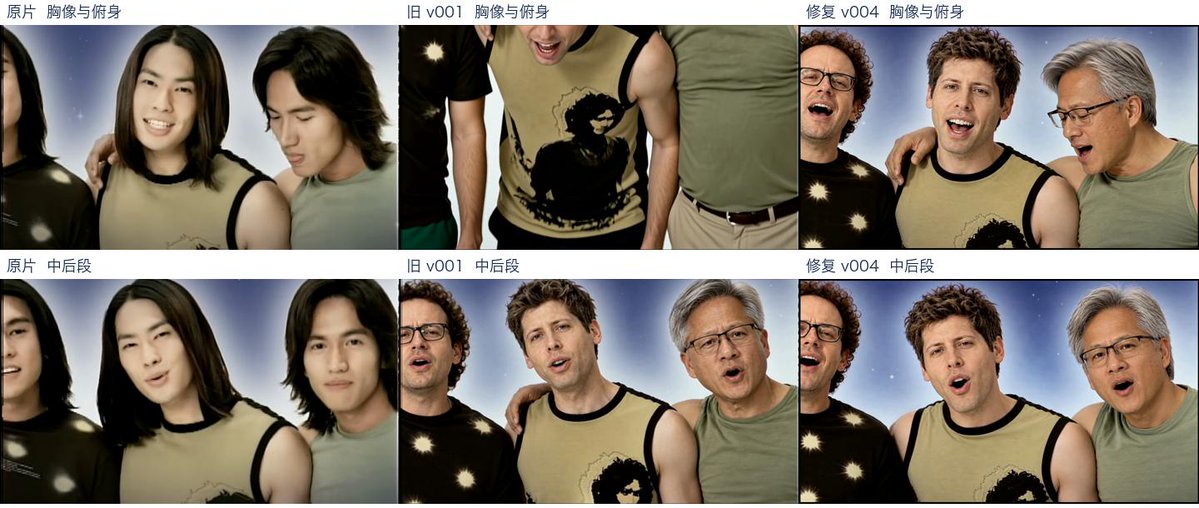
原片这一镜,是三个人搂着肩膀唱歌,镜头停在胸口以上。
AI 第一版出来,三个人齐刷刷往下弯腰,画面里只剩三件衣服,头全跑出了画面。
我第一反应是多给它几张参考图。结果补了一张,弯腰挪到了后面几秒。
再补一张,它又在别的地方弯下去。后来才查到,问题出在第一轮的草稿上。
前面说过,模型会先画一个低清草稿,再在草稿上精修。
原来草稿只画 2 轮、精修画 10 轮,草稿一画歪,后面怎么修都拉不回来。
改成草稿 6 轮、精修 6 轮,再把提示词明确写成站着、只拍到胸口以上,三个人终于站直了。
闭着嘴的人在唱歌
这一镜原片里的人闭着嘴,安静地听别人唱。AI 第一版却让 Sam Altman 张大了嘴。
原因特别简单,提示词里写了 singing,也就是唱歌。整首歌一直有人在唱,AI 就以为画面里每个人都在唱。把提示词改成照着画面写,闭嘴、低头,这一镜就对了。
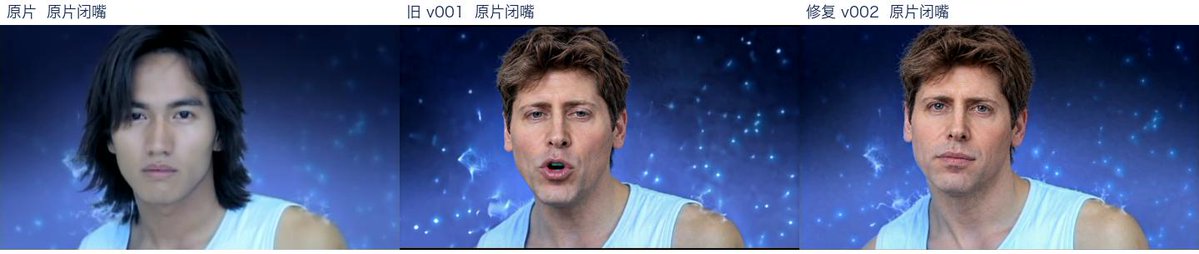
提示词要写你在画面里看到的,别写你在音乐里听到的。
马斯克总是早半拍闭眼
这个到现在也没完全修好。原片这几秒,花泽类半睁着眼,笑着说话。AI 生成的马斯克,眼睛总比原片闭得早,闭得也更久。
前后改了三版,修参考图、调画的轮数、专门补一张半睁眼的图,有几帧好了,另外几帧还是对不上。
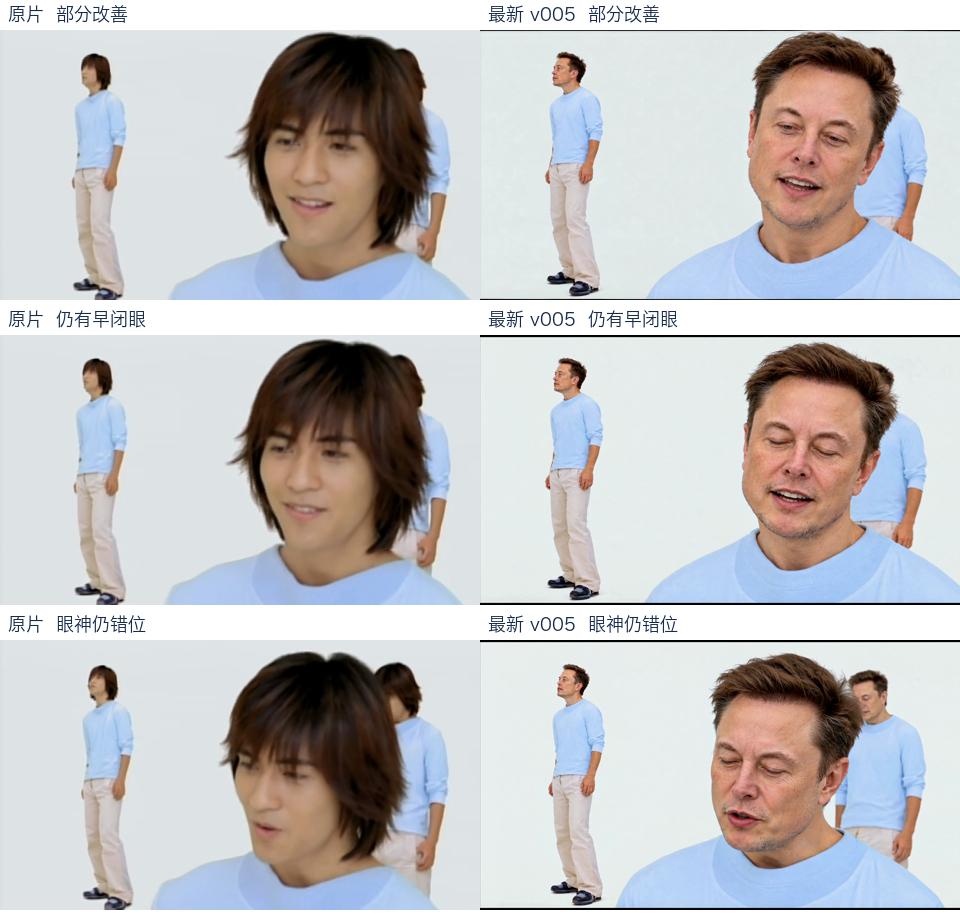
还得说清楚,这套流程里没有专门对口型的环节,原片的声音只是当参考喂给模型。嘴形和眼神对不上,是现在最大的短板。
自己试一试
别一上来就做整支 MV。先挑一个镜头,一个人,5 秒钟,背景越简单越好,照着上面七步完整走一遍。一个镜头跑通后,理解逻辑了,再慢慢加。
硬件投入
做这种视频,最吃的是显存。显存就是显卡自带的内存,模型越大,要的显存越多,不够就跑不动或者跑得很慢。
下面这张表,第一行是我现在用的配置,后面三行是我查到的替代方案。
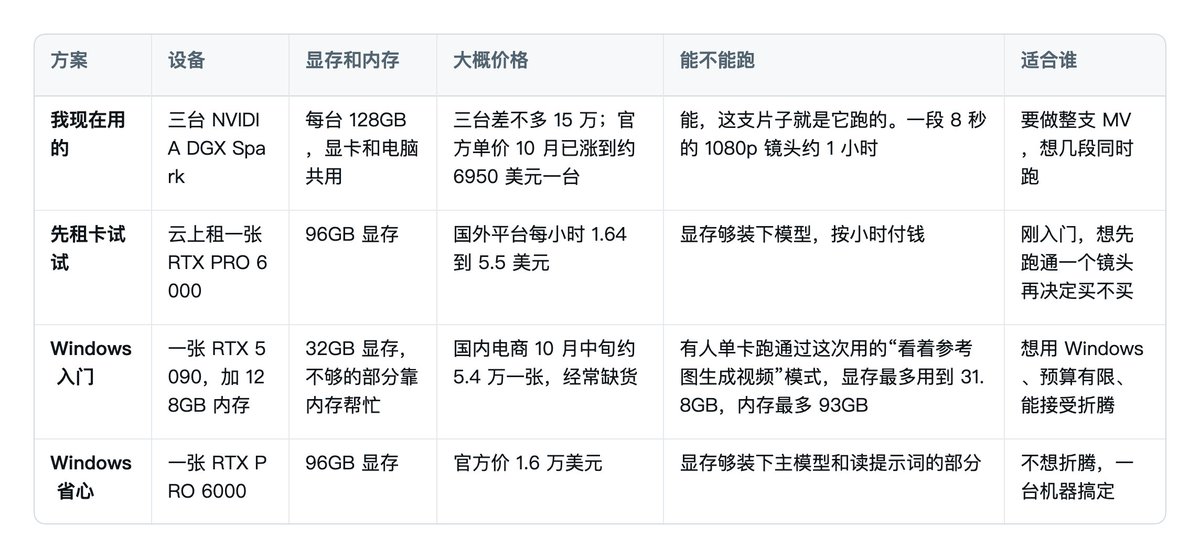
建议先用小尺寸跑通,后面三档配置未实测,仅供参考。
要效果好得肉眼看了后不停的调整细节,比如这个片子,前后渲染加调整差不多花了大半天。
skill及物料包,都在 github:
https://github.com/JayceHuang/recast-video-dgx
黄小木|T11级工程师|本文由opus5.5 创作|持续分享 AI 信息、副业赚钱、程序员转型OPC心得|X:@ai_xiaomu
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


