
我把一城烟火、千里江山,交给了一个5B开源模型
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
最初,我只是想用 MOSS-Image 做一张带中文的图。
后来越做越想试点大的:一座挤满船只、店铺和行人的宋城,一片把舞者衬得很小的青绿山河,再把山水做成丝绸、青瓷和墨金。
这次最有意思的体验,是我终于能把一些构图想法说得更具体:山在左边压多大,河从哪里绕过去,船留多小,标题放在哪一片安静的地方。
这段 50 秒视频,记录了前一轮宋城与青绿群舞的成图、布局和修改过程。画面的推近、平移与说明文字由后期制作,MOSS 负责的是其中的原始图片。
先把一座城画得有人气
宋城这张,我想看的是密集画面里的关系。
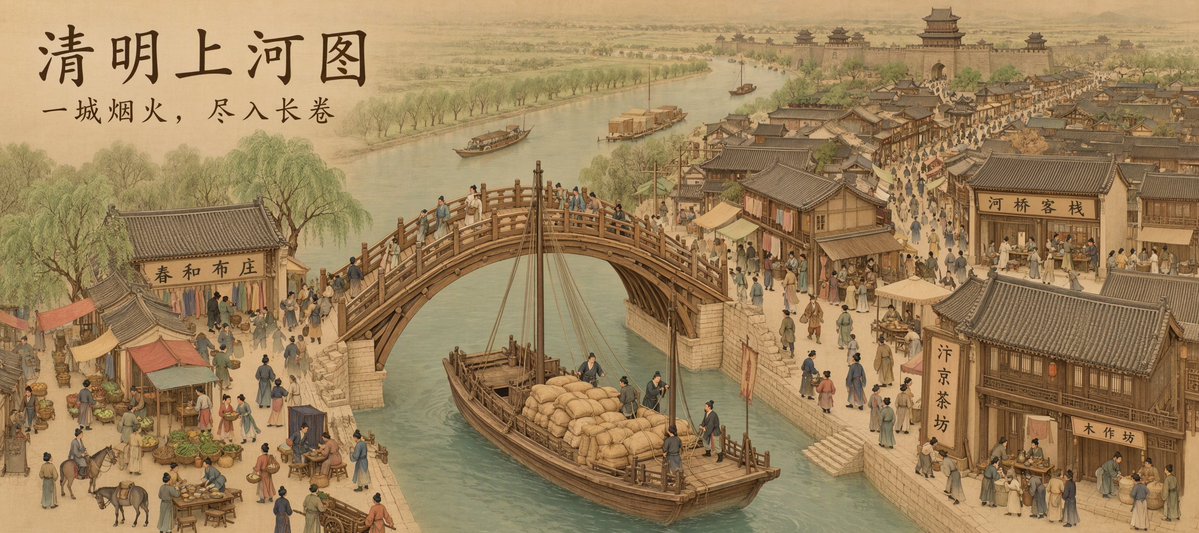
桥要接得上两岸的街,船要落在水里,摊位之间要留出人能走的路。近处有茶坊和布庄,远处还有城门与水运。放大以后,应该能找到更多小故事。
我把桥、船、市集、远城和几块中文招牌分别放进 Layout。中文店招直接在图里生成,没有再用修图软件补字。
它也有没做到的地方:船桅杆没有按我的描述放倒,细小人物和建筑经不起“每一笔都准确”的要求。这张更适合当作一幅宋城想象,而不是古画复原或历史证据。
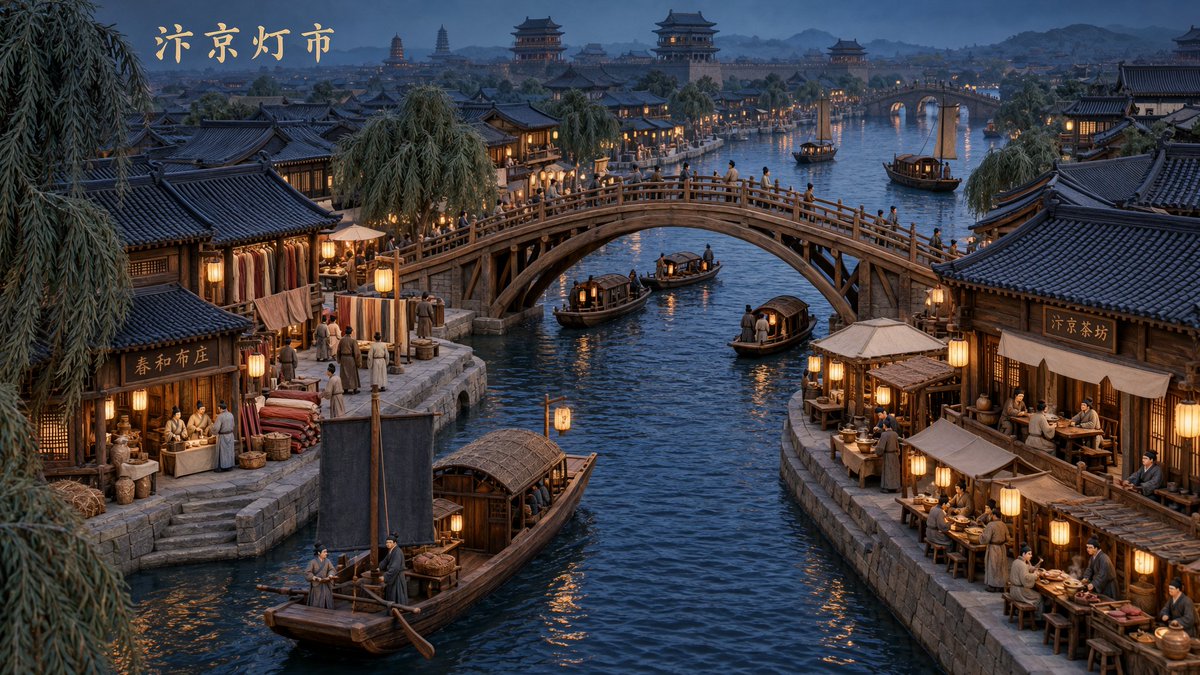
沿着这条线,我又做了一座入夜后的「汴京灯市」。保留河道、桥和两岸市集的关系,让灯笼、窗内的光和水面倒影把空间串起来。工笔版之后,又补了这一张偏微缩摄影质感的版本。
山要大,人要小
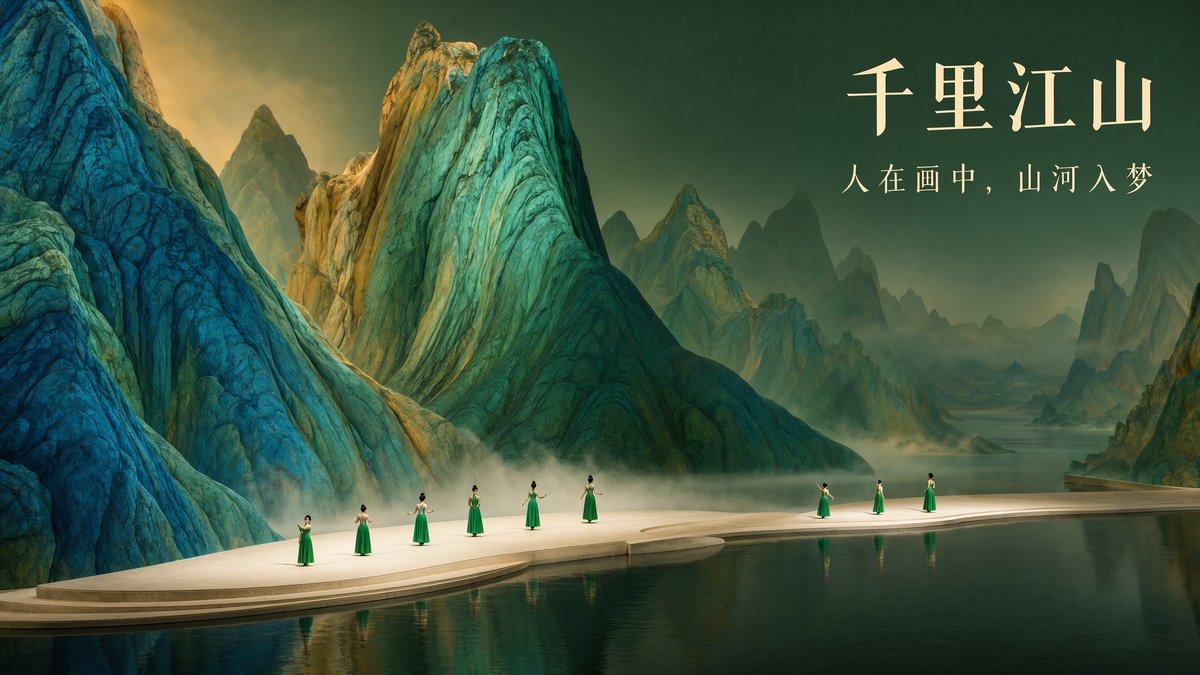
青绿群舞的第一版,人物太抢眼,山反而变成了背景。
我重新拆了人物区域,把九位舞者安排成前后两组,给他们很小的位置框,让山体占住画面。第二版尺度对了,标题却有一个字不对;后来调整标题和字形描述,整张重新生成,才得到现在的「千里江山」。
这一轮让我更愿意把 Layout 当作构图草图:它给我一个能继续修改的起点,每次成图仍要放大看。
让山水换一种材质
这次又补了一个工作流:先做参考母图,再让平台解析成布局,交给 MOSS 重新生成。
这里要说清楚:参考母图由内置生图工具制作;平台用参考图提取区域与描述,最终展示的成图再由 MOSS-Image-SFT 生成。这个入口叫「参考布局」,我没有把它当作保持原图像素的修图功能。
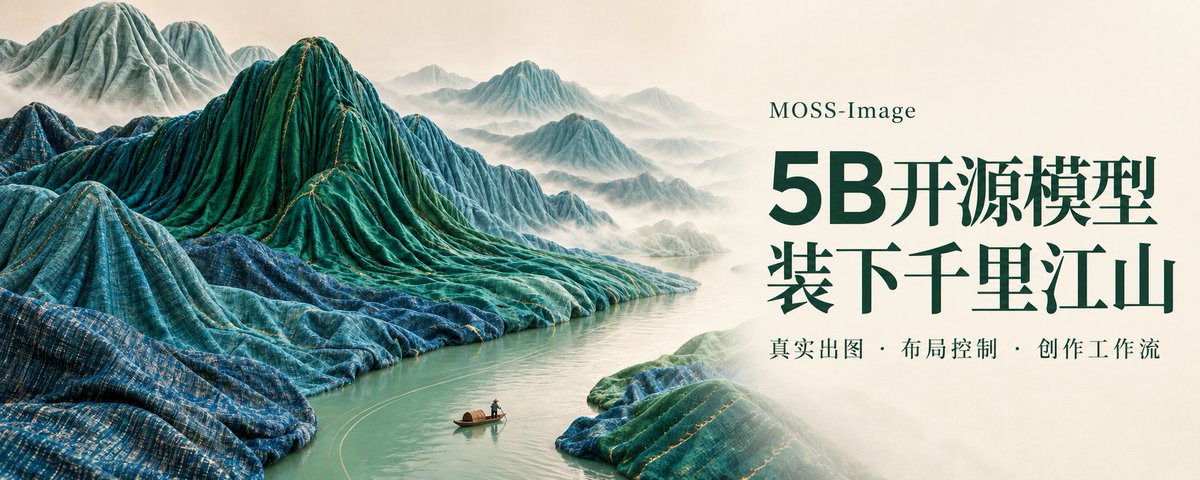
封面这张「山河入绢」,用丝绸褶皱构成山脊,少量金线沿着山势延伸,一叶小舟留在水面。近处能看到布纹,远处逐渐退进雾里。
同一份解析后的布局,我试了两个 Seed。布料的细部和山势会变化,标题仍留在右上的空处。最终选了更能看清河道与近处织纹的一张。
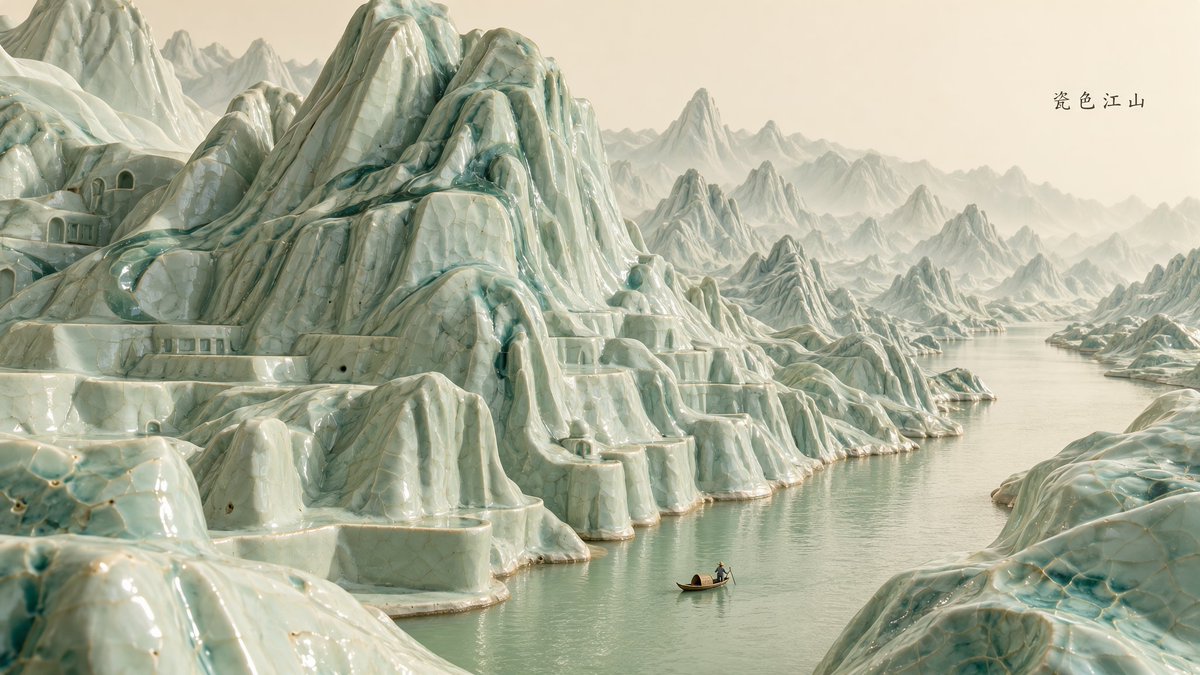
接着保留提取后的空间骨架,改写材质描述,做了「瓷色江山」。想让青瓷的积釉、开片和薄边透光成为画面的一部分,而不是把山简单染成绿色。
「墨海金山」则把主山压进墨黑的纸与漆面里,只在局部山脊留下金箔。换了材质,画面的气质也跟着变了:从织物的柔软,到瓷的温润,再到纸折线与残金的锋利。
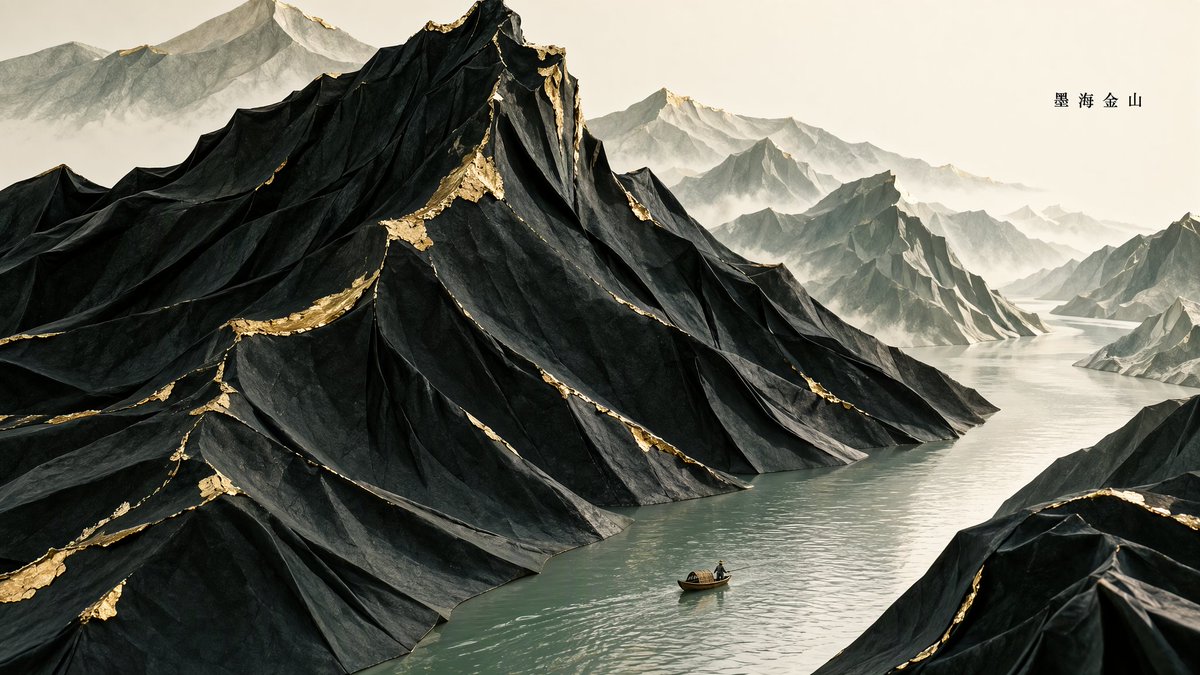
这两张并没有保持每一块山体的轮廓。它们延续了左侧主山、右侧河谷、小船和标题的大体关系,模型仍会重新组织细节。
我是这样做的
没有参考图时,先写整体场景,再把主体、文字和位置拆成 JSON Layout;有参考图时,上传到「参考布局」,写清哪些关系要保留、哪些内容要改变,生成目标布局后检查并应用。
之后再用 MOSS-Image-SFT 出图,放大核对文字、人物、材质和空间,针对问题改描述或框的位置,重新生成。上面的文字均未后期盖字。
以丝绸山水为例,我给参考布局写的要求是:
保留横向构图、山体大小与河流走向、右上标题位置。山体由青绿丝绸与蓝色织锦褶皱构成,少量金线顺山脊延伸。一叶小木舟与船工建立尺度。克制晨光,标题精确为「山河入绢」,不新增其他文字。
本轮使用 2048×1152,Euler,50 步,CFG 3,Shift 5,负向分支跳过第 22 层。参数是我这次的实际设置,不能保证每个题材都适用。
MOSS-Image 基于 5B DiT 主干,Base 和 SFT 权重及代码都已公开。官方还提供最长 4K tokens 提示词支持和微调指南,SGLang 与 vLLM-Omni 也已提供 Day 0 支持。这次我主要实测了中文文字、布局和不同材质,没有做长提示词上限或微调测试。
如果你也有一幅脑子里很清楚、说起来却总跑偏的画面,可以从最关键的几个位置开始,把它写进布局里。
GitHub : https://github.com/OpenMOSS/MOSS-Image
Hugging Face 在线体验: https://huggingface.co/spaces/OpenMOSS-Team/MOSS-Image
点开试一张。也想看看,你会把山河做成什么材质?


