
一个晚上,复现一篇《Science》
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
——用 Open-Science 重跑海马涟漪"记忆选择"试点
2024 年,wannan姐在 Science 发表了《Selection of experience for memory by hippocampal sharp wave ripples》,提出海马尖波涟漪(SWR)会主动“选择”哪些经历被巩固进记忆。论文数据开放在 Zenodo 上https://doi.org/10.5281/zenodo.10816749,
我之前也本地跑过这个数据:从原始数据出发,做神经流形、回放候选筛选、CEBRA 编码,再把迷宫中的高同步事件(HSE)投射到冻结的编码器里,看它们是否更接近行为流形。
这次我想试试:把这件事交给一个 AI 科研工作台从零重跑,能不能复现出我手里的结果,又能省掉多少事。我选的是开源的 Open-Science,模型用的是我自己的 Codex 订阅。
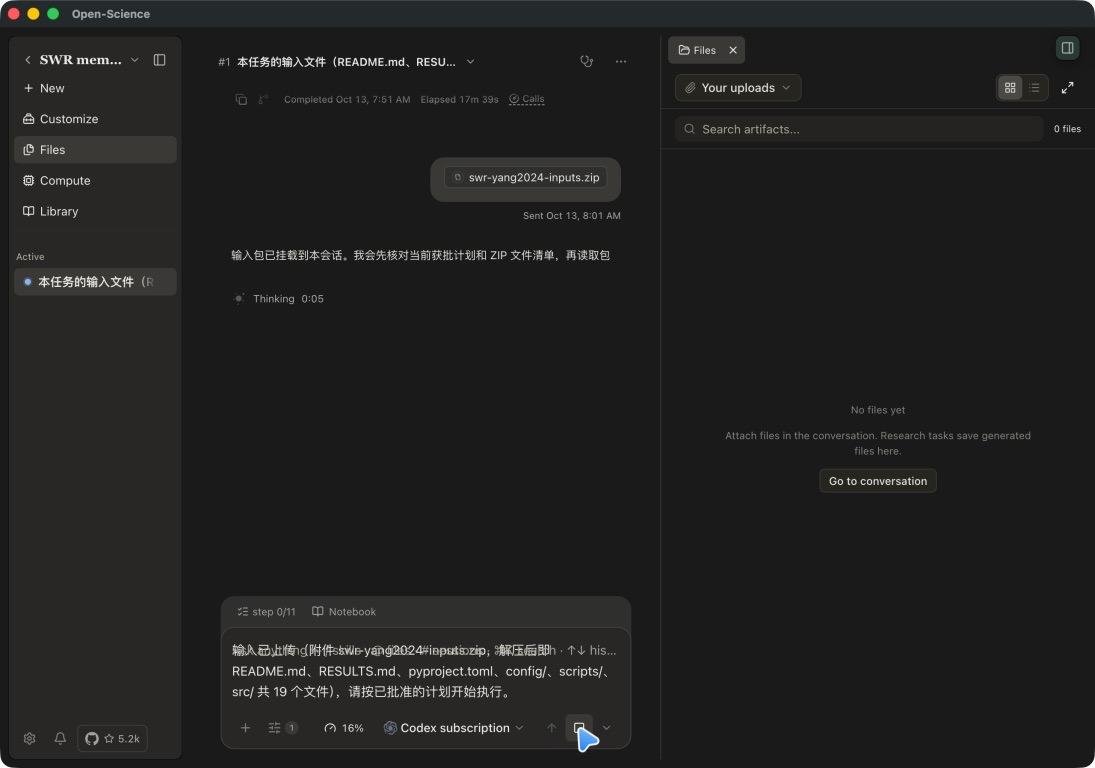
图1|把输入包作为附件发进会话,Agent 立即确认挂载,开始核对清单
一、从"给一个任务"开始
准备工作不多。装好应用、登录 Codex 订阅之后,我只做了两件事:把之前开源包里的既有结果 RESULTS.md、数据清单、分析配置和 scripts、src 代码打成一个压缩包上传,再写了一段任务说明:按清单从 Zenodo 下载数据并核对 MD5,依次完成数据审计、基线流形、回放候选、CEBRA 和 HSE 投射五个步骤,最后和 RESULTS.md 逐项对比。我特意加了一句:"不要在看过数据后改阈值。"
我打开了"先出计划"模式。Open-Science 先交出一份 5 个阶段、11 步的执行计划,批准后开始执行。每一步都写了完成条件,比如"试次不跨训练和测试集"、"置换次数完整"、"不把技术失败解释成阴性生物学证据"。这有点像预注册:要做什么、做到什么程度算完成,在跑数据之前就定好了。
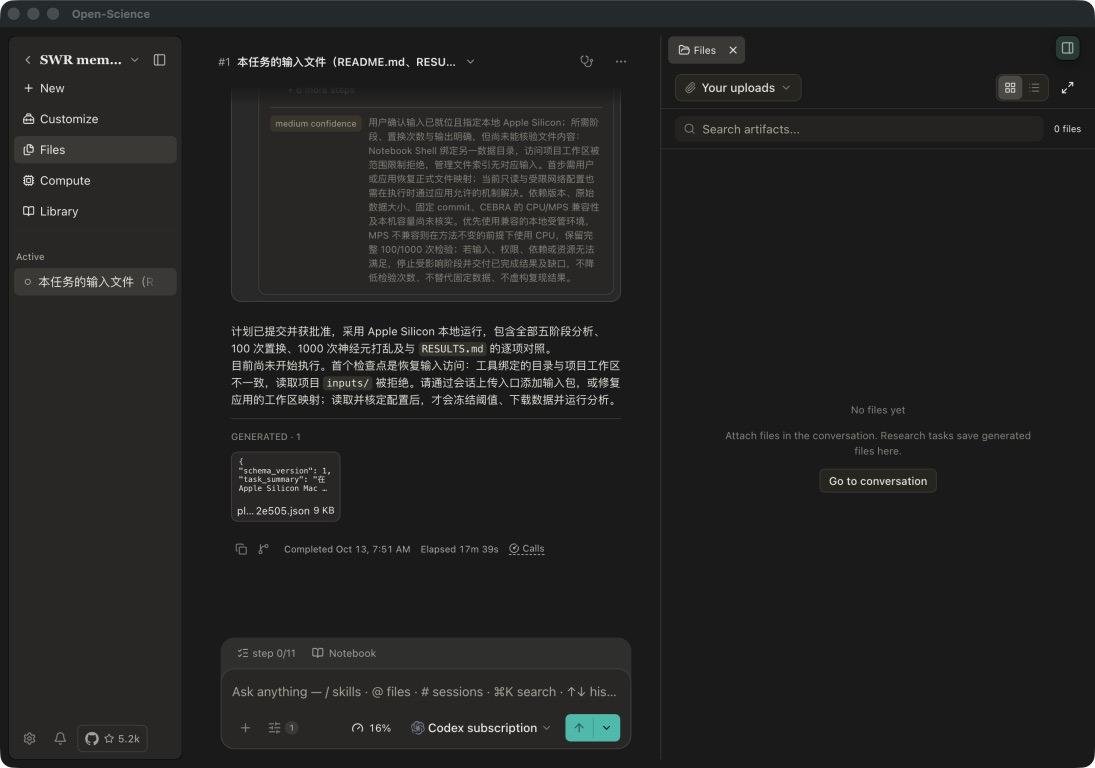
图2|"先出计划"模式:5 个阶段、11 步,附可行性评估,审批后才执行
二、看数据之前,它先找出了我代码里的问题
第一步就出乎我意料。Agent 读完全部 19 个输入文件、记录了哈希,没去下载数据,先交给我一份"输入与方法审查",列出配置和代码之间的几处实质性不一致:
-
analysis.yaml 写的是逐试次留一验证,原脚本实际做的是五折整试次留出;
-
配置里列了五种对照,我自己的代码只实现了其中两种;
-
CEBRA 训练时把各试次拼成了一条连续数组,时间上的正样本配对可能跨过试次边界;
-
回放筛选的打乱次数默认是 100,要显式指定才会跑 1000。
这几处我自己都没注意到。它给的建议是:主线严格照原脚本跑,这样才能和既有结果对比;在报告里如实没实现的对照列为"未执行",不补做,也不声称做过;跨试次配对单独做一个预先声明的敏感性检查。我同意后,它把这些决定写成冻结方案存档,再进入数据阶段。这个阶段我自己还一个数据点都没看过。
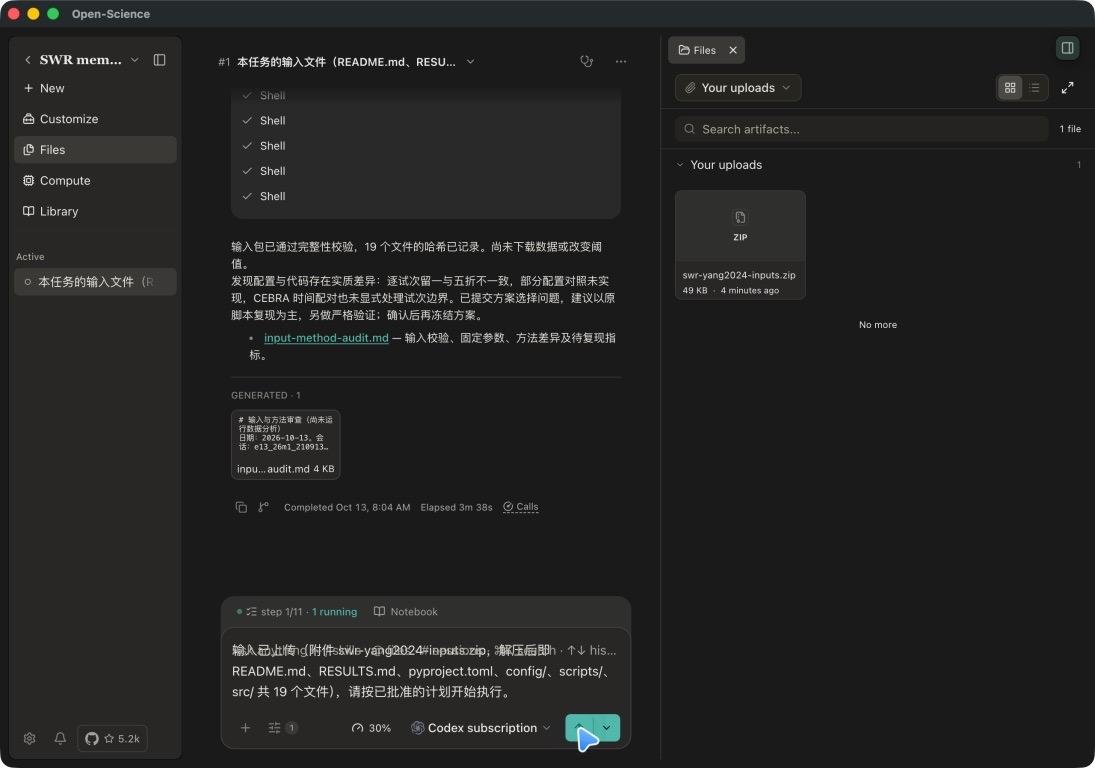
图3|方法审查:Agent 读完 19 个输入文件后,指出配置与代码的不一致,提交方案选择,先不碰数据
三、环境、数据、校验
环境方面,它先在本机检查了内存(128 GB)、磁盘和 Python 版本,用合成数据把 CEBRA 0.6.1 的拟合、投射和模型存取跑了一遍。中途 Conda 的科学计算库和 PyTorch 各带了一份 OpenMP,冲突导致进程崩溃。它找到了原因,新建一个独立环境统一安装,问题解决。
数据方面,它按清单下载了 248 MB 的 Zenodo 压缩包,核对了 MD5。作者事后补充的涟漪事件文件,它也按清单里固定的 GitHub commit 取回,同时核对了 SHA256 和 Git blob 哈希。数据审计报出 482 个单元、422 个锥体细胞、70 个试次、79 个迷宫 HSE,和我原来的结果完全一致。它还发现原始元数据里的日期和会话 ID 对不上,写进了报告。
每次要执行代码、安装依赖或访问外部网站,都会先弹出权限确认,附上要跑的代码和理由。点"允许"之前,我能看到它要跑我的哪个脚本、访问哪个地址。
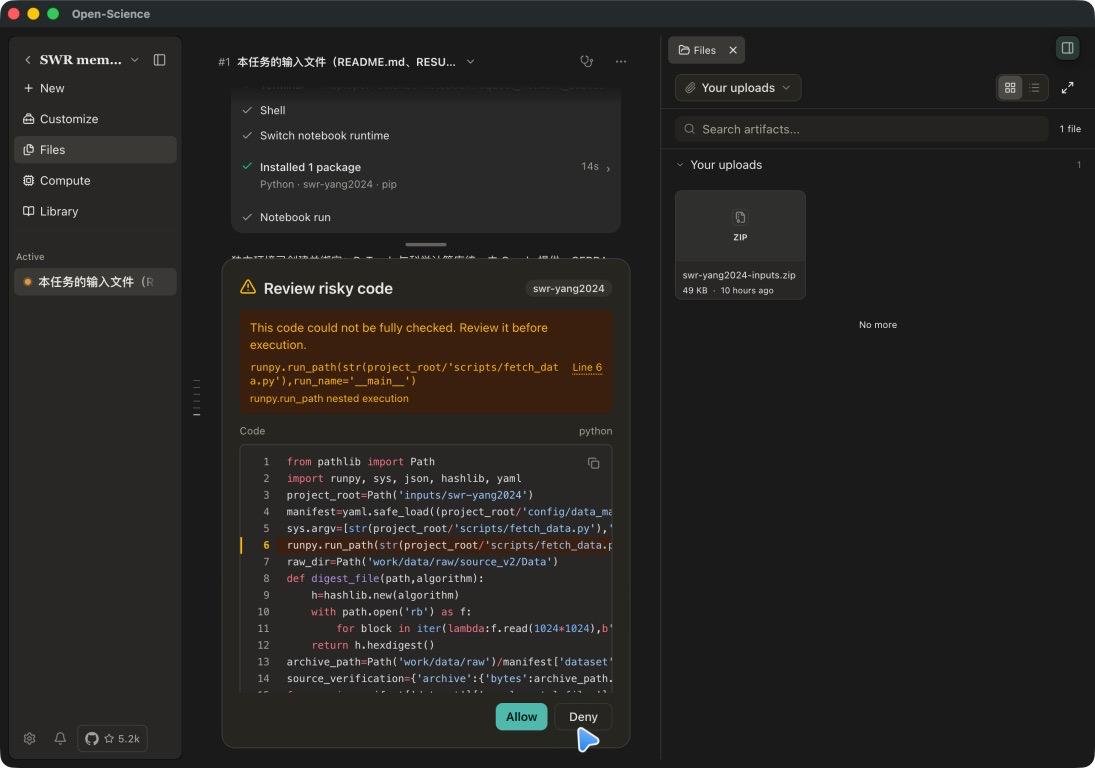
图4|执行前的权限确认:它要用 runpy 跑我上传的 fetch_data.py,按清单下载并校验数据
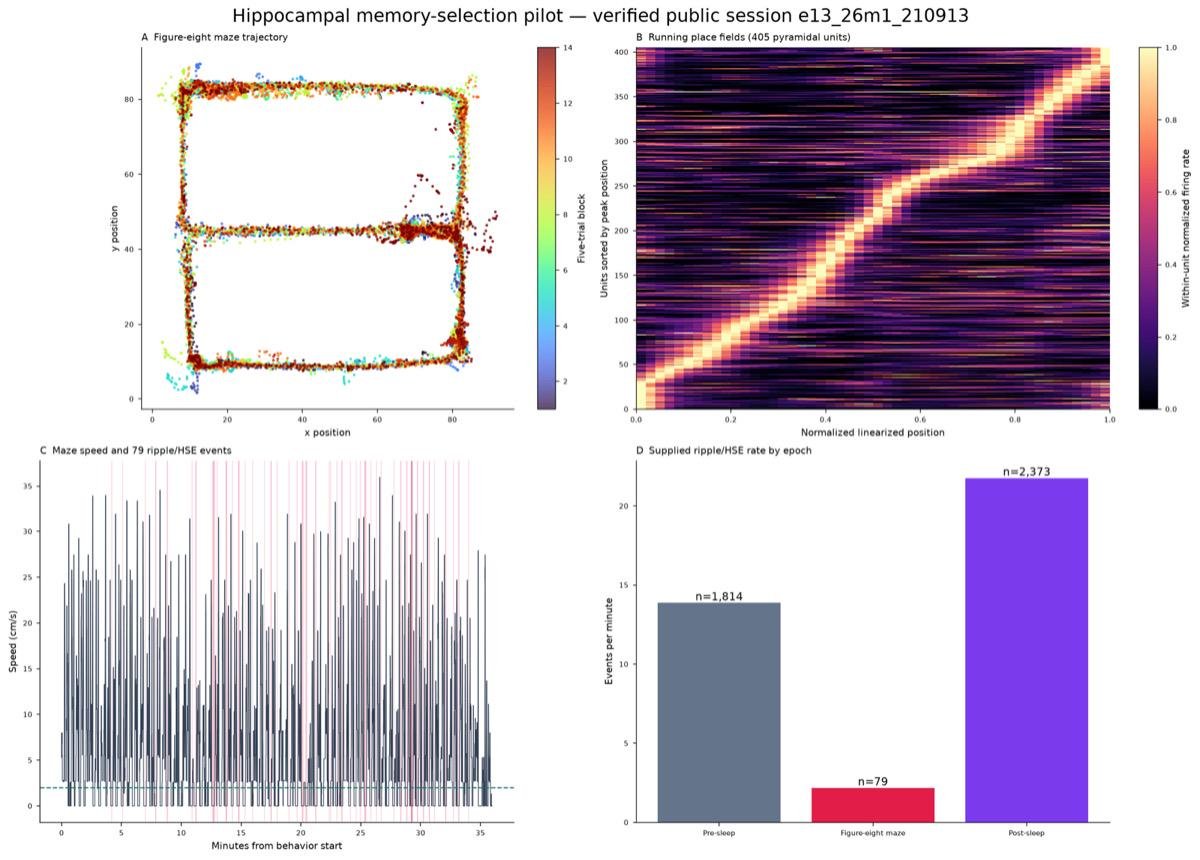
图5|数据审计总览:轨迹、位置场排序、速度与 HSE 分布
四、结果:大部分精确复现
五个分析阶段跑完,Agent 给出一份中文报告和一张 21 项的逐项对照表:
- 基线流形:位置匹配的 block 解码误差 2.182,置换均值 4.714,p = 0.0099。和 RESULTS.md 的 2.18、4.71、0.0099 一致。五折中每折 56 个训练试次、14 个测试试次,互不交叉,100 次置换全部完成。
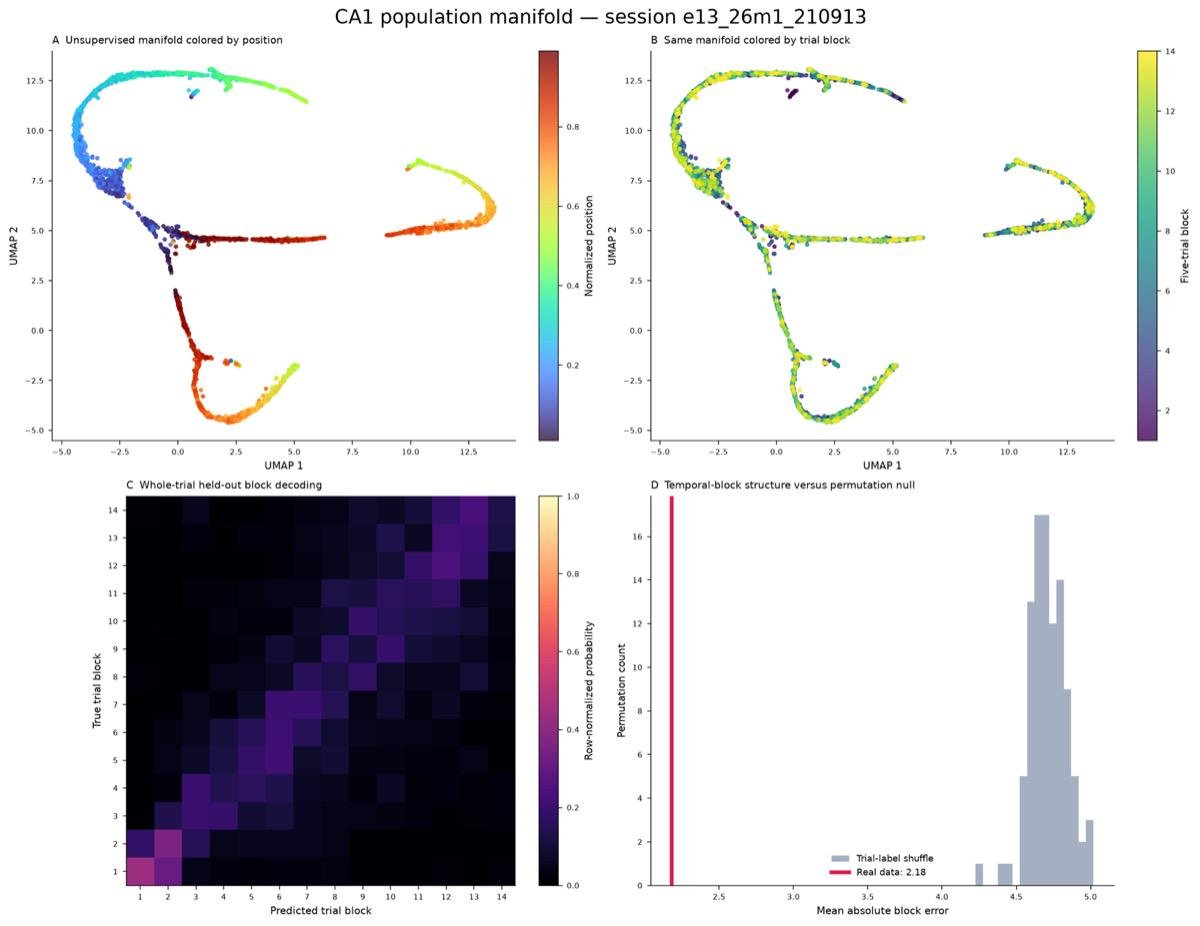
图6|基线 UMAP 流形,位置匹配的 block 解码与置换零分布
回放候选:79 个 HSE 中筛出 7 个(8.86%)。每个事件都做了 1000 次神经元打乱,并逐个事件重算 p 值核对。结果和原来一致。
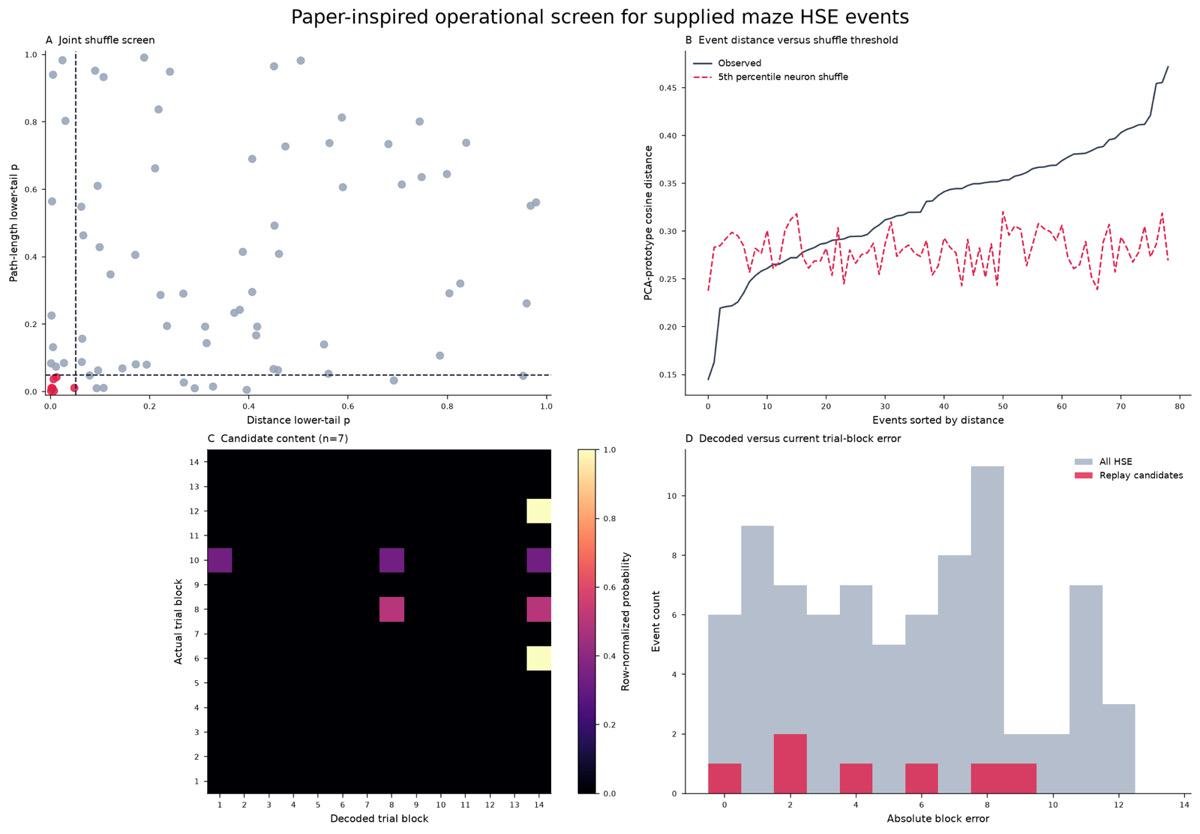
图7|79 个 HSE 的 PCA 原型距离与轨迹紧凑度,7 个通过双指标筛选
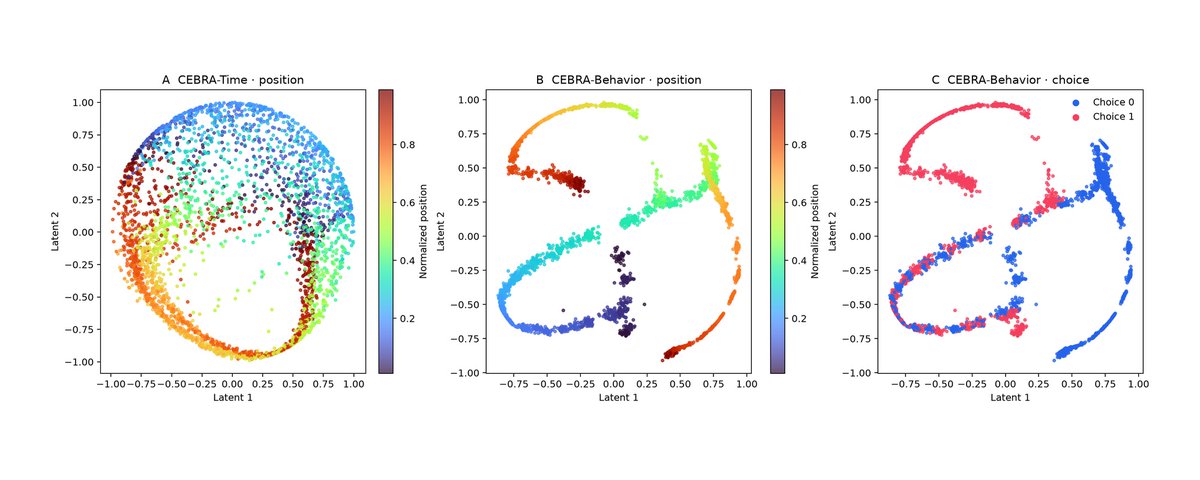
CEBRA:CEBRA-Time 的位置误差 0.0756、选择准确率 77.6%,精确复现;CEBRA-Behavior 的几项数值有小幅差异,方向一致。唯一没复现的,是 Behavior 模型 block 解码技能分数的正负号。
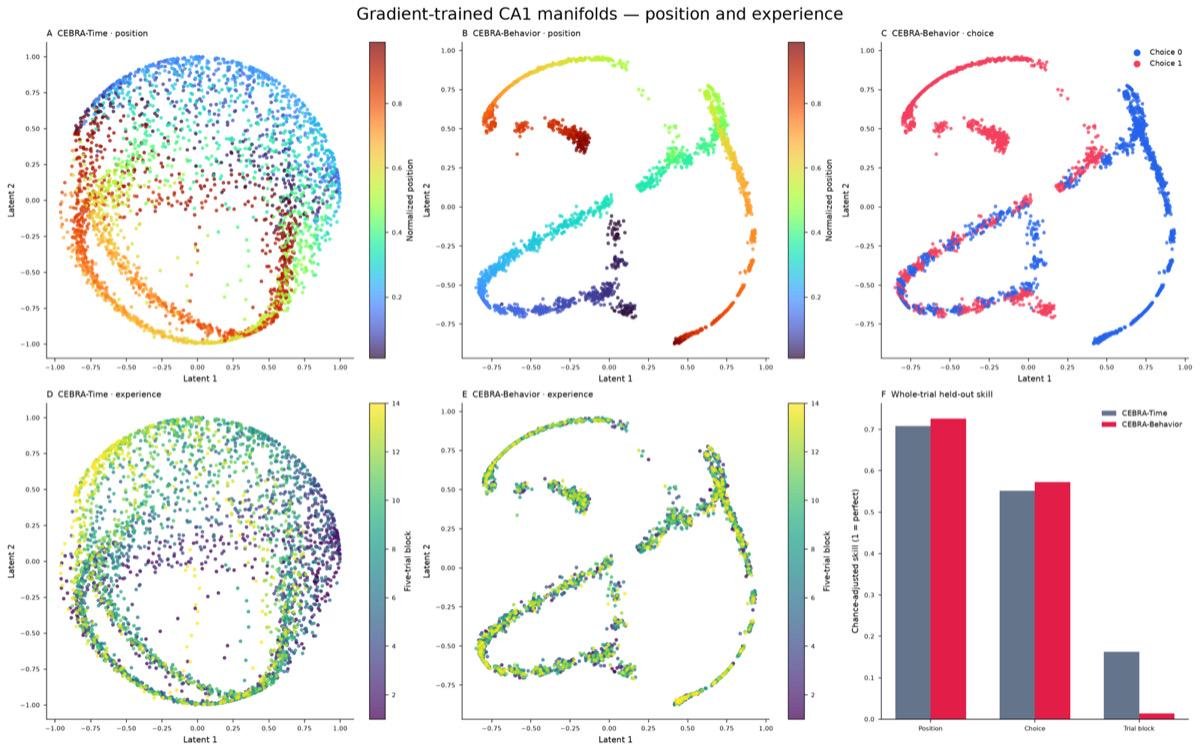
图8|CEBRA-Time / CEBRA-Behavior 学到的流形(按位置和经验着色)及五折解码指标
HSE 投射:在冻结编码器中,HSE 没有表现出比对照更接近行为流形的优势(单侧 p 为 0.96 和 0.88)。方向和原结果一致。
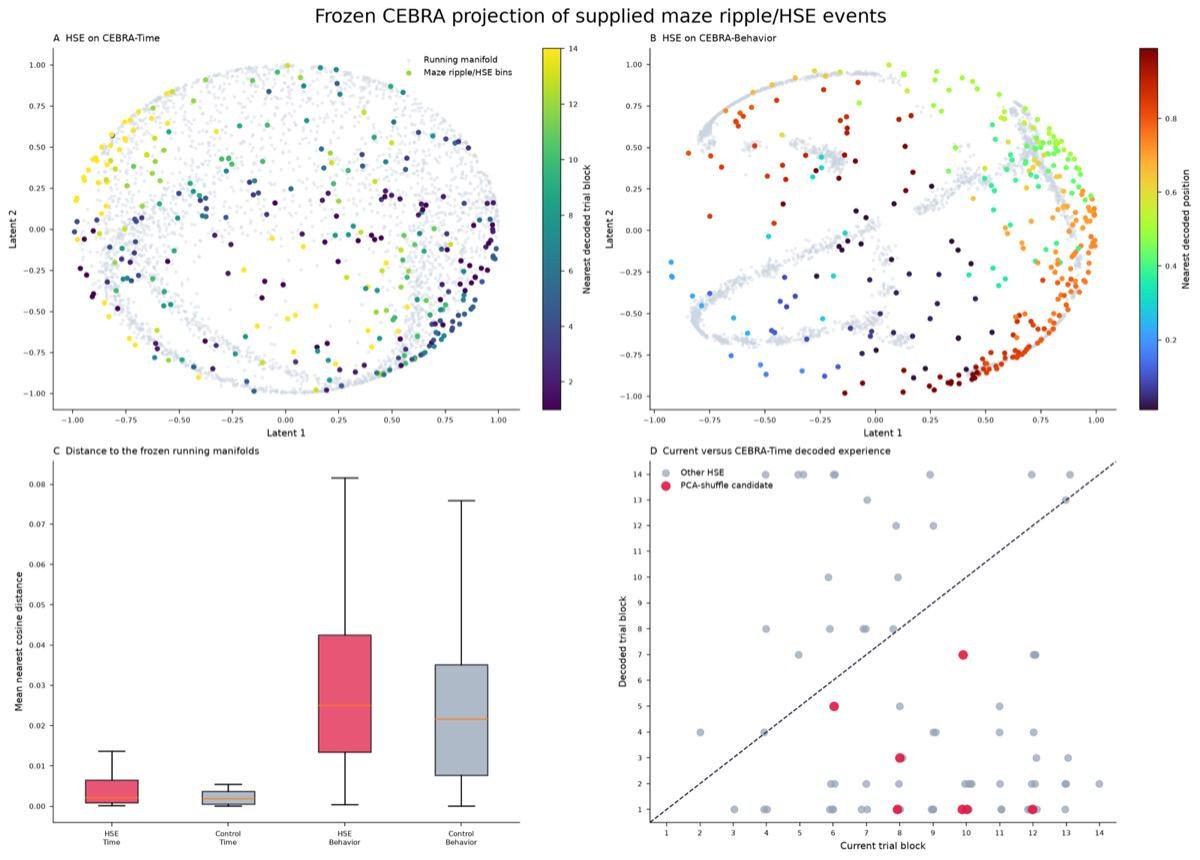
图9|迷宫 HSE 与时长匹配对照投射到冻结编码器后的距离比较
报告里也写了局限:HSE 和对照在 spike 数(110 对 32)和速度上都没有匹配好;79 个事件来自 41 个试次,不能当成独立样本;论文的核心命题,即清醒期回放如何选择随后睡眠中的巩固,在单会话试点里没有检验。它还去 PubMed 核对了原文。全文不是开放获取,它就写明不补写原文的方法细节。
最终它把原样输入、模型、全部图表、指标、零分布、哈希和复现脚本打成一个 99 个文件、19.7 MB 的总包,可以直接交付。
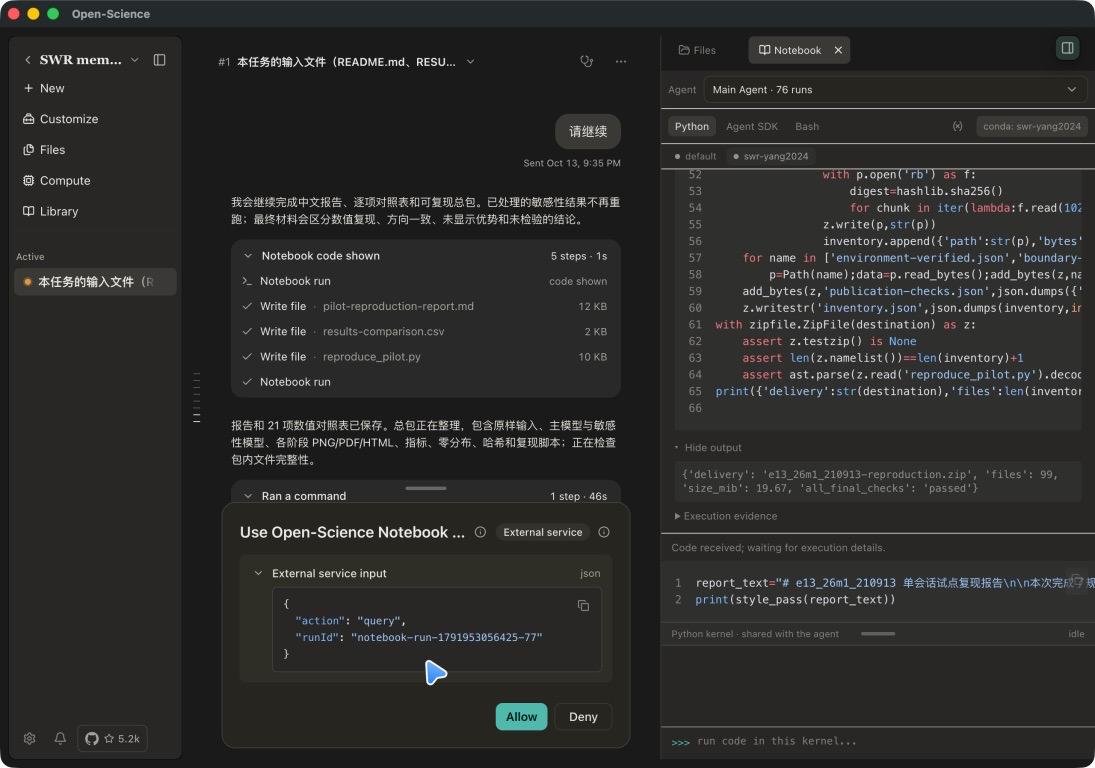
图10|会话结尾:中文报告、21 项对照表、复现脚本和 19.7 MB 总包都作为产出物发布
五、省下了什么
这次复现从开始到出报告,实际运行大约 7 小时,其余是网络中断和夜里没人看着的时间。中途断过几次网,每次会话都会标成失败,但已完成的步骤、产出物和计划进度一样都没丢,发一句"请继续"就能从断点接上。
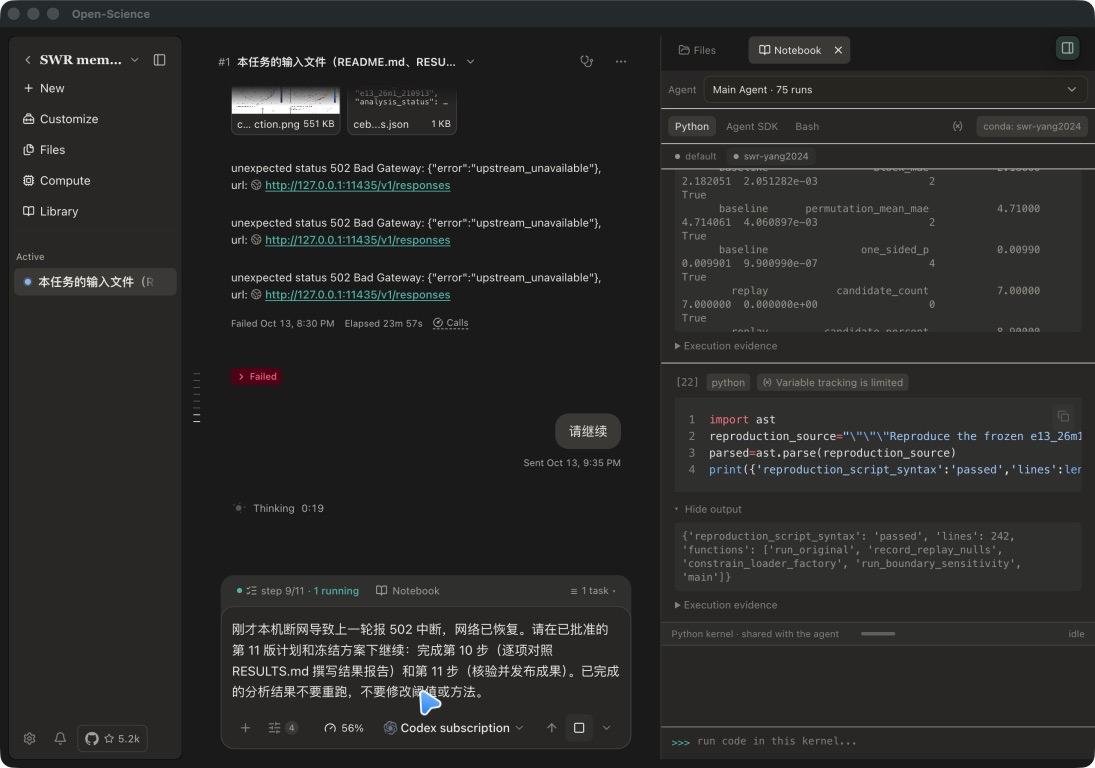
图11|断网导致上一轮报错后,发一句"请继续",Agent 从断点接着写报告
比起时间,我更看重另外三点:
-
方法在看数据之前就定下来了,讨论过程有记录。
-
它查出了我自己代码和配置里的不一致,并把"照原样复现"和"额外验证"分开做。
-
报告把结果分成"精确复现""方向一致""未复现""未检验"四类,技术失败不当作阴性结果。
从原始数据重跑一篇论文,最费劲、最容易出错的就是这几处。这次我的工作主要是审阅和拍板,代码基本没自己调。还是非常轻松的!确实Open-Science 可以大大降低科研门槛,说不定以后真的人人都能参与科研
他们官网上还有蛮多不错的user case可供大家观察,我也申请提交上传了,还在等消息,感兴趣的朋友可以在官网下载一些.science包,有完整的上下文,方便在本地复现,并开展进一步研究,可以去看看呀:https://aipoch.com/open-science/use-cases


