
如何用 Muse+豆包 Work +ChatGPT,做出高质量稳定的长视频
文章目录
9 月 25 日注册 Muse,到现在 20 多天,最近一直在用Muse测试视频生成能力。
我发现,长视频质量差,不一定是视频模型不行,可能是前面的提示词和首帧没定好。
我一共生成了 488 条视频,终于找到了 Muse video的版本答案!
我的实操测试过程,主要经历了三个阶段:
起初全交给 Muse; 后来把整片提示词交给豆包 Work; 最后又把首帧交给 ChatGPT。
一、从 10 秒试镜,到做出一整集
最开始,我是在 X 上看到别人发的 Muse 视频,画面看着不错,就想自己试试。
我就把在 Seedance 用过的提示词拿过来,先试了一个镜头。画面、运镜和气氛都还可以,我想,能不能拿它做一部 3 分钟一集的漫剧?
Muse 生成的视频是固定10 秒,按3分钟这个长度拆,就是 18 个分镜。
我把剧本交给 Muse,让它按这个顺序往下做:
剧本 → 分镜表 → 人物、场景和道具参考图 → 锁定资产 → 逐镜生成 → 拼接。
我让 Muse 去读 Seedance 的提示词技巧,调整人物和场景的描述、运镜。
拆分镜、写提示词、生成人物和场景参考图、生成视频、拼片,这些都由 Muse 来做,我主要负责拍板和审片。
人物长什么样、穿什么衣服,场景里有什么,我先看参考图,满意了就定下来。后面的分镜反复用同一段描述,一个字都不改。视频也是一镜一确认,这条我看过了,才继续做下一条。
《长安异闻之无主宫灯》, 纯Muse 成片:
这样确实把一集做出来了,但不过中间也没少返工。
二、豆包 Work+Muse复刻天宫系列视频
接下来,我想试试之前很火的天宫系列视频,做一条三分钟的长片。
具体每个镜头拍什么,我当时还没想好,就先把这个想法交给了豆包 Work。
用豆包work,是因为字节Seedance 在视频模型中本身就是最强的,字节系的豆包 Seed2.1 看视频、理解镜头的能力,我用下来也觉得不错。
让它找抖音、TikTok 上同题材的视频,再查 Seedance 官方的提示词技巧,这种能力在豆包Work中可以直接完成。
给豆包 Work 的指令:
按 10 秒一个镜头,写一条三分钟天宫视频的提示词;先去全网找这类爆款视频,总结它们的内容和拍法,再输出提示词。
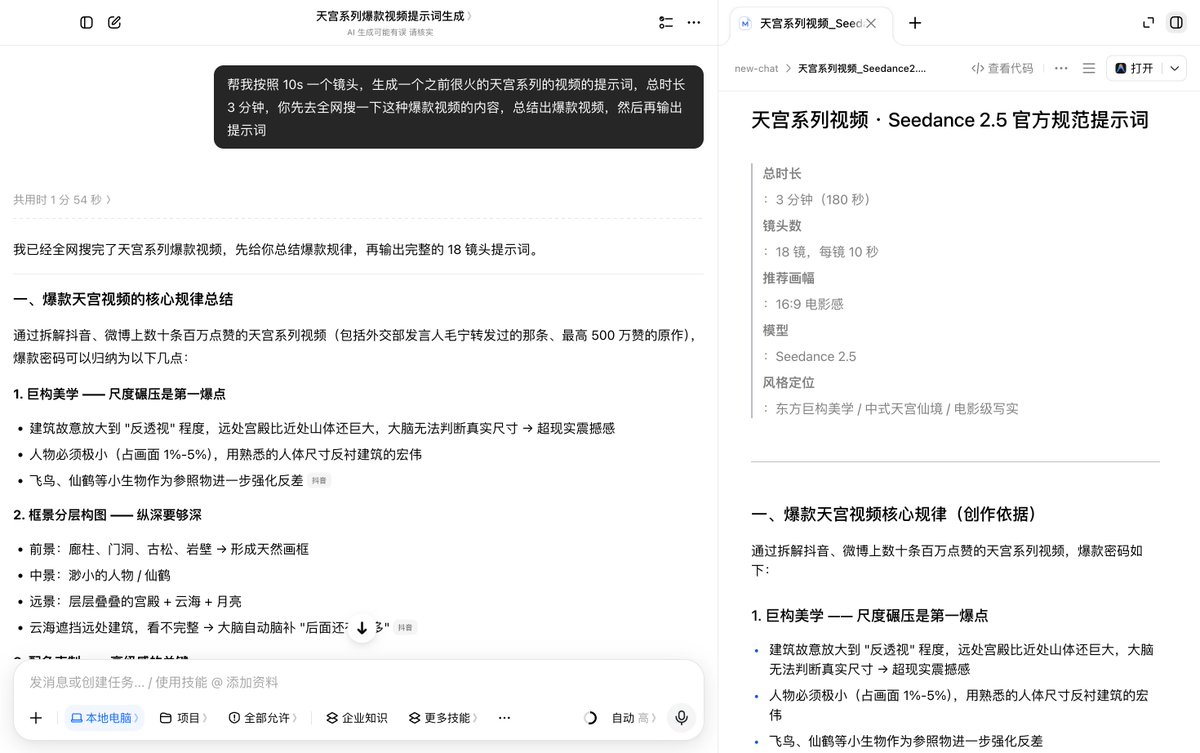
它先给了我一份天宫视频的规律总结。比如宫殿要大、人物要小,用比例差把建筑衬出来;前景放廊柱、门洞或古松,后面再放云海和宫殿,让画面有层次;颜色要克制,镜头要慢。
看完这些,再看它后面写的分镜,就知道为什么要这么安排了。整片从云海初现开始,经过南天门、石阶长廊、主殿、瑶池和月宫,最后再用全景收住。三分钟先有了一个完整的顺序。
这份方案一共 18 镜,每镜 10 秒。每镜先写 0 秒的画面,再写这 10 秒里怎么动,最后交代结束构图和下一镜怎么接。第一镜叫“云海初现”,我摘几行:
0 秒:云海里只露几座宫殿飞檐,白衣女子站在画面右下角。0~3 秒:镜头慢慢前推,云海缓慢流动。3~7 秒:镜头轻轻上摇,飞檐从一座露到三座。7~10 秒:继续前推,宫殿仍被云雾遮住大半。结束时保留云海和飞檐,下一镜接南天门。
我觉得这份方案好用,就好用在这些细节里。第一镜只露宫殿的一部分,后面再慢慢往里走,画面怎么展开,已经想好了。
接着,我把整份提示词文档发给 Muse,让它先出每个分镜的首帧参考图。我看过图,再让它按图生成视频,逐镜选好以后拼起来。
《云宫迅音》豆包Work+Muse成片:
这次做下来,我审片时轻松了一些,前后镜头怎么接,提示词里已经交代过,不用等生成以后再临时想办法。
三、豆包Work+ChatGPT+Muse输出高质量成片
这条天宫视频做完以后,我又想沿用这个办法,试一条吉卜力动画风格的集锦,把小镇、海边公路、云海花园、海上电车这些画面串起来。
我还是先让豆包 Work 写完整片方案,再照原来的流程,交给 Muse 出首帧。
第一镜是清晨的小镇。Muse 画出了红屋顶、房子和海鸥,但屋瓦和远景比较淡,整体像一张水彩稿。我看着这张图,总觉得拿它去做视频,画面还差点意思。
Muse 生成的首帧:
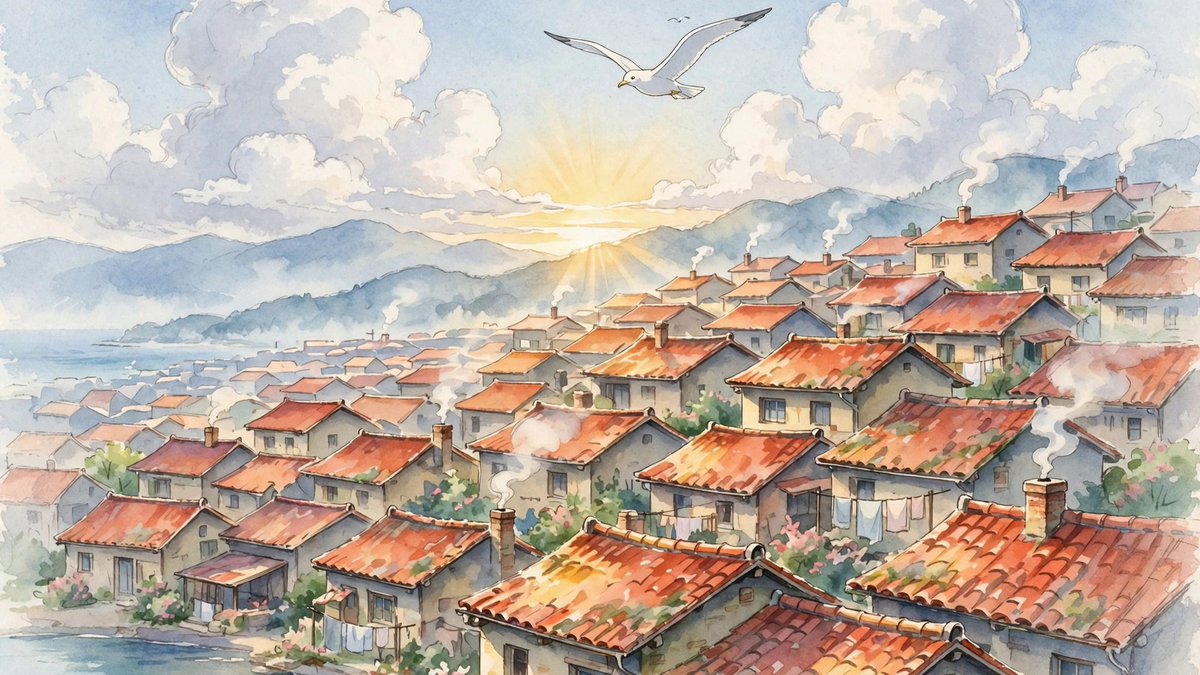
muse生成的分镜首帧参考图
于是我把豆包 Work 写好的整份创作提示词方案,发给生图能力最强的ChatGPT,让它按里面的分镜用GPT Image 2.5来出首帧参考图。
换过去之后,屋瓦、墙面、海湾和远山的细节清楚了不少,晨光也更接近我想要的样子,ChatGPT 这张图的 AI 味也更轻。
ChatGPT 生成的首帧:
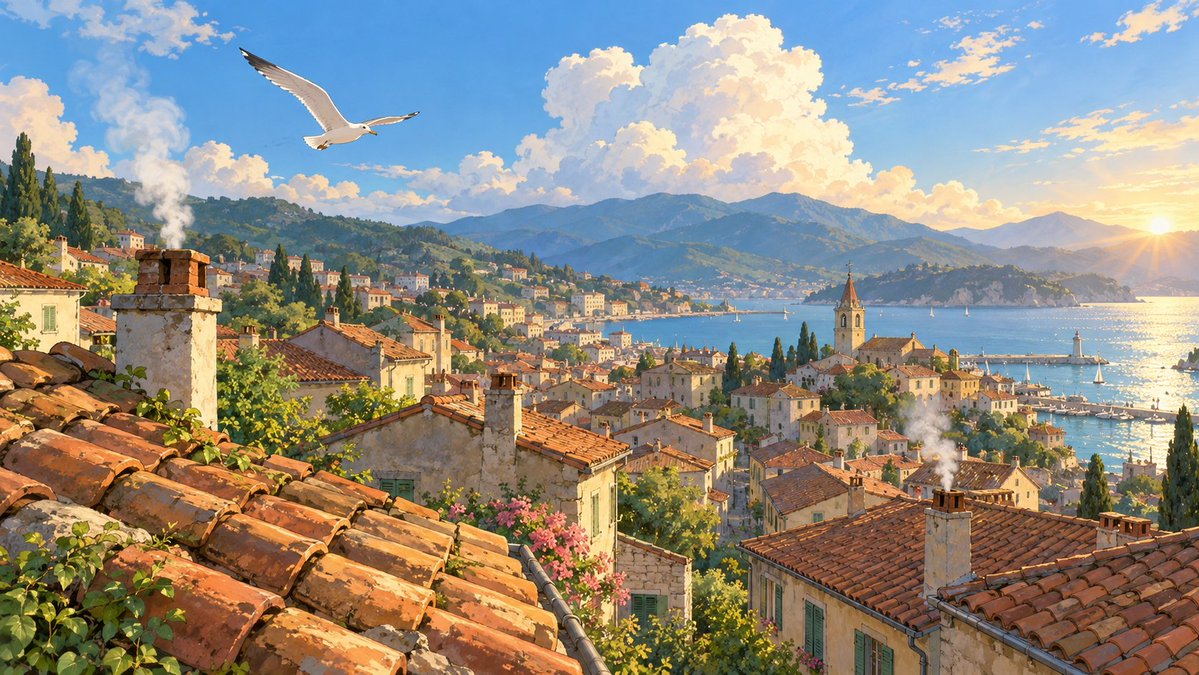
ChatGPT 生成的首帧参考图
我最后选了 ChatGPT 出整体的参考图,Muse 照着首帧生成视频,人物、构图、场景和光线都从分镜首帧参考图往下走。
把图先定好,后面的视频也更容易接近我想要的效果。
这条集锦一共 21 镜。我用 ChatGPT 做了 21 张首帧,一张张看,一张张改;确定以后,再把每张图和对应的 10 秒提示词交给 Muse 生成视频。
视频出来,我逐镜挑选,最后把选中的 21 条拼成 3 分半的成片。
《宫崎骏动画集锦》豆包Work+Chat GPT+Muse成片:
Muse视频生成用免费额度,反复试镜头的成本比较合适;前面的提示词和首帧定好以后,Muse 按图生成的效果也不差,这样的视频质量比全靠Muse直出稳定多了。
四、Muse长视频创作流程总结
第一步,先和豆包 Work 把整片方案定下来
题材、总时长、画幅先说清楚,再让它查官方技巧、找同题材视频,按 10 秒一镜写出完整方案。
先从头看一遍,每镜拍什么、怎么动、结束时停在哪、下一镜能不能接上。人物、场景、道具的描述一旦确定,后面就原样复用,不让它随手换个说法。
第二步,把这份方案交给 ChatGPT 出首帧
先让它看懂全片的风格,再一镜一张出图。我主要看人物、构图、场景和光线,图不满意就先改图。每张图都确认了,再交给 Muse 做视频。
第三步,Muse 逐镜生成,逐镜选片
先看这一镜本身有没有问题,再和前后镜头放在一起看。人物有没有变,动作和运镜有没有跑偏,接上去是不是顺。
如果一镜试了 10~15 次还不对,就简化动作,或者换一种拍法。原生对白总做不出来,也回头改镜头设计。这个时候继续加生成次数,往往只是重复碰同一个问题。
第四步,让 Muse 拼接,再完整看一遍。
例如《宫崎骏动画集锦》的 21 镜做完后,我让 Muse 写 ffmpeg 脚本,先统一到 1280×720,再按顺序拼接。生成的镜头里有 3:2,也有 16:9,得先把画幅处理好。
音乐换了三版,才换到想要的演唱版;水印位置不合适,也返过工。最后我从头看到尾,重点看每个切镜的地方,再听音乐和环境声合不合适。
工具可以帮我把这些步骤做完,但哪张图能用、哪条视频留下、成片要不要再改,还是得我自己看。
五、总结
这套流程测试下来,我最后固定下来的分工就是:
提示词用豆包 Work,参考图用 ChatGPT,视频用 Muse。
豆包 Work 更懂视频,我让它找参考、查官方技巧,把整片怎么拍、每个镜头怎么接先写明白。
ChatGPT 的生图效果更合我心意,画面清楚,AI 味也轻。我用它把人物、构图、场景和光线先定好,再交给 Muse 生成视频。
Muse 的视频能力不差,目前用免费额度反复试镜头,性价比也合适。前面的提示词和参考图做好了,它生成的视频质量也更稳定。
回头看,我每次只调整一环,慢慢才找到这套做法:影响画面质量的地方,交给我用下来能力最强的工具;需要大量生成、反复挑选的地方,就兼顾效果和成本。
这也是我现在用 Muse 做长视频的核心方法。把各家的长处用在同一条片子里,最后由我来审图、选片、验收。
我是 Jarvis,用 AI 做一人公司的独立开发者,公开记录 AI 商业实验。持续享自己使用AI有价值的实操过程,如果觉得这篇文章对你有帮助,欢迎转发评论收藏,感谢支持❤️
另附其他Muse视频成片:
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


