
视频反推提示词的通用流程
可直接复制的拆解指令:
请根据参考视频,重建一个可执行的视频生成与剪辑方案。

不要猜原作者的提示词,也不要只罗列人物、场景和风格标签。

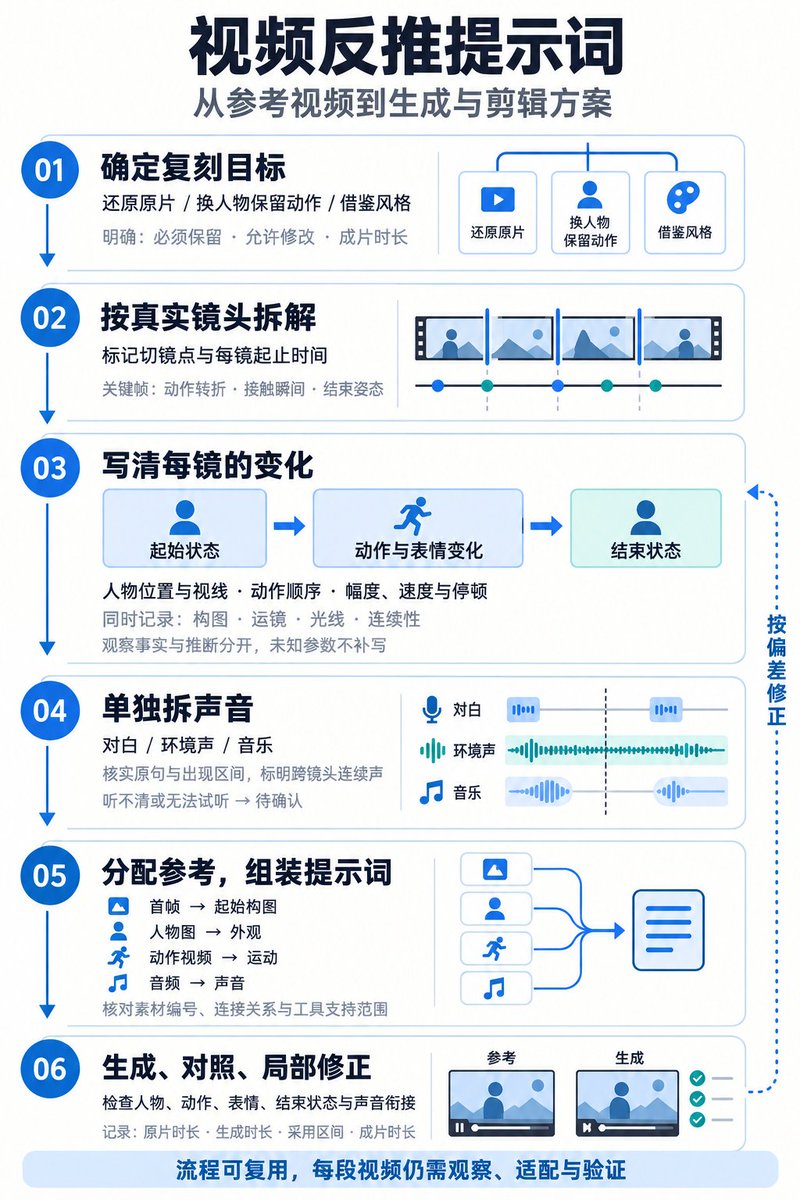
一、识别结构
记录视频时长、画幅、真实切镜点,按镜头分段。
时间不能精确确认时,标注为约值。

二、拆解每个镜头
记录:
- 人物与环境的起始状态;
- 视线对象、动作和表情变化的先后顺序;
- 动作幅度、速度、停顿和明确的结束状态;
- 景别、前后景关系、可见运镜与光线变化;
- 需要保持的身份、服装、站位和空间关系。

选择切镜点、动作转折点、接触瞬间和结束姿态作为关键帧,
不必逐帧罗列。

三、单独拆解声音
分别记录对白、环境声、音乐及其出现区间。
注明哪些声音连续跨越镜头,哪些声音随动作出现。
听不清或无法试听的内容标为待确认,不补写台词或声音事实。

四、确定参考素材的职责
明确每张图片、每段视频和音频分别负责:
人物外观、起止画面、动作、机位、场景或声音。
核对实际素材编号和连接关系。

五、编写生成提示词
每镜包含:
起始状态 → 核心变化 → 动作节奏 → 结束状态。
有首帧时以动态描述为主。
仅保留必要的连续性约束和针对性限制。
把直接观察、合理推断、生成选择分别标明。

六、输出完整执行方案
- 逐镜视频提示词;
- 声音处理说明;
- 生成时长与剪辑采用区间;
- 镜序、转场和跨镜头声音安排;
- 对照参考的验收清单;
- 尚未确认或当前模型不支持的事项。
全文完


