
多 Agent 现在到底能干到什么程度?我组了一个 AI 团队实测了一轮
文章目录
我越来越觉得,多 Agent 的下一步不是一个人指挥更多 Agent,而是多个人和多个 Agent 在同一个群、同一份上下文里一起干活。Teamily AI 是我目前看到认真做这件事的 Humans + Agents 平台。
但用多 Agent 干活,我最怕一种情况:第一个 AI 理解错了,后面几个顺着这个错,越干越卖力。
这周我就在 Teamily AI 拉了一个群实测:三个 AI 成员,再加一位一起合作的伙伴,拿 2.0 的 Website Builder 给我那门还没上线的 AI 编程课做宣传页。中途我改了一次关键前提,看看它们能不能跟上。
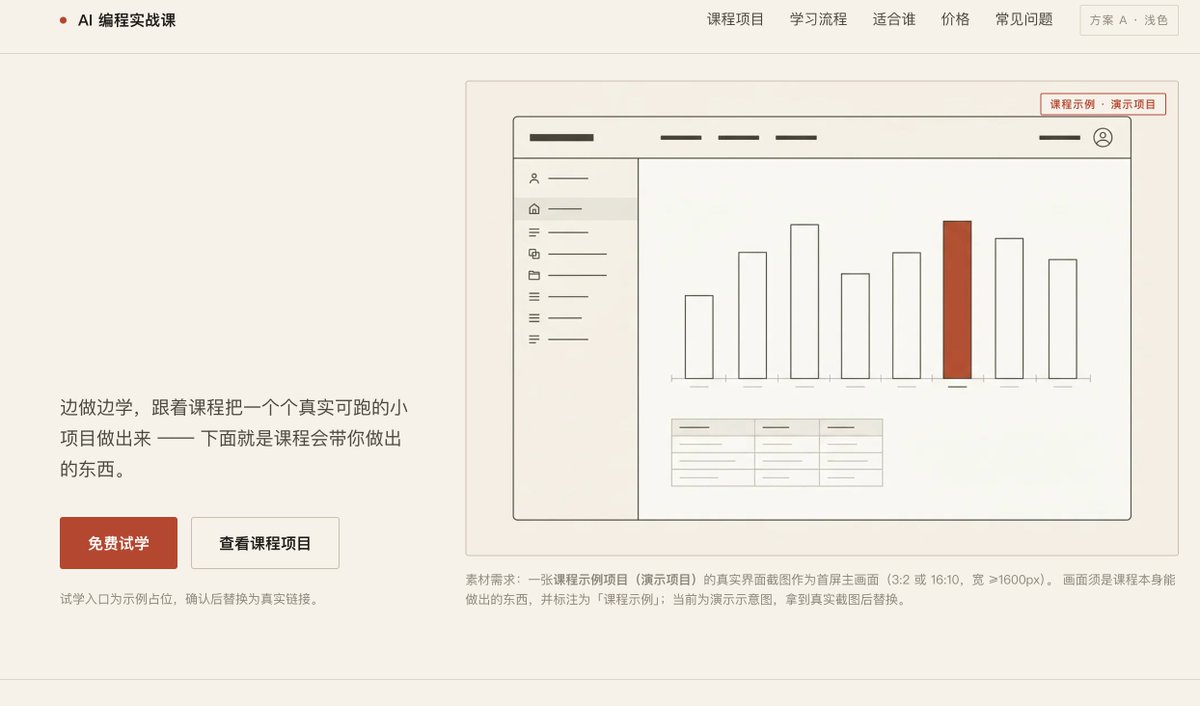
先看最终成果:
我想借这次实测回答三个问题:
-
现在的 AI 团队怎么分工、怎么交接?
-
中途改需求,它们能不能接着推同一个项目?
-
最后交出来的东西,人还得管多少?
一. 几个 AI 一起干活,为什么反而容易跑偏
先说我为什么会怕。
多 Agent 的思路很好理解:一个 AI 查资料,一个写文案,一个做网页,像个小团队。但用过就知道,人类团队有的毛病,它们也有。
-
错误会被接着用:前一个 agent 的输出,就是后一个的工作材料。一个没核实的判断,可能一路流进成品。
-
交接会丢条件:结论传过去了,但"这条只在某种情况下成立""这份资料还没确认"这些条件,没跟着传过去。
-
各干各的不等于干完:文案写了,网页也生成了,可没人回头看它还符不符合最开始的需求。
这不是我拍脑袋。UC Berkeley 团队有一篇研究,把多 Agent 系统的失败归成三类:系统设计本身有问题、agent 之间配合出错、最后没人好好验收。
当然,单个 AI 连续干活也会一错到底。多 Agent 只是多了交接和协调两个环节,也就多了两个出错的口子。
二. 那该怎么判断一个 AI 团队靠不靠谱
我给自己定了三个观察点,后面的实测一条条对:
-
分工清不清楚:谁负责什么,下一步要等谁的成果。
-
改动能不能传下去:我中途改了要求,相关环节有没有跟着调。
-
交付前有没有人检查:查了什么,拿什么查的,查出问题怎么办。
第三条是我最在意的。Anthropic 工程团队写过他们做长任务的做法是,把规划、制作、评估拆给不同角色,负责评估的那个要去实际打开应用检查。但加一个审核 agent 也不等于就可靠了,审核的也可能看漏。
还有个前提得先说。Google 研究发现,多 Agent 并不是在所有任务上都比单 Agent 强,任务适不适合拆,结果差别很大。
所以这次我只测一件事:一个本来就适合拆成调研、文案、网页、审核的真实任务,一个 AI 团队能做到什么程度。
三. 开始实测:把课程资料交给一个 AI 团队
背景是这样的:我在做一门 AI 编程课,大纲改到了 v2.2,但课还没上线,需要先有个宣传页。
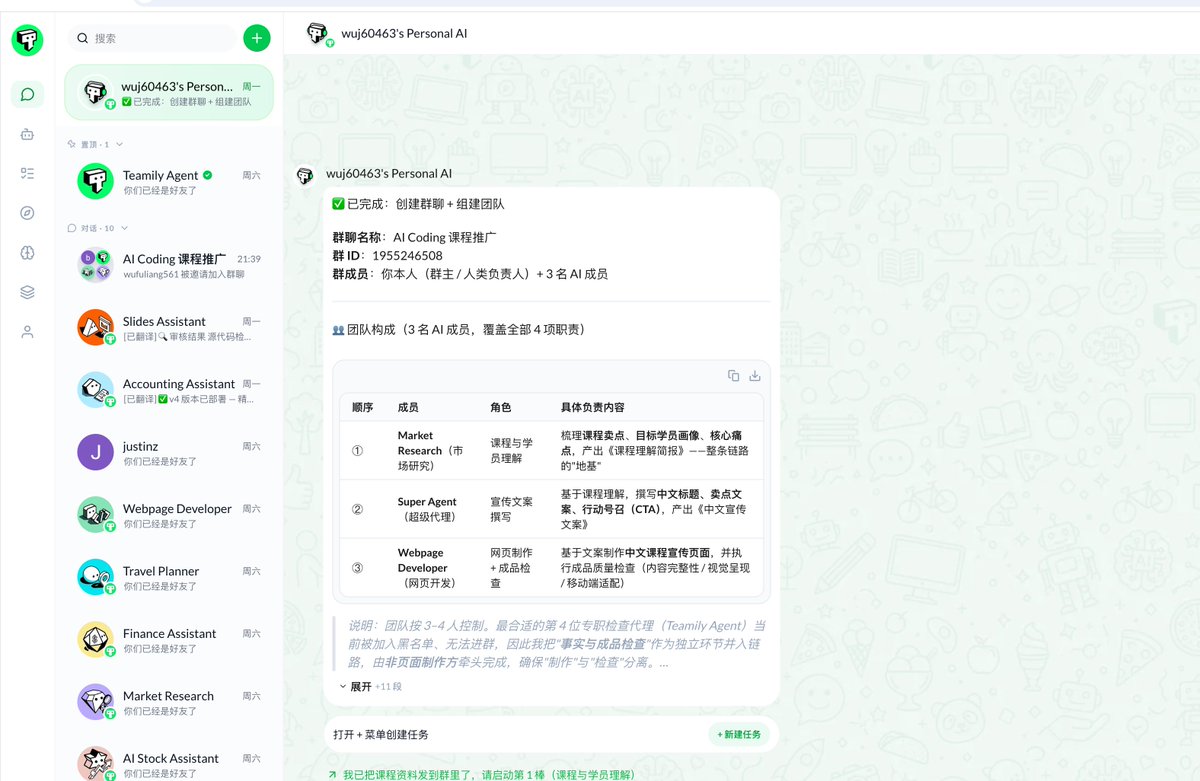
我跟 Teamily 里的 Personal AI 说:帮我建一个"AI Coding 课程推广"群,成员你来定,控制在 3 到 4 个,先把队组好,我再给资料。
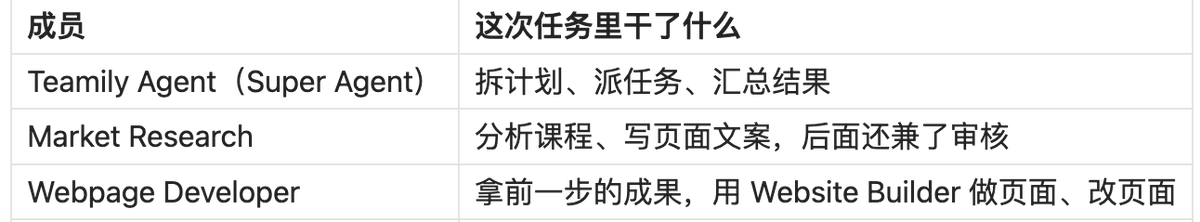
它建出来的群,是我加 3 个 AI 成员。后来我又把一起合作的伙伴拉了进来,请这位伙伴站在读者的角度看页面:
然后我把两份资料丢进群里,顺便讲清楚页面给谁看、要达到什么效果、哪些事实不能编。
接着群里出现了一份三步执行计划。我最想让你看的是一个小细节:第二步后面标着 depends on #1,第三步标着 depends on #2。
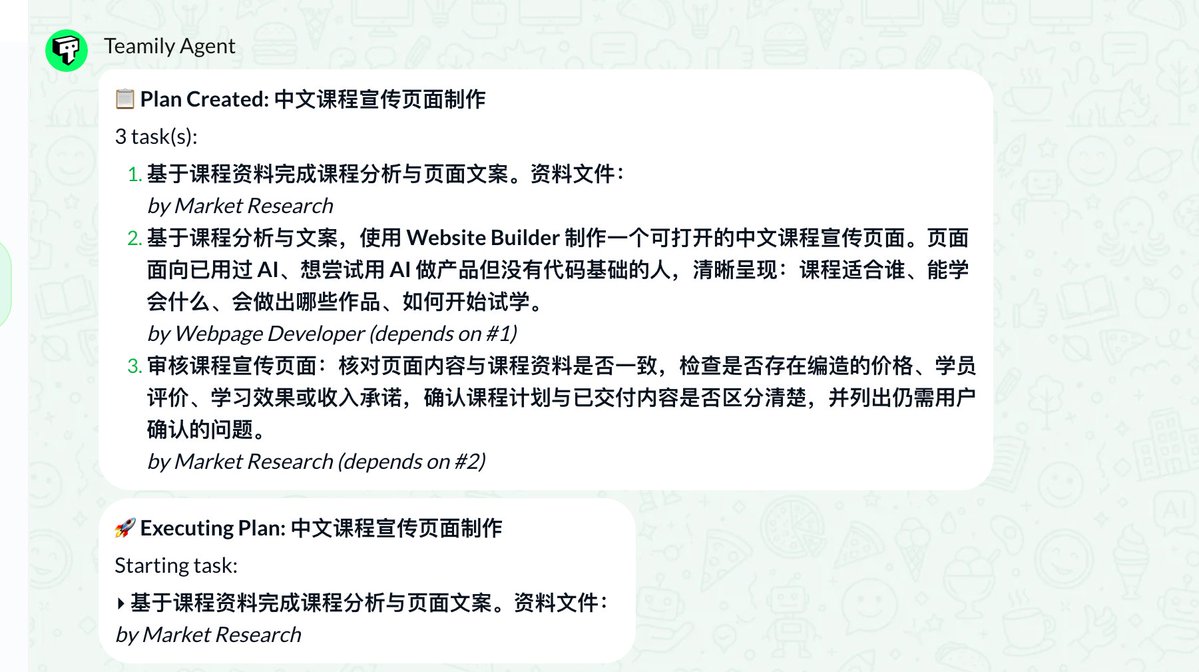
也就是说,它们不是三个 AI 同时开工、各写各的。Webpage Developer 要等 Market Research 的文案出来才动手,有先后,有交接。
第一个观察点,分工这块,它是清楚的。
四. 第一版出来,我不太满意
第一版很快就出来了。深色背景、橙色渐变、发光按钮,很有 AI 产品那味。
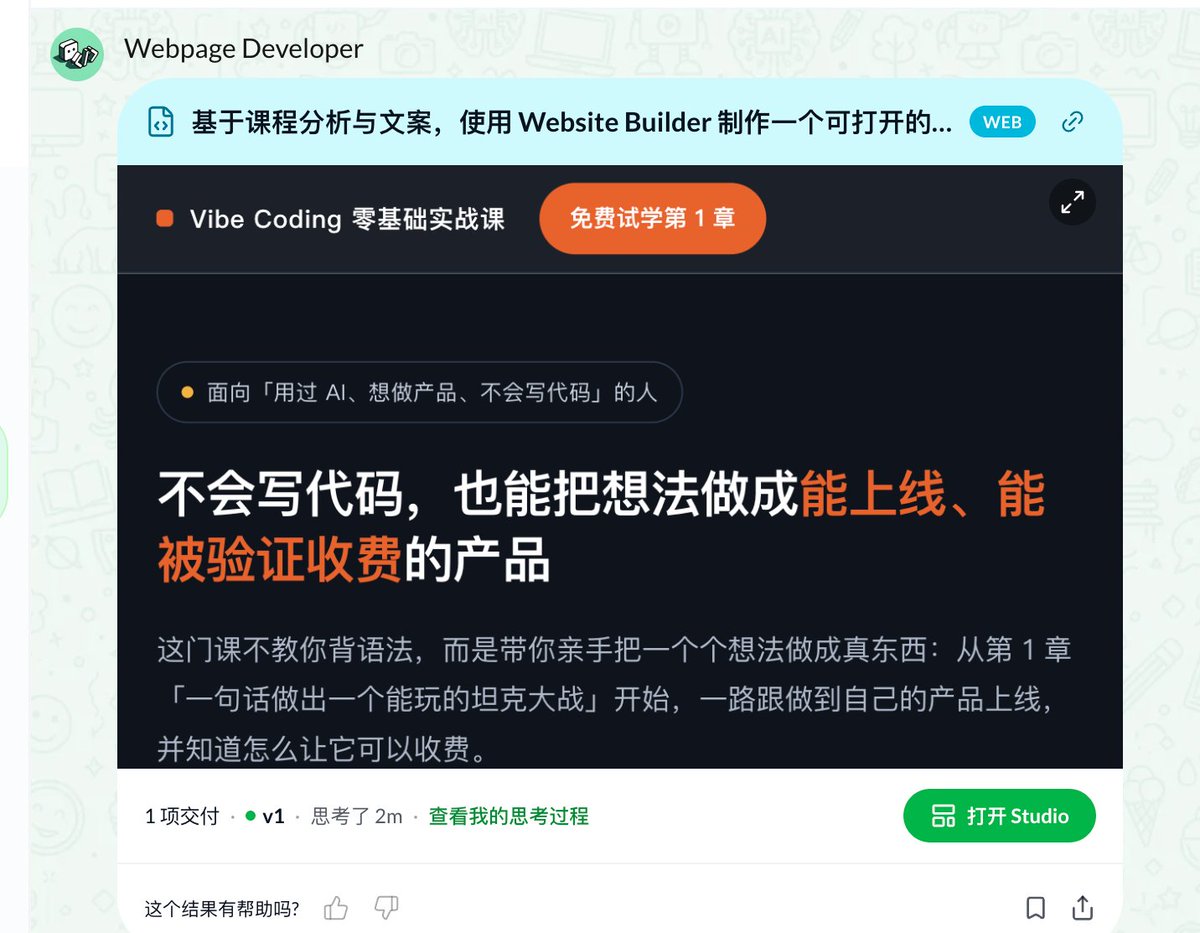
但我看完挺不满意的:
-
标题断行很别扭,"能上线、能被验证收费"被拆得七零八落。
-
流程卡片和大段文字堆在前面,我最想让人看到的项目反而压在后面。
-
发光和渐变太多,看久了有点累。
伙伴看完第一版,在群里就回了一句:这个版本 AI 味太重了。
这话说得比我还直接。我列的那几条,其实都是这个意思。
还有一个更要紧的问题。课程作品这块,我得先跟它们说清楚:没有学员作品集,因为这门课还没上线。这里只能讲课程会带你做出哪些项目,不能写成已经有学员做出来了。
"课程作品"和"学员作品"只差两个字,代表的事实完全不一样。课还没上线,写成后者就是在编。
所以我把这些,连同伙伴那条,攒成一轮整改意见发进群里:标题控制在两行、按意思断行,项目往前放、流程往后放,少一点发光渐变,作品只按课程项目的口径来写。
五. 一条意见,几个 agent 一起接
这一轮我最想看的,就是改动能不能传下去。
Super Agent 收到意见后重新排了一遍任务:Market Research 先精简文案,把作品的口径改成课程项目,Webpage Developer 再拿新文案用 Website Builder 重排页面,最后回到 Market Research 做审核。
这轮意见是直接发在群里的,Super Agent 自己拆给了每个成员。
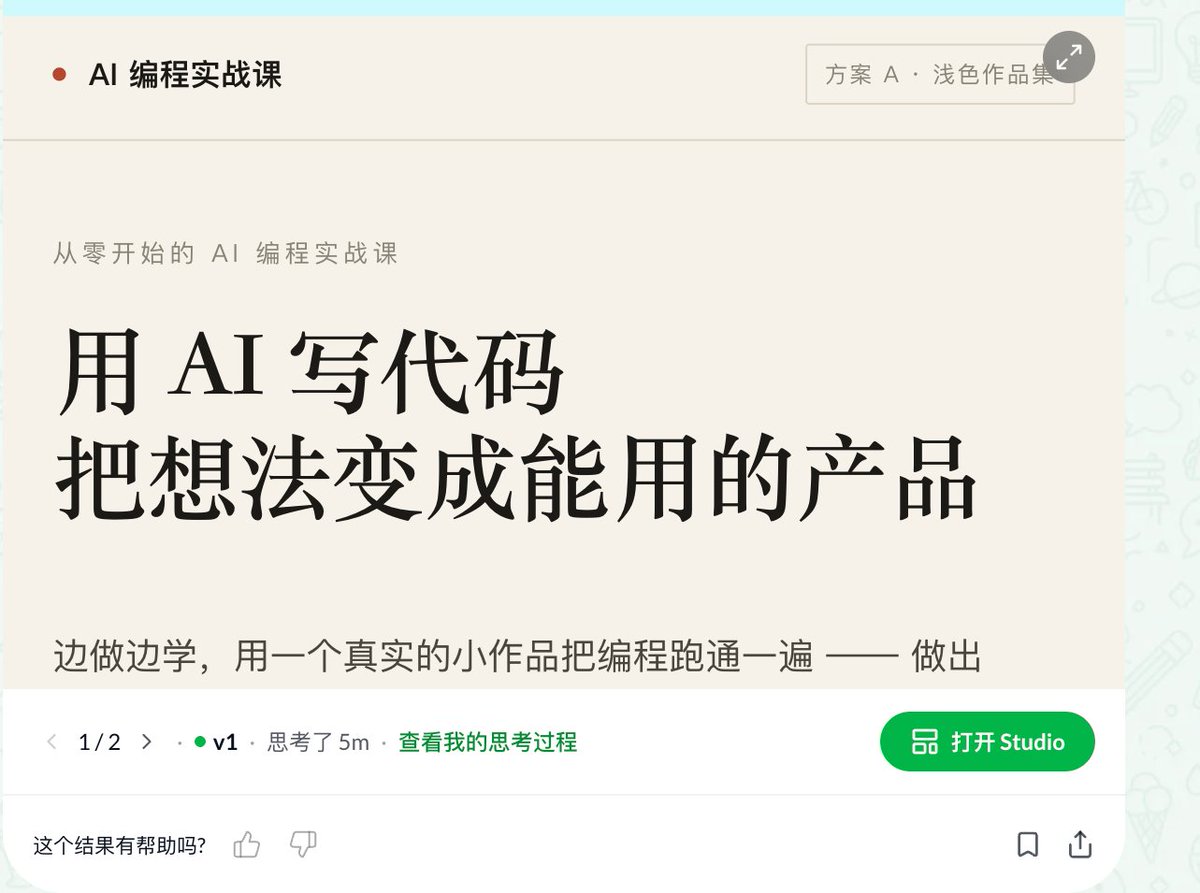
改版出来,变化是能直接看到的:
-
首屏标题压成两行,按意思断开。
-
风格从深色发光换成了浅色、偏杂志感的排版。
-
项目板块提到了前面,示意图右上角挂着一个小标签:课程示例 · 演示项目。
-
价格、试学链接这些我自己都还没定,我让它先用示例占位。页面顶部挂了一条提示:本页为演示版,所有项目、价格、链接均为示例占位,非最终内容。
我从这一轮拿到两条经验。
第一,反馈越具体,团队越容易把修改落到每一个环节。只说"再好看点",几个 agent 只能各自去猜。
第二,业务前提得人来拦。"课还没上线"这件事是我提的,不是 AI 自己发现的。它们做到的,是我说了一次以后,这个修改从文案一路传到了页面上。
错误的前提如果没人拦,就会流进成品。这次拦它的人是我。
六. 审核 agent 到底查了什么
Market Research 后面兼了审核,交了两份报告,一份审第一版,一份审改版。
挑两个它真找出来的问题:
-
项目编号和工具名称,前后口径不一致。
-
改版预览里的试学、目录按钮,链接还是占位锚点,点了哪儿也去不了。
但第一份报告里还有一句话,我觉得比找出的问题更重要。它明确写了:没法直接调取那两份课程大纲原文,部分判断依据的是页面自身前后一不一致,加上上游成员的记录。
也就是说,它判断没问题的地方,有一部分并没有对着原始资料核过。它愿意把这一点写出来,我反而更信它一点。报告里还记录了测试数量,这个数我没有自己复测,就不转述了。
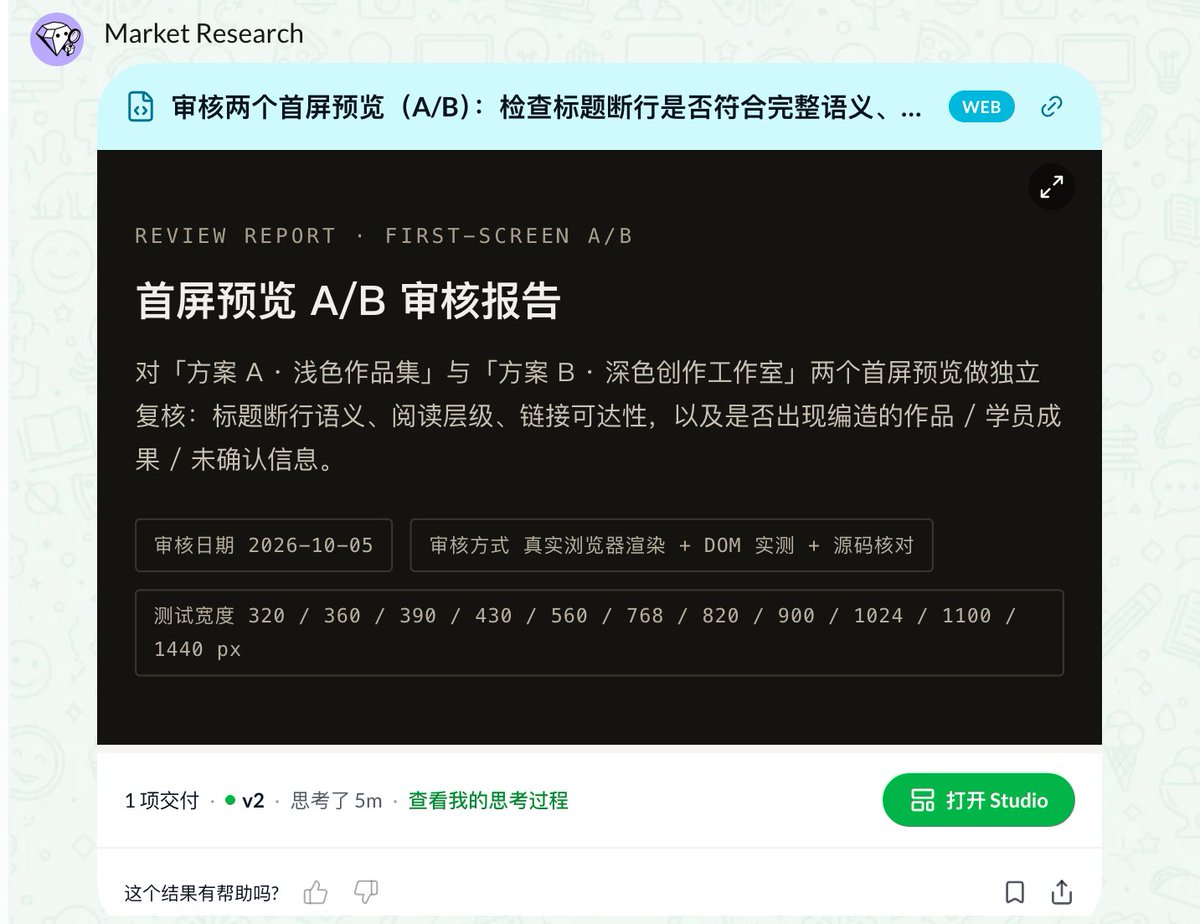
所以我现在看到任何"审核通过",都会多问三句:拿什么资料核的?实际查了哪些?哪些没查?
七. 最后交付了什么
最终交出来的是一个能打开、能分享的课程宣传页 Demo,有首屏、课程项目、学习流程、适合谁、试学说明、示例价格和常见问题,可以直接打开看:课程宣传页 Demo
这次我确实看到它们做到的:
-
组队和排任务:按目标自己拉人,排好谁先谁后。
-
一路推到交付:从读资料、写文案,到网页和审核报告。
-
接住反馈:一轮整改意见,文案、页面、审核都跟着动了。
-
跟着事实改:我补了一个前提,已有内容跟着调整。
还得我自己来的:
-
好不好看、话说得合不合适,最后还是我拍板。
-
课程现在到底什么状态,这种业务事实只有我知道。
-
定方向、补真实素材、最终验收。
也说清楚这次测不了什么。我没拿单个 Agent 做对照,所以没法说它快了多少,更不能说多 Agent 解决了幻觉。这个页面也是 Demo,离能直接招生收款还差真实素材和定价。
写在最后
如果你也想试试,我自己会这样做:
-
一开始就把目标、资料和不能编的事实交代清楚。我这次就是一开始没强调"课还没上线",后面才返工。
-
过程中盯交接,别只看最后的成品。
-
看到"审核通过",去翻它到底拿什么核的。
回到开头那个担心,前面理解错了,后面会不会顺着错下去?这次的答案是会,但只要人中途说一句,它们能把改动一路传到页面上。
这也是我对 Teamily AI 最直观的感受:人和 Agent 在同一个群、同一份上下文里干活,我的意见、伙伴的意见、Agent 的产出,都在一条线上往下走,越做越像一个真的团队。
从第一版到最终版,中间就改了一轮。我最大的收获其实是学会了怎么给一个 AI 团队提需求。
这次用的是 Teamily AI 2.0 的 Website Builder,想自己组个 AI 团队试试,可以走我的邀请链接https://teamily.ai/i/T93CGM
@Teamily_AI


