
90%的AI视频一眼假,真正缺的是这几个“活人感”细节
文章目录
大家好,我是李岳
前端时间我一直在用 Seedance 2.5 做一些30秒左右的情侣日常视频。
很多剧情其实很简单。
比如:
“你脸上有东西。”
或者:
“手机给我。”
真正写成故事,可能几十个字就结束了。
但最后交给 Seedance 的提示词,往往会变成几百甚至上千字。
为什么?
因为我后来发现:
AI视频提示词真正难的是先想清楚“人物的活人感到底应该怎么演”。
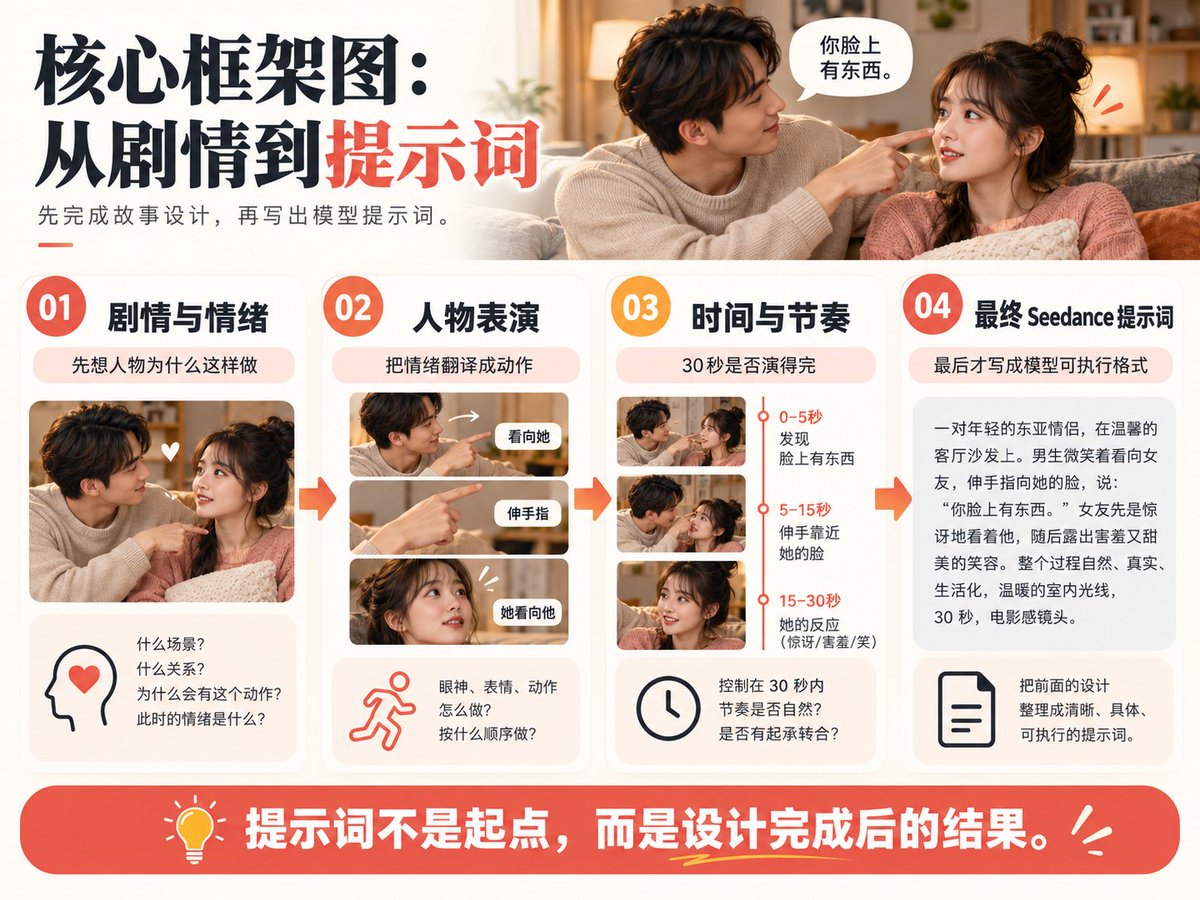
所以我现在出一条视频,大致会经过三层设计:
第一层:剧情和情绪
人物为什么这么做?

第二层:表演
这个情绪具体怎么表现出来?

第三层:时间
30秒到底够不够演完?
这三层都设计清楚以后,我才开始输出最终的提示词。
第一层:先设计“人物为什么会这么做”
我最开始做 AI 视频时,经常直接写:
女友生气。 男友解释。 两个人对视。 男友靠近。 女友害羞。
故事是通的。
但生成出来以后,经常感觉人物像在执行命令。
因为:
剧情告诉了 AI “发生了什么”,却没有告诉它人物为什么从一种状态变成另一种状态。
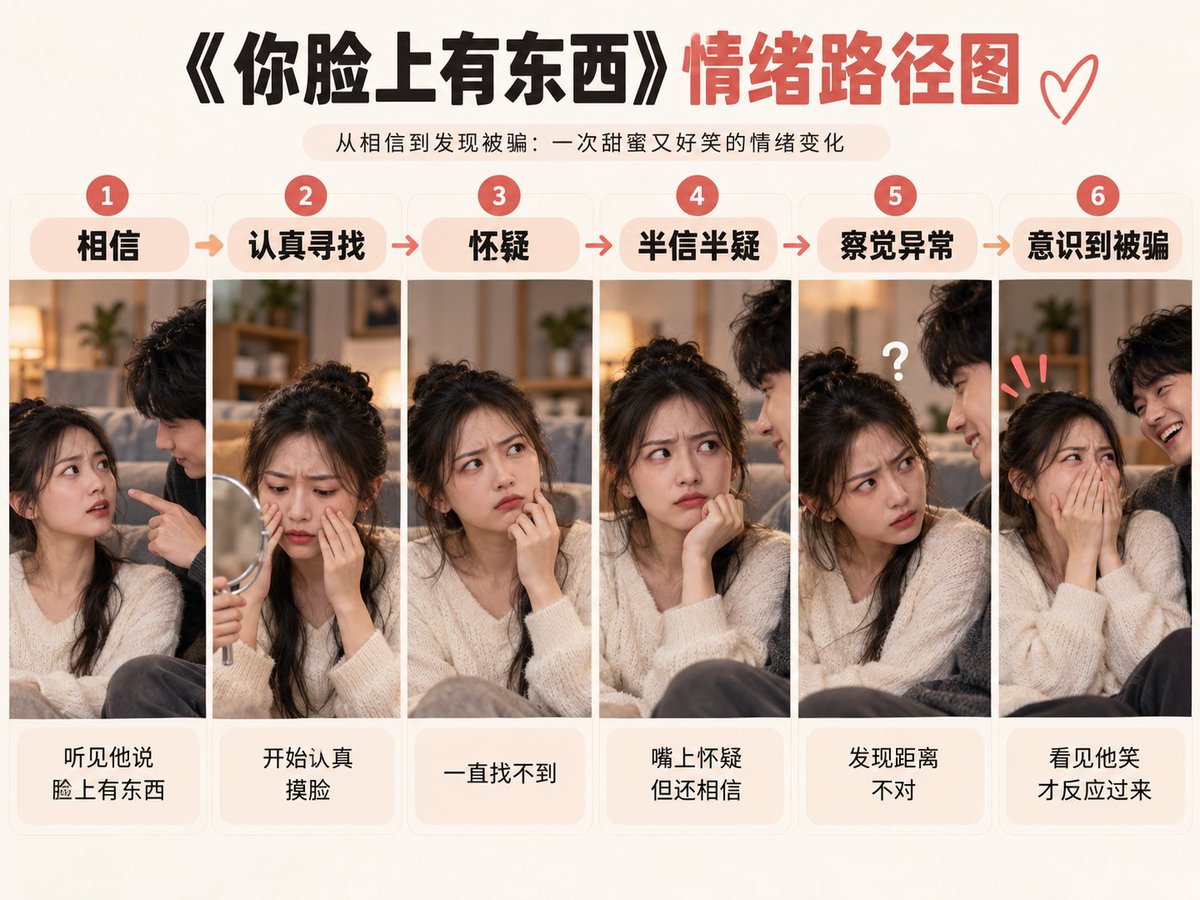
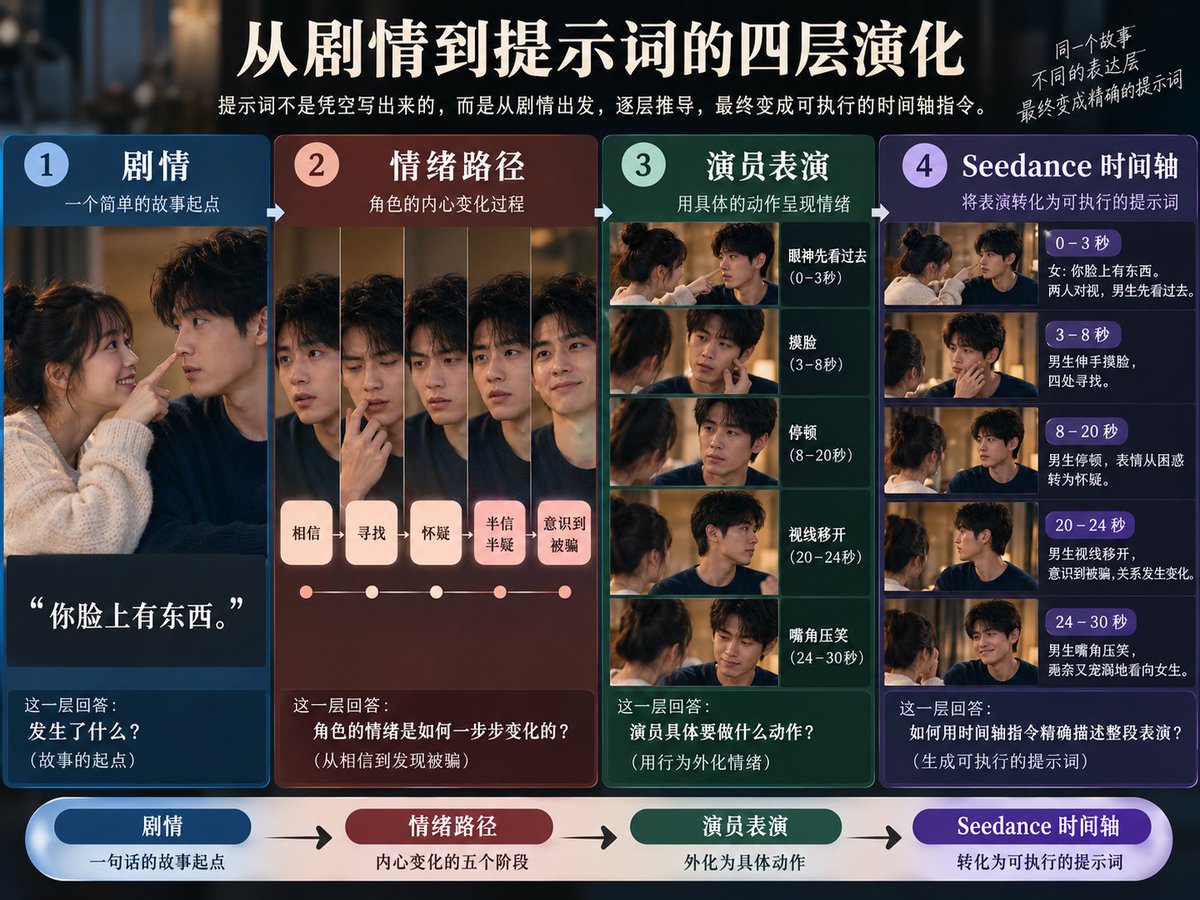
所以现在我会先画一条非常简单的:情绪路径。
比如《你脸上有东西》这个视频。
一开始女友相信男友。
然后:
相信
↓
认真寻找
↓
发现一直找不到
↓
开始怀疑
↓
半信半疑
↓
主动让男友帮忙
↓
发现两个人距离不对
↓
意识到被骗
这个过程一旦成立,后面的动作才会自然。
这一层最关注两个问题
- 情绪有没有跳?
比如:
前一秒还在生气。
下一秒突然害羞。
通常就会显得很假。
中间应该有东西把两个状态连起来。
可能是:
一次对视。
一句话。
一次停顿。
或者两个人距离突然发生变化。
- 后面的动作有没有前因?
比如情侣视频里很容易出现一个问题:
两个人正常聊天。
男主突然靠过去。
这时候观众很容易问:为什么?
所以我现在经常先设计:“靠近的理由”。
比如《你就是故意的》。
女友为了抢手机,不断往男友方向倾。
最后抓住他的手。
等她抬头时才发现:两个人已经离得很近。
这时候关系变化就是从前面的动作自然长出来的。
而不是为了后面的剧情,强行让人物靠近。
第二层:把“情绪”翻译成“演员能做的动作”
剧情和情绪路径确定以后,我才开始处理我认为最重要的一层:人物表演。
这也是为什么我后来专门整理了一套:人物表情细节库。
01|不能只写“她害羞了”
比如一句:
女友害羞了。
人类当然看得懂。
但对视频模型来说,这句话太宽泛。
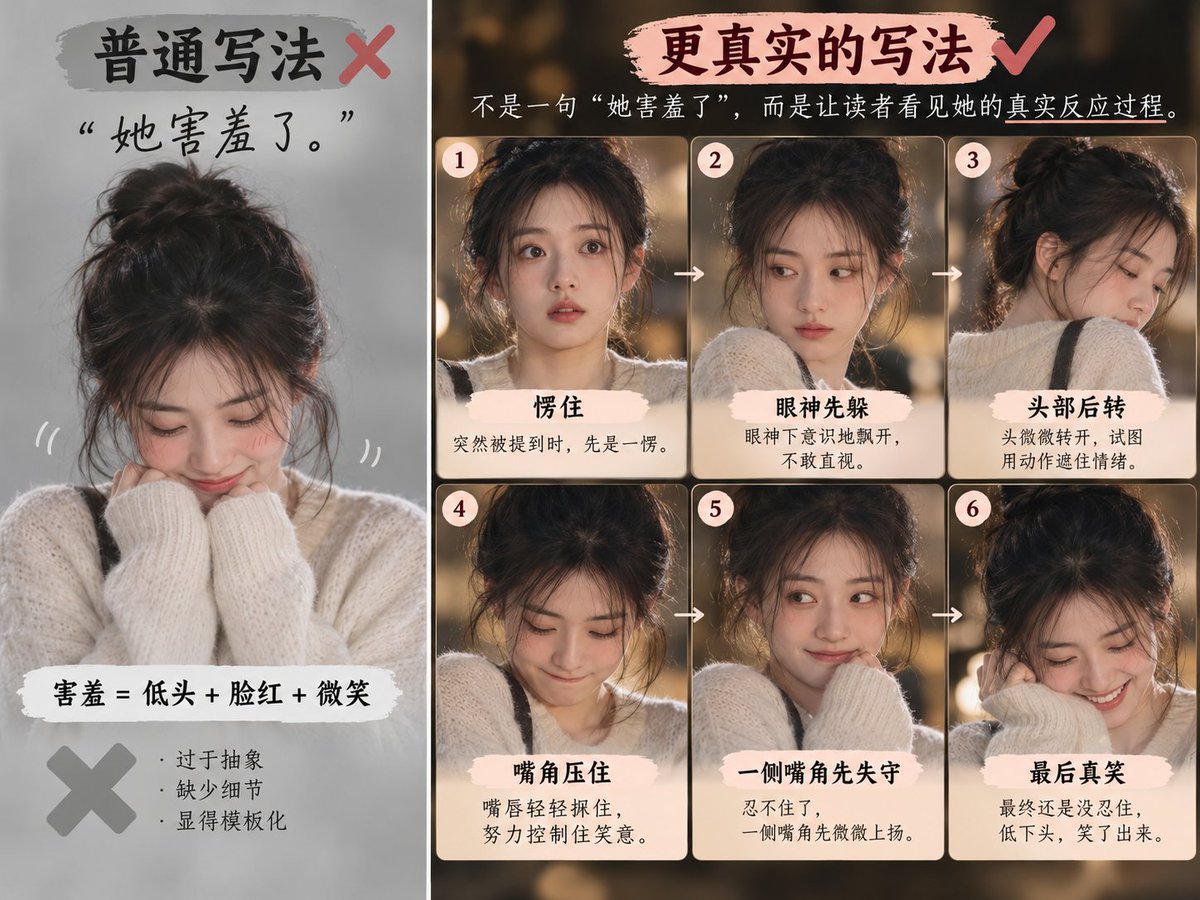
于是 AI 很容易自动套一个标准模板:低头 + 脸红 + 微笑。
如果每一条视频都是这样,很快就会出现明显的 AI 味。
所以我现在不会只写:
她害羞了。
而会把它拆成:
她先短暂停顿。 眼神先移开。 头部慢半拍才跟着偏开。 嘴角先压住。 一侧嘴角开始忍不住上扬。 最后才真正笑出来。
这个时候,“害羞”才真正变成了一段表演。
02|情绪泄露
人物真实的时候,往往不是先说出来。
而是:身体先暴露。
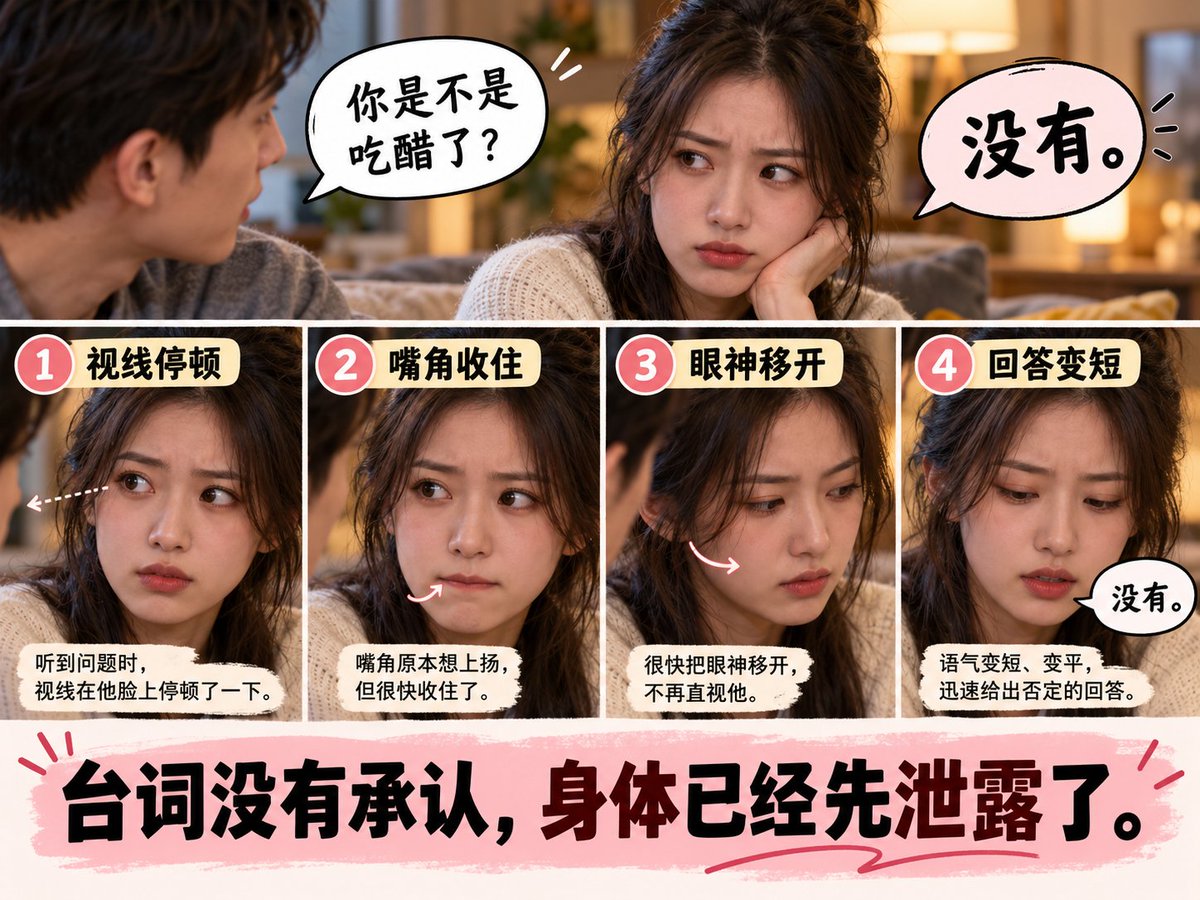
比如男朋友问:
“你是不是吃醋了?”
女朋友回答:
“没有。”
如果只写台词:
她没吃醋。
但真实表演可能是:
她先停顿了一下。
嘴角原本是放松的,突然收住。
眼神移开。
然后才回答:
“没有。”
这时候她嘴上虽然没有承认,身体已经把真实情绪泄露出来了。
我会把这种东西叫:情绪泄露。
它特别适合 AI 视频。
因为很多时候人物真正的“活人感”,并不是来自台词。
而是来自:台词和身体反应之间那一点不一致。
03|“眼神先动”很重要
我自己的表情细节库里,会特别关注动作顺序。
比如转头。
真人很多时候不是:眼睛和头同时转。
而是:先用眼睛看过去。
过一点点时间以后。
头才跟过去。
这种差别可能只有零点几秒。
但视觉效果会明显自然很多。
同样:
笑也不是整张脸突然切换。
可能先是一侧嘴角。
随后另一侧才跟上。
再然后眼周才真正进入笑的状态。
所以我现在越来越少写:
“人物露出开心的表情。”
而是写:
这个表情是按什么顺序发生的。
04|每个时间段,不要塞太多动作
这也是人物表情细节库对我帮助很大的地方。
我现在尽量遵循一个简单原则:一个时间段,一个主要动作。
再搭配一个很轻的表情泄露。
比如:
这一秒:
女友抬眼。
同时可以有:
嘴角轻轻收住。
但不要同时再加:
皱眉,转头,脸红,低头,抬手,笑。
模型一旦同时收到太多指令,就很容易全部一起发生。
资料库里也会限制同一时间块里的主动作数量,避免动作堆叠。
到这里,可以把第二层总结成一句话
不要告诉 AI 人物“是什么情绪”,要告诉它“这个情绪是怎么发生的”。
这就是人物表情细节库最大的价值。
第三层:30秒其实是一笔“时间预算”
人物怎么演设计好了,还不能马上写提示词。
因为还有一个非常现实的问题:时间够吗?
这也是我现在每次写脚本都会特别校核的一件事。
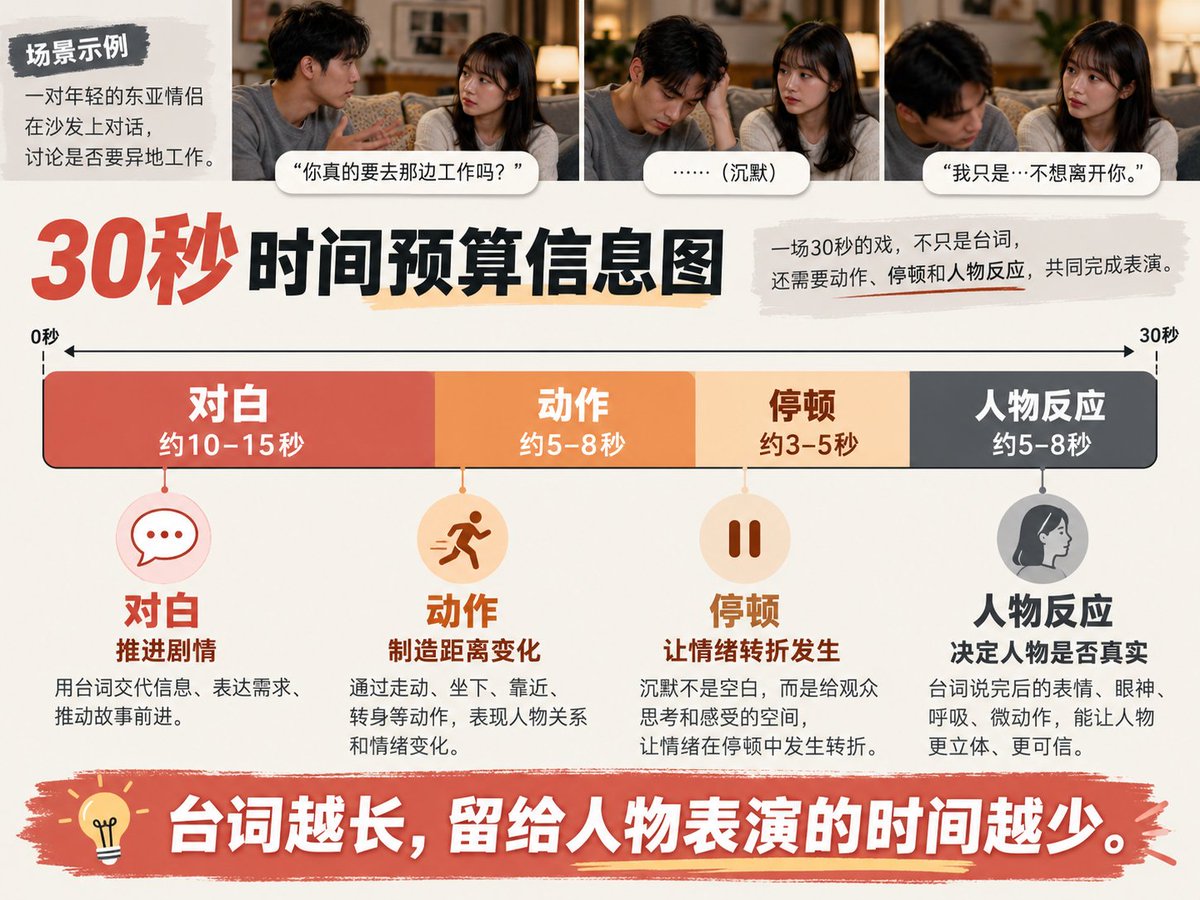
01|台词其实是在花时间
很多人设计短剧时,会首先想:
台词够不够好?
我现在会先想:这么多台词,30秒真的说得完吗?
假设30秒里放12句台词。
平均一句2秒。
已经24秒了。
只剩下6秒。
但这6秒里还要完成:
转头,伸手,走位,对视,靠近,停顿,人物反应。
肯定不够。
所以我后来慢慢意识到:台词数量,本质上是在消耗演员的表演时间。
02|要主动删台词
比如《手机给我》。
女友问:
“你看我干嘛?”
其实男友完全可以回答一句:
“因为你好看。”
从剧情上没有问题。
但我最后把这句删掉了。
为什么?
因为这个时候:沉默更值钱。
男友什么都不说。
只是看着她。
刚才还在抢手机的两个人,突然安静下来。
观众会立刻察觉:
气氛变了。
如果继续说台词,这种感觉反而会消失。
所以现在我不会觉得:
“30秒每一秒都必须有内容。”
有时候:停顿本身就是内容。
03|始终保持“前快后慢”
情侣拌嘴通常很快。
比如:
“手机给我。”
“不给。”
“你肯定有问题。”
这种对白如果说得慢吞吞,反而不自然。
所以我通常会让:前半段快一点。
负责推进剧情。
到了后半段:
两个人突然安静。
对视。
发现距离变化。
人物开始产生新的情绪。
这个时候节奏就要明显慢下来。
所以整个30秒通常会变成:
前面:台词推进
快。
中间:关系转折
慢下来。
后面:人物反应
留时间。
这就是:前快,后慢。
04|高潮以后,留足“反应”时间
这个是我现在特别重视的地方。
以前容易把视频高潮理解为:
亲吻,拥抱,摔倒,爆炸。
也就是:
发生了一件事。
但后来我发现:
观众真正关心的往往是:这件事发生以后,这个人是什么反应?
比如《你脸上有东西》。
真正有记忆点的不是前面的互动。
而是之后女友还一脸认真地问:
“……东西呢?”
这一秒,人物才真正“活”起来。
所以现在我会刻意给高潮后的反应留出几秒。
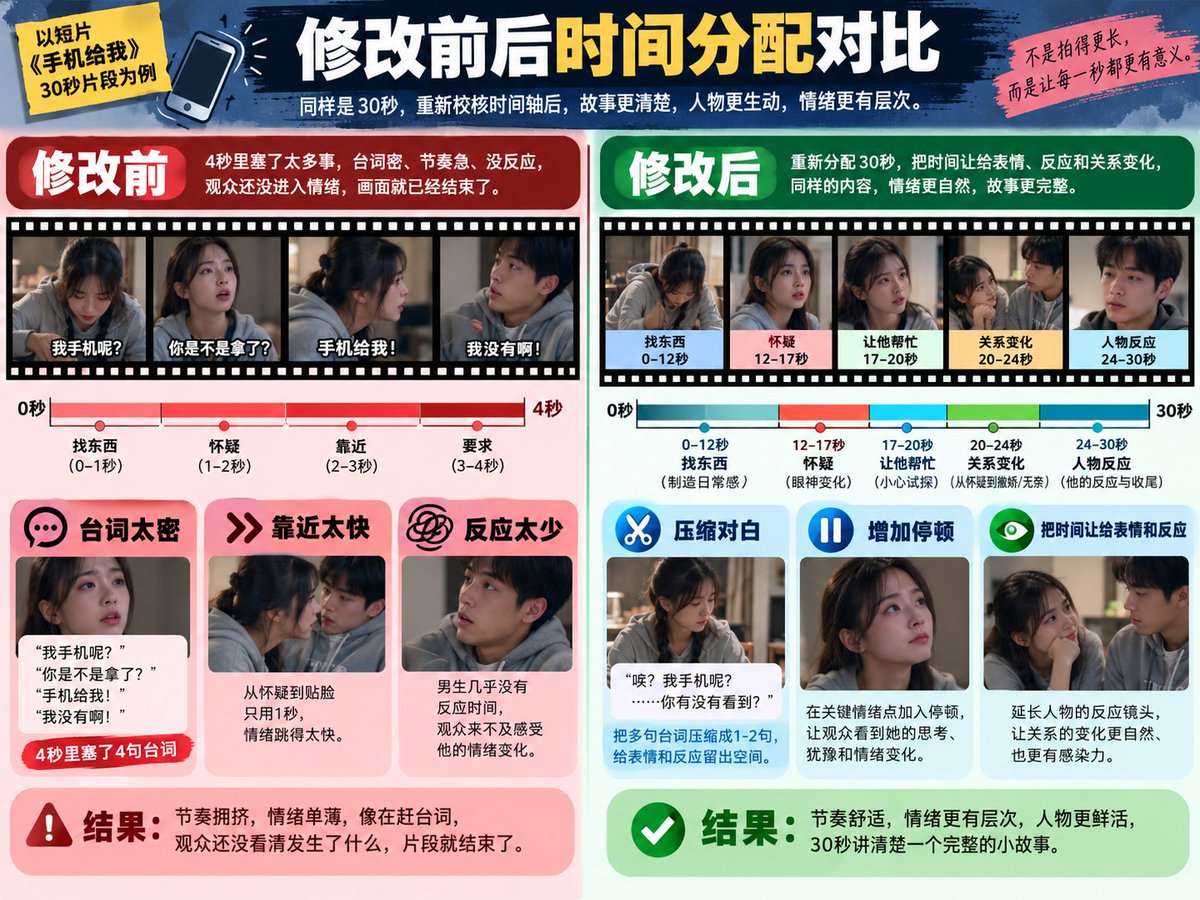
05|时间轴写完最好再校核一遍
我的第一版时间轴经常数学上是30秒。
但重新一看:
人物根本演不完。
比如:
一句话。
靠近。
发现异常。
发生互动。
害羞。
全塞进4秒。
文字看起来没有问题。
真人演一遍就知道:
太快了。
所以我每次都会重新检查:
这句话正常要说几秒?
这个动作需要多久?
两个动作有没有被我错误地写成同时发生?
情绪变化中间有没有过渡?
高潮以后有没有反应时间?
这一步其实就是:用真人表演去反推时间轴。
到这里,三层设计才真正完成
回头看一下。
我现在已经解决了三个问题。
第一层:剧情和情绪
人物:
为什么这么做?
情绪:
怎么从A走到B?
第二层:人物表演
情绪:
怎么通过眼神、嘴角、头部、手、声音泄露出来?
第三层:时间
这些台词和动作:
30秒真的演得完吗?
当这三层全部确定以后:
我才真正开始写 Seedance 提示词。
最终提示词,其实只是“组装”
到这里,提示词反而简单了。
我只需要把前面的设计结果转换成:
时间:什么时候发生。
景别:观众现在应该看两个人,还是看一个人的脸?
动作:人物这一秒具体做什么?
表情:这时候泄露了什么情绪?
台词:底说什么?
声音:语速、停顿、音量、呼吸是什么状态?
然后按时间轴组合起来。
就成了最终的 Seedance 提示词。
所以,最终那几千字提示词并不是重点
现在再看这种描述:
女友先停顿约0.4秒。 眼神先移开。 头部稍后才偏开。 嘴角轻轻收住。 一侧嘴角随后开始上扬。
可能就不会觉得:
为什么要写这么复杂?
因为这些细节不是为了“炫提示词”。
它们分别来自前面的设计:
0.4秒:来自时间预算。
眼神先移开:来自表情细节库。
头部后转:来自动作顺序。
嘴角压住:来自情绪泄露。
最后笑:来自完整的情绪路径。
也就是说:最终看到的每一句提示词,前面其实都有一个“为什么”。
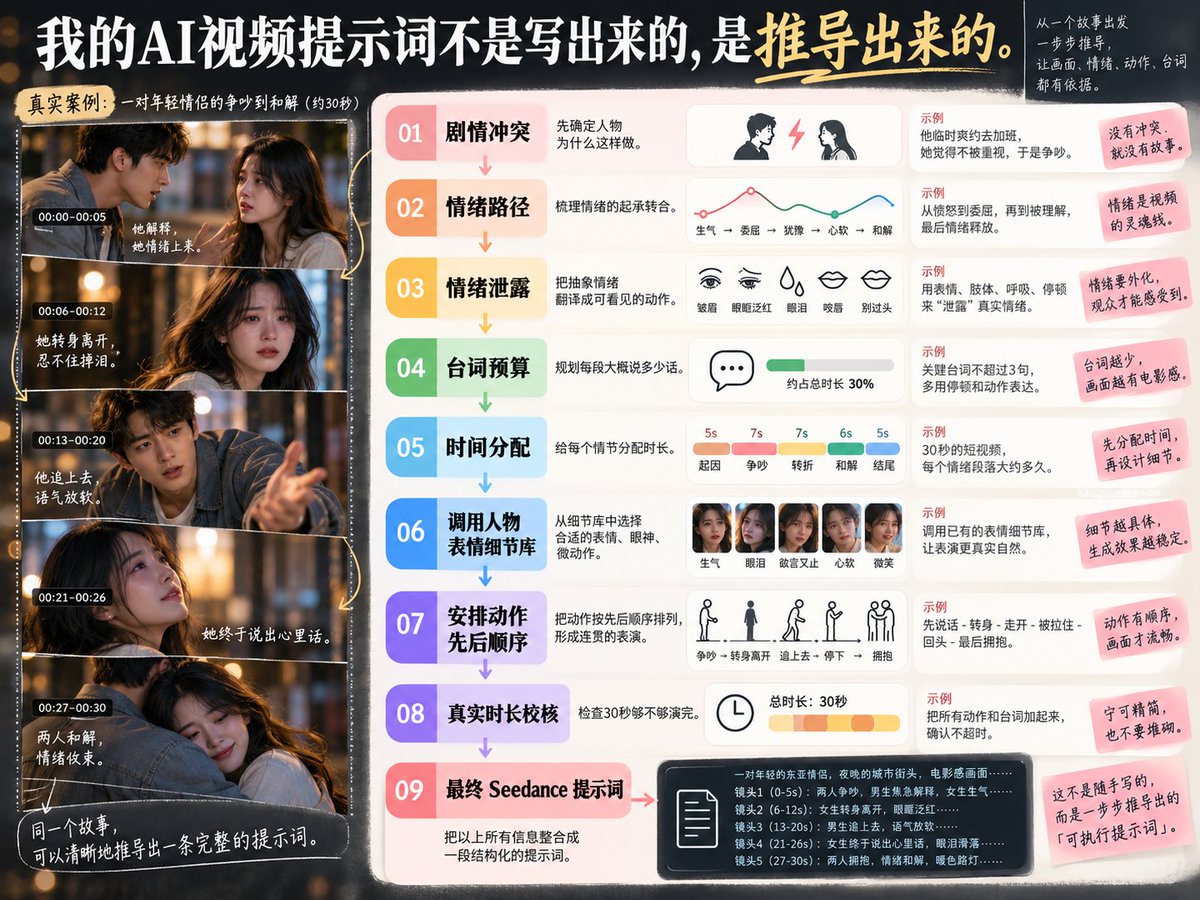
我现在完整的工作流
如果把整套方法压缩成一张图,就是:
剧情冲突
↓
情绪路径
↓
情绪泄露
↓
台词预算
↓
时间分配
↓
调用人物表情细节库
↓
安排动作先后顺序
↓
真实时长校核
↓
最终 Seedance 提示词
最后
以前我理解的 AI 视频提示词优化,更多是:
加电影感。
加摄影参数。
加镜头。
加光影。
现在做得越多,我反而越来越觉得:
真正决定一条 AI 视频有没有“活人感”的,是三个更基础的问题:
1. 这个人为什么这么做?
这是剧情和情绪逻辑。
2. 他的真实情绪是怎么泄露出来的?
这是人物表演。
3. 这些变化真的有时间发生吗?
这是节奏。
把这三个问题设计清楚以后,
景别、动作、表情、台词、声音,
其实都是顺着它们自然长出来的。
所以现在如果再让我总结:
AI视频提示词到底应该怎么写?
我的答案已经不是:
把提示词写得越详细越好。
而是:先把这场戏导演清楚。再把你的导演思路,翻译给 AI。
最终的提示词,只是这个过程留下来的结果。
推荐阅读
99%的人都写错了,GPT Image 2生成美女别写“性感”
我是李岳@liyue_ai
提示词工程师 | AI实战派
欢迎关注🌞🌞🌞
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


