
从零开始学 AI:小白也能看懂的常见 AI 术语讲解(二)
文章目录
朋友们大家好啊,我是金尘马。
上一篇,我们聊了大语言模型、Token、上下文、Agent 等常见名词,帮大家梳理了一些 AI 的基础概念。
很多朋友在日常使用 AI 工具的时候,还会被里面各种各样的功能名词搞蒙。什么推理强度、自定义指令、深度思考,还有问答模式、执行模式、上下文压缩……这些到底都是干嘛的?
这一期,我们就从平时用到的这些 AI 工具出发,把相关的常见术语讲清楚,看看它们各自是什么意思,又有什么用。
1. 提示词工程(Prompt Engineering)
上一篇讲过,提示词就是我们向 AI 提问、交代任务、补充背景时提供的内容。那怎么组织这些内容,才能让 AI 更清楚我们想要什么呢?
围绕一个任务,设计提示词,看看实际效果,再不断调整,这个过程就叫提示词工程。
比如希望 AI 帮我们写一篇文章,只说“写一篇介绍 AI 的文章”,给它的发挥空间就很大。读者是谁、想讲哪些内容、用什么口吻,都没有交代。把这些要求补上,它才更容易写出符合预期的内容。
那提示词为什么能影响结果呢?模型会根据当前能参考的内容,计算下一个 Token 的概率,逐步生成回答。提示词也是这些输入的一部分,你提供的任务、背景和要求,都会影响它后面怎么回答。
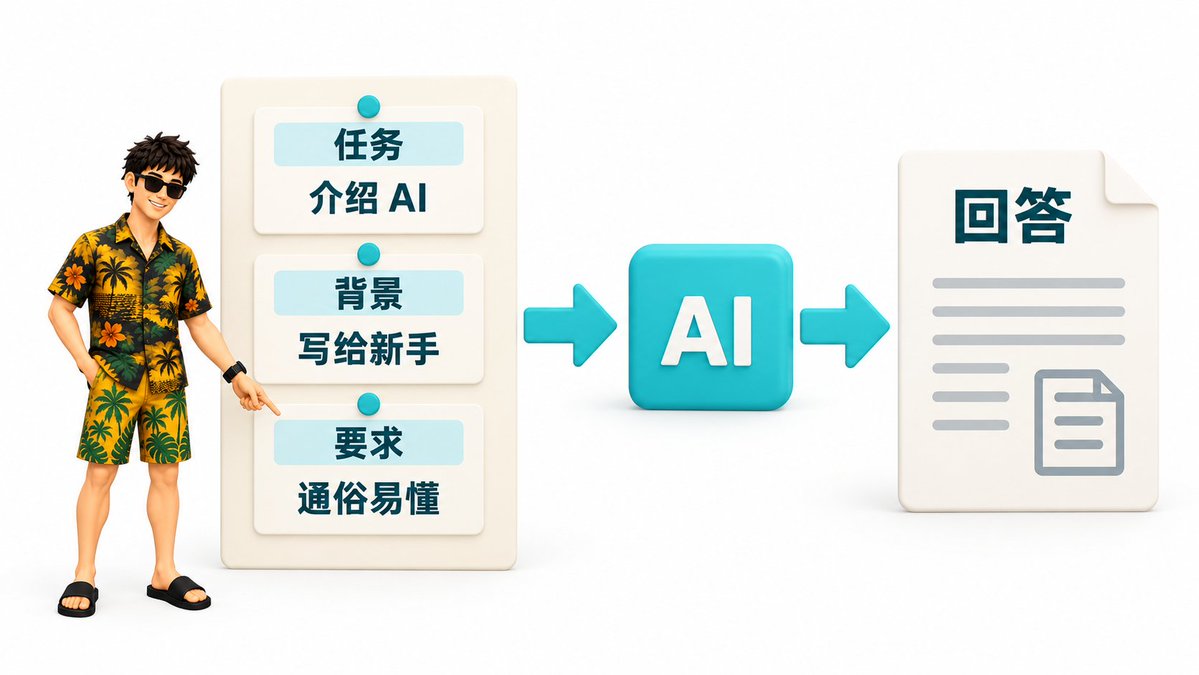
提示词的关键,是把相关的信息和要求说清楚。
我平时表达完需求,经常会加一句:“如果你有什么需要我补充的,可以向我提问。”
有时候我们自己也没把需求想完整,那就让 AI 先提问,帮忙梳理,再根据补充后的需求生成提示词。如果结果还是不满意,我也会让它去找一些最佳实践,看看这个任务通常怎么做,再回来完善要求。
2. 系统提示词(System Prompt)
我们在聊天框里输入的文字,通常只是模型收到的信息的一部分。
在 AI 工具背后,产品开发者还会预先设置一些指令,规定 AI 扮演什么角色、怎样回答、遵守哪些规则。这类指令通常叫系统提示词。
比如一个客服工具,可能会要求 AI 按客服的身份回答,遇到资料里没有的信息先说明情况,不随意透露用户隐私。这些要求可以在我们开始聊天之前就提供给模型,普通用户在聊天界面里未必看得到。
系统提示词能帮助同一个工具保持相对稳定的回答方式,也可以在里面设定一些安全和隐私方面的规范。
但是呢,光靠这些往往还不够。想让产品更安全、更严格地遵守相关规范,可能还要配合其他功能模块来共同完成。
3. 自定义指令(Custom Instructions)
系统提示词主要体现产品方的预设。我们自己如果也有一些希望 AI 持续遵守的要求,就可以用到自定义指令。一般呢,我们可以在 AI 产品的设置里找到输入自定义指令的地方。比如豆包、Codex,都可以在设置里配置。
自定义指令,就是预先保存自己的要求和背景,让 AI 在后续对话中参考,减少每次重复交代。
比如我会说明,希望它用什么风格回答,是简练一点,还是更务实一些;默认用简体中文。还有一条要求是,即使我反驳了它的观点,如果它仍然认为自己的判断有道理,也可以反驳我,并说明理由。
除了回答风格,我也会放一些个人背景,比如职业、履历、价值观,以及自己看待问题的方式。
这些信息有助于 AI 更有针对性地反馈。
4. 推理(Reasoning)
我们问 AI 一个问题,有时候需要它把几个条件放在一起,推导出一个结论。这个过程就涉及推理。
比如,下午 3 点开会,路上需要 45 分钟,还希望提前 15 分钟到。AI 要先算出应该在 2 点 45 分到,再往前减去路程时间,得到最晚 2 点出发。
写代码时根据报错寻找原因,分析一个方案是否满足多个条件,也会用到推理。
模型先生成一些中间推导,这些内容又会成为后面继续推导、生成答案时能参考的信息。
普通回答也能包含推理。工具里的推理开关,更多是在调整模型解题时是否投入额外的推导过程。
5. 思维链(Chain of Thought,CoT)
刚才从开会时间倒推出出发时间,中间有几个相互衔接的步骤。模型把这样的推导逐步展开,就形成了通常所说的思维链。
面对复杂问题,先处理一个条件,再根据得到的结果处理下一个条件,有时会比直接给出最终答案更容易完成任务。
可以把这些中间步骤理解成模型自己生成的一段额外上下文,后续回答会受到它们的影响。
有些 AI 工具会展示「思考过程」,展示的可能是中间步骤,也可能是整理后的摘要。
6. 深度思考与推理强度(思考强度)
理解了推理和思维链,再看工具里的「深度思考」,就容易一些了。
这类功能通常让模型在正式回答前,投入更多计算和中间推导,尝试分析条件、检查答案或寻找其他解法。对于条件多、需要多步处理的问题,这些投入可能改善结果。
相应地,它通常也会消耗更多 Token,回答需要更长时间。
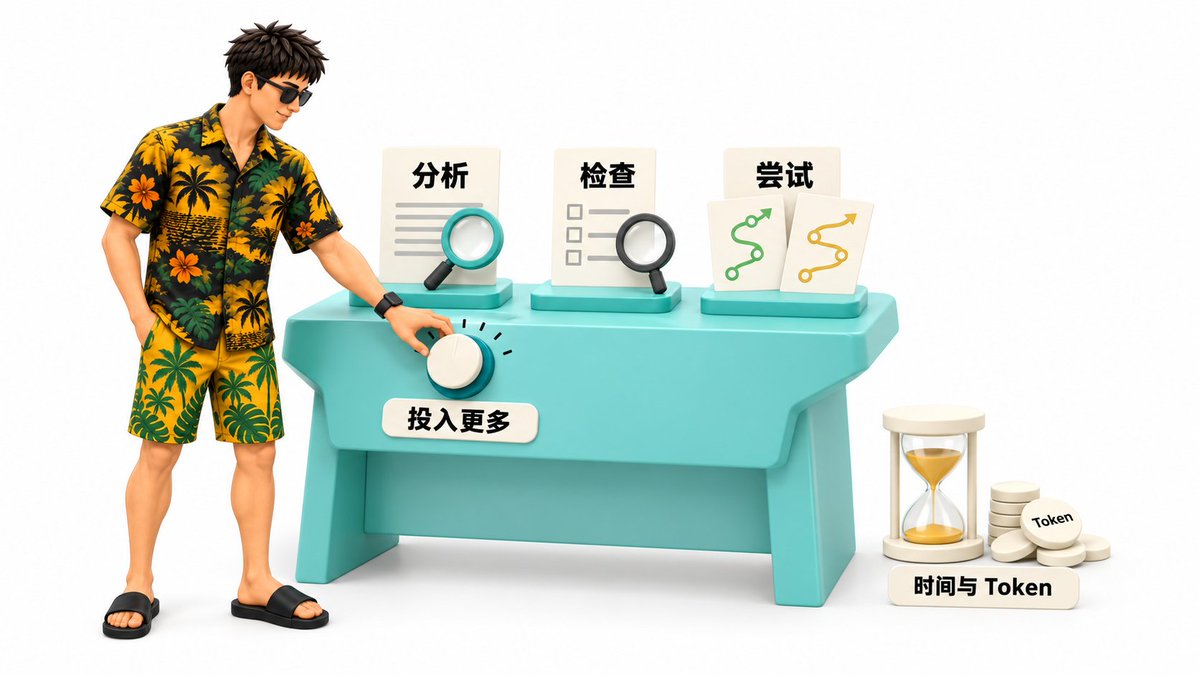
我一开始也纠结过要不要开。不开,怕回答不准确;开了,又担心消耗更多、等得更久。
那如何解决这个问题呢?我的方法是,最终还是按结果来判断,到底要不要开。
如果不开深度思考,它返回的结果也是 OK 的,那就不开。如果打开之后发现效果变好了,那就说明这个任务是值得开的。
有些工具除了开关,还提供低、中、高、极高等档位,这就涉及「推理强度」,也叫「思考强度」。
它调节的是模型为当前任务投入多少推理功夫。 有的实现会设置可用于思考的 Token 预算,有的会给模型一个投入程度的控制信号,由它结合任务决定具体怎么做。
这些档位没有固定的时长,实际耗时还受任务和模型运行速度等因素影响。
7. 问答模式与执行模式(Ask/Agent Mode)
有的朋友可能会发现,现在有些 AI 工具里有问答模式和执行模式,也就是 Ask 和 Agent 模式。
比如说,你正在开发一个网站,刚加了一个按钮功能,结果发现这个按钮点了没反应。
在问答模式下,你可以让 AI 读代码、分析原因,再告诉你应该怎么修改。它也可能把改好的代码返回给你,需要你自己手动复制、粘贴到代码文件里。
那在执行模式下呢?有了相应的工具和权限,AI 就可以直接帮你修改电脑上的代码文件,运行检查,看到报错后继续调整。
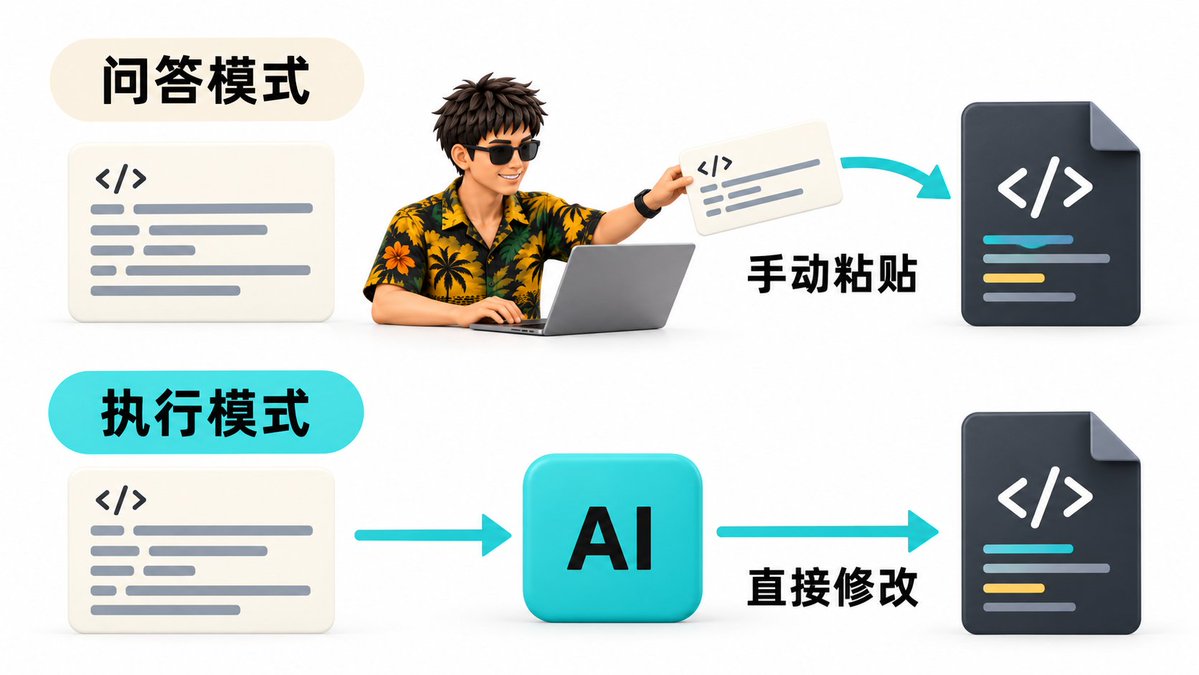
问答模式也可能读取文件、搜索资料、进行复杂推理。区别在于,它是否被允许实际修改内容、执行操作,以及能把任务推进到哪一步。
推理强度和执行模式也可以组合使用。一个决定投入多少思考,一个决定可以开展哪些操作。
8. 计划模式(Plan Mode)
计划模式是一个非常非常好用,也非常重要的模式。用好它,能很大程度上提升 AI 的工作效果。
那计划模式到底是个什么东西呢?平时我们给 AI 下达任务,它可能自己拆解一下,就直接去执行了。那执行效果怎么样,很大程度上取决于我们有没有把任务说清楚。
但是呢,我们在使用 AI 的时候,往往很难一次性把自己的需求说清楚。那这个时候,就可以用计划模式。
它会先针对我们的诉求,思考一个更详细的执行计划应该是什么样的。如果发现有些需求、有些细节我们没有交代清楚,它会主动反问,让我们补充这些信息。
经过几轮这样的交互,把需求和关键细节理清楚之后,AI 就能给出一份更完整的执行计划。我们再看一遍,确认好了,就让它照着这份计划去执行任务。
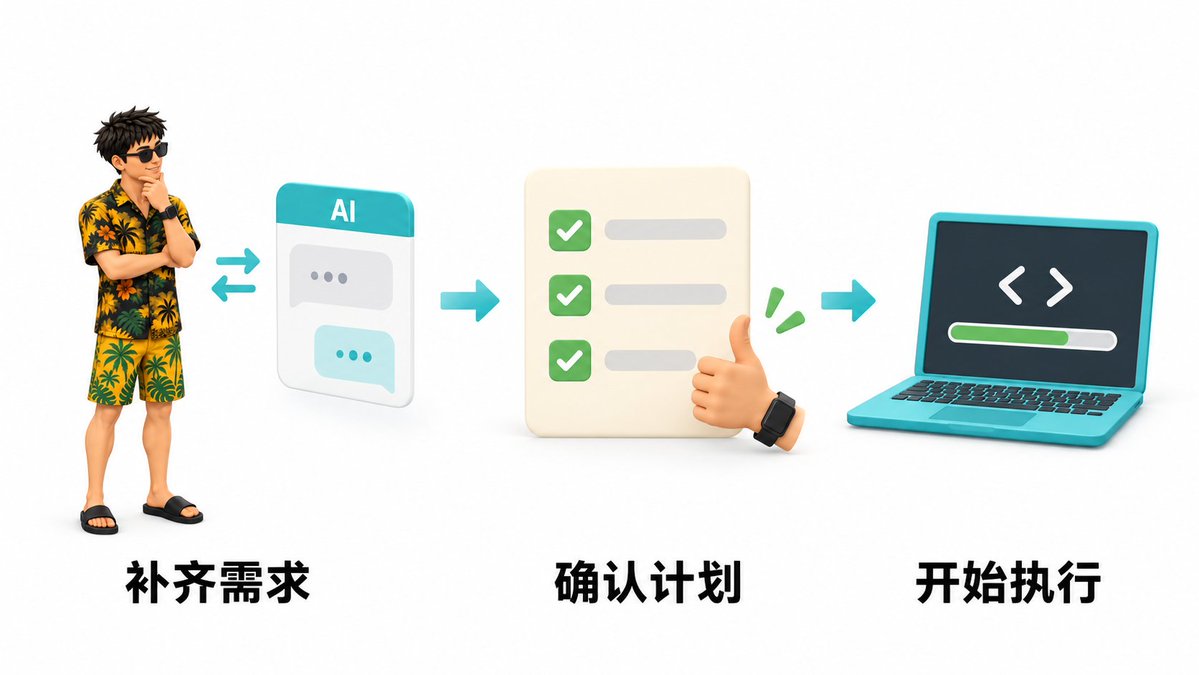
那等于说,我们让 AI 帮自己写了一份更为详尽的提示词。这样再去执行,效果往往就会比直接下达一个模糊的需求更好。
9. 目标模式(Goal Mode)
目标模式强调的是最终想要的结果。
我们可以把目标、要求和完成标准告诉 AI,让它自己拆解任务并执行,减少我们一轮一轮交代下一步的次数。
普通的 Agent 模式也可以连续执行多个步骤。目标模式会围绕最终目标持续推进,一轮工作结束后,再看看目标有没有达成,没完成就接着做。过程中能自己解决的问题就自己解决,需要我们补充关键需求时,也会回来问。
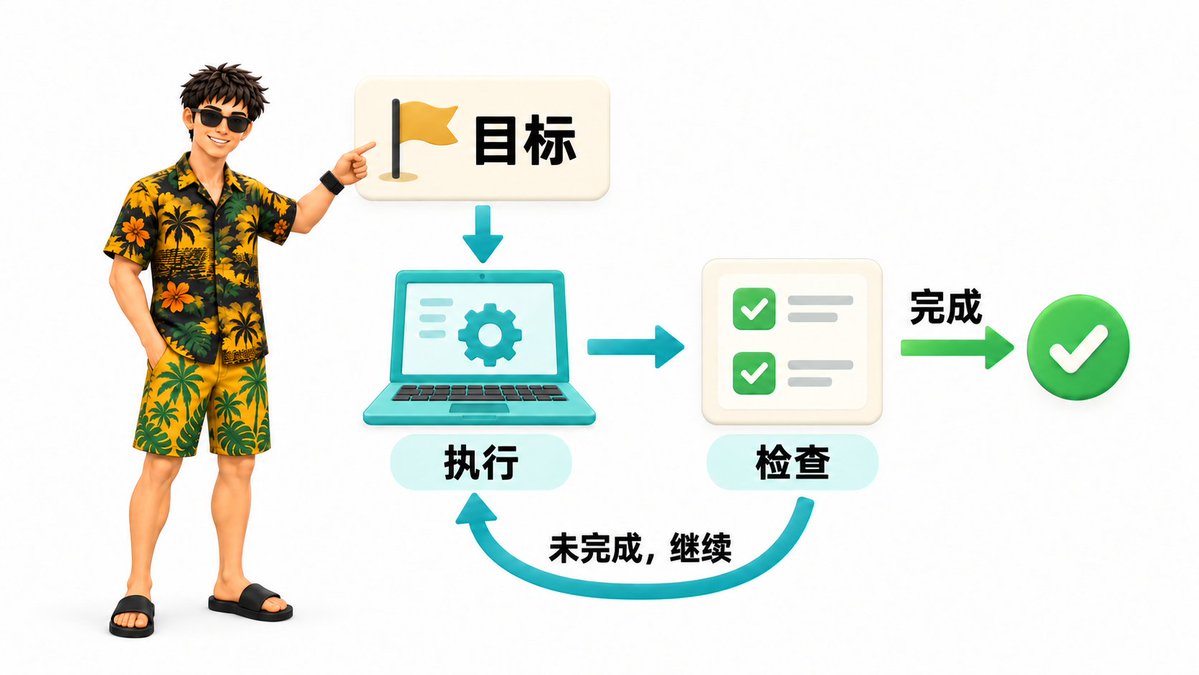
目标描述得清不清楚,会直接影响结果。
比如“把网站做好”,AI 很难知道我们觉得什么才算好。换成“修复登录失败的问题,正确密码能够登录,错误密码有提示,保留现有页面样式”,它就有了更具体的工作范围和检查方法。
我实际体验下来,如果任务和实现路径非常复杂,这种持续推进的方式可能消耗大量 Token。如果想要的结果没讲清,检查成果的办法也不明确,最后做出来的东西仍然可能偏离预期。
10. 权限与审批(Permissions/Approvals)
让 AI 真正操作电脑或外部工具时,经常会遇到授权提示。这就涉及权限与审批。
权限决定它可以访问哪些资源、做哪些操作。比如能不能读某个文件夹,能不能修改文件,能不能运行命令或连接某个账号。
审批则决定执行某项操作前,是否需要我们再点一次确认。
有些工具会允许直接读取当前项目里的文件,访问其他目录或执行某些命令时再请求批准。
尤其是删除、覆盖文件这类操作,需要考虑做错了还能不能恢复。有版本记录或可靠备份,一些修改可以回滚;如果删掉的是没有备份的唯一文件,后果就可能很严重。
减少逐次审批,确实能让 AI 更连贯地完成任务,不用每做一步都等人守在电脑旁边点击。前提是先明确任务范围、开放的权限和恢复手段。
11. 上下文压缩(Compaction)
上一期讲过,上下文就是 AI 在这次回答时能参考的信息,包括聊天记录、我们提供的资料,以及工具返回的内容等。
它的容量有限。比如有的模型支持 128K(约 12.8 万 Token)、256K(约 25.6 万 Token)的上下文。
随着对话轮次增多,文件和工具结果不断加入,可用的上下文空间就会逐渐被占满。如果还想在当前会话里继续聊,那怎么办呢?
支持上下文压缩的工具,可以在达到一定用量时自动触发,也可能允许我们手动触发。它会把较早的聊天内容整理成摘要,保留当前任务的重要背景、已经确定的要求、进展和待办事项。
后面的回答,就可以参考这份摘要和保留下来的近期内容。摘要比原文短,腾出了一部分空间,我们也就能继续交流。 之后内容又积累起来,还可以再次压缩。
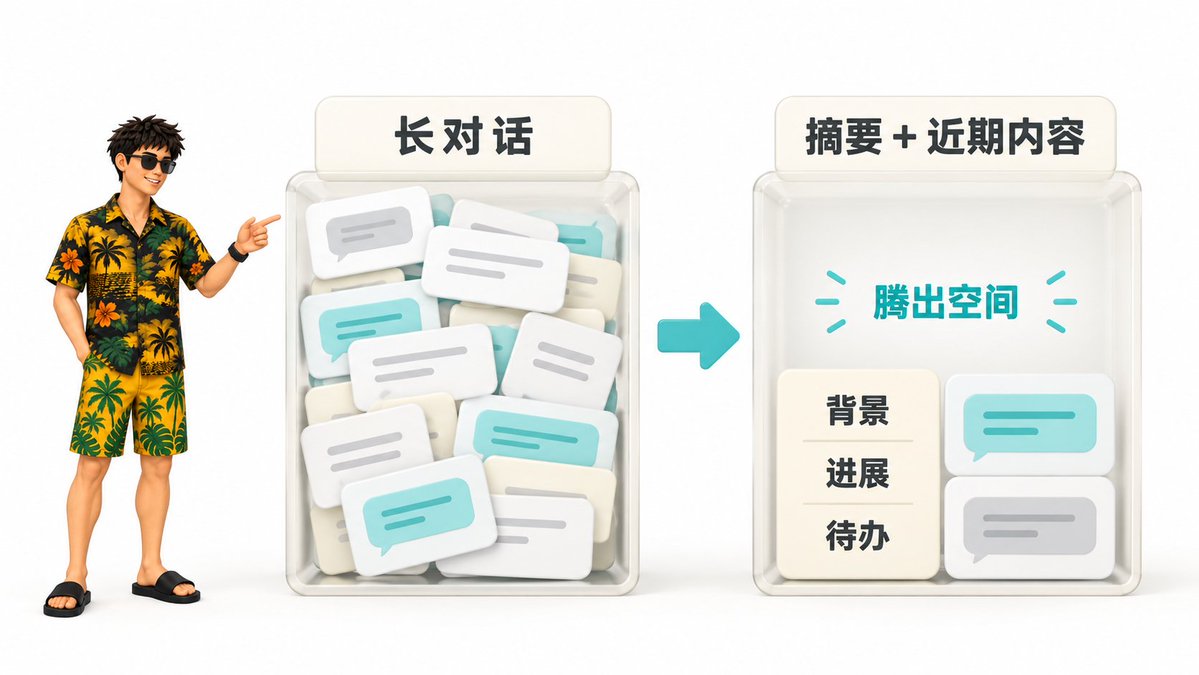
但摘要可能丢失原话和细节。
就拿这篇文章来说,我和 AI 一项一项讨论时,会让它边聊边保存原始问答,另外记录整理和进度。这样,即使上下文经过压缩,需要引用我的原话时,仍然可以回到保存的文件里找。
12. 知识截止日期(Knowledge Cutoff)
看模型介绍时,我们还可能看到一个「知识截止日期」。它表示模型通过训练掌握的知识,大致覆盖到什么时间。
模型训练用的是已经收集到的数据。文章、代码、论文、论坛内容、数字化的书籍,都可能成为资料来源,还可能包含授权资料、人工编写内容或生成的数据。
这些资料经过收集、筛选和处理,再用于训练。等模型发布时,现实世界已经继续往前走了,所以它学到的知识和我们提问的日期之间,可能存在时间差。
我们看到这个日期,主要是为了判断哪些问题需要补充更新的信息。
比如问今天发生的新闻,如果没有联网结果,也没有我们提供的新资料,模型就缺少可靠回答的依据。把今天的新闻贴给它,它仍然可以阅读和分析。
13. 联网搜索(Web Search)
联网搜索,就是 AI 工具去网上检索资料,再把找到的内容提供给模型,结合我们的提问组织答案。
这样,模型就能利用训练时没有学过的新信息,也能为回答提供可查的出处。
有的工具会根据问题自动调用联网搜索,有的需要用户主动选择。
上一篇讲 AI 幻觉时也提到,联网之后仍然可能答错。
有时候是查错了资料,比如把过时的信息当成最新情况,或者使用了不可靠的转载。有时候资料找对了,模型却漏掉限制条件,理解错了,或者写出了原文没有支持的结论。
假设官网写的是“新用户首月免费”,AI 却回答成“所有用户永久免费”,错误就出在理解和转述上。
14. 深度研究(Deep Research)
查一个具体信息,普通联网搜索通常就能派上用场。但研究一个行业、核查一件复杂的事情,往往需要更多资料和持续分析。
如果由人来做,我们也要寻找资料,判断来源是否可靠,比较不同说法,发现疑问后继续调查,最后再作综合判断。
深度研究,就是让 AI 围绕一个研究问题,执行类似的调研过程。
它会进行多轮搜索,阅读和比较资料,再根据已经发现的内容,决定下一步查什么。比如两个行业报告给出的数字差很多,就继续追查它们的年份、地区和统计口径,看看差异到底出在哪里。
普通搜索也可能连续查几次。深度研究更强调围绕复杂问题展开系统的调查,再把证据、分析和结论整理成报告。
它也会把不同来源的资料放在一起核对,看看哪些说法能相互印证,这就是交叉验证。
15. 引用来源(Citations/Sources)
AI 根据资料回答时,有些工具会在相关句子旁标出数字或链接,告诉我们这部分内容参考了哪里。这就是引用来源。
它主要是方便用户溯源。我们能沿着引用找到对应的网页、文章或文件,看看原文到底怎么说的。
有时候对答案不放心,想核对一下;有时候是觉得这个内容有意思,想继续深入阅读。引用都能帮我们回到资料本身。
写在最后
上面聊到的这些功能,在不少主流 AI 工具里都能见到。有些名字叫得不见得完全一样,但对应的功能往往是相似的。
大家在使用的时候呢,可以多去实际操作,边用边感受不同功能给结果带来的变化。 用熟了,自然就知道遇到什么任务,该怎么去用了。
金尘马|前大厂程序员,OPC 实践中|持续分享普通人也能看懂、用得上的 AI 实用教程|目前在做 AI 培训与企业 AI 落地|合作咨询,联系方式见主页:https://x.com/jinchenma_ai。本文由我口述,ChatGPT 协助整理,经我审稿定稿。


