
从零开始学 AI:小白也能看懂的常见 AI 术语讲解(一)
文章目录
朋友们大家好啊,我是金尘马。
好多朋友想学 AI,也有些朋友已经开始使用各种 AI 工具了。但面对 AI 界各种各样的术语,还是有点摸不着头脑:一会儿是 Agent,一会儿是 Skills,一会儿又是工作流。遇到的陌生词太多,学起来也磕磕绊绊的。
从今天开始,我就开一个系列,用通俗易懂的语言,把 AI 里常用的一些名词跟大家讲清楚,帮大家扫清学习 AI 路上的这些小障碍。
这一期,我们先聊 11 个常见名词。从大语言模型讲起,再聊聊 Token、Agent、Skills、工作流这些词,看看它们各自是干什么的,彼此又有什么关系。
1. 大语言模型(LLM)
很多人开始关注这一轮 AI 热潮,是从 2023 年前后听说 ChatGPT 开始的。支撑这类聊天工具与人交流的,就是大语言模型,英文简称 LLM(Large Language Model)。
它通过大量数据训练,学会处理语言。你用平时说话的方式提出问题,它就能根据你的要求和提供的信息,分析问题、整理内容,再用自然语言回复你。
比如让它解释一个概念、分析一篇文章,或者帮你起草一段文字,都用到了这类能力。
那它跟我们平时用的豆包、DeepSeek 有什么关系?这里说的豆包、DeepSeek,是大家打开来聊天的应用。应用背后会调用大语言模型,再把对话界面、文件上传等功能放在一起,方便我们使用。
模型提供处理信息和生成回答的能力,应用把这些能力做成了我们能直接使用的工具。
2. 多模态(Multimodal)
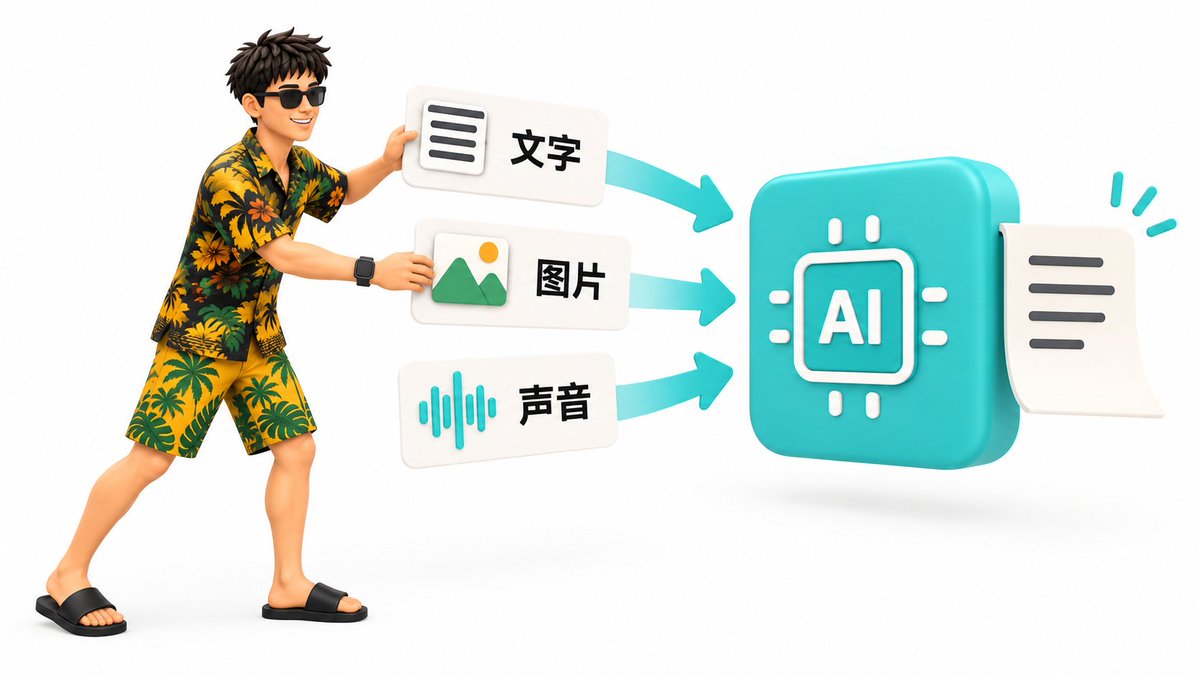
大语言模型让大家习惯了用文字跟 AI 交流,但我们给 AI 的东西还有图片、声音和视频。这些不同的信息形式,就叫作不同的「模态」。
多模态,说的就是能处理多种信息形式。它可以体现在输入上,比如同时理解文字和图片;也可以体现在输出上,比如根据文字要求生成图片。
像我平时有一些作图需求,比如给文章配插图、做笔记封面或者海报,就会让 AI 帮忙生成。处理录音时,也会让它把声音转成文字稿。这些需求就超出了纯文字问答。
声音生成还可以用于配音、声音复刻,视频模型可以生成一段视频,AI 漫剧也会用到这类能力。
比如,你把一张文章封面和正文发给一个支持看图和对话的模型,问它这张封面的配色怎么样、人物够不够突出、跟文章搭不搭。它需要同时读懂文字和看懂图片,再用文字给出建议。
有些大语言模型就具备这样的能力,既能理解和生成文字,也能看图,这就属于多模态。至于能不能处理声音、生成图片或视频,要看具体模型支持什么。
3. 提示词(Prompt)
提示词,英文叫 Prompt,广义上,你发给 AI 的文字,都可以叫作提示词。无论是提问、交代任务,还是补充背景、随口聊几句,都算。
虽然叫「词」,实际使用时,它可以是一句话,也可以是几段完整的说明。
比如我可能会让 AI 先读一篇文章,分析里面有哪些段落,再看看不同的段落适合配什么样的图片。这整段要求,就是提示词。
如果我还希望图片带上自己的 IP 形象,或者符合某种风格,也可以把这些要求一起说明。AI 才知道这次要做什么、最后交给我什么。
在 AI 时代,把自己的意图和需求清楚地表达给 AI,是我们每个人都需要锻炼的一项能力。 你想做什么、有什么要求、希望得到什么结果,交代得越清楚,AI 就越容易帮到你。
4. Token(词元)
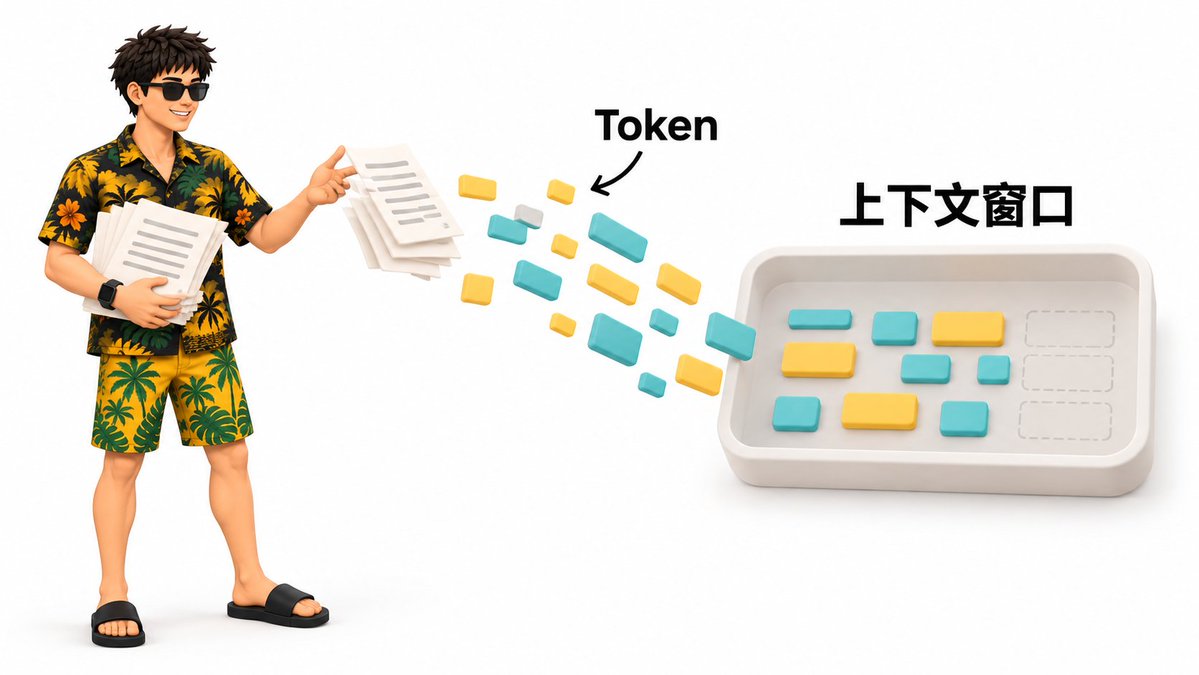
Token 在不同领域有不同的意思,有时会被翻译成「令牌」。在大语言模型的语境里,Token 就是模型处理文字时的一个小单元。前一阵呢,官方给它起了个中文译名,叫「词元」。
模型处理文字时,会按照一定的规则,把内容拆成一个个小单元,这些单元就是 Token。
一个 Token 可能对应一个字、一个词,也可能只是其中的一部分。不同模型的划分规则会有差别,所以 Token 和字数之间没有固定的换算关系。
平时最容易在两个地方遇到它。
一个是计费。有些模型服务会统计你输入了多少 Token、模型输出了多少 Token,再分别计算费用。输入包括你提供的要求和材料,输出就是模型生成的内容。这是模型服务的一种计费方式,聊天应用也可能采用会员订阅等收费方式。阿里云的 Token 服务说明就有按输入、输出分别计费的例子。
另一个是上下文长度。看到某个模型支持多少万 Token 的上下文,说的就是它能够容纳的信息量,和具体的汉字数量有区别。
5. 上下文(Context)
刚刚讲 Token 的时候提到了上下文,那上下文又是什么呢?
上下文,就是 AI 在回答你这次问题时,能够参考的信息。 比如前面的聊天内容,以及这次你发给它的问题、文章和资料。我们平时说的历史聊天记录,就是上下文的一种常见来源。
比如,我想让 AI 帮我做自媒体的视觉设计,就会把自己的品牌调性、人物形象、相关资料给它。它了解这些背景后,生成插图时就能更贴近我的品牌。
我也会把自己的经历、履历和当前情况告诉 AI,让它陪我讨论一些人生选择。它了解的情况更充分,给出的意见就更有机会贴近我的实际处境。
做项目也是一样。项目背景、相关资料、最新的会议记录给到它,它帮我整理纪要、更新进展时,就有了判断的依据。
不过,一次能放进来的信息量是有限的,这个容量就叫「上下文窗口」,通常用 Token 来表示。对话聊得很久、资料放得很多时,早期内容可能需要被压缩成摘要,或者不再被完整带入。后面的回答能参考多少,取决于当时实际提供了什么。
6. 记忆(Memory)
聊到这里就会遇到一个问题:换个对话,AI 还记得前面那些事吗?
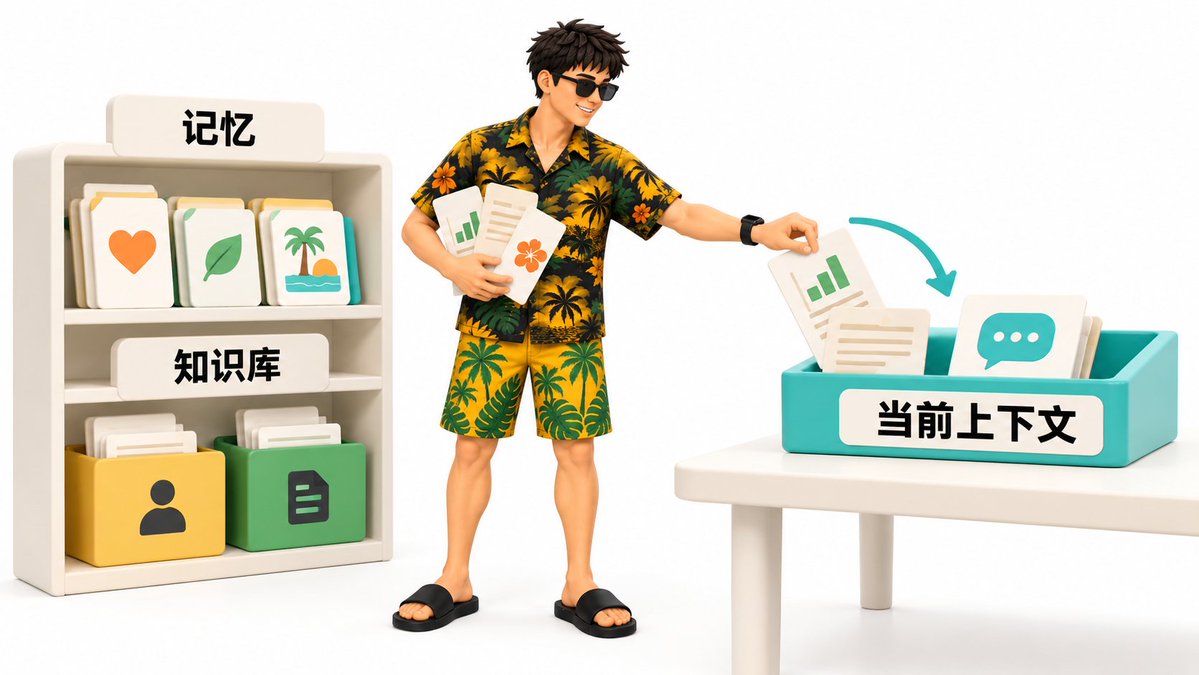
这就涉及记忆。我们说 AI 工具有记忆,通常是指它能把一些信息保存下来,在后续对话中再调用。
比如你的个人情况、表达偏好、正在做的项目。如果工具支持相应的记忆功能,并且这些信息确实被保存、调用了,你就可以少重复交代一些背景。具体能记住什么、在哪些对话里可用,各个工具的做法会有差别。
上下文关心的是这次回答能参考什么,记忆关心的是哪些信息被留了下来、以后还能再用。 保存的记忆被调出来时,也会成为当次上下文的一部分。
如果工具没有记忆,或者记忆功能没打开,我可以在一段对话结束时,让 AI 整理一份 handoff,也就是交接文档,把重要背景、已经做了什么、接下来要做什么写清楚。
然后把这份交接文档发到新对话里,就能接着往下聊。新对话了解的是文档里保留下来的内容,所以关键决定和进展写清楚,交接才更顺畅。
7. 知识库(Knowledge Base)
前面说的那些资料,总得有个地方放。知识库就是把资料组织起来,方便后续查找和使用的一套资料集合。
它很重要的一个作用,就是补上你知道、AI 还不了解的那些信息,让它回答问题时有据可循。
拿我自己来说,我有一个个人知识库文件夹,里面按大类分成个人资料、知识积累、项目资料、创作内容等几个部分。
这些资料的整理,我也会交给 AI。我告诉它这些分别是什么类型的东西,再让它协助分类、归档。
以后写文章,需要找之前写过的素材,就可以让 AI 去里面查;讨论某个项目,也可以让它读取对应目录里的资料。
放到公司里,业务介绍、产品资料、客户信息等,也可以整理进知识库。AI 回答相关问题时,就可以先查这些资料,结合公司的实际情况来回答。
这样,知识库负责把资料保存、组织好,AI 再根据当前任务读取需要的内容,放进上下文里使用。文件存在那里,并不等于它每次回答时都已经读过。
8. Agent(智能体)
Agent,也就是大家常说的「智能体」。
在这里,我们说的是一种能围绕目标推进任务的 AI 系统。你交代要做什么,它会判断接下来需要哪些步骤,调用相应工具,查看执行结果,再决定下一步怎么做。
其实,我们平时在手机上用的豆包、DeepSeek,在日常聊天中也已经具备了一部分 Agent 能力。比如开启联网搜索后,AI 可以查找资料,再根据搜索结果回答问题。这类场景下,它能做的事通常集中在 App 提供的功能里。
相比这些 App 的日常聊天模式,WorkBuddy、Codex 这类主要在电脑上使用的任务执行工具,通常能调用更多工具,处理的任务范围更广,通用性也更强。获得相应授权后,它们可以读取和修改电脑里的文件、操作浏览器、连接其他软件,把需要多个步骤的任务持续做下去。
比如写文章时,我可以让它去找以前的素材,读完后整理出这次能用的内容,再帮我汇总成一篇新的文章。写好的内容可以让它放进飞书文档;连接邮箱后,也可以让它从广告和订阅邮件里筛出有用的信息。
有了运行代码的环境,它们甚至可以自己做小工具来使用。比如,要从一批资料里提取内容,它可以先写一段脚本,也就是一小段执行特定任务的程序,再运行这个脚本来批量处理资料。
这里的大语言模型负责理解要求、分析和判断,工具负责实际执行查找、读取、写入等操作。Agent 把这些能力组织起来,边做边根据结果继续推进。
能做到哪一步,要看它接入了哪些工具、拿到了哪些权限,以及任务本身的难度。
9. Skills(技能)
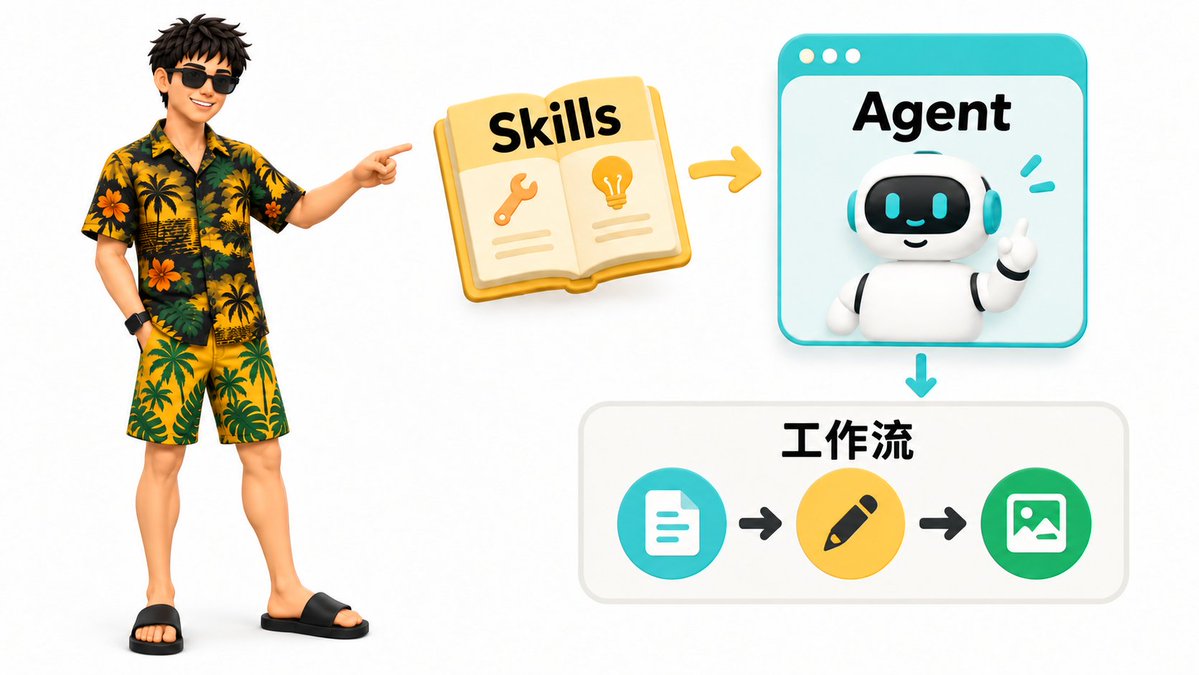
Agent 能做的事情多了,我们也会希望它按一套固定的方法完成某些任务。这就用到了 Skills,单个叫 Skill。
这里说的 Skill,可以理解为给 Agent 准备的一套可重复使用的做事方法,里面可以包含任务说明、参考资料、模板,以及辅助执行的脚本等。
比如生成文章封面,我希望它根据文章内容和标题,做出一张带有我个人 IP 形象、符合我想要的风格的图。
如果没有 Skill,每次做封面,我都得重新发提示词,说明人物形象和风格要求,再把参考图片传一遍。整理成 Skill 后,这些固定要求和参考资料就保存下来了。
以后做同类任务,就不用重复发这些提示词和资料,直接让 AI 执行这个 Skill 就可以了。 比如文章写完,我让它调用封面 Skill,它就会根据这次的文章内容,按保存好的风格和人物形象生成封面。
10. 工作流(Workflow)
工作流,就是把做一件事的步骤安排好。比如处理一篇文章,需要读内容、标重点、生成封面和插图。
在扣子、n8n 里,可以把每个步骤做成一个节点,再用线连接起来,系统就会按安排好的流程执行。这类流程即使用到了 AI,整体仍然是工作流。
Agent 则可以根据目标和执行结果,自己判断下一步该做什么。工作流里也可以让 Agent 负责其中某一步。
Skill 也可以用来组织一套更灵活的工作流。你把处理步骤和配图要求写清楚,具体配几张图、放在哪些段落,可以交给 Agent 根据文章内容判断。以后换一篇文章,直接调用这个 Skill 就可以了。
11. AI 幻觉(AI Hallucination)
AI 能回答问题、调用工具、完成任务,但生成的内容仍然可能出错。其中一种常见情况,就叫 AI 幻觉。
比如它给你列出一篇论文,标题、作者写得挺完整,查了一下却发现这篇论文根本不存在。还有一种情况是论文确实存在,但里面并没有支持它所说的结论。它生成了看起来像那么回事、实际缺乏依据的内容。
这类现象在相关研究中仍有记录,并没有因为工具变多就自动消失。一项关于科学文献综合的研究就观察到了虚构引用,以及引用与断言不匹配的问题。
AI 的回答不理想,可能有两种情况。一种是它不了解你的个人情况,给出的建议比较笼统,这是缺少背景。另一种是它编造了事实,或者给出了资料并不支持的结论,这就属于 AI 幻觉。
联网搜索能为回答补充更新的信息和可查的出处,有助于减少幻觉。
但是,联网搜索不代表 AI 回复的内容就百分之百正确。 哪怕找到了资料,也可能出现理解偏差或者引用不对的情况。
如果你对答案的准确性要求很高,需要有真实来源,建议亲自查看来源原文,确认资料是否属实、是否支持 AI 给出的结论。
写在最后
这一期,我们从 AI 背后的模型,聊到怎么交代任务、提供资料,再到让它调用工具帮我们做事,也认识了回答中可能出现的 AI 幻觉。
下一期,我们会接着聊聊和 AI 对话、用 AI 查资料时经常遇到的一些名词,看看这些说法分别是什么意思,又有什么用。
金尘马|前大厂程序员,OPC 实践中|持续分享普通人也能看懂、用得上的 AI 实用教程|目前在做 AI 培训与企业 AI 落地|合作咨询,联系方式见主页:https://x.com/jinchenma_ai。本文由我口述,ChatGPT 协助整理,经我审稿定稿。


