
600万播放的“AI视频”是怎么做出来的?——从想法到成片,谈谈如何制作有质感的AI视频 (上)
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
最近我制作的视频在X上获得了近700万曝光。很多朋友在评论区和私信让我教教大家AI视频怎么制作。为了回馈大家的支持,我决定开源自己的AI视频创作心得,分享制作过程和踩过的坑。希望能给各位带来启发,祝你们人人都能做出爆款,争取让老马转发,一条视频赚1万刀。
下篇:https://x.com/Xanderwow_A/status/2103877894955024654
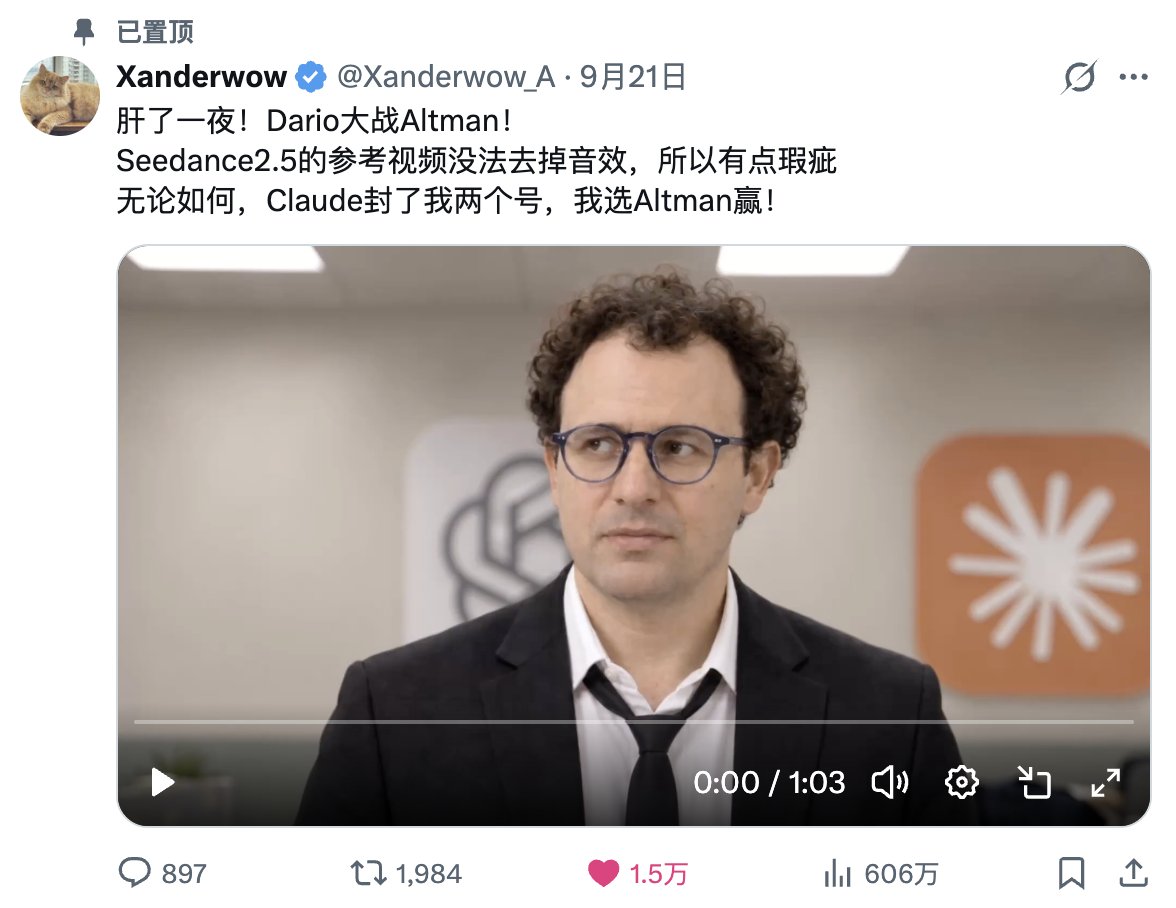
另外两个视频《泰坦尼克号》和《鱿鱼游戏》也分别达到了50万、30万的曝光。 视频在我的首页,欢迎大家去看!
在正式开始讲之前,先给大家介绍一下我自己:
我是一个文科生,读过专科、本科和研究生。大学里学的专业分别是电子商务、人力资源管理和行政管理(Public Management)。毕业后在一家国企干了两年行政文秘,去年回家帮家里的服装生意做线上运营方面的工作。
为什么要先介绍我自己?我没有影视方面的工作经验和学习经历,哪怕是做线上运营,我之前也没走过“自媒体”相关的路径,更多是通过技术手段来实现推广、获客和客户管理。所以,我想说的是——不管你有没有影视相关经历,只要是个人,愿意动手,都能搓出一部至少“看起来质感不错”的AI视频。
所以,只要你看了我的这些文章,大概率能做出我这种AI视频。当然,我不能100%打包票能把大家教会,但我一定会毫无保留的把经验都写下来。如果朋友们在制作中有任何的问题,欢迎你们私信或在评论区问我,我会回复。
我用我的猫咪罗罗作为参考图,在GPT-image2.5制作的图片
国外的朋友辛苦用Grok翻译一下,再次感谢全世界朋友们的支持和喜爱🙏 话不多说,那么接下来就开始进入正题!
一、先介绍工具:巧妇有米才能炊
准备好工具是开始创作的第一步。工具可不光光是准备一个视频生成模型那么简单~我会给大家先介绍工具的种类和细节,在本节最后一章解释图片和视频模型在哪些网站和工具上可调用。
需要准备的工具有以下如下:
(一)AI大模型和Agent Harness工具
现在市面上常用的工具包括Codex、Claudecode、Antigravity、Workbuddy、豆包工作、千问work等等.....各个大模型厂商都有自己的harness,你可以选择一个自己喜欢的模型,配上它的专属harness,来开始你的创作。 为什么要用Agent Harness?:因为它可以让AI操控你的电脑,可以帮助你干很多事,包括但不限于:找素材选题/剪辑视频/处理图片视频/写分镜提示词等等....能干的事情真的无限大,它的能力取决你想做什么。
我常常会用到Codex、Claude、Gemini和豆包
(二)图像生成模型
现在市面上出色的图像生成模型有很多,做视频会需要准备很多图片素材。模型不需要你什么都用,哪个能用、哪个顺手就用哪个。
如果一个模型一直出不了你想要的画面,你就换一个试试
我在这里给大家推荐以下几个:
-
GPT-image-2.5(🌟): 无脑推荐,我最爱用。控制力最强,适合把明确的想法落实成画面,也方便围绕参考图反复修改。 在codex里可以直接用。
-
Nano Banana 2 / Pro:适合人物参考图和连续改图,方便围绕已有角色调整场景、服装和光线。在Gemini里可以直接使用,但出的图有水印。
-
Seedream 5.0 Pro:能力跟Nanobanana大差不差,在豆包就能用。
-
Midjourney V8.2:一次出4张,如果你想要抽象的、有美感的图,一定要用它试试。它生成的图片非常漂亮,但缺点是几乎无法精确编辑图片。
-
Z-image、Krea2、Qwen-image2.1:本地闭源模型适合不想花钱的朋友;如果你非要玩,我只推荐这三个。电脑配置不错的话,可以在Comfyui里下载他们试试看,如果工作流跑不通,就让你的Codex或Claudecode帮你跑通,或者直接去下载别人做好的Comfyui整合包。 (据说Qwen-image2.1非常牛逼,不过我还没试过,你们可以试试)
总之,前三个模型都可以用,水平都差不多;后两个按需求使用。
(三)视频生成模型
视频生成模型,我只推荐2个。别的模型除非免费,否则都没必要用。
1.即梦(Dreamina)Seedance2.5/2.0(🌟):世界上最强大的视频生成模型,没有之一,不接受任何反驳。它的发挥,取决你的图片是否清晰漂亮,提示词是否精准。
特点如下:
-
支持4~30秒的视频生成,支持480P~4K内容的生成
-
可以放入多种参考内容,包括图片、视频、音频、文字。
-
支持视频编辑,可以在做好的视频里接着改,这个我后面会讲。
-
价格很贵,API基本上都是1块多1秒,除非你开很贵的会员或订阅,否则无论如何你的成本都会非常高。如果你有大量视频创作的需求,我建议你订阅5199元≈800💲/年的高级会员 或 20000元≈3000💲/年的超级会员。
-
订阅制是每个月给固定的积分,如果用不完就会清空。
-
重要提醒(🩷):豆包每天有免费3次的视频生成额度,如果你是新手,请先通过豆包免费额度制作以后,再付费使用该模型,否则得不偿失。
2.Minimax H3: 最近的新秀,可以作为Seedance的下位替代。能力相比大哥来说还是差一点点。
-
支持4~15秒的视频生成,官方提供768P和2K。
-
支持多模态。图片、视频、音频、文字参考。
-
支持本地部署(🌟)最低8G显存可跑,可以在本地想怎么玩就怎么玩。例如一些你平时敢想不敢做的,我就不多说了。
-
价格比Seedance便宜不少,但我没用过付费的,所以不评价。
-
如果你刚开始接触AI视频生成,Minimax H3 也许也是个不错的选择
(四)音频生成模型
“一段好的声音,是一个视频的灵魂。” 声音对视频来说真的非常非常重要。
声音生成这块儿,我给大家推荐两个网站:
1.Elevenlabs,官网地址是elevenlabs.io。 这家的语音克隆我认为是最牛逼的,你只要放入一段参考音频,就能帮你克隆成想要的声音。它克隆出的声音既有感情,又足够还原。 价格不贵。 22美金一个月的套餐完全足够使用!
2.Suno,官网地址是suno.com。 如果你需要做MV,或者为你的影片设计背景音乐,请一定要用Suno,最强大的音乐生成模型。
(五)视频剪辑 & 视频超分& 建模
1.视频剪辑工具
你可以选择用Agent Harness来帮你剪辑,但AI来剪辑,不仅费token,而且很容易出错。 所以剪辑这一块儿,还是亲自动手比较好。
-
剪映专业版(🌟):上手快,适合把 AI 生成的镜头拼成短片,再加上配音、音乐、字幕和转场。日常做短视频,建议先从它开始。提供免费基础功能,部分素材和 AI 功能需要付费。闲鱼上会员100多一年。
-
达芬奇 DaVinci Resolve(进阶推荐):剪辑、调色、音频处理和特效合成都能做。对于 AI 视频,我比较推荐用它统一不同镜头的色彩和明暗,让整部片子的观感更一致。免费版已经能完成很多后期工作,不过深入使用需要花时间学习。如果你实在不想学,就用Codex调色就好。
-
Adobe Premiere,简称 PR,经典工具,不过多赘述。
2.视频超分工具
什么是视频超分? 就是超分辨率,举个例子,你原本是用480P生成的视频,但你可以通过超分工具把它变成4K的。
视频超分工具我推荐大家使用Topaz。中国的朋友们可以去万能的海鲜市场用最便宜的价格拿下它的网盘链接。(考虑到版权,不在此处分享地址)
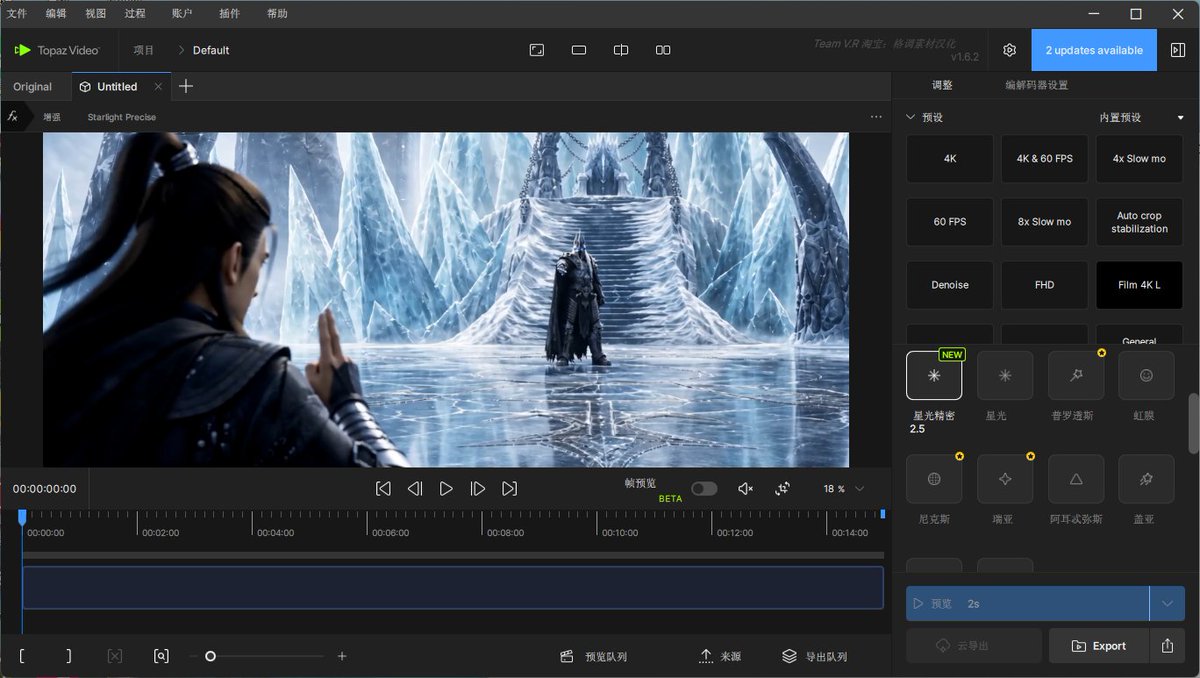
强烈推荐大家使用星光2.5 或者 普罗米修斯
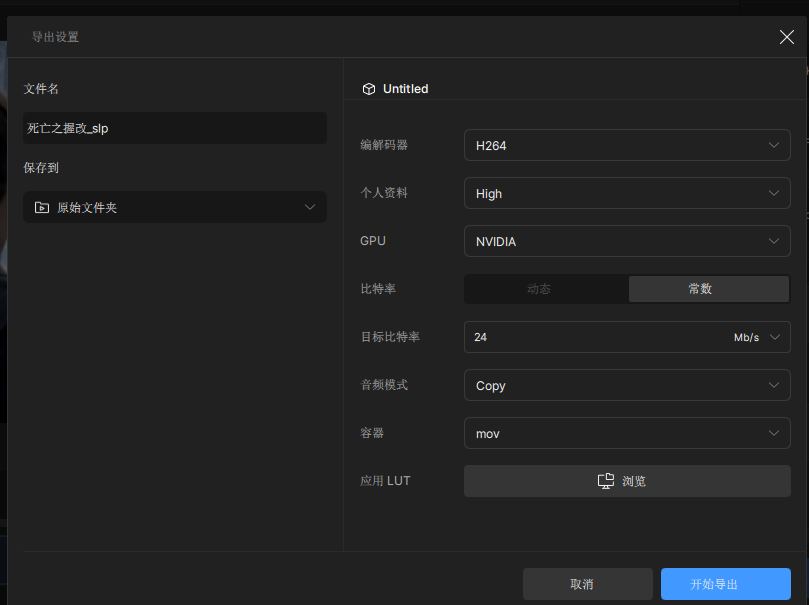
GPU,别忘了选择正确的显卡品牌,否则会超分失败
3.建模工具 ** 除了视频以外,我推荐大家下载一个Blender**,它是一个建模工具,可以用来生成白膜视频。而白膜视频是现在非常流行的一种AI视频控制方法。
即便你自己不会用,你的Codex也会用,下载一个有备无患。 如果你是个懒狗,就让Codex帮你下载。
白膜视频会给视频模型起到极大的参考作用,视频模型会完全渲染白膜视频中的人物站位和镜头运镜。
(六)图片、视频工具在哪儿用?
我先声明,我没有接过任何商单和广告。 任何的工具和模型,我都只会建议你到官方网站去使用下载。 你可以把我提到的这些模型或工具名称在Google或Bing搜索一下,即可找到官方渠道。
很多聚合站都会提供一个工具叫“无限画布”。无限画布真的非常好用,就跟Comfyui工作流一样,可以把各种参考素材都传上去,而且管理很方便。
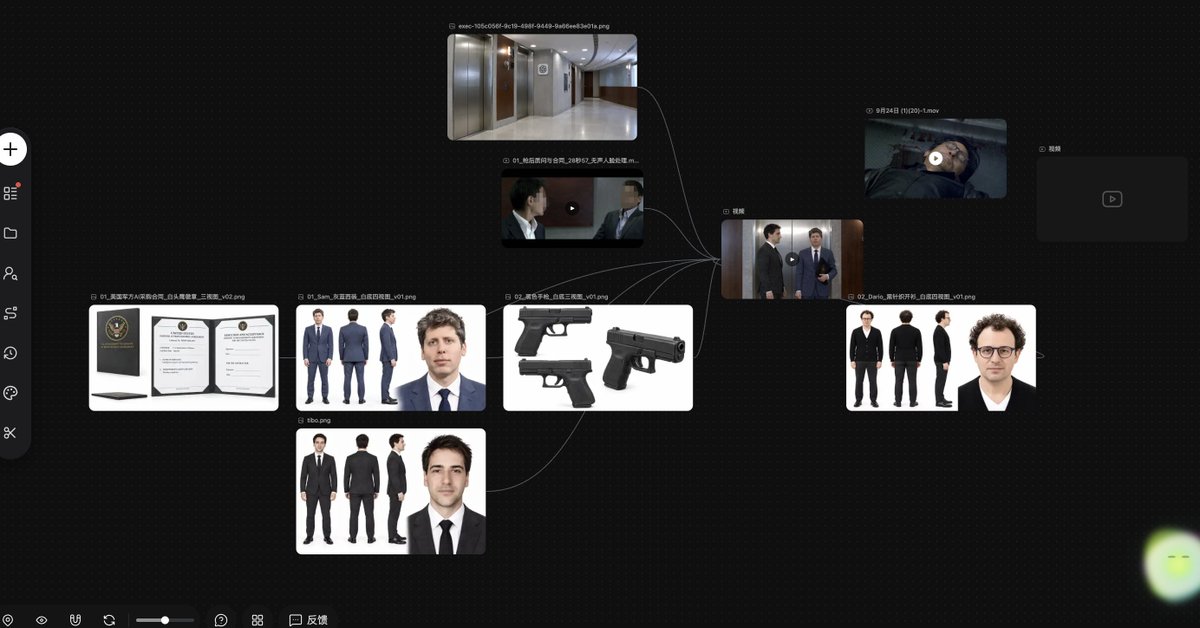
参考图 + 参考视频 + 提示词 + 视频节点 = 一个AI视频
聚合站跟大模型中转站的性质有点像,我强烈建议大家使用正规、大型的聚合平台购买服务,千万不要为了贪小便宜,去那些不知名小平台充钱。
先提示一下部分中转站可能存在的一些小伎俩,大家自行辨别
-
你选1080P,支付了1080P的价格,但中转站实际用480P来生成,最后它偷偷加了一个你看不见的“超分”节点,把480P超分为1080P交付。
-
图片也是一样,你选了4K,实则是用1K的来超分。
-
用烂模型充当好模型,例如你选的Seedance2.0,实际给你Seedance2.0 fast。
-
就跟中国的健身房一样,随时可能暴雷跑路。
说几个比较知名的,至于是否充值,由你自行决断,如果不好用,与我无关。
Higgsfield:https://higgsfield.ai Krea:https://www.krea.ai Freepik/Magnific:https://www.magnific.com Artlist:https://artlist.io LiblibAI 哩布哩布:https://www.liblib.art RunningHub:https://www.runninghub.ai 哔哩哔哩:https://www.updream.cn/ Tapnow:https://app.tapnow.ai
最后再次提醒:豆包每天有免费3次的视频生成额度,如果你是新手,请先通过豆包免费额度制作以后,再付费使用该模型,否则得不偿失!!!
二、资产制作——生成视频前的必要步骤
(一)角色资产
角色资产,就是你希望自己视频里出现的角色。
角色资产的制作提示词应该这么写:
生成XXX(交代人物的细节、服装以及图像风格)的白底四视图,包括全身正面、背面、侧面及面部特写。
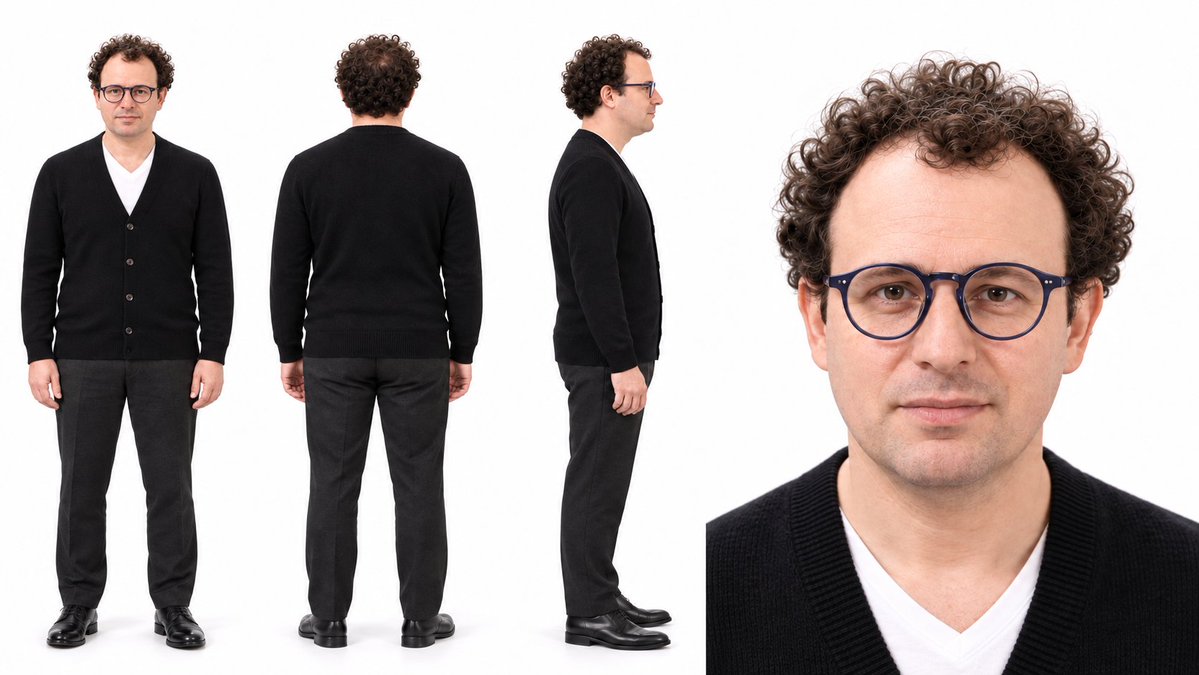
达里奥的人物资产
生成人物资产应当注意以下几点原则:
-
你的资产图越高清,在视频里的效果呈现就越好。因为像素越高,视频模型能识别的信息素就越多。
-
要确定人物的长相、穿搭、细节,要确定作品的画面和美术风格(写实/3D/动漫赛璐璐/虚幻引擎/粘土等等....将之描述给你的图像模型。
-
注意(🌟):如果你希望人物的表情更多元,应该在四视图的基础上再加上这个人物的喜怒哀乐表情,这样会让角色的表情变得更自然。 如果你想省事,可以放到一起;如果你追求质量,可以分2张图传。
-
选择16:9的比例来制作人物资产。
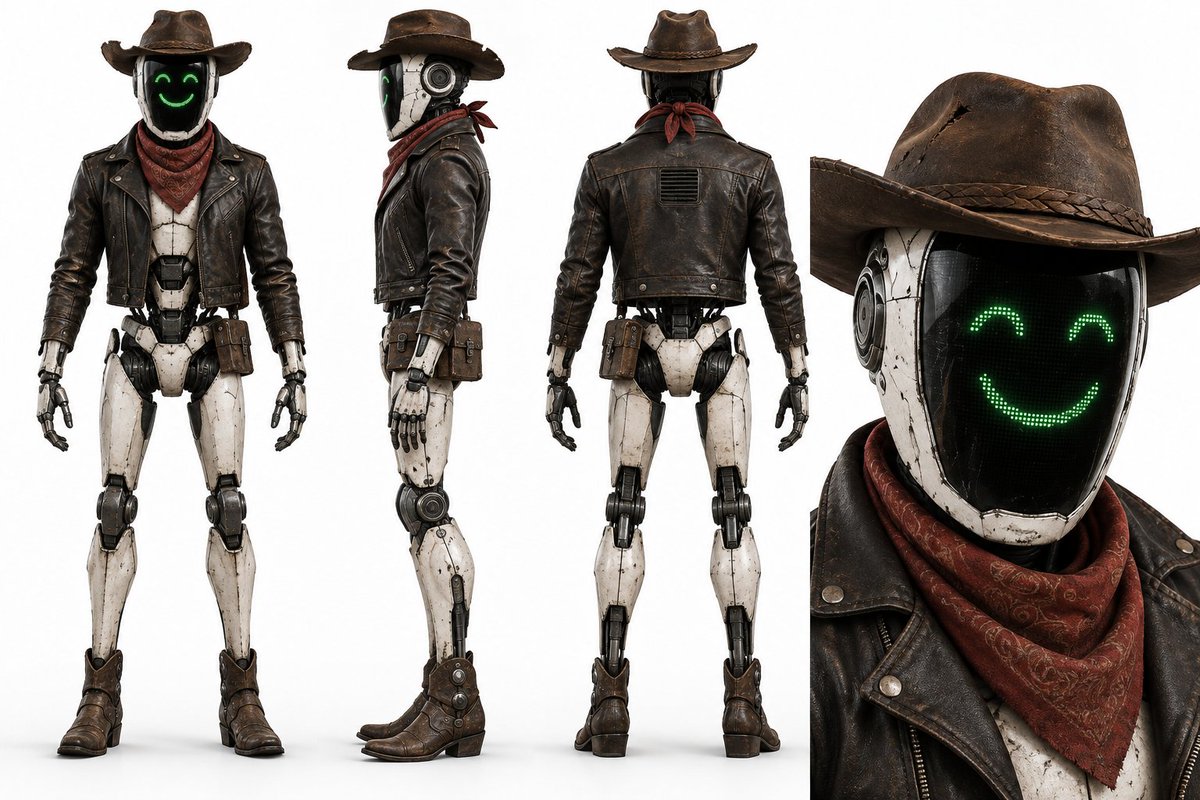
丧尸清道夫人物资产
我们可以通过以下两种方式来结合白底四视图提示词形成人物资产:
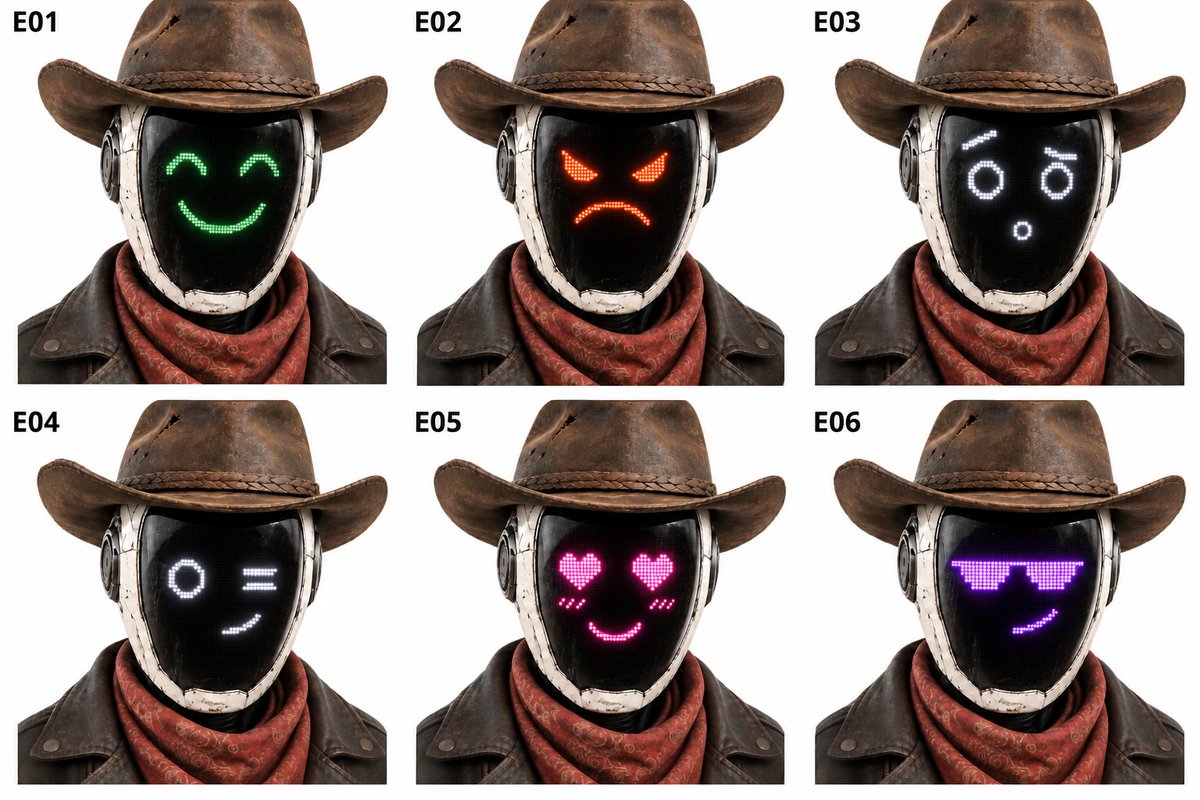
丧尸清道夫的表情
-
通过文生图的方式,用语言描述来构造一个人物的资产图。 例如:帮我生成一张Claude老板达里奥的.....一些知名人物,你只用说他们的名字,图像生成模型就会帮你把资产做出来。
-
通过图生图的方式,例如在网上搜索达里奥的照片,然后作为参考图丢给图像模型,再加上白底四视图的提示词,就能得到一个人物的资产图。
什么?你懒得去网上找达里奥的照片?!!
告诉Codex:请你帮我去网上找一下Anthropic CEO 达里奥·阿莫代的照片,并生成他的白底四视图,包含全身正面、背面、侧面及面部特写。图像比例为16:9。
如果你完全不知道自己该生成什么样的东西,我推荐你去使用悠船midjourney来生成图片,它生成的图像非常具有艺术美感,可以帮你找到灵感。
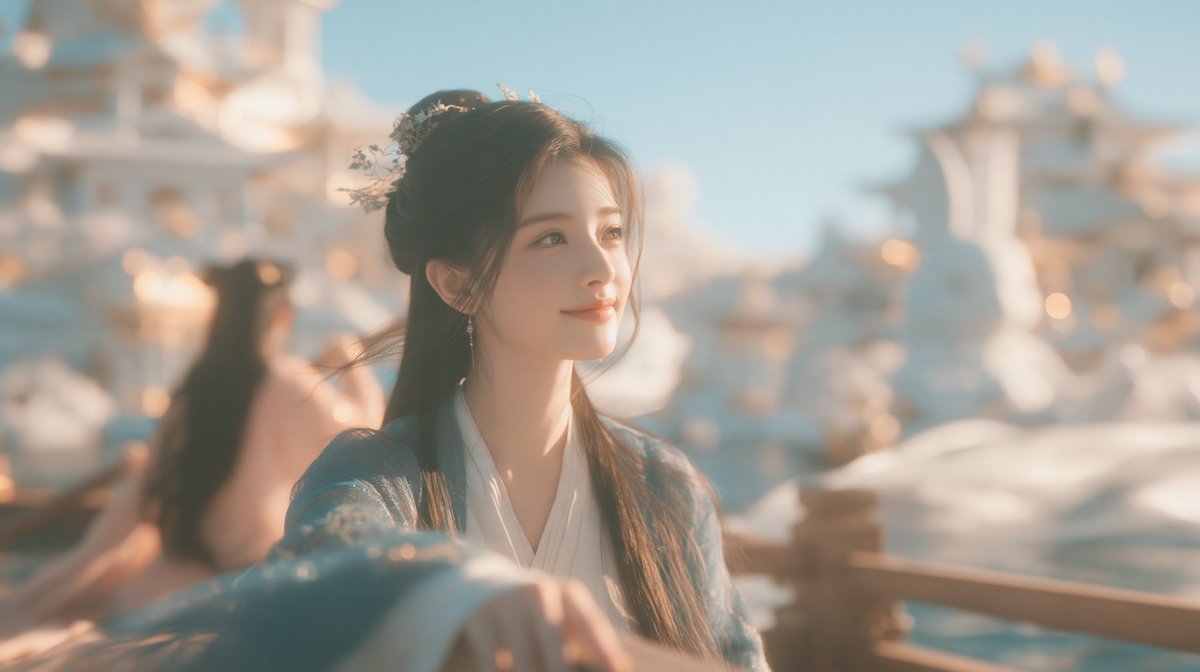
来源:万能的群友用midjourney制作的图片
人物资产过不了审该怎么办?
顺带一提,如果你使用的是中国的平台,那么就会涉及到比较严格的审核机制。我认为这些平台都是AI审查,你要做的就是骗过AI的OCR识别。
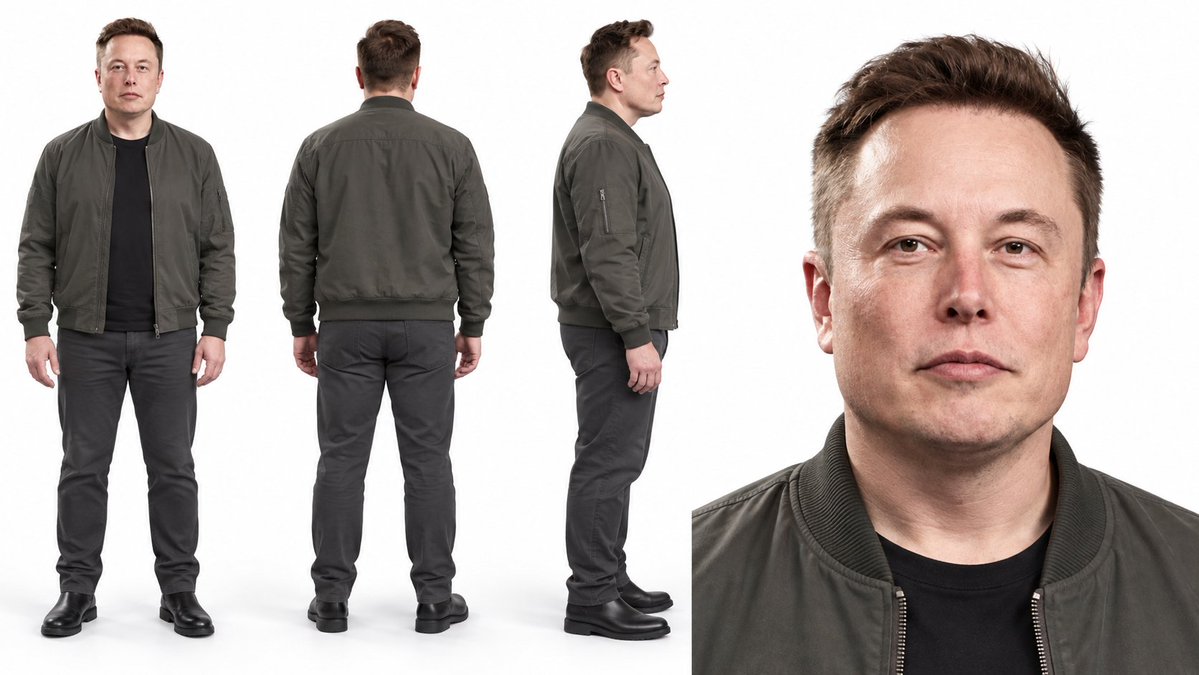
马老板的四视图,100%过不了审版本
上面这张马老板的图片,你在国内任何平台都100%过不了审。但下面这张图,就一定能过审,而且大家能看出这是马老板。
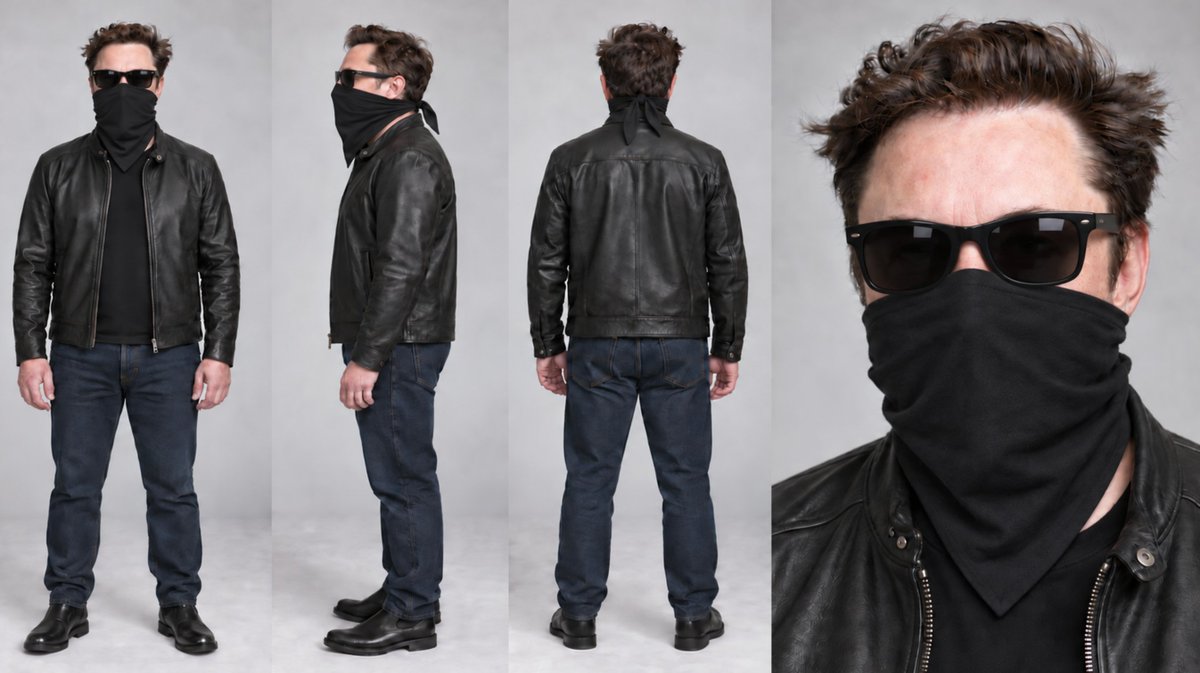
所以,如果你想要自己的人物能够过审,就来一点小心计,给他加一个墨镜,或者面具试试,万一过审了呢?
(二)场景资产
有了角色,那就需要给角色留一块儿表演的地方,场景资产我认为没有什么提示词。
还是两种方式:
-
文生图。通过让AI利用文字来生成场景图片
-
图生图。你可以上传一张你拍过的地方,把它制作成场景,例如你家里/旅游过的地方/学校/公司等等....也可以去网上翻找素材,将其作为参考图让AI帮你生成一个场景。
场景图制作的原则是:
-
尽可能的生成一个场景的全貌,不要只生成某个角落,除非你的角色只在某个角落表演。例如下面这张图里的冰封王座,就是一个典型的半截场景。 这样的场景,视频模型不知道它背后的样子,很容易在生成的过程中出现两个人“正反打”时背后都有冰封王座的情况。 在这种情况下,你还需要生成这个场景的另一面。
-
如果你说你非得要这个经典视角,那么需要确认你的人物正反打不会涉及到冰封王座的背面。 之后我会讲怎么来控制这一点。
-
场景的材质尽可能的要做到高清、高清、还是他妈的高清。8K、超清,把你能想到的高清词都大胆的告诉AI。
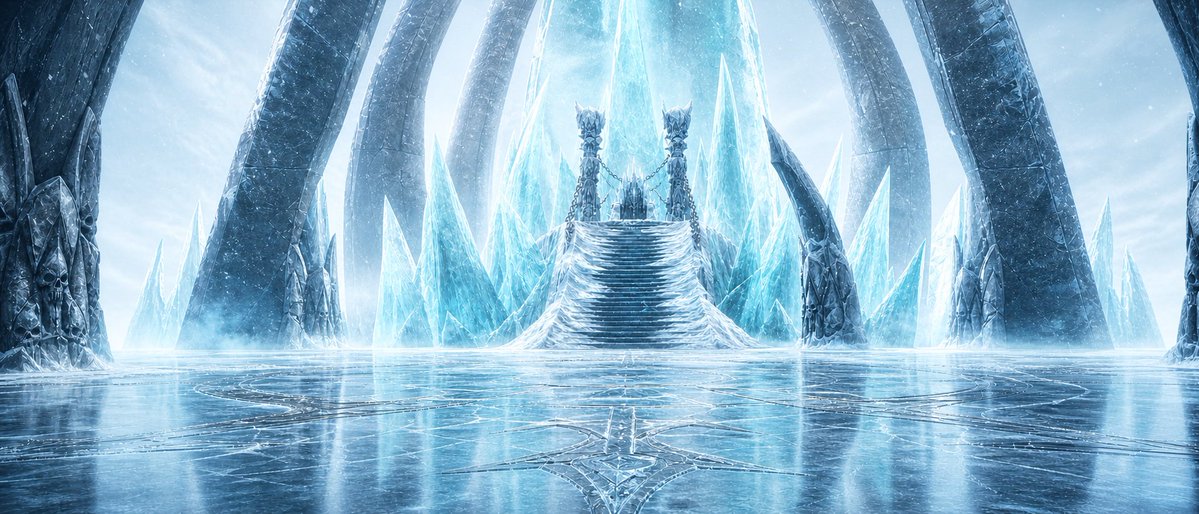
作品:韩立大战巫妖王
- 就像泰坦尼克号这一部,因为Rose和Jack全程都在这个船头上表演。那么我就只需要把这个船头的场景制作出来即可。 因为这张图完全可以覆盖Jack和Rose的表演范围。 https://x.com/Xanderwow_A/status/2102056025872306658
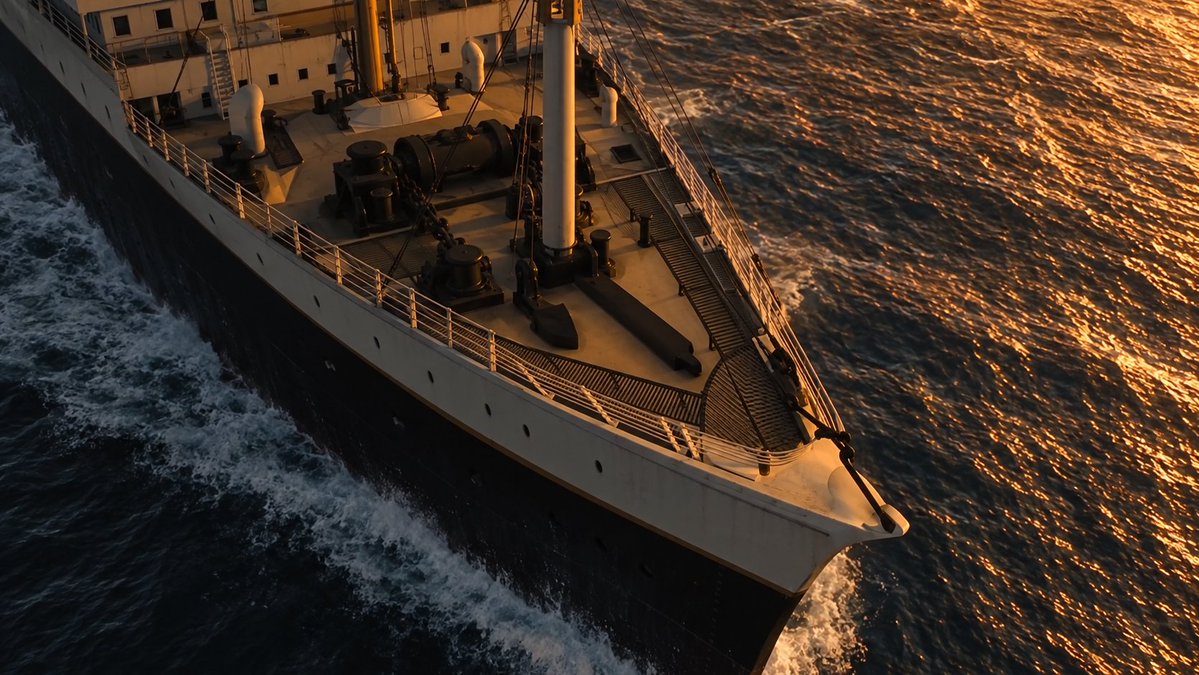
达里奥和奥特曼《泰坦尼克号》的场景资产
这张泰坦尼克号的场景资产图,我的制作方法是:
告诉Codex:帮我对照泰坦尼克号的参考原片,根据人物演出的场景,制作场景图,要求画质高清,并保持原片的光线、光照。展示场景全景。
发一个场景做的比较全的,大家可以看一下:
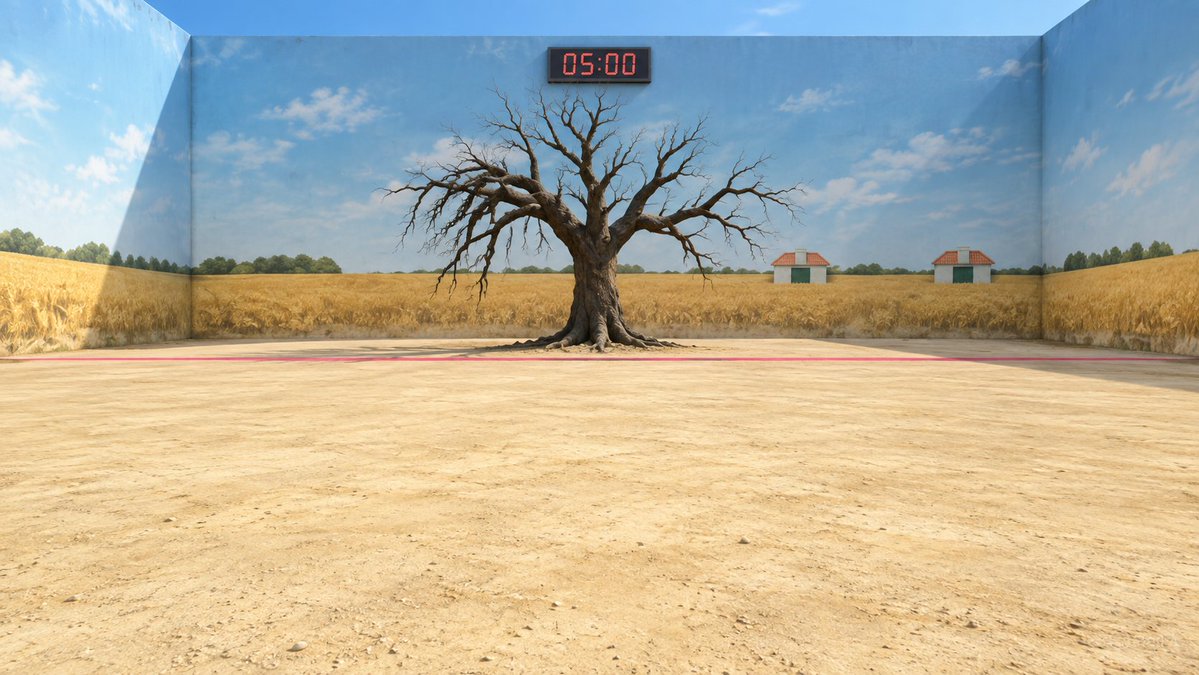
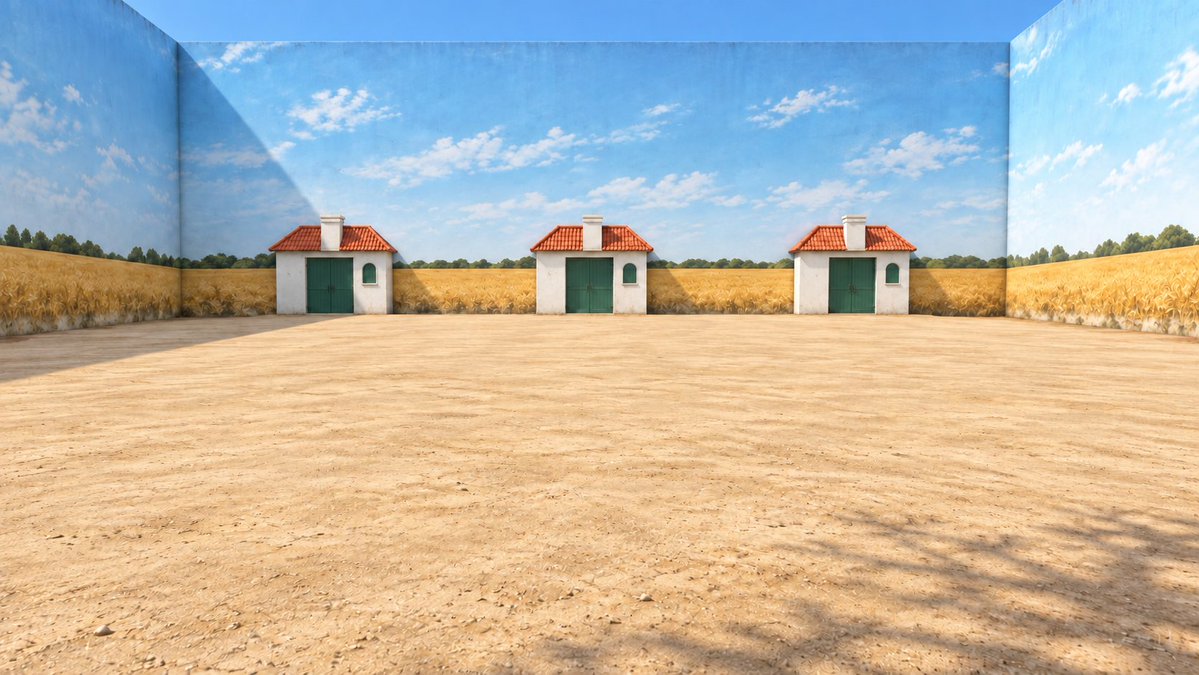
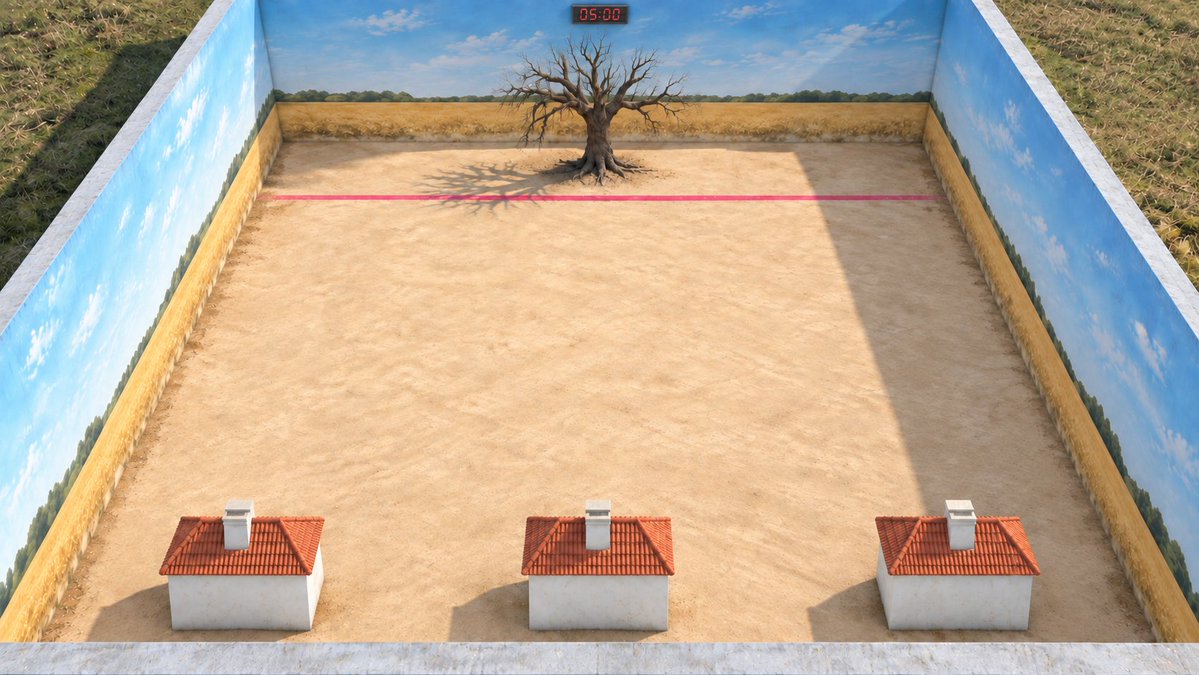
只要你上传的信息要素足够全,再加上视频模型不降智。基本上它都会按照场景的正常逻辑来工作。
如果你觉得场景很难控制,不想让模型出错。 那么我在这里提供一个思路:
只要正面背面的场景都是对称相同的,那么就不需要担心场景的错位
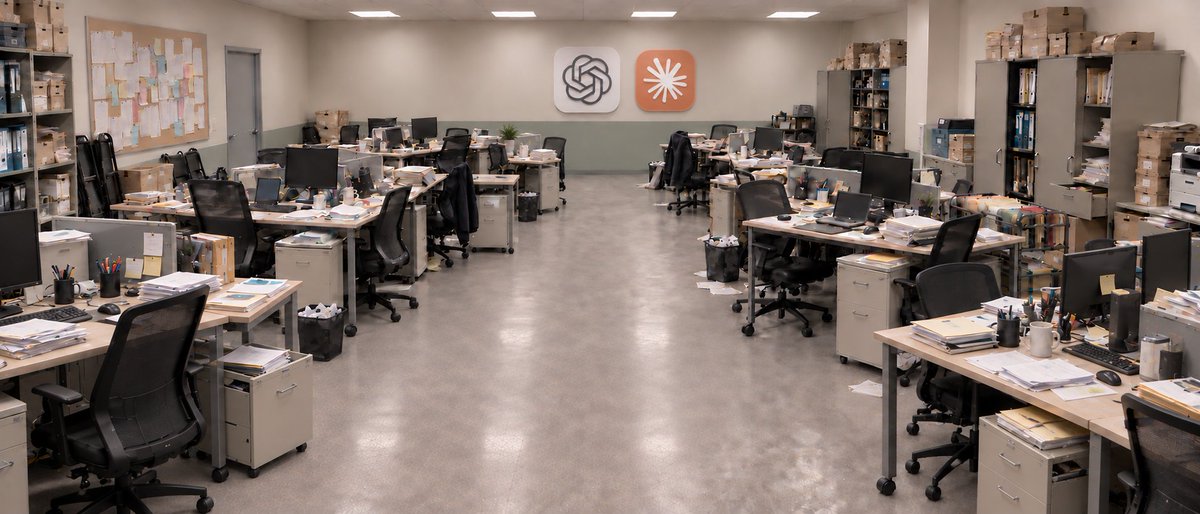
例如这张达里奥大战奥特曼的场景图,我是把它视为正面和背面都是同一个样子来制作的。所以就没有为场景操太多的心。
最后,跟人物资产一样,如果你依然不知道做什么场景,那么midjourney也是最佳的场景制作选择~
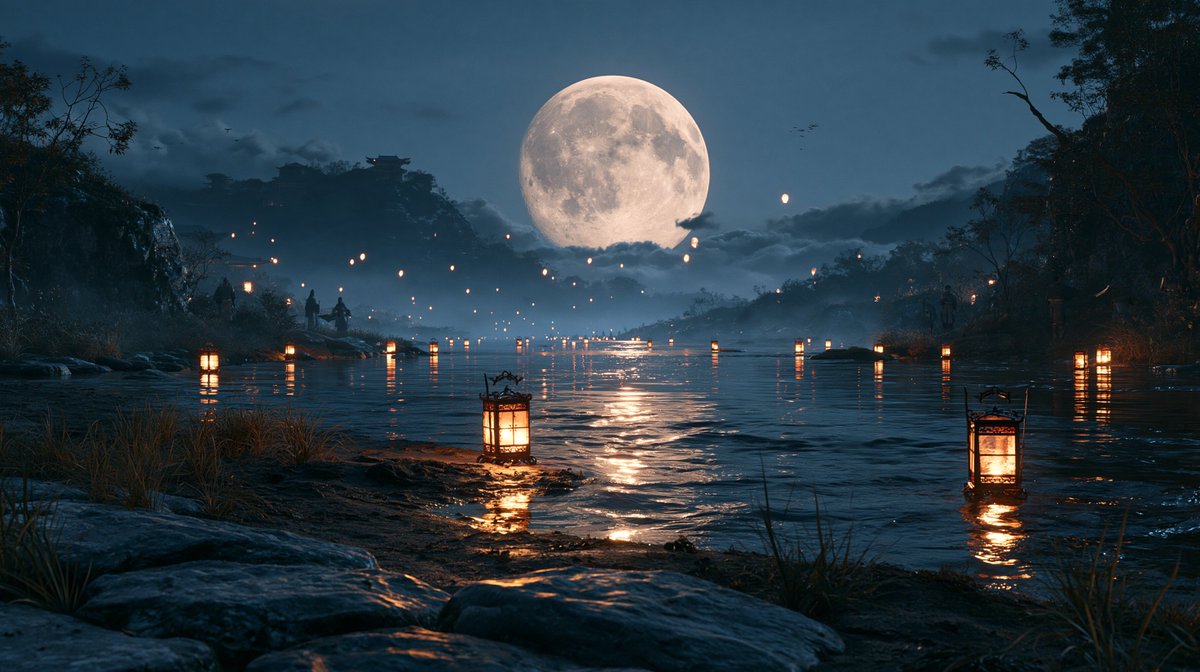
由midjourney生成的场景图片
(三)参考视频资产
参考视频,意思就是你丢给视频模型,要让它对标生成的视频。 需要参考视频的情形我认为有两种:
1.参考别人的视频(影视经典、平台爆款),用来替换其他人物和场景
**其实这很简单,你的目标就是想办法找到你想参考的那个视频的原片,并把它下载下来,然后作为参考。下面我给大家推荐两种方法,你们可以偷偷去用。
-
例如我要爬取Youtube,B站等平台的视频,我用的工具名称叫yt-dlp。当我需要一个视频的时候,我会给我的Openclaw一个视频地址,让它去下载我想要的视频。Github仓库地址:https://github.com/yt-dlp/yt-dlp
-
如果你很懒,那么告诉你的Codex或Claude code,向它许愿,让它帮你找到你想要的,然后给你。
-
特别警告⚠️:除非你很需要原片中的某个声音,否则最好将原视频中的音效给去掉,否则Seedance会将参考视频中的原声用到生成的视频里。
-
我会在下一期,讲如何越过影视经典镜头的审查限制。
2.你需要精准的控制一个视频的运镜
这就跟我一开始提到的Blender有关了,你需要在Blender里制作好白膜人物和场景,设定好机位,然后按你想要的方式去移动机位。 这种白膜视频往往会起到非常棒的控制效果,Seedance模型会优先遵循白膜参考视频里的人物站位和运镜。
但值得注意的是,白膜视频其实是个双刃剑,你如果用得好,它就是最佳搭档,你如果用不好。它就会成为一个笑话。
先来给大家展示一个负面案例......
为什么会产生这样的情形? 其实是因为作者在建模时,给人物刻画了过于具体的动作。导致视频模型在生成时会认为这就是用户想要的动作....
正确使用白膜的姿势应该是:构建一个完整的场景,但人物的样式一定要足够模糊!给到视频模型足够的想象空间。例如把人物做成方块或没动作的人,然后用颜色区分开,这才是正确的用法!
例如@Magncsans制作的这段视频,你会发现里面的人模都没有复杂的动作。
为什么很多大佬的原创作品都很惊艳,很大一个原因就是他们都在用白膜来控制AI视频生成。
什么?你说你不会建模???
巧了,我也不会。那你用Codex帮你做不就好了? 为了确保效果,我建议你使用GPT-6-Astra....
(四)声音资产
声音资产,在我浅薄的知识里,我一般需要以下三种:
1.角色的说话声
**还是跟开头说的一样,我强烈建议大家到Elevenlabs去生成声音,方法很简单,就是把你想要的声音丢给它,然后让它生成你想要的声音。然后生成声音我有2点建议:
-
最好一次性把人物这个视频里的所有台词都生成。 因为声音模型每次生成的结果都不一样,如果分开生成,会出现说话声音缺乏一致性的情形。
-
如果你希望你的角色富有更多声线,例如说悄悄话,大声喊,正常说话话,那么我建议你每个声线都克隆一遍,需要哪个用哪个。
2.背景音乐
背景音乐有两个搞定的法子:
-
如果你要走AI生成,顶级原创。直接suno就完事了,唯一的神。
-
如果你要用别人的背景音乐:(1)剪映里面有音乐库,可以直接把别人上传的音乐拿过来用;(2)很多音乐软件可以下载音乐;(3)让你的Codex帮想尽办法去找到这段音乐,许愿就完事了!
好的背景音乐决定了一个视频能不能爆,它会影响片子的节奏和连续性! 所以大家一定要重视。
注意🌟:AI生成视频的时候会帮你自动配乐。如果你需要做15秒或30秒以上的视频,这个功能必须关掉。否则你的片子很难流畅剪辑。 我自己现在用的提示词是:禁止bgm、背景音乐和智能配乐。 Seedance2.0管用,可是2.5就不管用了,会玩的朋友看到了教我下。
3.场景环境音
环境的声音,现在的Seedance2.5/2.0模型已经可以做的非常棒了。除了一些特殊的声音,例如爆炸、心跳等等。这些声音可以先在剪映音乐库里翻找一下。
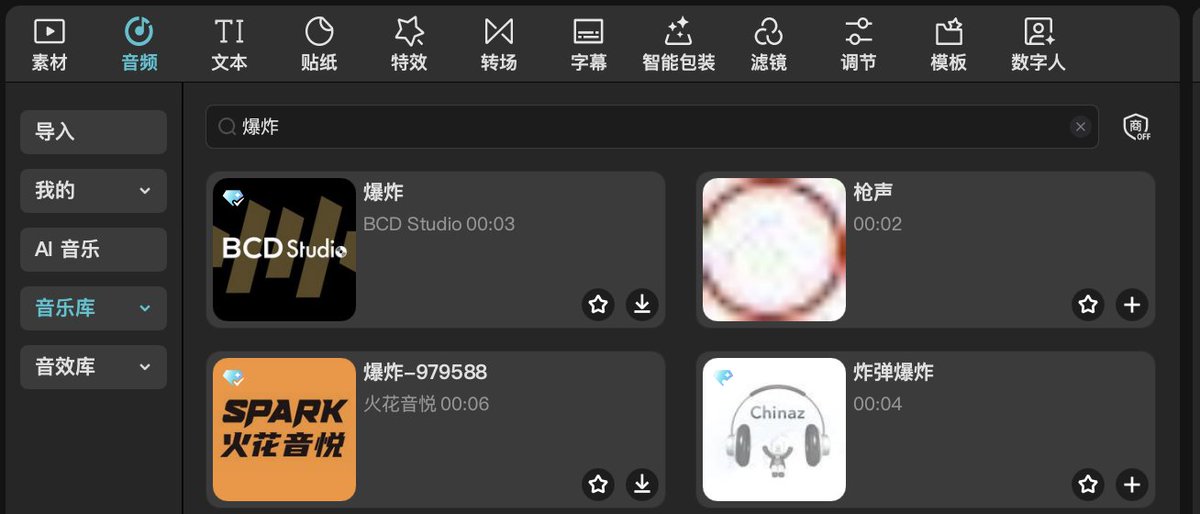
如果剪映里面都没有,你应该先去向Codex许愿,如果不行,再去找Elevenlabs生成。
(五)剧情与分镜资产
1.剧情
这个我不专业,没有资格评价。但我一般都是让Codex或者Claude帮我写。
-
X的话,我认为还是比较看内容的。为什么我会做出来那个600万的视频? 因为我的朋友在之前给我发了一个他做的视频,让我发到X上试试效果:https://x.com/Xanderwow_A/status/2100848761215881681 这个其实就是kotte视频的改编,我没想到居然有20多万的播放。 于是就萌生了我要做Dario大战Altman的想法。
-
抖音这些短视频平台我没做过,所以不评价。我只知道开头要有钩子。
-
B站的话我认为标题挺重要的,我把标题改成*【X/推特600万播放】达里奥大战奥特曼 *。播放量从几千很快就涨到了10万。
2.台词
如果你使用的是Agent Harness来写台词,一定要把台词做成MD文档存起来。Codex是256K就会压缩上下文,Claude是1M上下文,你如果一直围着一个项目或者作品让它创作,里面的上下文不停的压缩,它有可能会把你的台词忘掉。
举个例子,当你一个视频有好多个片段,你第一个片段是一套台词,到第五个片段的时候,如果你没有存台词,codex可能会忘了,然后给你别的词。 这时候你要是没有检查视频生成提示词,或者你也忘记了,那这个视频基本上就白做了....
台词的话,最好一上来,就把整个片子的台词做好! 不要边做边改。如果你是参考别人的视频,一定要确保台词的长度跟那些影视镜头的时间轴对得上,否则就会出现“牛头不对马嘴”的情形。
3.分镜
分镜对于AI视频生成来说非常非常重要。 我认为分镜资产制作分两种情形:
-
参考他人的视频。 这种情形不需要设计分镜,参考别人的镜头调度就行。
-
自己原创。 这种情况的话一定要规划好分镜,一个15秒的镜头里,有哪些机位,机位是怎么运动的,都要做好规划。
分镜的规划当然可以让AI帮忙做。 之前的Seedance2.0 你可以把分镜细分到每一秒,例如 在某一秒, 机位是什么,人物在场景里干了什么。
【0-2秒】中景·矮人肩后机位·固定机位·50mm;矮人的后脑、毛领和右肩位于右侧前景,右前臂放在大腿上。石板上传来爪部落地声,矮人眼球先向左移动,随后头部向左转动约15度,身体仍保持坐姿。
但现在的Seedance2.5已经不需要这样了,不需要精确到几秒。
镜头1:沿用参考视频开头的双人近景与轻微镜头移动。针织衫男子在前轻闭双眼,感受海风,嘴角从放松状态收住,轻吸一口气后说:“We need to slow the pace of AI development.” 在“slow the pace”上稍加重音,句末语气落下。西装男子在后方,按视频调整头部与身体,目光落向对方侧脸,再短暂看向两人的支撑位置,安静听完。
这些都是AI能帮你写的,所以千万不要担心自己不懂,AI能做的很棒。
刚刚在前面我们提到:“一个场景,如果只有正面,没有背面,该怎么去控制AI去规避镜头里遇到的这个“不存在”的背面? 一是可以用白膜视频;二是可以用下面的这个方法。
这里又教你一个新技术,这很重要,要划重点
黑白线稿分镜图
这张图片,被视频模型参考的权重也会非常大,但低于白膜视频。如果没有创造白膜视频的条件,可以考虑制作黑白线稿分镜图。
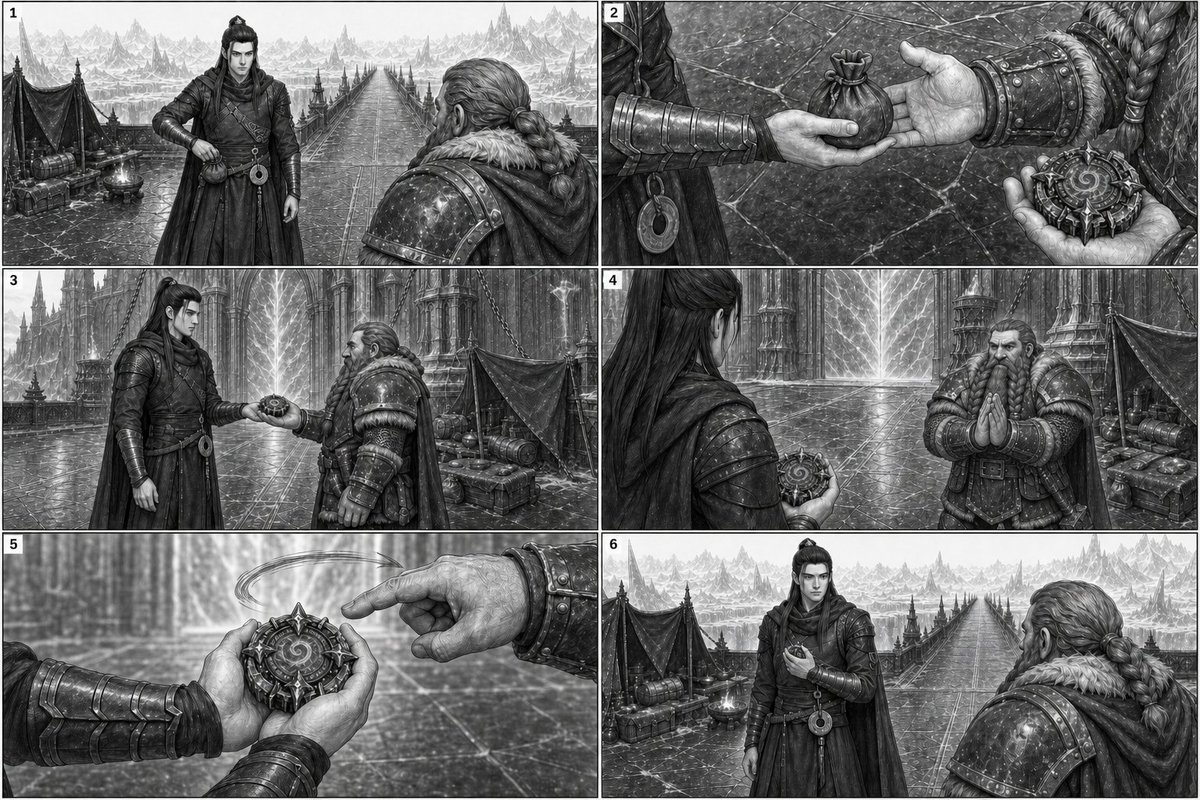
举个例子,这是韩立跟矮人交易的一次对话。 我给了Codex 以下内容: 人物资产、场景资产(正反面),视频提示词。 它自己就生成了这张分镜图。 然后我把这些东西全部丢给Seedance2.0,这是效果:
想学这个黑白线稿提示词怎么写吗?
不用学,你把我这张图丢给Codex,让它照着你的剧情生成黑白线稿分镜图就行。
在这里也提一嘴,大家不要老想着什么提示词工程,真没什么用,你自己脑子里规划的那个大框架,才是最管用的。细的东西AI能做的很棒。
这期先讲到这里。因为每篇文章有放置媒体数量的限制,我没法放更多的图片和视频了。为了确保效果,还是图文并茂的讲,大家才容易看懂。
在下篇,我会讲参考视频中的经典影视镜头如何“过审” 、提示词的撰写、视频模型的玩法及视频处理的方法。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


