
AI 视频小白第一课!文生视频+动作迁移视频教程【万字长文】
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
Hello 朋友们大家好,我是 Serena 木瓜!好久没有更新长文了。
这段时间我一直在准备线下活动,其中我负责分享的部分是 AI 视频制作。通过线下反馈我发现大家其实对这个都蛮感兴趣的,AIGC 也包含着巨大的机会!
所以今天我会带着大家一点一点把概念捋清楚,教大家制作出属于自己的第一个文生视频和动作迁移视频。
那我们马上开始!
看了这篇文章,你会学会什么?
-
AI 视频的一些基础概念
-
学会去模仿大V 提示词去制作自己的第一条文生视频
-
制作抖音爆火的舞蹈动作迁移视频
第一章 AI 视频模型与平台介绍
1. 常见模型与基础概念
模型是"生成能力"的提供方,比如:Seedance 2.5、 Minimax H3
平台是"使用模型的地方",比如:小云雀、即梦、flova
1.1 文生图、文生视频、图生视频三者的区别是什么呢?
| 生成方式 | 输入 | 输出 | 典型用途 | 上手难度 |
|---|---|---|---|---|
| 文生图 | 一段文字描述 | 单张图片 | 定妆照、分镜图、海报素材 | 低 |
| 文生视频 | 文字描述(可含镜头与运镜) | 一段视频 | 从零构思剧情、场景演示 | 中 |
| 图生视频 | 一张或多张参考图 + 提示词 | 一段视频 | 让已确定的角色、场景动起来,一致性最好 | 中 |
1.2 文生视频和图生视频该怎么选择呢?
只有画面想法,用文生视频;已经有想保留的画面,用图生视频。
| 文生视频 | 图生视频 | |
|---|---|---|
| 适合什么时候 | 从零探索场景、风格和镜头 | 已确定人物、产品或场景的外观 |
| 你提供什么 | 用文字描述画面和变化 | 参考图+希望发生的动作 |
| 主要优势 | 创作空间大,适合快速试想法 | 起始画面更可控,便于延续视觉风格 |
| 主要难点 | 人物长相、服装、产品细节可能偏离预期 | 动作幅度大时仍可能变形,参考图也会限制构图 |
比如:
-
想做“一只猫在月球上开咖啡馆”,还没想好猫和店铺长什么样 → 文生视频,先探索效果。
-
已有角色定妆照,希望她转头、微笑、走路 → 图生视频,更容易保持角色外观。
-
已有保温杯产品图,希望镜头绕杯身移动 → 图生视频,但 Logo、文字和结构仍需检查。
-
只需要一段雨夜街景、云海或科幻城市素材,没有必须一致的主体 → 文生视频。
做连续剧情时,也可以组合使用:先生成并选定角色和分镜图片,再用图生视频让各个镜头动起来。
2. 主流视频模型怎么选?大概需要花多少钱?
现在视频模型有很多,大家可以根据自己手里的预算,还有想要制作的视频类型进行选择。
如果你做一些产品的广告,MiniMax H3 的性价比是最高的。
如果你要做一些比较复杂或者是质感很高的短片,大部分人还是会选择Seedance 2.5模型。
下面这 7 款模型,可以作为入门时的候选。表里的场景是选择方向,不代表某种视频只能用某款模型。
| 模型 | 什么情况下可以先试它 |
|---|---|
| 可灵 2.5 Turbo | 已经有一张人物图或产品图,想做动作、运镜,先生成几个镜头看看效果。 |
| MiniMax H3 | 做产品展示、广告,手上有图片、视频等参考素材,希望模型结合这些素材生成画面。 |
| Wan 3.0 | 想生成一段相对完整的介绍或故事。它支持最长 30 秒输出,也支持根据文档等资料生成视频。 |
| 可灵 3.0 系列 | 做带人物对白、多镜头切换的短剧情。选择时注意具体版本,以及是否开启声音。 |
| Seedance 2.5 | 画面里有多个人物、多个场景,或者需要参考动作视频、白模视频来控制内容;也适合需要继续修改已有片段的任务。 |
| Veo 3.1 | 想把画面、对白和环境声一起生成,例如街头对话、生活场景、带声音的故事片段。 |
| Gen-4.5 | 想尝试广告镜头、氛围画面和不同的运镜效果,尤其是已经在使用 Runway 做视频的人。 |
价格怎么看?先分清你在哪里买。
同一个模型,在官方网页、聚合平台和 API 上的价格可能不同。网页端通常收会员费、扣积分;API 是通过接口调用模型,按实际用量收费。如果你用的是 LibTV、TapNow 等聚合平台,就看这个平台生成前显示的积分,不能直接套用下面的 API 价格。
下面以累计生成约 30 秒视频素材为例,帮助你建立预算概念。金额是生成费用,不是完成一条视频的全部费用。
| 模型与使用渠道 | 约 30 秒素材的费用 | 需要知道的条件 |
|---|---|---|
| MiniMax H3/阿里云百炼 API | 768P 约 15 元;2K 约 24 元 | 只算输出的基础费用。上传参考视频也会计费;每次输入图片超过 5 张,超出部分另收费。 |
| Wan 3.0/阿里云百炼北京区 API | 480P 约 9 元;720P 约 18 元;1080P 约 36 元 | 按成功生成的视频秒数收费,这里使用的是官方原价。 |
| 可灵 2.5 Turbo/国际站 | 按发布时的 1080P 计费标准,30 秒合计 150 积分 | 发布时为每 5 秒 25 积分。人民币成本取决于你购买积分的价格,当前扣分以生成页面为准。 |
| 可灵 3.0 系列/国际站 | 根据版本、分辨率和声音设置,在生成页面查看扣分 | 不适合统一写成“30 秒多少钱”。原生声音、不同生成模式等都会影响费用。 |
| Seedance 2.5/火山引擎 API | 按调用规格与计费量计算,以控制台报价为准 | 不同渠道的价格不能混用;生成前先查看当前规格的报价。 |
| Veo 3.1/Google Flow | 免费用户每天有 50 积分。非 Ultra 用户生成 4 条 8 秒视频:Lite 40 积分、Fast 80 积分、Quality 400 积分 | 实际生成的是 32 秒,再剪成 30 秒。免费积分未用完不结转,高峰期可能暂时无法生成视频。 |
| Gen-4.5/Runway | API 约 3.60 美元;Standard 月付会员按积分用满折算,约 8.64 美元 | 会员实际支付的是每月 15 美元,含 625 积分;30 秒消耗 360 积分。API 和网页会员是两套计费方式。 |
以上价格核对于 2026 年 9 月 22 日,具体以购买和生成页面为准。
如果暂时不想付费,可以先试 Google Flow。 不开通付费会员,也能获得每天 50 积分。如果全部用来生成 Veo 3.1 视频,可以这样算:
| 模式 | 每条消耗 | 50 免费积分能生成多少 |
|---|---|---|
| Lite | 10 积分 | 5 条,每条可选 4、6 或 8 秒 |
| Fast | 20 积分 | 2 条,剩余 10 积分 |
| Quality | 100 积分 | 当天免费额度不够生成 1 条 |
这些积分适合拿来练习提示词、试试画面效果。当天没用完的积分不会累积到第二天,高峰期也可能需要等待。注意扣费按生成的视频条数计算,一次操作如果生成两条,就会扣两条的积分。
还有一笔钱,很容易在刚开始时漏算:重做的费用。
比如,某个镜头生成一次花 6 元,你做了三次才选到满意的版本,这个镜头实际就花了 18 元。参考图、配音、剪辑等费用,还要另外考虑。
所以,刚开始不用急着买年费,也不用一次生成整条片子。先做一个短镜头,看看效果、等候时间和实际扣费。确认能用,再继续往下做,预算会更好掌握。
3. 聚合平台对比
这些平台都有不同的优势,大家可以根据功能做出自己的判断。
不过,用 AI 生成视频的逻辑都是通用的,只要你会用一个平台,后面的平台也就都会用了。
大家可以根据自己的喜好来选择: • 如果喜欢画布,就选画布类的平台 • 如果更喜欢对话驱动,可以选对话驱动类的平台 • 另外也有一些平台既带对话又带画布
| 平台 | 平台类型 | 核心特色 | 适合人群 |
|---|---|---|---|
| LibTV | 聚合平台 | 多模型整合,提供无限画布、剧本生成、角色造型、智能剪辑和 Agent;支持 Blender 白模视频接入。 | AI 短片、漫剧、产品广告创作者;需要统一管理角色、分镜与素材的人。 |
| TapNow | 聚合平台 | 通过画布连接文字、图片、视频和音频,搭建可复用的创作流程;支持克隆社区共享画布。 | 设计师、广告创意、电商视觉团队;喜欢自己搭流程、复用工作流的人。 |
| Flova | 聚合平台 | 对话驱动的成片 Agent,结合分镜、素材管理和剪辑时间线;支持手动调整与 Skills 复用。 | 有故事或成片需求,希望通过对话推进制作的个人创作者、短片和 MV 制作者。 |
| Higgsfield | 聚合平台(兼有自有创作技术) | 集成多个视频模型,强调运镜预设、动作参考和 Cinema Studio 等镜头设计工具。 | 产品广告、时尚视觉、音乐短片创作者;重视运镜和视觉效果的人。 |
| 可灵 AI/Kling | 模型厂商官方平台(快手) | 提供文生视频、图生视频、动作参考与角色控制;可让参考角色跟随视频中的动作表演。 | 人物表演、舞蹈、角色短片创作者;对人物动作有明确要求的人。 |
| 即梦 AI | 模型厂商官方平台(字节跳动) | 中文创作,整合图像与视频生成;支持首尾帧控制,以及局部重绘、扩图等画布功能。 | 中文创作新手、自媒体运营、内容设计师;希望先生成图片再制作视频的人。 |
| 海螺 AI/Hailuo | 模型厂商官方平台(MiniMax) | MiniMax 视频模型的官方入口;支持多种参考素材、原生声音视频生成及编辑,具体取决于所选模型。 | 希望直接使用 MiniMax 模型的创作者;产品展示、广告和创意视频制作者。 |
| Google Flow | 模型厂商官方平台(Google) | 围绕 Google 模型整合图像、视频与声音创作,提供参考素材生成、视频延长、编辑和场景组织。 | 叙事短片、场景镜头、带声音视频素材的创作者。 |
| Runway | 模型厂商官方平台(Runway) | 结合生成、编辑、表演相关工具和自定义工作流,支持角色、分镜、广告等多步骤制作。 | 有剪辑、设计或影视基础的创作者;需要将 AI 接入现有制作流程的团队。 |
按平台主要定位分类;官方平台也可能接入第三方模型,聚合平台也可能拥有自有模型或技术。适合人群是根据功能作出的判断。
第二章 视频生成步骤与工作流
选好工具以后,我们先弄清楚两件事:一条图生视频是怎么做出来的,以及怎么用提示词把自己的想法说清楚。
这一章先把流程和写法讲明白。等到了第三章,大家再跟着具体案例上手,就会更容易理解每一步在做什么。
第一部分:图生视频的完整制作流程
做一条有多个镜头的视频,可以先按这个顺序来:
写故事 → 定角色和场景 → 列分镜表 → 生成分镜图 → 图生视频 → 剪辑配声。
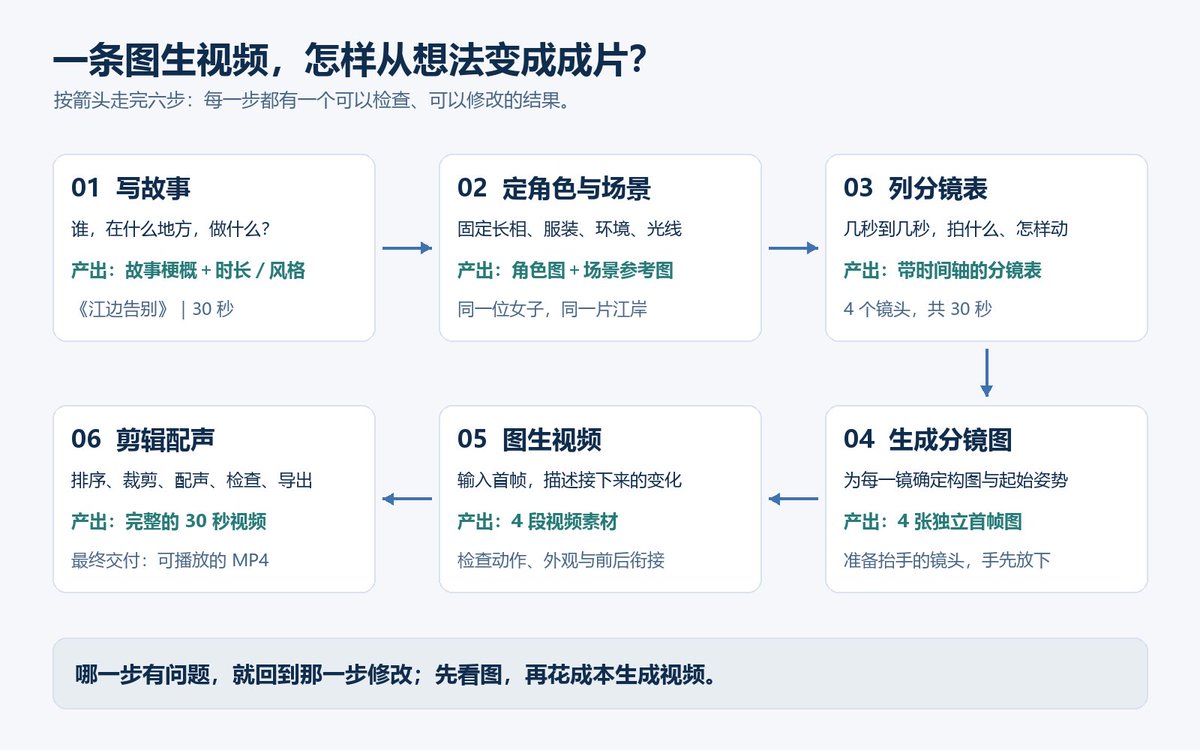
我们先看每一步要做什么,以及做完以后手里应该有什么。
| 步骤 | 具体做什么 | 这一步的产出物 | 进入下一步前,看什么 |
|---|---|---|---|
| 第一步:写故事 | 想清楚谁在什么地方,发生了什么,最后怎样结束。同时确定大致时长、画幅和风格。 | 一段简短故事,以及“30 秒、16:9、写实风格”这样的基本设定。 | 故事能不能用画面表达?动作和场景会不会太多? |
| 第二步:定角色和场景 | 写清主角的长相、发型、服装,以及场景的时间、地点、光线;生成或准备相应参考图。 | 选定的角色参考图、场景参考图,以及需要固定的外观说明。 | 人物是否符合预期?服装、环境、风格是否已经确定? |
| 第三步:列分镜表 | 把故事拆成几个镜头,写清几秒到几秒拍什么、人物做什么、镜头怎样移动。 | 一张带镜头编号、时间、画面、动作和声音的分镜表。 | 时长能否对上?前后动作是否连贯? |
| 第四步:生成分镜图 | 参考选好的角色和场景,为每个镜头生成对应的画面,确定人物位置、姿势和拍摄距离。 | 一组按镜头编号排列的分镜图;这套流程里,每张图用作对应片段的首帧。 | 是否还是同一个人?场景、光线、人物朝向能否接上? |
| 第五步:图生视频 | 输入每个镜头的首帧图,描述接下来发生的动作和运镜,分别生成视频。 | 若干段可供剪辑的视频素材。 | 动作是否完成?人物、手部和物体有没有明显变形? |
| 第六步:剪辑配声 | 按分镜顺序拼接片段,调整时长,配上旁白、环境声、音效或音乐,检查后导出。 | 一条有完整开头和结尾、画面与声音配合好的视频,例如一条 30 秒 MP4。 | 故事是否看得懂?衔接是否自然?声音和总时长是否合适? |
这是一套方便新手理解和修改的做法。每一步先选定满意的结果,再往下走;后面发现问题,也可以回到对应步骤修改。
其中有几个名字容易混淆,我们放在一起看:
| 名称 | 可以怎样理解 |
|---|---|
| 角色参考图 | 角色的“定妆照”,告诉模型这个人长什么样、穿什么衣服。 |
| 场景参考图 | 故事发生的环境,帮助统一地点、光线和色调。 |
| 分镜表 | 文字版拍摄安排,告诉我们什么时候拍什么。 |
| 分镜图 | 把某个镜头画出来,展示人物位置、姿势和构图,也可以只是草图。 |
| 首帧 | 视频开始的第一张画面。分镜图做得足够完整、适合作为动作起点时,就可以拿来当首帧。 |
比如,一张浅灰背景的女孩全身照,可以用来固定角色外观;但要拍“女孩站在江边”,还需要生成她出现在江边的那张镜头画面。
用一个小故事,把流程串起来
《即梦 Seedance 2.5 使用手册》的长视频部分,有“古装女子江边告别”的 29 秒一镜到底示例。我们借用这个题材,改编成一个 30 秒、4 个镜头的教学示例《江边告别》。
先写一句完整故事:
清晨,一位穿素白古装的年轻女子站在江边,望着远处渐渐离开的小船。她轻轻抬手告别,随后放下手,安静地留在岸边。
接着固定角色和场景:女子始终是同一张脸、黑色长发、素白交领衣裙;场景始终是有薄雾的清晨江岸。先准备好人物与江岸参考图,再列出分镜表:
| 镜头 | 成片时间 | 起始画面/分镜图 | 这段视频里发生什么 |
|---|---|---|---|
| 01 | 0–6 秒,6 秒 | 远景,女子站在画面左侧,面向右侧江面,小船在右侧远处。 | 小船缓缓远离,女子安静望着它,镜头固定,交代人物和环境。 |
| 02 | 6–14 秒,8 秒 | 女子的侧面中景,双手自然垂下,朝向与上一镜相同。 | 她慢慢抬起右手,在肩部附近轻轻挥动一次,镜头固定。 |
| 03 | 14–22 秒,8 秒 | 女子脸部近景,视线朝画面右侧,延续望向小船的方向。 | 她的目光停留在远处,嘴角浮现轻微笑意,发丝被风吹动。 |
| 04 | 22–30 秒,8 秒 | 回到侧面中远景,女子右手仍抬在肩部附近,小船已经更远。 | 她缓缓放下右手,继续望向江面,镜头慢慢后退,留出安静的结尾。 |
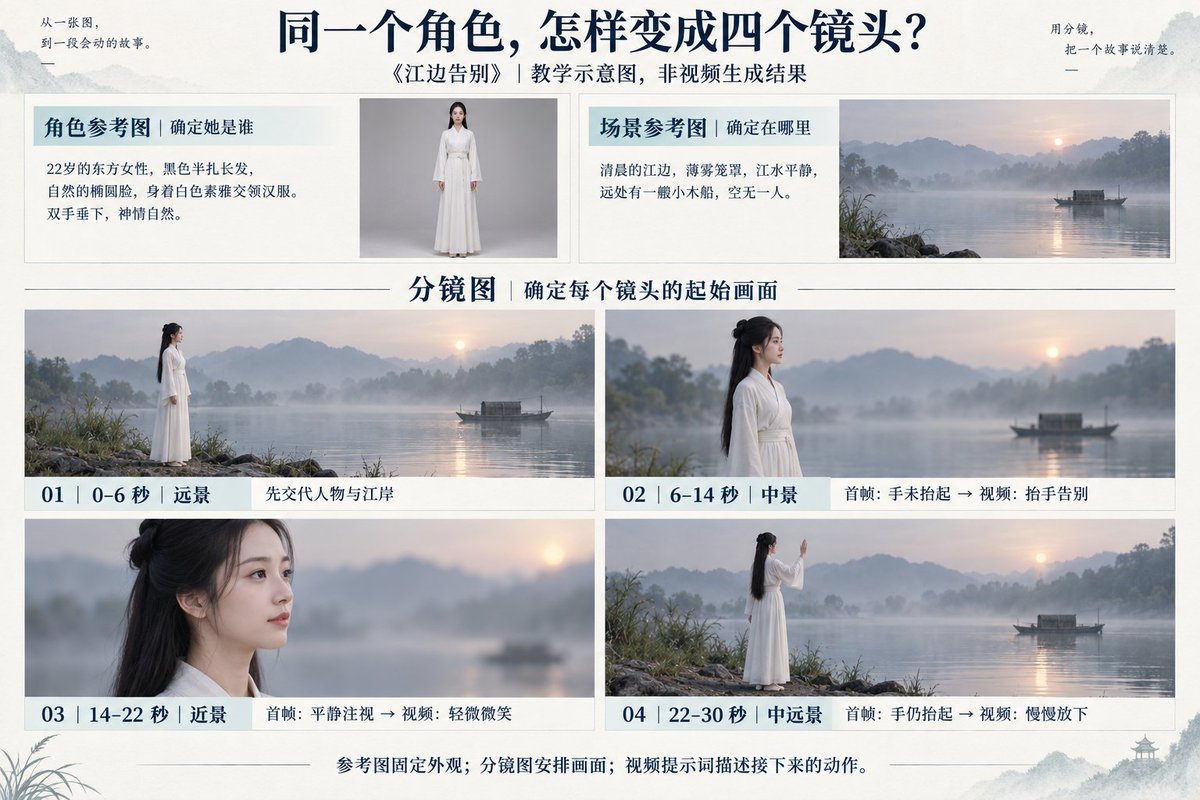
有了这张表,就知道接下来要准备 4 张分镜图、4 段视频素材。例如镜头 02 的图片先画“手还没有抬起”的状态,再让视频表现抬手的过程。不要在一张图里同时画出抬手前和抬手后。
最后把片段按顺序剪在一起,加上连续的江水声和轻微风声,就能形成一条完整短片。音乐和旁白按表达需要添加,不是每条视频都必须有。生成素材的时长可以留一点剪辑余量,最终以剪辑后的 30 秒为准。
这个例子展示的是逐镜头制作。
第二部分:人物、分镜和视频提示词怎么写
知道流程以后,提示词就有了具体用途:生角色图时,要交代外观;写分镜时,要安排画面和动作;生成视频时,还要告诉模型这些动作按什么顺序发生。
可以整理成四个部分:
素材用途(有参考素材时)+一句话概述+具体情节+全局要求。
| 部分 | 要回答的问题 | 例子 |
|---|---|---|
| 素材用途 | 上传的每个素材分别用来参考什么? | 图片1参考人物外观,图片2参考江岸环境。没有素材时可以省略。 |
| 一句话概述 | 谁在什么地方做什么,是什么风格? | 一位古装女子在清晨江边向远去的小船告别,写实电影风格。 |
| 具体情节 | 先发生什么,后发生什么,镜头怎么拍? | 0–6 秒拍江岸远景;6–14 秒切中景,女子抬手挥别。 |
| 全局要求 | 整段视频哪些东西要保持一致?需要什么声音? | 人物长相和衣服不变,保留江水声,无对白、字幕和背景音乐。 |
下面分别看三个常用写法。
1. 人物提示词:把“好看”写成具体特征
只写“一个漂亮女孩”,模型可以有很多种理解。想让人物接近你的想法,就要把最重要的外观说清楚。
真人人物得写法会从年龄、皮肤、面部特征、眼神、发型、服装、体型和气质几个方面描述。新手可以先按下面这张表整理:
| 维度 | 写什么 | 《江边告别》的教学设定 |
|---|---|---|
| 年龄与整体形象 | 大致年龄、人物类型 | 约 22 岁的年轻东亚女性 |
| 皮肤与面部特征 | 肤色、皮肤质感、容易辨认的五官 | 自然肤色,保留细微皮肤纹理,鹅蛋脸,细长眼睛,柔和下颌线 |
| 眼神与表情 | 看向哪里、什么表情 | 目光平静,神情略带不舍 |
| 发型 | 长短、颜色、梳理方式 | 黑色长发,半束发,额前少量碎发 |
| 服装与材质 | 颜色、款式、材质 | 素白交领长裙,柔软布料,没有繁复刺绣 |
| 体态与气质 | 身形、姿态、整体感觉 | 身形纤细,站姿自然,气质温婉 |
把它整理成角色参考图提示词,就是:
写实人物摄影,一位约 22 岁的年轻东亚女性,自然肤色,保留细微皮肤纹理。鹅蛋脸,细长眼睛,下颌线柔和,神情平静。黑色长发半束起,额前有少量碎发。身穿素白交领长裙,布料柔软,没有繁复刺绣。身形纤细,自然站立,双手垂在身体两侧。全身完整入镜,浅灰色简洁背景,光线柔和,脸部和服装清晰,无文字。
描述不必越长越好。先固定几项最重要的特征,选好参考图以后,后面的镜头持续引用它。不要每个镜头重新设计一次发型和服装。
2. 分镜提示词:把故事变成拍摄安排
分镜要说清楚“拍哪里”和“发生什么”。可以用一个简单结构来写:
时间段+景别与构图+主体动作/表情+镜头运动+声音。
这里的景别,就是拍摄范围:远景能看见更多环境,中景能看清人物动作,近景更适合表现脸部表情。运镜就是摄像机怎样移动,例如固定不动、缓慢推进、向后拉远。
同样是“她依依不舍地告别”,改成下面这样,画面就具体了:
6–14 秒,侧面中景。女子在画面左侧,望向右侧远去的小船。她缓慢抬起右手,在肩部附近轻轻挥动一次,表情克制。镜头固定,微风吹动发丝和袖口,背景保留轻微江水声。
如果想让 AI 先帮你列分镜表,可以这样提问:
请将下面的《江边告别》故事拆成 4 个镜头,总时长 30 秒。表格包含镜头编号、开始与结束时间、景别、起始画面、人物动作、运镜和声音。保持人物、服装、场景与视线方向一致,每个镜头安排一个主要动作。起始画面必须能用单张静态图片表现,检查各段时间连续,合计 30 秒。故事:清晨,古装女子站在江边,望着远去的小船,抬手告别,最后放下手,留在岸边。
列好分镜以后,生图和生视频的提示词还要分开。生图描述这一刻的画面,生视频描述接下来怎样变化。以镜头 02 为例:
| 用途 | 提示词示例 |
|---|---|
| 生成分镜图 | 人物外观参考图片1,江岸环境参考图片2。16:9 横屏,写实电影风格,清晨薄雾,女子站在画面左侧,侧身面向右侧江面,双手自然垂下。中景,完整保留头部、上半身和双手,右侧留出视线空间。单张画面,无文字。 |
| 让分镜图动起来 | 以上传图片为首帧,女子缓慢抬起右手,在肩部附近轻轻挥动一次,随后保持片刻。目光始终望向画面右侧。镜头固定,发丝和袖口随微风轻动,保持人物外观与场景一致,不切镜。 |
引用图片时,编号要和实际上传的素材对应,并按工具提供的方式选中素材。单独生成某一段视频时,时间从该段的 0 秒算起;分镜表里的 6–14 秒,是它在最终成片中的位置。
3. 30 秒长视频提示词:先统一设定,再按时间展开
30 秒里如果要发生几件事,就需要安排节奏。先交代参考素材和全局设定,再用时间段展开剧情。我们可以整理成下面这个模板:
| 层次 | 写什么 |
|---|---|
| 全局设定 | 总时长、画幅、题材风格、人物外观、场景、时间和光线。 |
| 参考素材(可选) | 哪张图对应人物,哪张图对应场景,视频或音频分别参考什么。 |
| 时间轴分镜 | 从 0 秒到结束,逐段写出画面、动作、表情、运镜,以及需要的对白或声音。 |
| 全局补充 | 始终保持什么,哪些元素不需要,结尾怎样结束。 |
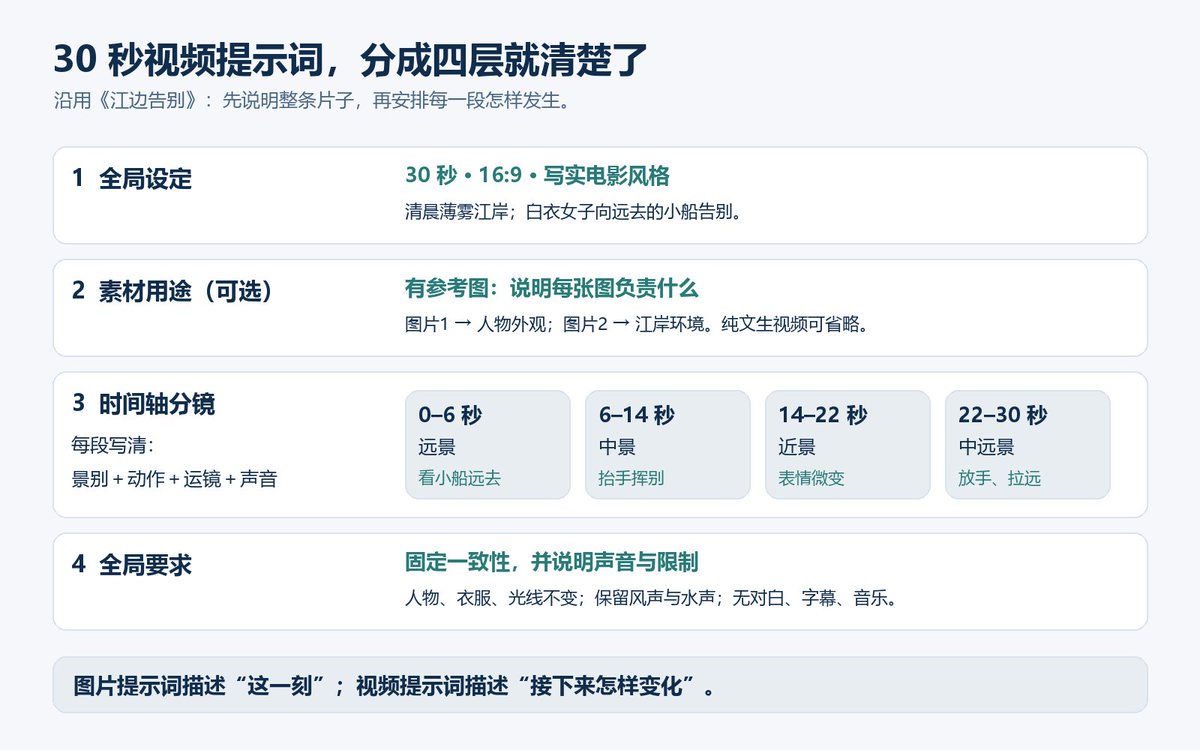
下面是一段纯文生视频的教学示例,不依赖上传图片。使用时需要在支持相应时长的生成入口里同步设置时长与画幅,不能只靠提示词里的“30 秒”改变生成参数。
【整体设定】
生成一条 30 秒、16:9 横屏的写实电影风格短片《江边告别》,采用四个镜头,节奏舒缓。清晨江岸有淡淡薄雾,柔和侧光照亮人物,江面平静,一只小船缓缓远去。
主角是一位约 22 岁的年轻东亚女性,自然肤色,保留细微皮肤纹理,鹅蛋脸,细长眼睛,下颌线柔和。黑色长发半束起,额前有少量碎发,穿素白交领长裙,布料柔软,没有繁复刺绣。身形纤细,神情平静,略带不舍。
0–6 秒:交代环境
江岸远景,女子站在画面左侧,侧身望向右侧江面,小船在右侧远处缓慢离开。镜头固定,薄雾轻轻流动,衣角被微风吹动。能听见轻微江水声和风声。
6–14 秒:抬手告别
切到女子侧面中景,保持人物在左、望向右侧的方向。她缓慢抬起右手,在肩部附近轻轻挥动一次,随后保持片刻。镜头固定,袖口自然垂落,动作轻柔。
14–22 秒:看清她的表情
切到女子脸部近景,视线仍朝画面右侧。她望着远处,嘴角慢慢浮现轻微笑意,少量碎发随风移动。表情克制,不说话,镜头稳定。
22–30 秒:留下安静的结尾
切回女子侧面中远景,右手仍在肩部附近。她缓缓放下右手,继续望着江面,小船已经更远。镜头缓慢向后拉远,最后两秒让人物安静站立,保留江水声。
【全局要求】
四个镜头保持同一人物、发型、服装、江岸环境和光线方向。人物始终望向同一侧的小船,镜头切换时保持动作衔接。全片无对白、旁白、字幕和背景音乐,只保留自然环境声。不增加其他人物
这段提示词同时交代了人物、场景和每一段的动作,读者即使没有看到参考图,也能大致想象出画面。
如果你已经有角色和场景参考图,可以在开头补充:“图片1用于人物外观,图片2用于江岸环境”,再按工具的素材引用方式关联它们,就变成了带参考素材的视频生成。人物和构图有了图像参照,文字仍负责说明动作和镜头如何发展。
还有两个地方需要留意:**写四个切换的镜头,就不要同时要求全片一镜到底;要求没有背景音乐,就不要又在结尾要求钢琴配乐。先让自己的指令前后一致。时间戳帮助表达节奏,生成后仍需要回看实际动作和时长,必要时修改或剪辑。
到这里,我们已经知道一条视频要准备哪些东西,也有了人物、分镜和长视频提示词的基本写法。接下来进入第三章,把这些方法用到具体的视频制作里。
第三章 进阶制作方法与前沿探索
1. 让自己的数字人跳一支热门舞蹈
刚开始学 AI 视频,可以先找一个自己觉得好玩的舞蹈来试试。比如刷抖音时看到一段热门舞蹈,准备好可使用的视频,再生成一个数字人,或者用自己的个人形象,让这个角色跟着跳一遍。把别人的动作参考迁移到自己的角色身上,就是一次舞蹈动作迁移。
支持视频动作参考的 Seedance 等模型,可以尝试直接使用原视频。但实际操作时,素材也可能因人物、版权或平台审核规则而无法使用。这时,先确认素材的使用权限与平台要求;对于允许使用、但人物和背景细节干扰较多的素材,可以增加“深度动作捕捉”这一步,提取动作与空间参考后再生成。
深度视频看起来是灰白色的:用明暗表示远近,保留人物轮廓、运动过程和空间关系,弱化原画面的颜色与外观细节。它不是简单给原视频加一层黑白滤镜,也不等于完整的三维骨骼动捕。转换为深度视频不会自动解决素材版权或平台限制。
四步完成一次舞蹈动作迁移
| 步骤 | 具体做什么 | 这一步得到什么 |
|---|---|---|
| 1. 下载原视频 | 找一段自己喜欢、可使用的舞蹈视频。新手优先选单人、全身入镜、镜头稳定、手脚遮挡少的短片段,并保留原来的节奏。 | 一段清晰的舞蹈动作参考视频。 |
| 2. 进行深度动作捕捉 | 使用平台的深度动作捕捉功能,或让能运行本地工具的 Codex 调用视频深度估计模型,把原片处理成灰白深度视频。 | 一段与原片动作、时间节奏对应的深度视频。 |
| 3. 导入视频生成模型 | 上传深度视频和个人数字人形象图,使用支持视频参考的模式。明确告诉模型:图片负责人物外观,视频负责舞蹈动作。 | 一段由自己的角色表演的舞蹈视频。 |
| 4. 添加音乐 | 在剪辑工具中配上可使用的音乐,按原舞蹈的节拍对齐。检查动作、音乐和结尾后导出。 | 一条有角色、有舞蹈、有音乐的完整成片。 |
第 1 步:准备舞蹈原视频
下面这段是本案例的动作来源。先看动作顺序、节拍,以及手脚是否始终清楚,再决定截取哪一段。
第 2 步:把原视频变成灰白深度视频
方法 A:使用 LibTV 的现成功能。 把视频放进画布并选中视频节点,展开上方工具栏「逐帧拉片」的下拉菜单,再选择「深度动作捕捉」。注意选择菜单中的“深度动作捕捉”,不要误选“逐帧拉片”。不消耗积分
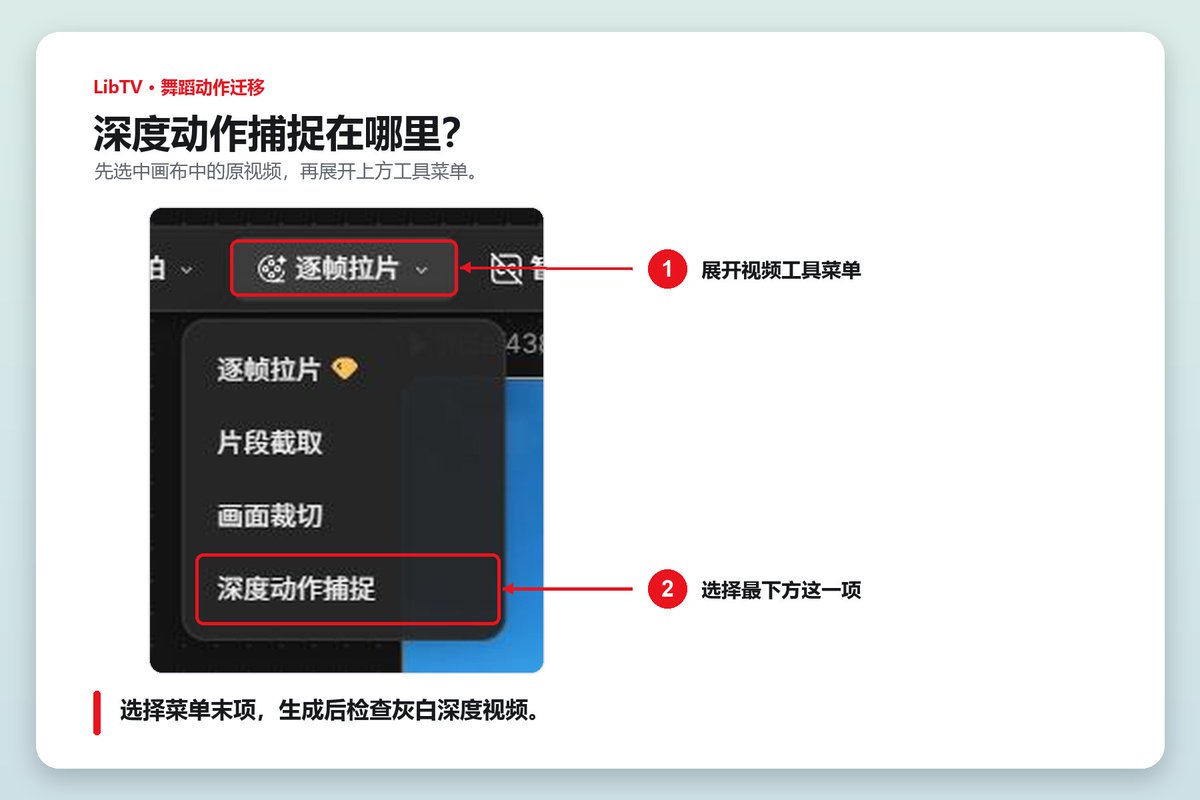
方法 B:让 Codex 帮你处理。 没有平台入口时,把视频文件放到 Codex 能访问的项目目录,给出文件路径,让它配置并运行视频深度估计工具。例如开源的 Video Depth Anything 支持视频输入和灰度深度输出。这里是 Codex 帮你操作工具,需要相应模型、依赖和可用算力,并不是聊天模型收到视频就能直接输出动捕结果。
可以直接这样说:
请把这个舞蹈视频处理成灰白深度参考视频。先检查本机是否能运行 Video Depth Anything 等视频深度估计工具;具备条件后,保留原视频的画幅比例、时长、帧率和动作节奏,输出无配乐的 MP4。我要的是表示远近的深度图,不是普通黑白滤镜。请检查人物轮廓和连续帧的稳定性;如果缺少模型、依赖或算力,请明确告诉我缺什么。
处理完后,可以把原片和深度视频对照播放:动作顺序和节拍应当对应,手脚轮廓不能大面积消失。下面是本案例的深度视频:
第 3 步:让数字人复刻舞蹈
准备一张清晰的角色图,可以是新生成的数字人,也可以是自己的个人形象。全身图有助于交代服装和身体比例,需要时再补一张脸部特写。
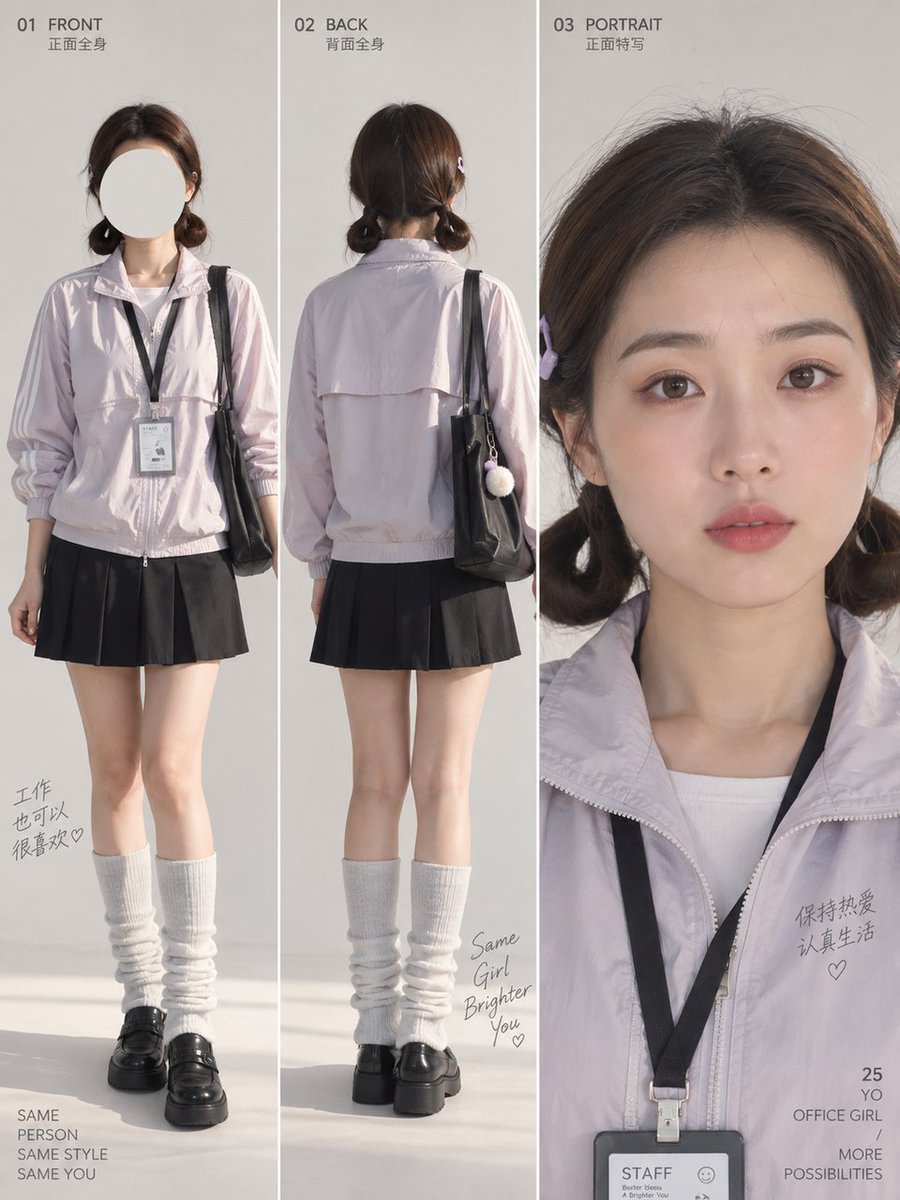
把角色图与深度视频一起上传到支持视频参考的生成入口,分别关联为 image_1 和 video_1(具体名称以平台为准)。提示词要写清楚两份素材的分工:
image_1 只用于人物身份、面部、发型和服装参考;video_1 是灰白深度动作参考,只用于舞蹈动作、动作时机、节奏和空间关系。让 image_1 中的人物按 video_1 的顺序完成舞蹈,保持全身入镜、手脚清楚、人物外观稳定。输出正常彩色画面,不保留深度图的灰白外观。无对白、无音乐。
如果第一次动作跟得不够准,可以先缩短片段,再检查素材绑定是否正确。深度图能够提供参考,但不保证模型逐帧精确复刻,复杂的遮挡、转身和道具动作尤其需要检查。
本案例的完整提示词如下。人物、服装和扔出道具的描述是这个案例的具体设定,换成自己的舞蹈时也要一起改。
Standalone_dance_video

参考 image_1 <<<image_1>>> 中的人物身份与外观。

【人物名字】 的脸部请严格参考 image_1 右侧的人像特写区域,保持同一个人物身份和面部特征:约 25 岁的年轻东亚女性,自然柔和的淡妆,脸颊带轻微红润感,嘴唇饱满自然,暖棕色眼睛,深棕色头发,扎成两侧低马尾,并佩戴一个小型紫色发夹。

人物的身材比例、服装和整体造型参考 image_1 左侧正面全身图和中间背面全身图:

穿浅薰衣草紫色拉链防风外套,袖子带白色条纹细节;内搭白色 T 恤;黑色百褶短裙;白色宽松及膝袜;黑色厚底乐福鞋。

【人物名字】 最初背着一个黑色托特包,包带上挂有一个小毛球挂件;脖子上佩戴黑色挂绳的 STAFF 工作证。

以 video_1 <<<video_1>>> 作为灰白深度动作参考视频,只参考动作、节奏与空间关系,不继承灰白外观。最终画面为正常彩色。

【人物名字】完整复刻 video_1 中的整套舞蹈编排,尽可能高保真地还原所有动作,包括:

完整的全身舞蹈动作、精确的手臂动作、手势、脚步、腿部动作、身体重心变化、舞蹈节奏、动作时机和动作衔接。

动作节奏和时间点严格跟随 video_1,不随意删减、替换、简化或重新设计动作。

整体表演状态保持 video_1 中那种充满活力、自由、洒脱、自信且具有情绪感染力的舞蹈表现。

【人物名字】的面部表情自然放松,随着舞蹈保持开心、兴奋、充满生命力的状态,表情与身体动作的能量一致,不做夸张或僵硬的表情。

在原舞蹈中“扔工作牌”的那个准确节拍点,【人物名字】同时抓住自己的 STAFF 工作证和黑色托特包,用一个果断、畅快、有释放感的动作,将两样物品同时甩出去。

工作证和托特包必须真实地从人物身上脱离,并一起飞出画面之外。

完成扔出动作后,【人物名字】 不停顿,也不回头捡东西,立刻无缝继续完成 video_1 中剩余的舞蹈动作。

此后 【人物名字】 身上不再出现托特包和工作证,以更加自由、轻盈、放松的状态继续跳舞,并保持完整的舞蹈节奏和高能量表现直到结束。

场景环境、拍摄机位、构图、镜头距离、光线条件以及背景氛围,均参考并匹配 video_1 中已经建立的环境。

镜头始终确保 【人物名字】的完整身体和关键舞蹈动作清晰可见,尤其需要完整表现手臂、双手、双腿、脚部和脚步动作,避免因为裁切导致舞蹈动作缺失。

以全身舞蹈表演镜头为主,完整呈现整套舞蹈。

保持 【人物名字】的人物身份、脸部、发型、服装、身体比例在整段视频中稳定一致,不换脸、不换人、不改变服装,不出现额外人物。

除指定的工作证和托特包飞出动作外,不新增、不删除、不凭空生成任何服装、饰品或道具。

无对白。
无音乐。
第 4 步:配音乐,检查成片
将生成的视频导入剪辑工具,配上适合这支舞蹈且可使用的音乐,让开头和关键动作落在对应节拍上。先把动作对齐,再处理字幕、音量与结尾。下面是本案例的成片:
举一反三:从一个好玩的片段开始
不一定非要跳舞。比如看到《甄嬛传》中一个有趣的出场、转身或行礼场景,也可以沿用“动作参考+自己的形象”的思路,尝试让自己的角色演绎类似动作。先从单人、短动作开始;多人对戏、对白口型和复杂运镜需要另外处理。使用影视片段时同样要确认素材与平台的使用要求。
先做出一个自己愿意分享的小作品,再慢慢增加场景、镜头和剧情,会更容易建立对 AI 视频的感觉。
2. Seedance 2.5 文生视频:借鉴成熟结构,改写自己的美食短片
刚开始做文生视频,不知道怎么写提示词很正常。除了参考即梦相关指南、MiniMax H3 提示词编写资料,我也很建议大家看看优秀博主是怎样组织提示词的。
先找一个喜欢的案例,理解它的结构,再让 AI 帮你改写成自己的题材。 对新手来说,这样可以少一些从零摸索,也更容易把画面、动作和声音交代完整。当然,结构成熟不代表每个细节都会自动生成正确,成片仍然需要自己检查。
下面就用我做的“老上海葱油饼”来走一遍这个过程:参考日式猪排丼的提示词,改成上海弄堂里的葱油饼,生成后再根据画面调整。
第一步:看懂范例,找到可以借鉴的结构
我参考的是 @Goodmanprotocol 的猪排丼案例。先看视频,再对照下面的提示词,会更容易理解文字是怎样对应到画面的。
这个案例值得借鉴的地方,是它把一段 30 秒视频交代得很完整:
| 提示词部分 | 解决什么问题 | 改写时怎么用 |
|---|---|---|
| 整体设定与 STYLE | 做什么食物,采用什么画风、光线和镜头感觉 | 保留写法,换成符合新题材的场景与风格 |
| TIMELINE 时间线 | 每几秒发生什么,动作怎样衔接 | 保留按时间分镜的方式,按新食物的制作过程重排动作 |
| 质感与动作细节 | 食材在切、煎、炸、掰开时发生什么变化 | 写清变化怎样出现,例如饼皮受热起泡、边缘逐渐变金黄 |
| AUDIO 声音 | 配什么音乐,突出哪些制作声 | 配合新场景调整音乐和揉面、煎饼等声音 |
| NEGATIVE 约束 | 哪些画面或效果不要出现 | 根据题材补充需要避免的问题 |
尤其可以留意它怎样写“质感”:油花在食物下锅时出现,酥脆感在切开时表现,蒸汽在盛装时升起。把质感放进具体动作里,画面要求才更明确。
原版英文提示词改写成中文,方便表达:
**中文对照,方便理解它的结构和表达:**

```text
Seedance 2.5 中文提示词
Seedance 2.5 Prompt:

创作一支 30 秒、节奏明快、具有电影感的日式动漫料理视频,内容是制作一碗正宗的猪排丼(Katsudon),并且完全根据以下文字描述生成。

重要要求:
不要展示、重现、描摹、参考或模仿任何分镜图、草图、参考图、画格、标注或源素材。
 只生成原创的日系动漫风格动画。

风格(STYLE)
高质量日本动画电影风格,
 具有电影感的夏日光线,
 食物材质超细节表现,
 真实的烹饪物理效果,
 可见的蒸汽与水汽,
 浅景深,
 微距特写镜头,
 顺滑的镜头运动,
 温暖的日式厨房氛围。
整体剪辑节奏快速而富有韵律,
 通过**动作、形状、质感和构图之间的自然匹配剪辑(match cuts)**进行转场。
时间轴(TIMELINE)

0–2.5 秒 —— 处理猪肉
 特写镜头:双手在砧板上用木槌敲打一块厚切猪里脊。
 肉片在敲打过程中逐渐变薄,肉纤维慢慢松散。
 随后均匀撒上盐和黑胡椒。
 敲击动作清脆有节奏。

2.5–5 秒 —— 给猪排裹粉
 快速匹配剪辑:
 先将猪肉压入面粉中,
 再浸入打散的蛋液中,
 然后均匀而牢固地裹上粗粒面包糠(panko)。
 展示真实的蛋液滴落效果,以及面包糠附着在表面的细节。

5–7.5 秒 —— 油炸
 将裹好面包糠的猪排放入金黄色热油中。
 猪排周围立刻冒出强烈气泡,
 炸衣逐渐变成金黄酥脆。
 使用温暖的电影感光线,细致表现油的流动与翻滚。

7.5–9.5 秒 —— 切块
 将炸好的猪排放在木质案板上。
 锋利的刀将其切成均匀的条状。
 酥脆外壳自然裂开,露出多汁的白色猪肉,
 同时有轻微热气缓缓逸出。

9.5–12 秒 —— 炖煮高汤与洋葱
 薄切洋葱在浅锅中的琥珀色日式高汤(dashi)里轻轻炖煮。
 小气泡缓缓升起,洋葱逐渐变得透明。
 筷子轻轻拨动洋葱,使其在汤汁中柔和移动。

12–14 秒 —— 加入猪排
 用筷子将切好的炸猪排轻轻放在正在炖煮的洋葱上方。
 汤汁开始浸润猪排酥脆的边缘,
 蒸汽缓缓升起。

14–16.5 秒 —— 倒入蛋液
 将打散的金黄色蛋液缓缓倒在猪排和洋葱上。
 蛋液自然流入食材间的缝隙,
 并在热边缘处开始慢慢凝固。

16.5–19 秒 —— 蛋液定型
 特写镜头:蛋液在小火中轻柔凝结。
 边缘变得柔软金黄,
 中央依然保持光泽、略微流心,并轻轻颤动。

不要搅拌。

19–21 秒 —— 准备米饭
 一个白色陶瓷丼碗中盛入满满一碗冒着热气的日式短粒米饭。
 米饭看起来蓬松、饱满,并带有轻微光泽。

21–24 秒 —— 组合装碗
 将锅中的蛋液猪排轻轻滑入盛好米饭的碗中。
 蛋液自然覆盖,形成柔和的波浪状,
 少量高汤轻轻渗入米饭。

24–26 秒 —— 成品特写
 完成的猪排丼放置在料理台上。
 带有光泽的蛋液缓缓覆在猪排与米饭表面,
 并带着轻微颤动。
 镜头缓慢向前推进,形成电影感特写。

26–30 秒 —— 最终展示(Hero Reveal)
 将完成的猪排丼呈现在一个传统的蓝白配色陶瓷碗中,放在木质台面上。
 金黄色蛋液覆盖在酥脆猪排和晶亮米饭之上,
 顶部点缀新鲜的三叶芹(mitsuba)。
 蒸汽持续升起,
 镜头缓慢环绕碗边移动,
 以优美的动漫美食电影感结尾。


音频(AUDIO)
明亮的 1980 年代风格日式 city-pop 器乐,
 速度为 110–120 BPM,
 加入细微的**筝(koto)**和轻巧的铃音打击乐。
同步加入真实的 ASMR 烹饪音效:
 木槌敲打声、
 刀切声、
 油炸滋啦声、
 高汤咕嘟声、
 筷子碰触声、
 倒蛋液声、
 蒸汽声、
 以及轻柔的陶瓷碰撞声。
在最终展示时,
 以一声轻巧的风铃音收尾。

负面约束(NEGATIVE)
不要出现任何:
 分镜图、参考图、草图、画格、边框、数字、箭头、标注、字幕、说明文字、UI、Logo 或文字叠加。
不要出现无关食材或其他菜品。
只制作猪排丼(Katsudon)。
确保整支视频中的:
 食物、手部、厨具、光线、环境
 都保持视觉一致性。
第二步:交给 AI 改写,从日式猪排丼变成老上海葱油饼
看懂结构后,就可以把原提示词交给 Codex 或其他大模型,请它保留组织方式,重新设计内容。我这次选择的是上海老弄堂里的葱油饼。
这里需要一起调整食材、制作步骤、街景、器具、画风和声音。猪排丼的裹粉、油炸、浇蛋液,要换成葱油饼的揉面、抹猪油、撒葱花、卷叠和煎制;原来的日式街景和音乐,也要跟着换成上海弄堂的氛围。
大家可以这样向 AI 提需求:
请参考下面这份日式猪排丼提示词,保留“整体设定、STYLE、30 秒分镜时间线、AUDIO、NEGATIVE”的组织方式,改写成“上海老弄堂葱油饼”。请按葱油饼的制作过程重新安排动作,写清抹猪油、撒葱花、卷叠、煎制和掰开酥皮时的变化,并让街景、器具、画风和声音相互协调。先帮我检查制作步骤和时间安排,再输出完整提示词。
改写也不一定一次就到位。在这次对话里,AI 最初还保留着日式动画的表达,我又追问了一次画风,才进一步调整为“老上海市井手绘动画电影风格”。这也是大家可以学着做的一步:读完改写结果,看看它是否真正符合自己的题材。
完整交流过程可以看这里:从日式料理到老上海葱油饼的提示词改写对话。
第一版:老上海市井手绘动画风格的提示词。
Seedance 2.5 中文提示词|老上海葱油饼

创作一支 30 秒、节奏明快、具有电影感的老上海市井手绘动画美食短片,内容是在石库门弄堂口的传统小吃铺制作一张上海葱油饼,并且完全根据以下文字描述生成。

主角是一张厚实、小巧、圆形的上海葱油饼:
表面金黄,带有深浅自然的焦斑,
外壳酥脆,内部柔软,
掰开后能够看到面皮层次与细碎葱花。

制作过程包括:
揉压醒好的面团、切葱、擀皮抹油、撒葱、
卷起盘圆、压饼、先煎后烘、出炉掰开。

通过自然的时间跳切压缩实际烹饪时间,
保持操作顺序合理、食物变化连贯。

重要要求:
不要展示、重现、描摹、参考或模仿任何分镜图、草图、参考图、画格、标注或源素材。
只生成原创的老上海市井手绘动画。
场景、器具、服装与生活细节保持统一的老上海传统小吃铺气质。

风格(STYLE)

精致的老上海市井手绘动画电影风格,
细腻的手绘线条,
柔和的水彩背景,
具有体积感的自然光影,
食物材质超细节表现,
真实的面团形变与烹饪物理效果,
可见的轻微热气,
浅景深,
微距特写镜头,
顺滑而克制的镜头运动。

场景是一间位于石库门弄堂口的传统葱油饼小铺。
深色木质操作台、旧铁煎锅、嵌在灶台中的小烘炉。
背景隐约可见灰砖墙、石库门门框与木质窗户。
器具整洁,带有长期使用形成的自然痕迹。

清晨暖光从铺面左侧斜照进来,
照亮案板上的少量面粉、面皮上的薄油光和缓缓升起的热气。
背景以灰砖色、米白色与木褐色为主,
突出葱油饼的金黄酥壳和葱花的鲜绿色。
暗部保留细节,食物色彩自然鲜明。
不要使用厚重的泛黄滤镜或褪色色调。

只出现同一位摊主的双手与前臂,
穿着素色棉布衣袖,袖口挽起。
不展示人物面部。

整体剪辑节奏快速而富有韵律。
通过动作方向、圆形轮廓、质感与构图之间的自然匹配剪辑(match cuts)进行转场。
每个镜头只有一个清晰的主要动作。
卷面、盘圆、翻面与掰开时,保持动作连续、空间关系明确。

时间轴(TIMELINE)

0–2 秒 —— 弄堂清晨
近景镜头从小铺木窗边缓缓向内移动。
清晨阳光斜落在木质案板上,
背景中的石库门门框与灰砖墙柔和虚化。
摊主将一块已经醒好的面团放在案板中央。
面团落下时轻轻变形,表面柔软细腻。

2–4 秒 —— 揉压面团
斜俯拍特写:
掌根向前推压面团,再将其折回。
面团随着手掌自然伸展、折叠,
表面形成柔和的弧面与浅浅压痕。
案板上的少量面粉被推开,留下清晰的揉压轨迹。
动作沉稳、熟练,具有节奏感。

4–6 秒 —— 切葱
微距侧拍:
洗净并沥干的青葱整齐放在案板上。
刀刃有节奏地落下,切出细小均匀的葱花。
葱白与翠绿葱叶交错散开,
切口湿润,少量葱花随着刀刃轻轻跳动。
镜头沿切葱的方向短距离移动。

6–9 秒 —— 擀皮、抹油、撒葱
三个衔接紧凑的动作特写:
擀面杖向前滚动,将一份面剂擀成长形薄面片。
小勺背将少量半凝固的猪油轻轻抹开,
在面片上形成均匀、薄薄的油膜。
随后撒上少量盐与切好的葱花。
绿色葱花自然落在润泽的面皮上,分布均匀。

9–12 秒 —— 卷起与盘圆
保持同一个斜俯拍镜头。
双手从面片的一条长边开始,
将面片卷成细长面卷。
再把面卷从一端盘成紧凑的螺旋形,
将末端轻轻收压在底部。
面团随着手指自然弯曲,
葱花逐渐被包入层层面皮之间。
完整展示卷起与盘圆的动作,不让面团突然变形。

12–14 秒 —— 压成圆饼
切换到贴近案板的低角度特写。
手掌缓缓压下盘好的面团,
将其压成厚实、小巧的圆饼。
饼身向四周自然展开,
表面保留淡淡的盘卷纹理,
局部透出被面皮包住的绿色葱花。
边缘圆润,厚薄基本均匀。

14–17 秒 —— 入锅煎制
以圆饼轮廓进行匹配剪辑,
切换到旧铁煎锅的斜俯拍。
摊主将圆饼轻轻放入带有薄层热油的锅中。
接触锅面的瞬间,
饼边立刻出现细密气泡,响起清晰的滋啦声。
热油沿着圆饼边缘轻轻流动。
通过自然的时间跳切,
展示饼边逐渐定型,并染上浅金黄色。

17–19 秒 —— 翻面
低机位微距特写:
金属锅铲从饼底完整托起,将葱油饼翻面一次。
翻转过程中,
清楚露出已经煎成金黄色的底面,
表面带有不规则焦斑和细小鼓泡。
圆饼平稳落回锅中,油泡沿边缘重新聚起。
饼身保持完整,大小与厚度保持一致。

19–22 秒 —— 入炉烘香
侧面近景:
通过时间跳切,葱油饼已经煎至两面金黄。
摊主用长柄铲将其送入小烘炉,
平稳放在炉内烤架上。
炉内暖光映亮饼面。

再次通过时间跳切,展示烘烤后的状态:
外壳变得干爽酥脆,
焦斑略微加深,
边缘的薄面层轻轻翘起。
炉口上方出现轻微的热空气扰动。

22–24 秒 —— 出炉
镜头跟随长柄铲向外移动。
烘好的葱油饼被轻轻放到木台上的金属沥油网上。
接触网面时,发出轻微而干脆的声响。
侧面的晨光掠过起伏的饼面,
细致表现酥壳、焦斑和少量露出的熟葱花。
表面只有薄薄油光,不滴油。

24–27 秒 —— 掰开特写
极近距离拍摄。
经过短暂放置,
双手隔着一张无文字的牛皮纸,
缓缓将葱油饼掰成两半。

外层酥壳先出现细小裂纹,
随后自然断开,
少量金黄色碎屑落在纸上。
内部柔软的面层短暂牵连,再逐渐分离。
断面露出错落的面皮层次与细碎熟葱花,
细薄热气从温热的中心缓缓逸出。
清楚表现外壳酥脆、内部柔软的质感差异。

27–30 秒 —— 最终展示(Hero Reveal)
两半葱油饼放在铺有无文字牛皮纸的竹编小盘中,
其中一半略微倾斜,
让金黄外壳与内部层次同时朝向镜头。

镜头从断面微距缓慢后拉,
逐渐带出木质窗台与虚化的石库门弄堂。
晨光照亮饼面细小的酥脆纹理,
薄薄热气缓缓升起。
远处传来一声轻巧的自行车铃。
以温暖、细腻、富有烟火气的老上海市井动画电影感结尾。

音频(AUDIO)

轻快、温暖、带有复古上海气息的爵士器乐,
速度为 105–115 BPM。
以柔和钢琴、拨弦低音提琴与轻巧的刷奏鼓为主,
加入少量温润的单簧管旋律。
无歌词,无人声旁白。
音乐音量克制,不盖过烹饪声音。

同步加入真实、细腻的 ASMR 烹饪音效:
面团落在案板上的轻响、
掌根揉压面团的声音、
有节奏的切葱声、
擀面杖滚动声、
葱油饼入锅后的滋啦声、
金属锅铲轻触铁锅的声音、
出炉时放上金属网的轻响、
牛皮纸摩擦声、
以及掰开酥壳时清晰、轻脆的碎裂声。

掰开葱油饼时,适当降低背景音乐,
突出酥壳断裂与纸张摩擦的声音。
环境中保留极轻的弄堂晨间氛围声。
最终展示时,以远处一声自行车铃自然收尾。

负面约束(NEGATIVE)

不要出现任何:
分镜图、参考图、草图、画格、边框、
数字、箭头、标注、字幕、说明文字、
UI、Logo、水印或文字叠加。

不要出现无关食材或其他菜品。
只制作上海葱油饼。
不要加入鸡蛋、芝士、火腿、辣酱或其他额外配料。
不要把葱油饼做成薄脆煎饼、手抓饼、披萨或大馅饼。
不要出现芝士式拉丝、夸张爆汁或不合理膨胀。
不要出现浓烟、火焰包围食物或大量热油飞溅。

不要出现日式店铺装饰、霓虹灯或现代塑料包装。
不要使用厚重泛黄滤镜、旧胶片划痕或明显褪色效果。
不要让环境装饰遮挡制作过程。

避免多余手指、手部穿透食物、厨具变形,
避免食材突然增多、消失或无原因改变形状。
成品在掰开前始终保持为同一张完整圆饼,
掰开后只出现对应的两半。

确保整支视频中的:
葱油饼的大小与厚度、
摊主的双手与衣袖、
厨具、操作台、光线方向与小铺环境
都保持视觉一致性。
第三步:检查成片,把不对的细节重新写清楚
下面是生成的老上海葱油饼视频:
这次我一开始就漏检查了一个细节:整个生成过程都能正常完成,但视频里用油的表现,并不是我想要的猪油效果。
回头看,第一版提示词在抹油的步骤里其实已经提到“半凝固猪油”,但煎制部分只写了热油,成片也没有清楚表现出我想要的食材质感。写进提示词,只是提出要求;有没有做到,还要回到视频里检查。
所以后来我又调整了一版,把要求落到看得见的东西和动作上:陶瓷碗里是乳白色、半凝固的猪油;用小勺舀出后抹在面皮上;锅里煎饼用的是融化的猪油。这样,检查成片时就有了更明确的依据。
另外,下面这版还把画风从手绘动画调整成了写实美食影像。这是一次同时涉及食材细节和画风的修改。大家自己练习时,可以先集中修改最影响结果的一处,再生成、对照,更容易判断修改是否有效。
修改后的提示词:强化猪油的形态与使用动作,并改为写实风格。 这里展示的是修改思路与完整提示词,上面的视频对应前一版。
Seedance 2.5 中文提示词|老上海葱油饼

创作一支 30 秒、节奏明快、质感细腻的写实美食短片,内容是在老上海石库门弄堂口的传统小吃铺,制作一张外酥内软、带有猪油与葱香的上海葱油饼。

整体采用真人实拍般的影像质感,
结合电影级美食摄影与街头生活纪录片的自然感。
不要动漫、插画、卡通或三维渲染风格。

主角是一张手掌大小、略有厚度的圆形葱油饼。
使用面团、猪油、盐与新鲜青葱,
经过擀皮、抹猪油、撒葱、卷起、盘圆、压饼、先煎后烘,
最后掰开展示金黄酥壳与柔软的内部层次。

通过明确、自然的时间跳切压缩实际制作时间。
每个镜头只突出一个主要动作,保持制作顺序合理。

风格(STYLE)

写实电影摄影风格,
真实的皮肤、面团、猪油、葱花与金属材质,
细腻的食物微距特写,
自然的烹饪物理效果,
克制的浅景深,
平稳的镜头移动,
温暖但不泛黄的清晨光线。

场景是一间保留老上海生活气息的弄堂口小吃铺。
灰砖墙、石库门门框、深色木窗,
木质案板、旧铁煎锅、嵌在灶台中的小烘炉,
以及盛放猪油的素色陶碗。
器具整洁,带有长期使用留下的磨痕与自然包浆。

老上海的感觉来自真实的建筑、器具、衣着与街巷声音,
不依靠夸张的复古装饰或厚重怀旧滤镜。

清晨阳光从画面左侧斜照进铺面,
照亮面团上的细粉、猪油的润泽表面与锅边升起的轻微热气。
背景以灰砖色、木褐色和米白色为主,
食物保留自然的金黄色与葱绿色。
高光柔和,暗部有细节,不使用橙黄色覆盖整个画面。

只出现同一位摊主的双手与前臂。
双手有自然的皮肤纹理,动作熟练,
穿素色棉布衣袖,袖口挽起。
不展示人物面部。

整体剪辑明快而富有韵律,
通过动作方向、圆形轮廓与相近构图进行自然匹配剪辑(match cuts)。
卷面、盘圆、翻面和掰开等关键动作保持连贯,
避免过度慢动作与炫技转场。

时间轴(TIMELINE)

0–2 秒 —— 弄堂口的清晨
镜头从小铺木窗旁缓慢向内移动。
背景是柔和虚化的灰砖墙与石库门门框。
前景中,摊主把一份已经醒好的面团放在木质案板上。
面团落下时轻轻变形,
清晨侧光照出细腻的表面与薄薄面粉。

2–4 秒 —— 擀开面团
斜俯拍近景。
擀面杖来回滚动,
将面团逐渐擀成长形面片。
面皮随着压力向外舒展,
边缘略微不规则,保持手工制作的自然感。
案板上留下浅浅的面粉推痕。

4–7 秒 —— 舀猪油、抹猪油
微距特写:
一只素色陶碗里盛着乳白色、半凝固的猪油。
小勺舀起一小块猪油,
放在展开的面片中央。

切至贴近面皮的低角度。
勺背将猪油缓缓推开,
乳白色猪油被抹成均匀的薄层,
在面皮上留下细腻的涂抹纹路。
薄处透出面皮颜色,
侧光下呈现柔和油光,不形成液体积油。

7–9 秒 —— 撒盐与葱花
俯拍特写。
指尖先撒下少量盐,
随后将切好的新鲜葱花均匀撒在面片上。
翠绿葱叶与浅白葱段落在猪油薄层上,
轻轻附着,不随意滚落。
镜头清楚表现葱花湿润的切口和猪油细腻的光泽。

9–12 秒 —— 卷起、盘圆
保持同一个斜俯拍镜头。
双手从面片的一条长边开始,
将面片卷成细长面卷。
再从面卷一端向内盘绕,
形成紧凑的螺旋面团,
将末端轻轻收压在底部。

面皮随着手指弯曲,
猪油与葱花被包入面层之间。
动作连续,面团不突然改变形状。

12–14 秒 —— 压成圆饼
贴近案板的侧面特写。
手掌缓缓压下盘好的面团,
将其压成手掌大小、略有厚度的圆饼。
饼身自然向四周展开,
表面仍保留淡淡的盘卷纹理,
局部透出包在面皮下的葱绿色。
边缘自然,不追求机器般规整。

14–17 秒 —— 入锅煎制
利用圆饼轮廓进行匹配剪辑,
切换到旧铁煎锅的斜俯拍。
锅中有一层已经融化、微微发亮的热猪油。
摊主将圆饼平稳放入锅中。

接触锅面的瞬间,
饼边出现细密气泡,响起清晰的滋啦声。
油脂沿饼边轻轻流动。
通过一次自然的时间跳切,
展示饼边逐渐定型并染上浅金黄色。
仅有少量热气,不出现浓烟。

17–19 秒 —— 翻面
低角度微距特写。
金属锅铲从饼底完整托起,
将葱油饼翻面一次。
翻转时清楚露出金黄色底面,
上面分布着深浅不一的焦斑和细小鼓泡。

圆饼平稳落回锅中,
边缘再次响起滋啦声。
饼身完整,大小与厚度保持一致。

19–22 秒 —— 入炉烘香
通过时间跳切,葱油饼已经煎至两面金黄。
侧面近景:
摊主用长柄铲将葱油饼送入灶台中的小烘炉,
平放在炉内烤架上。

再次通过时间跳切,
近距离展示烘烤后的饼面:
表面逐渐干爽,
焦斑颜色略微加深,
边缘的薄面层轻轻翘起,
炉口上方有细微的热空气扰动。
不出现明火直接接触食物。

22–24 秒 —— 出炉
镜头跟随长柄铲向外移动。
葱油饼被轻轻放在木台上的金属沥油网上,
发出轻微而干脆的触碰声。

晨光掠过饼面,
清楚表现起伏的酥壳、自然焦斑与细小裂纹。
表面保留薄薄油光,
不滴油,不出现夸张反光。

24–27 秒 —— 掰开
以自然剪辑表示葱油饼已短暂放凉。
极近距离拍摄:
双手隔着无文字牛皮纸,
缓缓将葱油饼掰成两半。

酥壳先出现细小裂纹,随后自然断开。
少量金黄色碎屑落在纸上。
内部柔软面层短暂牵连,然后分离,
露出错落的层次与细碎熟葱花。

融化的猪油使内部面层呈现柔和的润泽感,
外壳干爽,内部柔软,不流油。
细薄热气从断面缓缓升起。
重点突出真实、清脆的断裂声音。

27–30 秒 —— 最终展示(Hero Reveal)
两半葱油饼放在铺着牛皮纸的竹编小盘里,
其中一半略微倾斜,
让酥脆外壳与内部层次同时朝向镜头。

镜头从断面特写缓慢后拉,
带出木质窗台、素色猪油陶碗,
以及远处虚化的石库门弄堂。
金黄饼面沐浴在柔和晨光中。
背景传来一声轻巧的自行车铃,
以自然、温暖、具有老上海烟火气的实拍电影画面结尾。

音频(AUDIO)

温暖、轻快、带有复古上海气息的爵士器乐,
速度为 105–115 BPM。
以柔和钢琴、拨弦低音提琴与轻巧的刷奏鼓为主,
点缀少量单簧管旋律。
无歌词,无旁白。
音乐保持低音量,让烹饪声音位于前景。

同步加入真实的 ASMR 制作音效:
面团轻落案板的声音、
擀面杖滚动声、
小勺轻碰陶碗声、
勺背涂抹猪油的细微声音、
葱油饼入锅后的滋啦声、
锅铲轻触铁锅声、
出炉后落在金属网上的轻响、
牛皮纸摩擦声、
以及掰开酥壳时清晰的碎裂声。

掰开葱油饼时适当降低音乐,
突出酥脆断裂声。
背景保留极轻的弄堂晨间环境声,
最终以远处一声自行车铃自然收尾。

负面约束(NEGATIVE)

不要出现:
动漫、卡通、插画、水彩、手绘线条、
三维渲染感、塑料食物质感、过度磨皮、
夸张景深、过度锐化、过饱和色彩、
厚重泛黄滤镜、旧胶片划痕或褪色效果。

不要出现:
分镜图、草图、画格、边框、数字、箭头、
标注、字幕、说明文字、UI、Logo、水印或文字叠加。

不要出现无关食材或其他菜品。
只制作上海葱油饼。
必须清楚展示猪油的原料形态与涂抹过程。
不要加入鸡蛋、芝士、火腿或辣酱。
不要把葱油饼做成薄脆煎饼、披萨或大馅饼。
不要出现芝士式拉丝、夸张爆汁、大量流油或不合理膨胀。

不要出现浓烟、夸张火焰或大量热油飞溅。
不要出现霓虹灯、日式店铺装饰或现代塑料包装。
不要用密集的复古道具遮挡制作过程。

避免多余手指、手部穿透食物、厨具变形。
避免面团和成品突然增多、消失或改变大小。
掰开前始终是同一张完整圆饼,
掰开后只出现对应的两半。

确保整支视频中的:
葱油饼大小与厚度、
摊主的双手与衣袖、
厨具、操作台、光线方向与小铺环境
都保持视觉一致性。
大家完全可以沿用这个方法,去改写其他食物或题材:找一个成熟案例 → 拆解结构 → 让 AI 按新题材改写 → 看成片 → 修正具体细节。 好结构能帮我们把需求写得更完整,减少遗漏;自己的判断和检查,则决定最后的视频有没有把想表达的东西做出来。
写在最后
希望这篇教程,能帮第一次接触 AI 视频的你,从 0 到 1 做出自己的第一个 AIGC 视频。
你可以先让自己的数字人跳一段喜欢的舞蹈,也可以试着写下脑海中的画面,或者参考优秀创作者的提示词结构,让 AI 帮你改写成自己的故事。选一个感兴趣的小玩法,动手生成一次,再看看哪里需要调整。第一条视频不必完美,每一次尝试和修改,都会让你更清楚怎样把想法变成画面。
这就是我写这篇“AI 视频小白第一课”的初衷:希望大家看完以后,能真正上手做出一个作品,带着自己的想法走进 AIGC。期待看到你的第一条 AI 视频!
我是 Serena 木瓜,祝你在 AI 时代,无限接近自由!下期见!
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


