
做过三次 OCR 横评的我告诉你:Unlimited OCR 2 的真正杀手锏不是"读得多",而是"每一步只看该看的"。
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
老朋友都知道我之前测评过几次OCR 对比的横向测评,感兴趣的可以看看之前的测评,我这里给没看过的朋友回顾一下。
1、别瞎花钱了!我实测了 18 个文档 6 类场景,教你选对 OCR 模型!(项目已开源+实测数据)
2、亲手实测:不用花钱,仅需 10 分钟就可以在笔记本搭好本地 OCR 工作流,三档模型任你选!(免费开源!)
3*、最新开源的Unlimited-OCR能一次性处理几百页文档,而且速度还很稳。*
这里想要说的是,其实针对OCR的这个场景来说,对于很多中小企业其实是非常实用的,且可以沉淀数字资产的一个重要路径和方法。
在整个的OCR赛道里面,我们发现目前综合表现最优的还是Paddle OCR 、以及今天刚刚看到新开源的文心UnlimitedOCR 2,直接可以将3623 页的《哈利·波特》七部曲 PDF 的扫描出来。
整本扔给这个 OCR 模型,不切分,不拼接,1 小时 30 分后,最后一页也解析完了。
真的,你换做之前真的难以想象,3600多页居然可以一口气解析完,并且精度也是到位的。
官方还拿1222 页的《三体》全集测了下,用了 50 分钟,我有点不相信哈哈,这么狠?
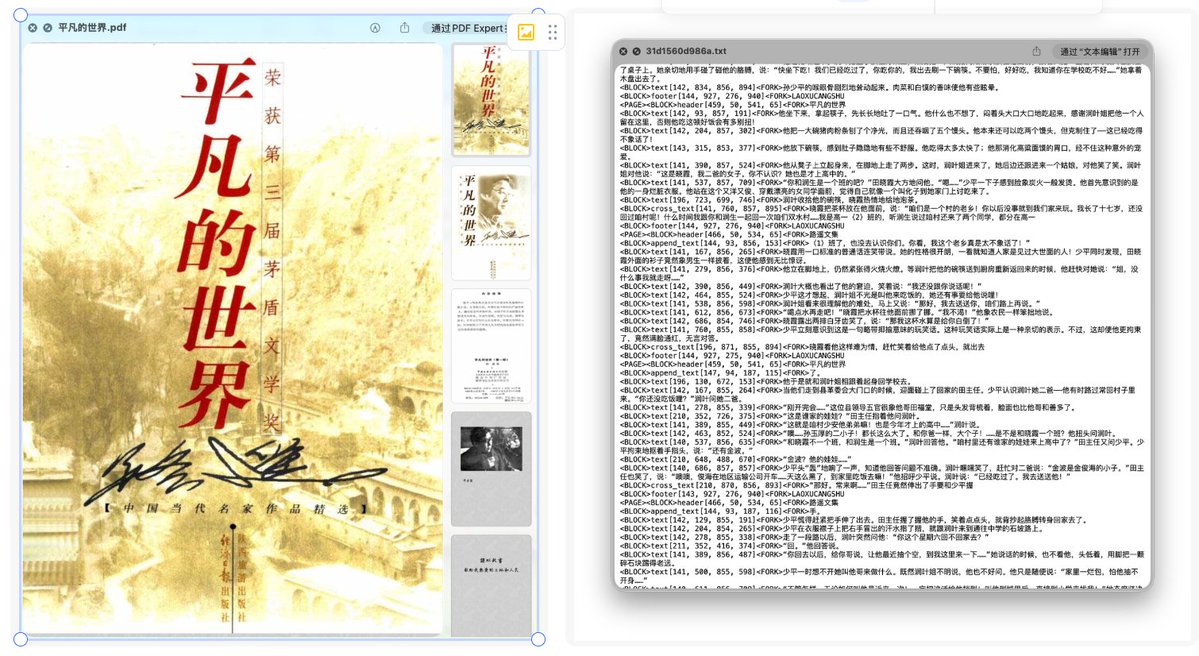
直到我自己也拿对应的《平凡的世界》这本书做了一个测试,全书1665页,并且是真正的图片版本的PDF。
总耗时40分钟,直接OCR的结果最后可以下载TXT文本,展示视频24x倍速,可以看看识别过程~~
这个模型叫文心 Unlimited OCR 2,百度文心团队以及在 10 月 27 日开源。
开源地址:https://github.com/baidu/Unlimited-OCR
我第一反应是,上下文窗口得开多大才装得下?翻完技术报告,答案正好反过来。
这个结论还挺有意思的,居然是它能读这么长,靠的是每一步看得更少,这样就是可以可持续的单次少了,但是总长度拉长了。
而过去各大厂家都在卷让模型「看得更多」!
这两年大模型的主旋律是上下文越来越长,几十万、上百万 token,好像窗口够大,什么都装得下。
长文档 OCR 一开始也是这个思路。上一代 Unlimited OCR 用 R-SWA 把连续解析做到了几十页,开源后 HuggingFace 下载破 1000 万,GitHub 拿下 2.86 万 Star,杨立昆也转发过。
Unlimited OCR 当时最多只能输入 40 页。原因很朴素:写出来的文字可以只留一个窗口,但每生成一个字,模型还要回头看前面所有页面的视觉 Token。页数翻倍,要看的东西也翻倍。
窗口大,不等于读得完。团队新做了一个评测集 MarathonDocBench,100 份文档,每份 103 到 300 页。参与对比的通用大模型,综合分最高只有 33.74。
团队的解决方案的灵感来自“抄书”?
你抄一本厚书,眼睛只盯着当前这页。碰到「见前文」,才回头翻一下。没人会把整本书一直摊在脑子里。
多页文档也是这样,页内关联很密,跨页依赖很稀。全局注意力让每一页都和每一页交互,大部分计算是白算的。
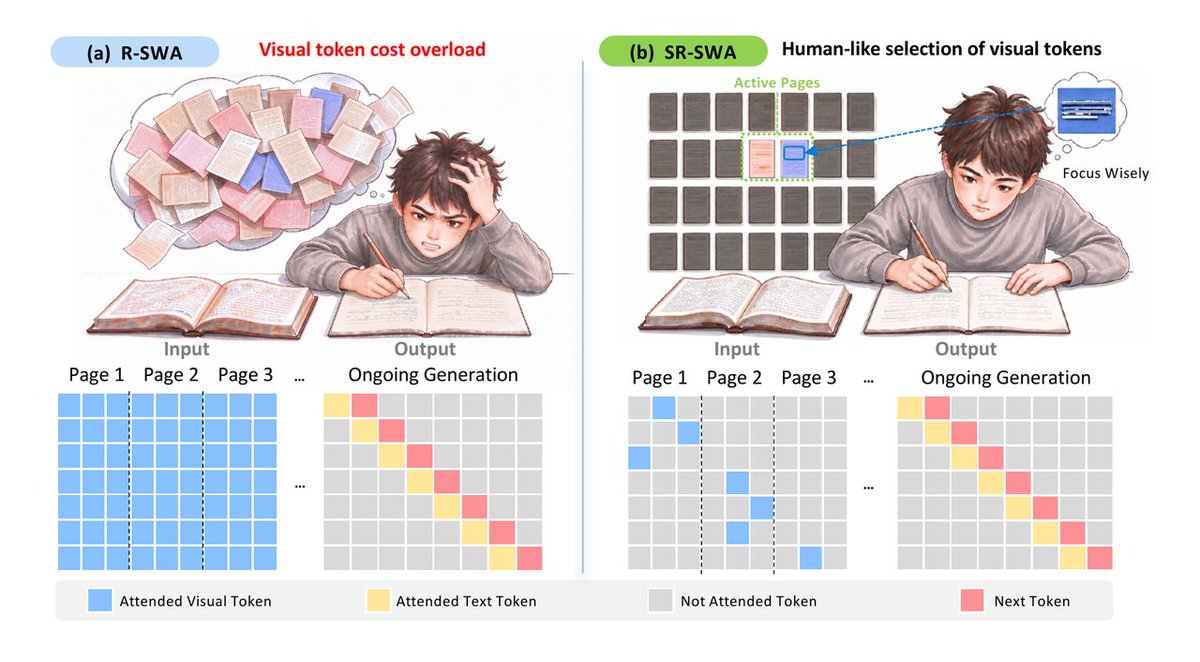
左:R-SWA 每一步都看所有页面的视觉 Token。右:SR-SWA 只挑相关区域看。
这一代的核心就从这里来:
SR-SWA(稀疏参考滑动窗口注意力):每生成一个 Token,只从整本文档里挑出一个固定大小的视觉信息集合来参考。就像去图书馆查资料,先走到对的书架,再抽最相关的几本,用不着把整座图书馆搬到桌上。文档再长,这个集合也不变,所以每一步的计算量不随页数增长。
挑的过程分两步。
Page Gate(页面门控)先划范围,把查找从整本书缩到相关页面,并给每个位置记上「第几页、页内第几个」。
Token Sieve(Token 筛选器)再挑重点,把候选信息切成固定大小的块,打分,只留得分最高的 top-k 块,再加上手边的一个局部窗口。
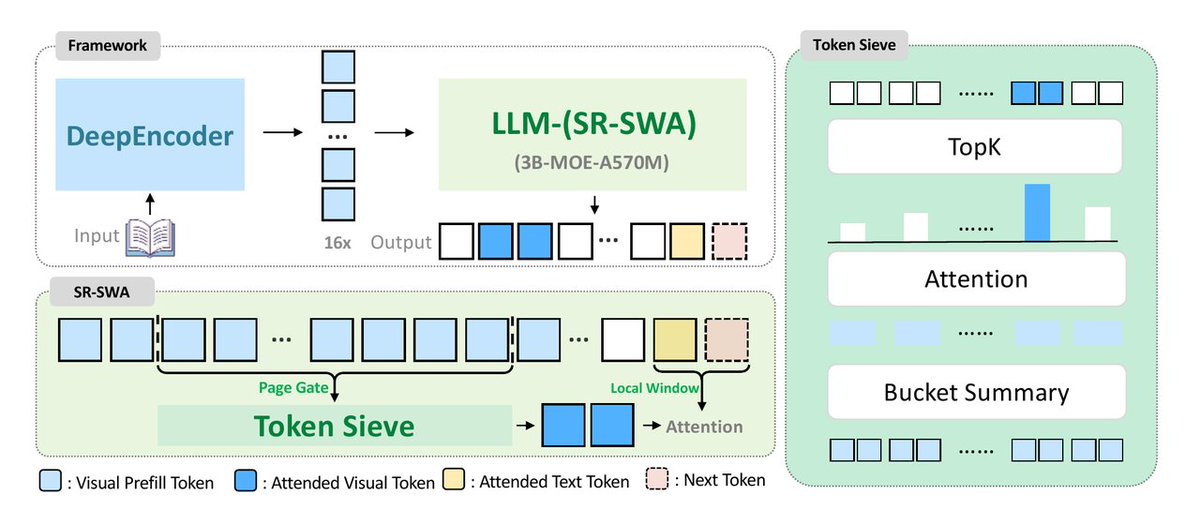
比如读到第七部哈利和伏地魔对决,模型可能挑出前文写到伤疤、写到魂器的那些区域,其余几千页,这一步都不用算。(例子只为帮助理解,模型实际处理的是页面图像区域和视觉 Token,并不检索情节。)
显存那头也一起管了。无限解码机制把文档切成按页重叠的分块,像接力赛交接棒,相邻两块共用一页的 KV Cache,跑完的那一棒直接释放。百页级文档上,峰值显存从 47 GB 降到 1.77 GB。
大模型「少看」后的结果反而更好!
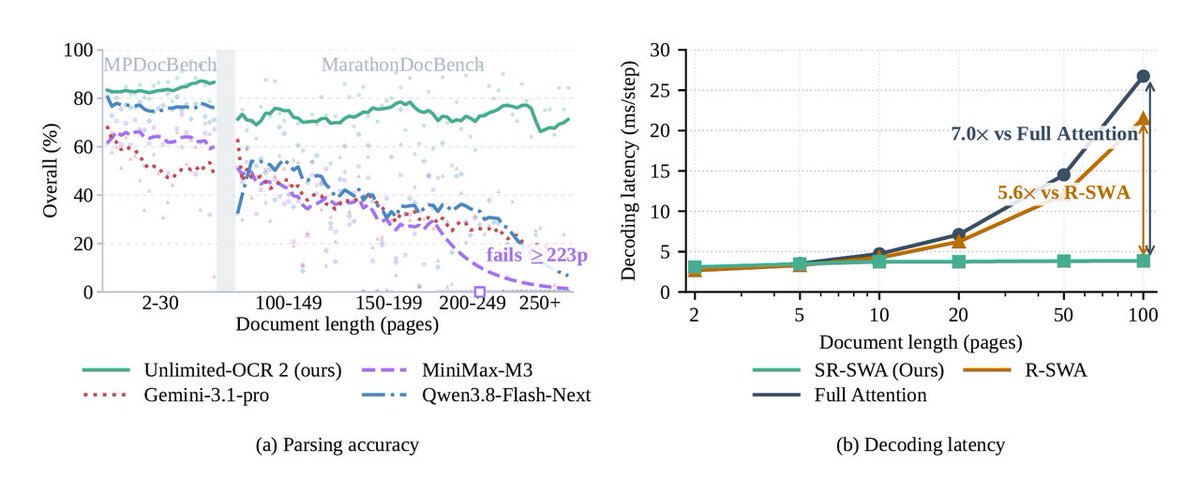
左图是准确率随页数的变化。通用模型越往后越掉,文心 Unlimited OCR 2 从几页到 300 页,基本是一条平线。 右图是单步解码延迟。到百页规模,它比全注意力快 7.0 倍,比 R-SWA 快 5.6 倍。
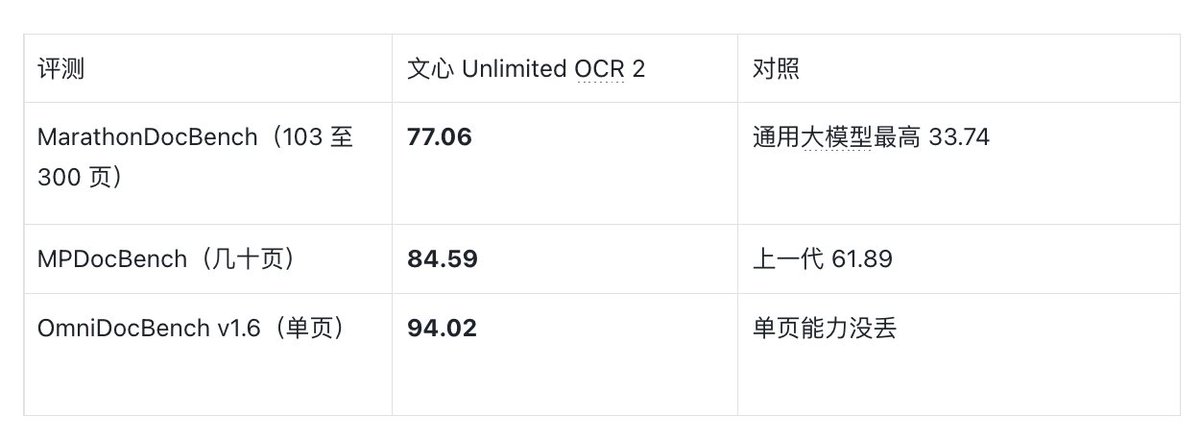
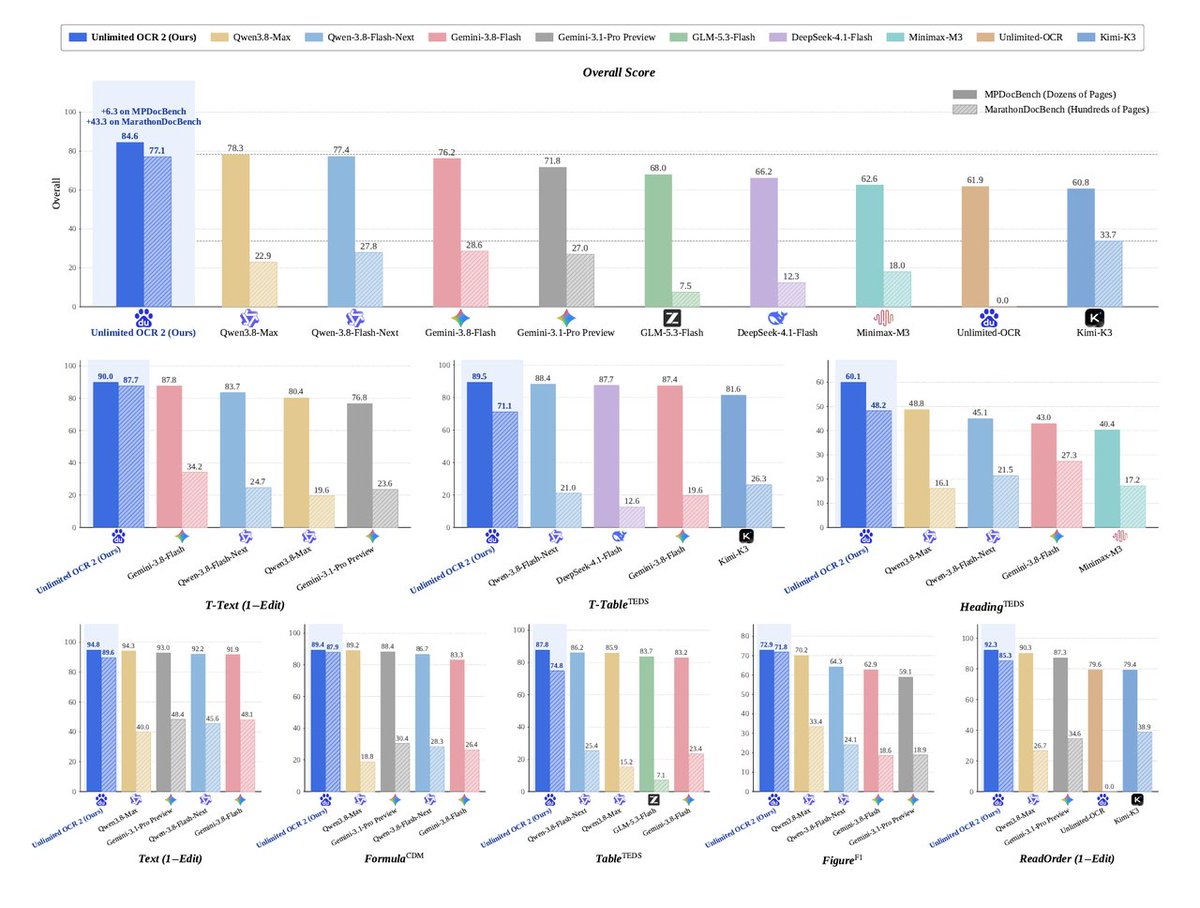
深蓝色是文心 Unlimited OCR 2,在所有评测类别中都保持最先进水平(SOTA)。
团队也写了短板:稀疏注意力不保留全局信息,标题层级这类整篇级的结构,仍是它得分最低的一项。
一个彩蛋
技术报告引言的第一段,是一段咏唱:「像素为身,而 Token 为血。我已阅尽千余页文档。不为 KV Cache 所限,不为上下文长度所缚。故而,我在此祈愿,Unlimited OCR Works。」
看过《Fate/stay night》的会心一笑,这是在致敬「无限剑制」。
上一代的名字就来自这里,网友在 HuggingFace 改写的 OCR 版咏唱,被团队收进了这一代的报告。
还挺有意思的😄
最后
Unlimited OCR 解决的是看懂一页,而文心Unlimited OCR 2 要解决的是读完一整本。
而读完一本的办法,和人抄书一样,盯住眼前这一页,只在需要时回头。
下次有人说长文档只能靠更大的上下文窗口,你可以想想这 3623 页是怎么读完的。
GitHub:https://github.com/baidu/Unlimited-OCR
HuggingFace:https://huggingface.co/baidu/Unlimited-OCR-2
关于文心 Unlimited OCR 2 的更多细节,百度将在11月12日举行的百度世界2026公开课上进一步分享。
#文心 #文心大模型 #文心无限OCR2 #无限OCR #UnlimitedOCR #百度世界2026


