
Jev便宜444倍:160年前的经济学正在重演
文章目录
—— 160 年前的一条经济学规律,正在解释今天的 AI
Hi,我是 Punk,一个管理学硕士,一个在制造业深耕5年的人。今天想换个角度,从经济学出发聊聊最近刷屏的 Jev。
这几天,大家都在拆它有什么功能、怎么接进工作流,以及它处理海量数据时到底能跑多快、跑多便宜。这些我先不展开,我更关心一个藏在 Jev 后面的经济学问题:当做一次判断的成本突然掉下去,世界会多出什么?
所以这篇文章,我想把三件事一次讲透:Jev 背后的杰文斯悖论;它为什么会把 AI 从“抽样”推向“全检”;哪些工作值得交给 Jev,哪些地方必须留在人手里。
先给你算笔账:444 倍。 9 月 15 日,旧金山一家叫 TypeSafe 的公司发布了 Jev;它宣称同样一件活,比当前最强的一批大模型便宜 444 倍。原来要花 100 块预算的活,现在大约两毛二。
把镜头拉回 1865 年的英国,那个看着毫不相干的故事,正好能解释这周发生了什么。
一、一个"越省用越多"的怪事
1865 年,英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)写了一本书,叫《煤炭问题》。
当时的英国正处在一个很得意的时刻。蒸汽机的效率一代比一代高,尤其是瓦特改良之后,一台机器烧同样多的煤,能干的活儿翻了好几倍。
从上到下都觉得这是好事:机器越省煤,全国烧的煤就越少,煤就够用了,工厂也能开得更久。
杰文斯的结论刚好相反。
他的推理是这样的:蒸汽机效率提高,意味着使用煤炭这件事变便宜了。一件事变便宜,人们就会拿它去干更多以前不划算的事——开更多工厂、跑更多火车、点更多灯、烧更多暖气。省下来的那份煤,不会躺在仓库里,它会立刻被新的需求吃掉。
最后是用煤量暴涨。人们省下来的煤,很快被新增的用法消耗掉了。
后来的历史站在了他这边。整个 19 世纪,英国蒸汽机的效率一直在涨,英国的煤炭消耗量也一直在涨。
这个现象后来有了个专有名词,叫“杰文斯悖论”,也叫“回弹效应”。用一句话概括:
效率提升换来的从来都是新需求。省下来的那一份,一天也留不住。
现在你大概猜到那个模型为什么叫 Jev 了。
这不是巧合。TypeSafe 官方 FAQ 说得很直白:Jev 取自杰文斯,因为他们相信机器智能会重走煤炭的老路——原话是:
"智能的成本每下降一个数量级,就会解锁多出几个数量级的使用场景。"
这句话是全文的钥匙。你不妨先记住它。
二、这个悖论,正在 AI 圈原样重演
镜头拉回现在。过去四年,同样一件 AI 活儿的价格已经掉到原来的一个零头;模型也变得更强、更快。照这个逻辑,自动化应该已经铺满各行各业。
现实没有那么热闹。你每天用的软件、上班的流程,大多还是老样子;被 AI 拆开重做的环节集中在少数地方,许多行业里的“AI 已经改变一切”还停留在 PPT 上。
卡点不在能力,卡在成本。这个问题用一个很笨的比喻就能讲清。
三、用一位主任医师,去量一次体温
设想你开了一家大型体检中心,每天几千个人来检查,而你只需要知道每个人的体温。正常做法当然是发体温计:几十块钱一个,几秒钟出结果。
可你手里只有一位主任医师。那就只能让他一个一个量。他量得很准,态度很好,还会顺口告诉你“37.2 度属于低烧,建议多喝水多休息”。但一次只能量一个人,时间、人力成本都很贵。
过去四年,很多 AI 自动化项目差不多就是这个处境:拿一个按次收费的主任医师,去做分类、路由、打标签这种廉价判断。模型当然做得好,可调用量一上来,账单也跟着往上窜。
更残酷的是,你原本冲着减少人力上的 AI,落地后却多出三笔钱:模型调用费、人工复核费、错误返工费。旧流程不敢撤,负责兜底的人也不能少,最后人力没省下来,账单先厚了一层。用了 AI,反而更贵。
比如一家每天进三千条消息的店,你想让模型判断“这条消息该派给哪个部门”。每条都让最贵的模型过一遍,月底财务一定会来找你;为了不把预算烧穿,你只能挑一部分给模型看,剩下的继续用关键词规则硬凑。
所谓全量自动化,就这么退回了抽样。 能力早就够用,价格却还没低到可以放肆使用。用一个极度昂贵的零件,去干一件极度廉价的小事,这就是过去四年很多 AI 项目卡住的地方。
四、Jev 更像一台化验仪器
Jev 就是冲着这笔账来的。它把主任医师身上那些昂贵的通用能力砍掉,只留下一个能被塞进系统、反复调用的判断零件。
把 Jev 当成化验科的仪器来用,别当成主任医师来请教。
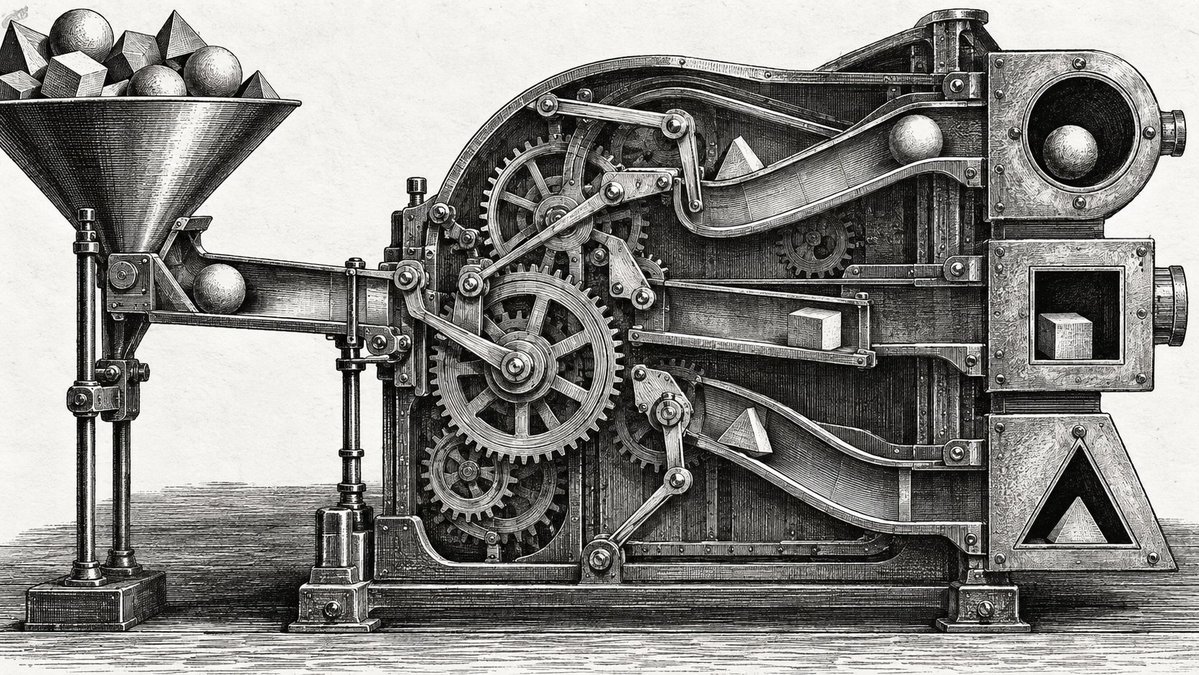
你不会跟化验仪器聊天。你把样本递进去,指定要测哪几项,它给你一组数值,然后结束。解释、安慰、补充建议和长篇输出,都不在它的工作范围内。
官方自己的说法更狠——他们说 Jev “更像代码”,为此干脆放弃了“生成文章”。你可以把它当成一次函数调用:前面塞进一段状态,后面吐出几个带概率的判断。
它的特点是这样的:
-
它只在你的选项里选。 所有可能的答案,在你调用它之前就已经锁死了,它给不出你没定义过的东西。
-
它出结果很快。 眨眼都嫌慢。
-
它每次都会附带一个"这次测得准不准"的把握度。 一个敢说"我不确定"的零件,才敢被放进没人盯着的系统里。
公司名字里的 TypeSafe,说的就是这个——类型安全。它像一根“格式保险丝”:插头和插座的形状提前对好了,你根本插不歪。
但这里要分清楚一件事,不然特别容易误解:"给不出格式外的答案"不等于"永远选对"。
它保证的是不会给你一个不存在的选项;可在你给的这几个选项里,它照样可能挑错。这是两个完全不同的保证,别混。
上面这些特性,技术上算不上惊天动地的新东西。让它几天内被讨论成这样的,还是开头那个数字:便宜 444 倍,快了将近 200 倍。
具体到定价:每百万输入 token 收 0.042 美元,输出免费。输出不要钱这件事本身就挺说明问题的。
这两个数字来自厂商公布的工作流评测,还没有第三方独立复现。TypeSafe 在自家博客里列出了证据限制:这是偏乐观的上限估计,参考基线选的是最聪明的对手模型,可能低估了自己;他们也坦白“无法证明这个价格不是靠补贴撑着的”。至少,这些限制需要和数字一起看。
但即便打个对折,这个量级也足够说明问题了。
便宜 444 倍是什么概念?
这跟多打几次车完全是两回事。如果打车从 444 块降到 1 块,你不会只是多打几次——你会重新安排你的生活。你会搬得离公司更远,你会每天多跑两趟,你会让跑腿替你去取东西。
价格每降两个数量级,先被改写的是行为和结构,用量只是后面的结果。
而这件事,在历史上已经发生过很多次了。
五、引爆世界的那一刻,通常写着"更便宜"三个字
我们习惯把技术进步想象成"更强的诞生":更快的芯片、更准的模型、更聪明的算法。
回头看历史,让世界拐弯的瞬间,常常落在“更便宜”的那一天。
最漂亮的例子是铝。
今天铝是廉价到不像话的东西,易拉罐、外卖盒、窗框。但在 19 世纪,铝比黄金还贵。原因很朴素:提炼太难了。当时的工艺成本高到离谱,法国皇帝拿破仑三世专门用铝制餐具招待最尊贵的客人,普通客人用金的。
1886 年,电解铝的工艺被发明出来。铝的价格崩了。
之后发生的事和“铝变得更坚硬”没有关系:飞机有了骨架,高压电线有了芯,易拉罐有了材料。
铝本身一点没变强。变的是价格。
钢铁、电、光纤、算力,走的是同一条曲线。价格每掉一个数量级,就会长出一整代前所未有的用法。
这句话,正好就是开头 TypeSafe 那条 FAQ 的另一个说法。而这家公司已经用行动先给自己做了一次证明——
团队里有人拿 Jev 做了个能打《毁灭战士》的 AI 机器人:游戏每一帧的状态喂给它,它当场判断下一步往哪走、开不开枪。一秒问它十次,一小时烧掉大约 7 美元。
做这个 demo 的工程师有点心虚,担心"这会不会太贵了"。其他同事的一致反应是:比想象中便宜多了。
看清这件事的性质。在 444 倍降价出现之前,“让 AI 每秒思考十次”这个念头几乎不会被提上日程。降价之后,凭空多出来一种玩法。
这就是杰文斯悖论长什么样。
先别只盯着“这个模型有多聪明”,把目光移到这个问题上:
当"做一次判断"变成一种几乎免费的东西,会长出什么以前不可能的东西?
六、最直接的变化:从抽查,变成全检
这是我最想让你记住的一节,这也是我过去5年在制药业的一些体会
一百年前的工厂不敢全检。因为检查本身有成本:请一百个质检员把每一件产品都翻一遍,成本可能比产品还贵。
于是大家发明了统计抽样——抽一百件里的五件,用五件的合格率去推断整批。抽样首先是为了省钱;准确只是它顺带的效果。这是成本逼出来的妥协。
后来视觉检测设备变便宜了,工厂才开始往全检走。推动这件事的,是检查一件东西的成本终于掉到了低于放过一个次品的代价。老板的良心并没有参与决策。
这是一个很容易理解的规律:
-
当检查的成本高于漏掉的代价,你就只能抽查;
-
当检查的成本低于漏掉的代价,你就会全检。
用这条规律看今天的世界,会发现几乎所有跟“判断”有关的业务都还停在“抽样”阶段。客服录音抽 5% 听一下,风控复审挑一部分人看,内容审核抽一部分扫,合同只审大额的,库存只盘几家门店。
没人不想全看,问题是看不过来。一旦看一眼、判一下的成本掉到接近零,抽样这个动作就失去大半意义。
这就是杰文斯悖论落地的样子。它先让“判断”总量爆炸,省下来的判断预算很快会被新的判断需求吃掉。
而且你会发现,那些新增的判断里,绝大多数是过去根本不在考虑范围内的。
以前没人会去判断"这条评论的语气是不是带着嘲讽",因为不划算。以前没人会去判断"这个客户的付款节奏是不是有变化",因为不值当。以前没人会去判断"这张图片里的货架有没有缺货",因为得派人去数。
TypeSafe 给这类用法起了个名字,叫"在海量数据上做 map-reduce"——把一个 PB 级别的数据湖整个翻一遍,转成能用的特征和结论。
过去没人去翻整个数据湖,理由很简单:不值得。 做不做得到,是另一回事。
当一件事从很贵变成几乎免费,人类从来不会省着用。我们会把它铺到以前想都不敢想的地方去。
一百六十年前,煤炭是这样。今天,判断也是这样。
七、但是,便宜有便宜的代价
讲到这里,气都快喘完了,我得泼一盆冷水。
如果文章只告诉你“便宜真好,快去用”,那没什么价值。
便宜的判断,有三个必须提前想清楚的代价。
代价一:它不给你理由
化验单给你一个数值,但它不会告诉你为什么是这个数值。
单看一次,这没什么。可当你把一个系统里的几千个判断串成一条链,任何一个环节出了问题,你都无从追溯。
官方的补丁是"把握度"——它至少会告诉你这次有多确定。但把握度回答的是我有多信自己,它答不了我为什么这么判。这两件事不能互相替代:一个说自己 90% 确定的人,你仍然不知道他在想什么。
可解释性和成本一直是一对冤家。判断越便宜,你往往越得放弃一部分“讲道理”。上线前先划清边界:哪些环节可以不要理由,哪些环节死活都得要。
代价二:判断力会被外包掉
这是个更隐蔽的问题。它伤到的是人,跟机器无关。
导航用得多了,认路的能力就退化。计算器用得多了,心算的能力就退化。这跟怀旧无关,是真的。
如果一个岗位上的所有判断,都被降价外包了出去,那这个岗位的人会慢慢失去"做判断"的能力——然后再失去"议价权"。
机器变便宜,对会用它的人是杠杆,对只会被它替代的人,是慢慢缩小的生存空间。这两者的区别,就在于你有没有在做机器做不了的那部分判断。
代价三:责任会掉进真空
这是我们常听到的议题。
当判断变得便宜,"做决定"的环节会变得又多又碎,散落在整个系统的各个角落。这带来一个法律和伦理上都还没答完的题:
出了事,谁负责?
一条被埋在第 5 层依赖里的小判断判错了,导致了一个客户被拒贷、一个人被误判、一笔钱打错账号。写提示词的人?调参数的人?采购这个模型的公司?还是模型本身?
技术跑得比制度快,这是常态。但吃这个亏的,往往是第一个吃螃蟹的人。
八、泼第二盆冷水:这个悖论也没那么神
我得诚实一点:杰文斯悖论在经济学里一直有争议。
它只是一种趋势,谈不上什么物理定律。而且这个趋势有一个前提条件——需求还没被满足。
我为啥这么说呢?
比如,马路上的路灯换成了 LED,单颗灯珠的耗电降了 80% 以上。但全球照明用电并没有同步降 80%,因为我们在以前根本不会装灯的地方装了灯——亮化工程、广告屏、深夜的球场。这就是所谓的“回弹反应”。
但另一些场景里,回弹并没有发生。比如某些已经完全饱和的品类,效率提升确实实打实地省下了资源。
所以我们需要优先考虑的是:我这件事,需求已经饱和了吗?
-
如果你的判断需求早就饱和了(比如你只想判断"这条消息该给谁",再也没有别的判断需求了),那降价就是纯省钱。
-
如果你的判断需求一直被成本压着没被释放(比如"我要是能全量看一遍所有评论多好"),那降价之后,用量一定爆炸。
先回答这个问题,再决定要不要兴奋。
九、所以你该想什么
你不需要先懂技术。先做一件事:把工作里的所有“判断”,挑出来看一遍。
别先问“我的工作会不会被 AI 取代”。挑出一个个具体、微小的判断,然后逐个问下面三个问题:
第一,这件事最后要的,是不是只有一个数值或一个分类?
如果只是"这条该归到哪一类""这个有多严重""是不是要处理",而你一直在用最贵的方式做它,那这里就有巨大的降价空间。
第二,如果它的成本降到百分之一,我会不会干脆全量过一遍?
如果答案是"会",那你已经找到那个"从抽样到全检"的机会了。这个机会往往比"省成本"大得多,因为它会给你以前从来没有的信息。
第三,如果这件事交给机器,出错的时候谁负责?
如果这个问题你答不上来,那先别急着自动化。留在人手里,可能更便宜。
这几个问题,不管你做什么行业都成立。
开店的,你的补货判断和临期处理,是不是只在盘点的几家店里看? 做运营的,评论和小红书笔记,是不是永远只能"挑几条看看"? 当老师的,作业里的主观题,是不是永远只能"来不及了挑几本翻"? 做财务的,发票是不是永远只能"大额的人工看"?
以前这些“只能”,都是成本逼出来的。现在,成本开始松动。
十、最后
杰文斯悖论把我们对效率提升后的“美丽泡沫”戳破,逼你放下一个很舒服的想象:效率提高以后,我们就能少干活。
历史给出的答案反复出现:我们不会少干活,只会找到新的活干。
所以,在“AI会不会代替我”这个问题来临之前。先思考另一个问题:
当判断变成一种像自来水一样便宜的东西,什么反而变贵了?
我的答案是三样:
-
提对问题: 机器再便宜,它也不会告诉你该问什么。它只会老老实实回答你递过去的那几个问题——问题问歪了,它答得再快也不过是更快地跑偏。
-
定对标准:一把错的尺子,量一万次还是错的,而且错得更快、更贵。
-
为结果负责: 这是唯一机器替不了的事。因为机器不承担后果,人承担。
判断变便宜,对普通人是好事。
它会把人的位置,从“做那些廉价的判断”,挪到“决定什么才值得被判断”。
至于那些一辈子只做廉价判断、从没想过往上游走一步的人——
一百六十年前,曼彻斯特那些手艺精湛的手工织工,大概也是这么想的。
关于作者
Punk|中科大管理学硕士|AI提示词、AI小白教程|Punk系列Skills作者|3个月赚了8位数|Learn in Public|FDE文章浏览量240w|@AdrianPunk115
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


