别再只会拿 Telegram 搜索机器人找片了,我是怎么把它变成私人资源搜索引擎的
文章目录
这是不是你使用Telegram 的机器人日常?
很多人第一次接触 Telegram 搜索机器人,目的都很朴素:找片,看片,找片....
用久以后我才发现,真正值钱的不是“搜到一个资源”,而是你开始拥有一套主动找信息的方法。
其实真正会玩的人,已经用它找 AI 工具、行业资料、赚钱信息,甚至建立自己的私人资源库。
很多百度搜不到、Google翻不到的东西,他们几分钟就能找到。
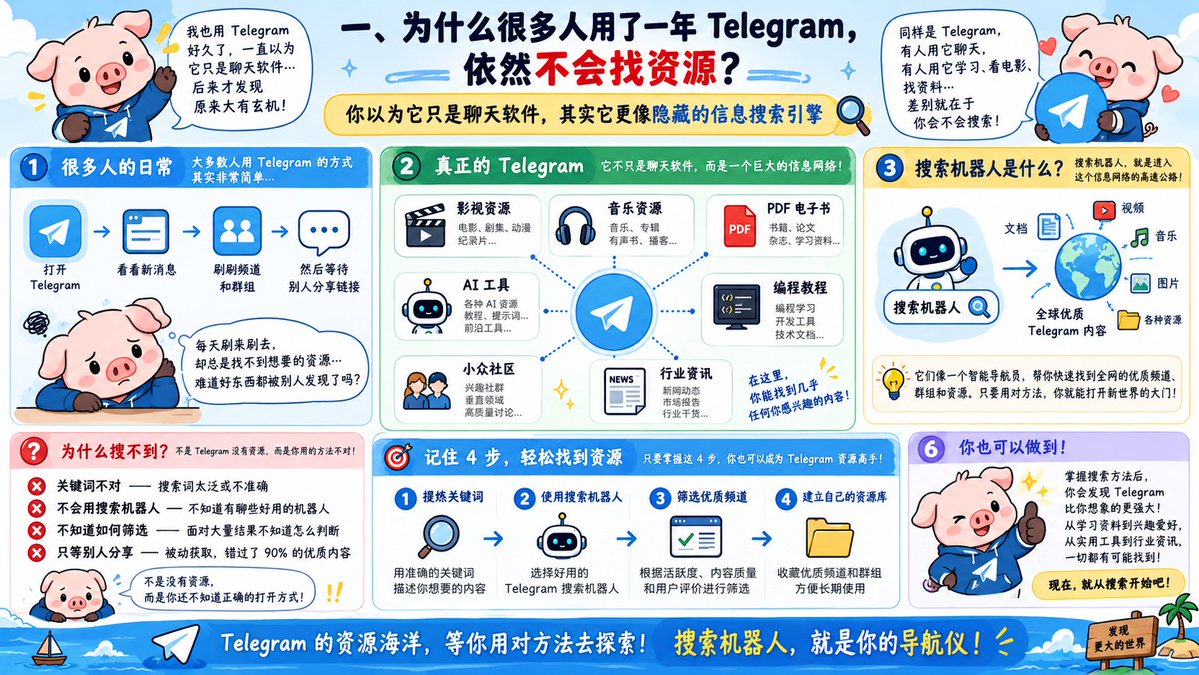
AI 工具、Prompt、编程教程、出海资料、PDF、行业频道、小众社区……很多东西不一定能被百度或 Google 直接检索到,但可能早就在 Telegram 的某个频道、群组或历史消息里躺了几年。
所以我现在更愿意把 Telegram 搜索机器人理解成一个入口:它不负责替你判断什么是好东西,但它能让你从“等别人喂链接”,变成“自己主动找线索”。
这篇不准备给你塞一长串机器人名单。我更想讲清楚一件事:怎么从一个关键词开始,把搜索、判断、保存和使用串成一条完整的信息工作流。
看完以后,你最大的收获可能不是找到几个资源,而是建立一种主动获取信息的能力。
01|为什么很多人用了 Telegram 一年,还是不会找资源?
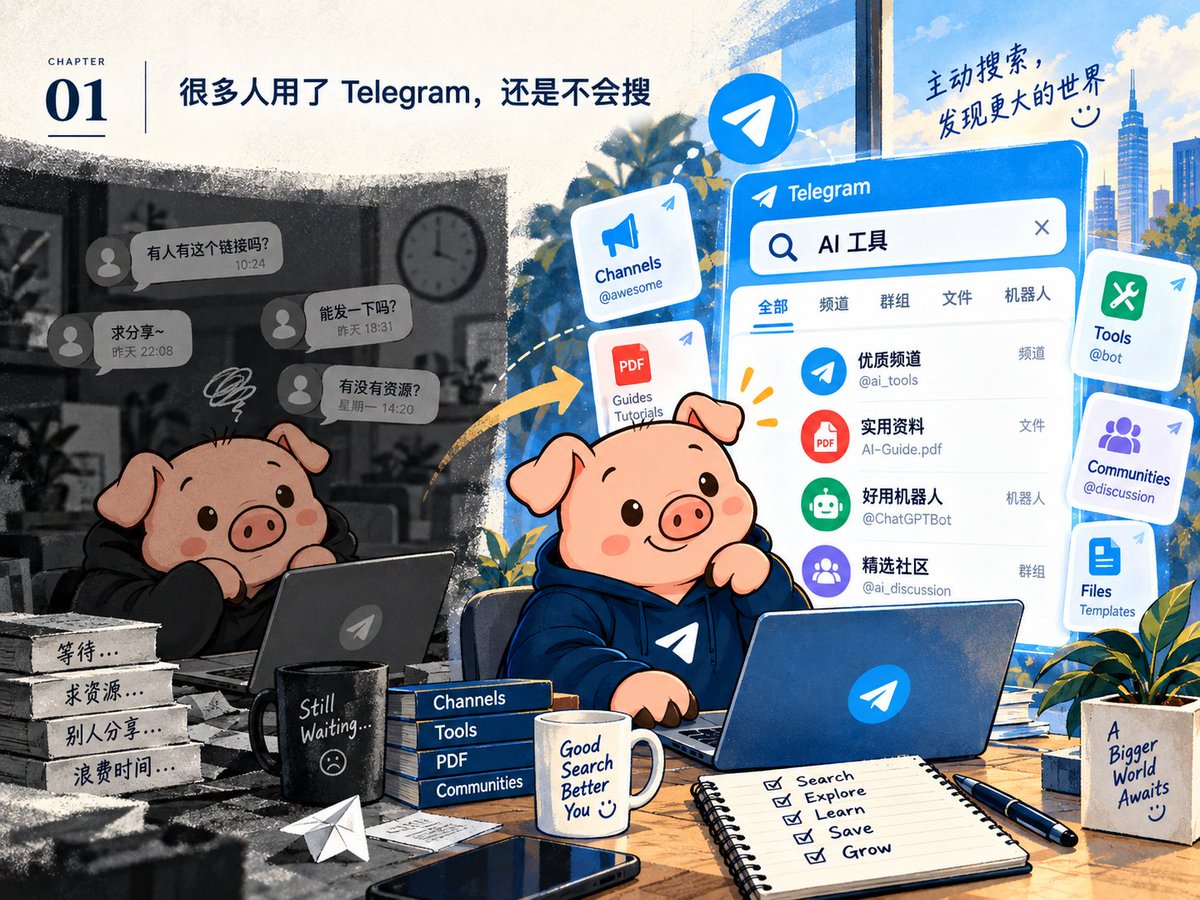
问题通常不是工具不会用,而是使用方式没变。
很多人的日常是:打开 Telegram → 看几个频道 → 收几个转发 → 顺手收藏 → 过两天忘了。
本质上和刷朋友圈、刷信息流没有太大区别。你看到什么,完全取决于别人今天发了什么。
而我后来发现,Telegram 真正好用的地方恰恰不是“被动订阅”,而是“主动搜索”。
当你想研究一个主题,比如 AI Agent、跨境电商、独立站、摄影、Python,不应该先问“谁有资料”,而是先把它拆成几个关键词,自己去搜。
这一步看起来很小,但它会直接改变你的信息获取方式。
以前是别人决定你看到什么。现在是你决定自己要找什么。
02|搜索机器人到底在搜什么?
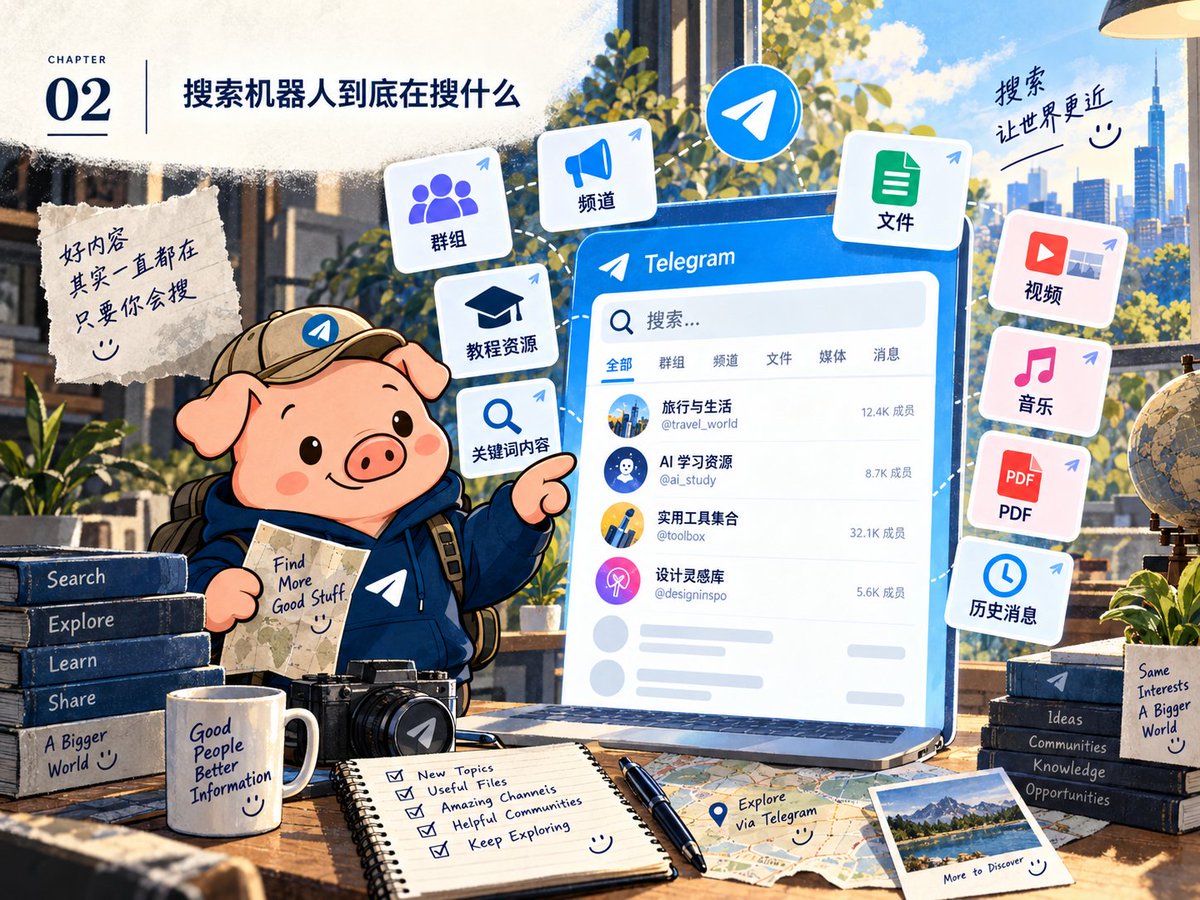
搜索机器人本质上可以理解成 Telegram 生态里的聚合检索入口。它常见能帮你找到几类东西:
-
群组:适合讨论、问问题、看真实用户反馈
-
频道:适合长期跟踪某个主题或信息源
-
文件:PDF、电子书、文档、压缩包、教程
-
视频和音频:很多内容可以直接在 Telegram 里查看
-
历史消息:尤其适合找旧教程、旧项目、过去的讨论
-
关键词内容:围绕某个产品、人物或主题找相关信息
最关键的区别是:Google 主要帮你找网页,而 Telegram 搜索机器人找的是 Telegram 生态里已经存在的内容。
很多资料没有独立网页,也没有做 SEO,甚至从来没被传统搜索引擎很好地收录,但它可能在一个频道里更新了三年。
这就是为什么搜索机器人的价值,不只是“找文件”。它更像一条进入 Telegram 信息网络的快捷通道。
03|真正决定搜索质量的,不是机器人,而是关键词
这是我认为最值得练的一项能力。
很多新手喜欢直接输入一整句话:“有没有完整的小红书运营课程?”“哪里可以找到最好用的 AI 工具合集?”“有没有跨境电商从入门到进阶的资料?”
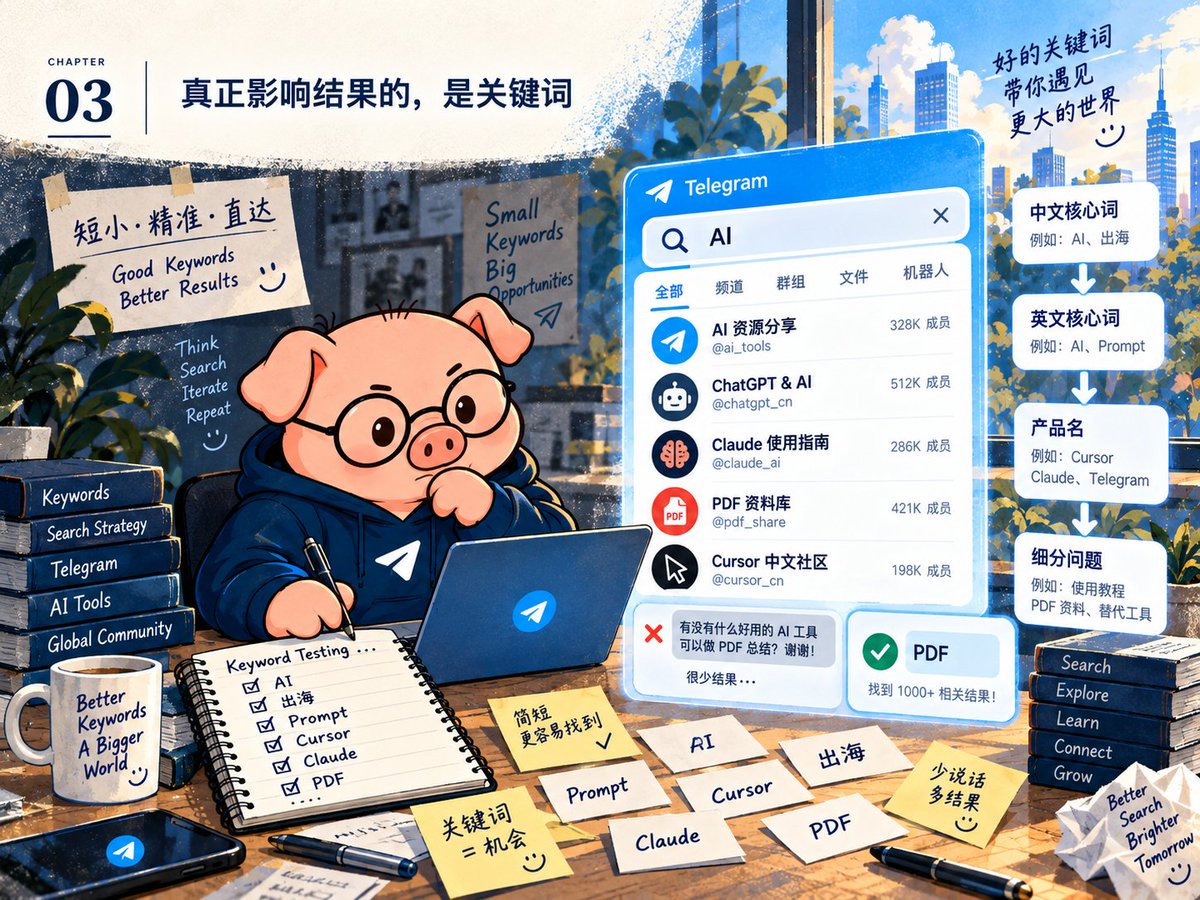
这种搜索方式的问题是:你把 Telegram 当成了 ChatGPT。
但 Telegram 里的内容往往不是按照“问题”被组织的,而是按照标题、标签、频道名和关键词被组织的。
所以我更推荐短词搜索。比如你要研究 AI,不要只搜“AI”,可以分四轮:
第一轮:AI / 人工智能
第二轮:Agent / Prompt / Workflow
第三轮:Claude / Cursor / Codex / OpenAI
第四轮:MCP / Skills / Agent workflow
出海
独立站
Shopify
SEO
投放
跨境
Affiliate
我的习惯是:一个主题至少换 4 组词。
中文搜一轮,英文搜一轮;产品名搜一轮,具体问题再搜一轮。
不要指望一个关键词把所有好东西一次性端到你面前。真正会搜的人,往往不是“知道一个神奇关键词”,而是会不断换角度。
04|先说安全:搜索机器人只负责找到,不负责替你判断
Telegram 里确实有大量公开资源,但同样有假机器人、假频道、诈骗链接和恶意文件。尤其是机器人名字非常像的时候,新手很容易点错。
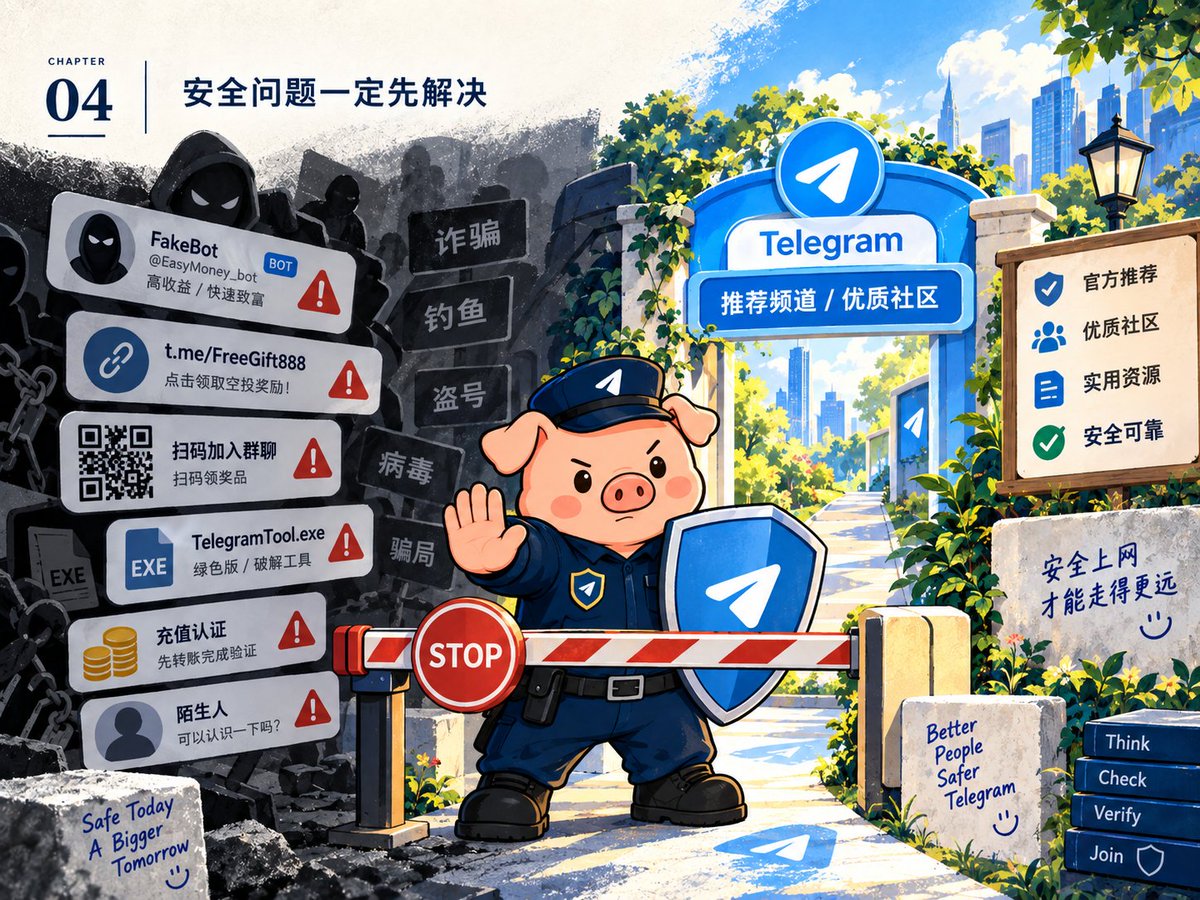
我自己的规则很简单:
-
不下载来源不明的 EXE、APK 或所谓“破解版”。
-
任何要求你先充值、转账、支付验证费的机器人,都先停一下。
-
Telegram 登录验证码不要交给任何人。
-
不因为“搜到了”就默认它是真的。
搜索结果是线索,不是背书。
最稳妥的入口通常来自长期运营的导航、熟悉的社区、可信作者或老用户分享。
如果一个机器人刚进去就疯狂要求授权、付费、加陌生客服,直接退出。
05|为什么有时候搜着搜着就被限制?
很多人第一次找到搜索机器人以后特别兴奋,一分钟连搜几十个词。AI、ChatGPT、赚钱、副业、课程、出海……结果没多久就出现频率限制,或者直接搜不出结果。
这并不难理解。对很多机器人来说,连续、高频、机械式操作,本身就很像脚本行为。
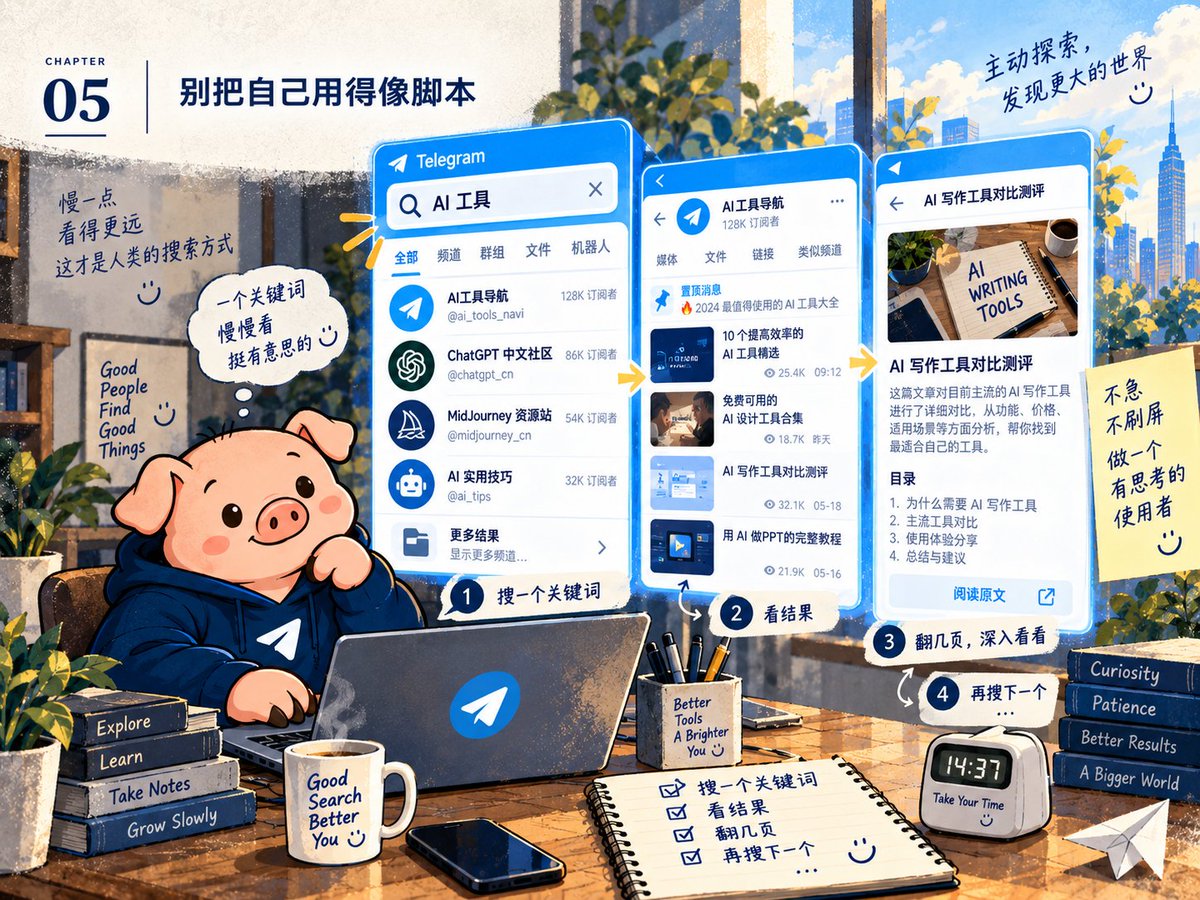
所以不要把搜索做成“关键词轰炸”。
我的节奏通常是:搜一个词 → 看结果 → 翻几页 → 点进几个频道或文件 → 再回来搜下一个。
很多真正有价值的结果,也未必在第一页。有时候你认真看一个关键词五分钟,比连续输入二十个词更有效。
06|搜到以后,怎么判断这个结果值不值得留?
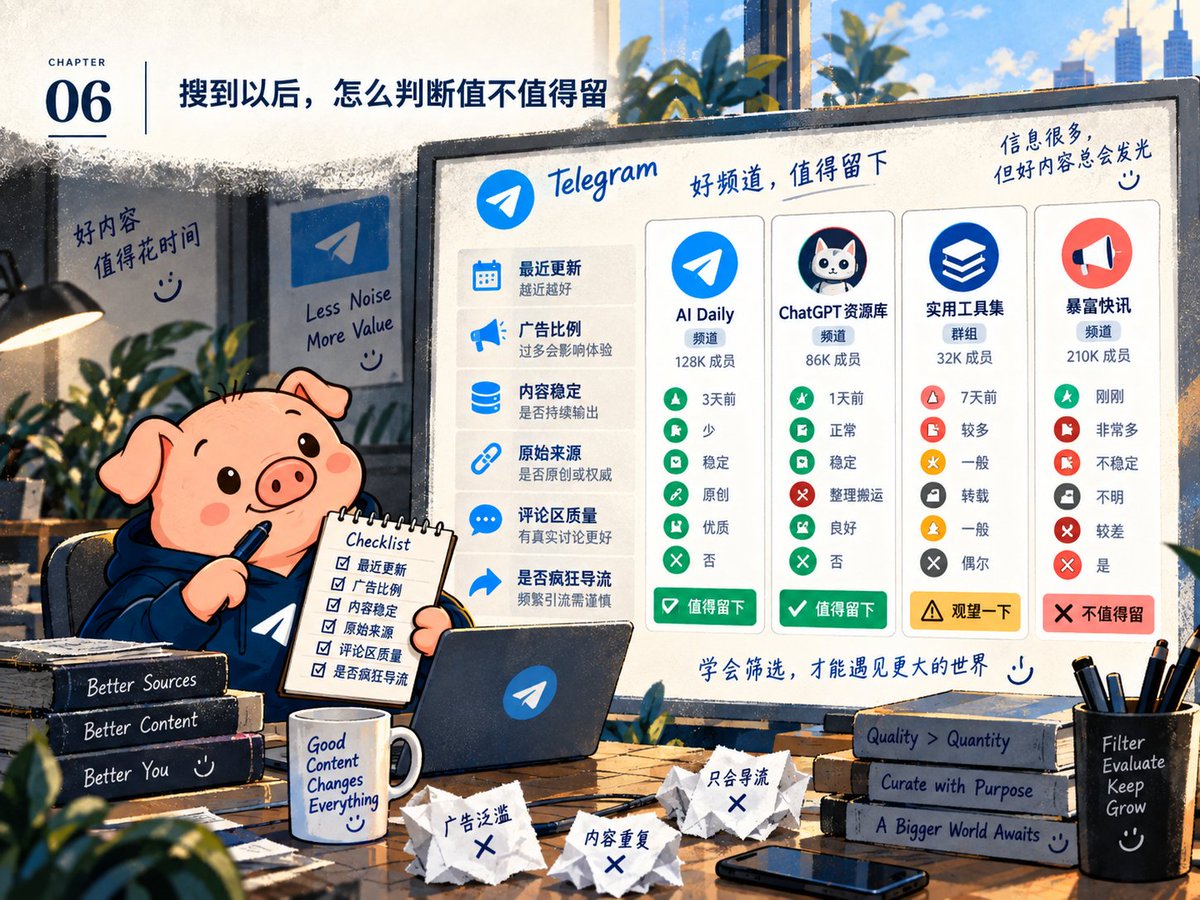
这是大多数教程容易跳过的一步。“搜到”只是开始。我现在看到一个频道,会先花 30 秒看六件事:
-
最近有没有持续更新
-
内容是不是长期围绕同一个主题
-
广告和导流比例高不高
-
有没有原始链接或信息来源
-
内容是不是大量复制粘贴
-
评论区和互动看起来像不像真实用户
搜到不等于搜对。
如果一个频道半年没更新,或者十条内容里八条都是广告,我一般不会留。
如果它长期稳定输出,而且经常引用原始资料、项目官网、研究文章或一手信息源,那才值得继续跟。
搜索效率真正拉开差距的地方,是后面的筛选。
07|找到一个好频道以后,不要急着回搜索框
这一步是我后来才真正用顺的。假设你搜到一个质量不错的 AI 频道,先别关。继续看:
-
它经常转发谁
-
它引用哪些频道
-
管理员还运营什么频道
-
置顶消息推荐了什么
-
评论区里谁经常提供高质量补充
-
它引用的原始来源来自哪里
一个真正好的频道,往往不是终点,而是一个“种子节点”。
顺着它继续挖,可能会带出五个、十个甚至更多相关信息源。这比你一直在搜索框里换关键词效率高得多。
我现在找新信息源,经常就是:关键词搜索 → 找到一个好频道 → 顺着转发和引用继续扩展。
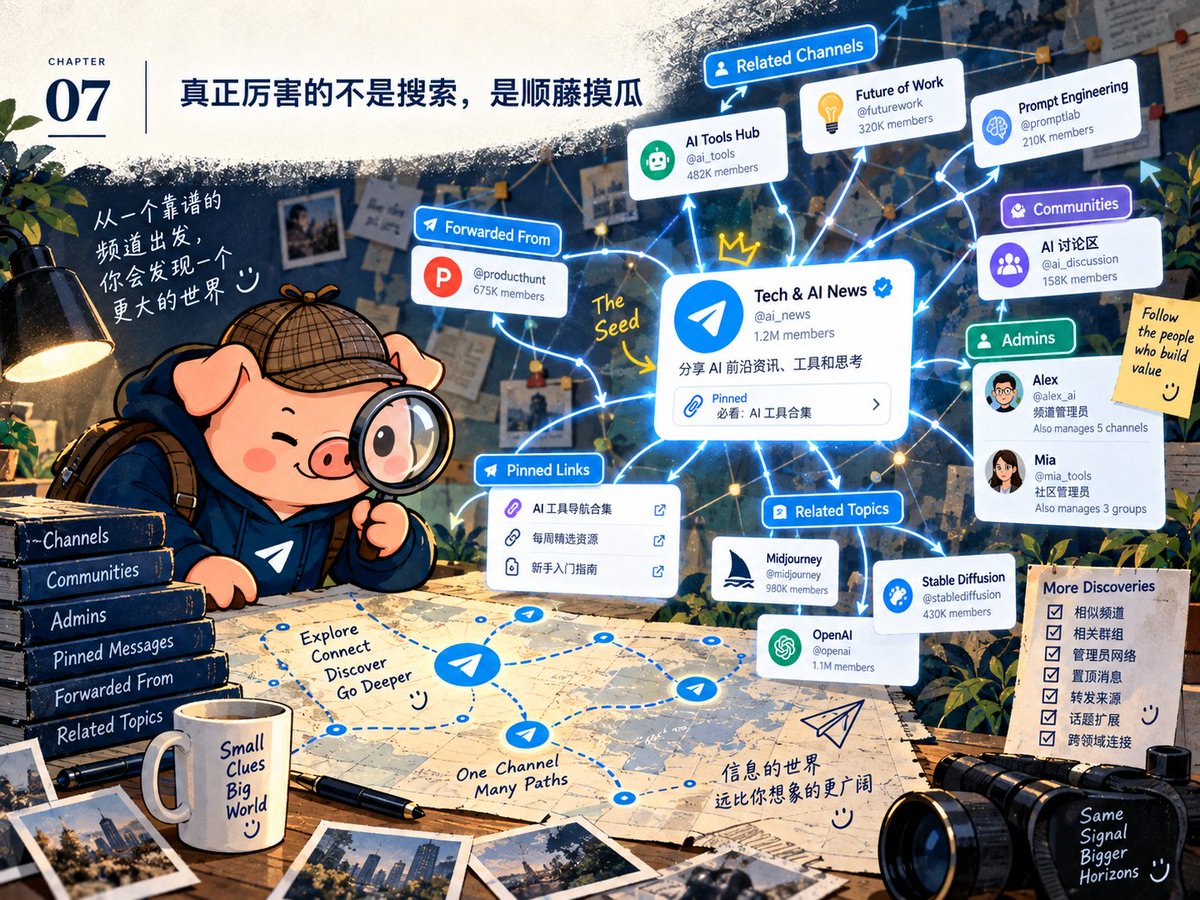
久而久之,你会得到一张属于自己的信息关系网。
08|别只收藏:把资源变成自己的私人数据库
很多人搜到好东西以后第一反应是收藏。我以前也这样。
最后的结果通常是:几 GB 文件、几百条 Saved Messages、几十个“以后再看”,然后一个都没打开。
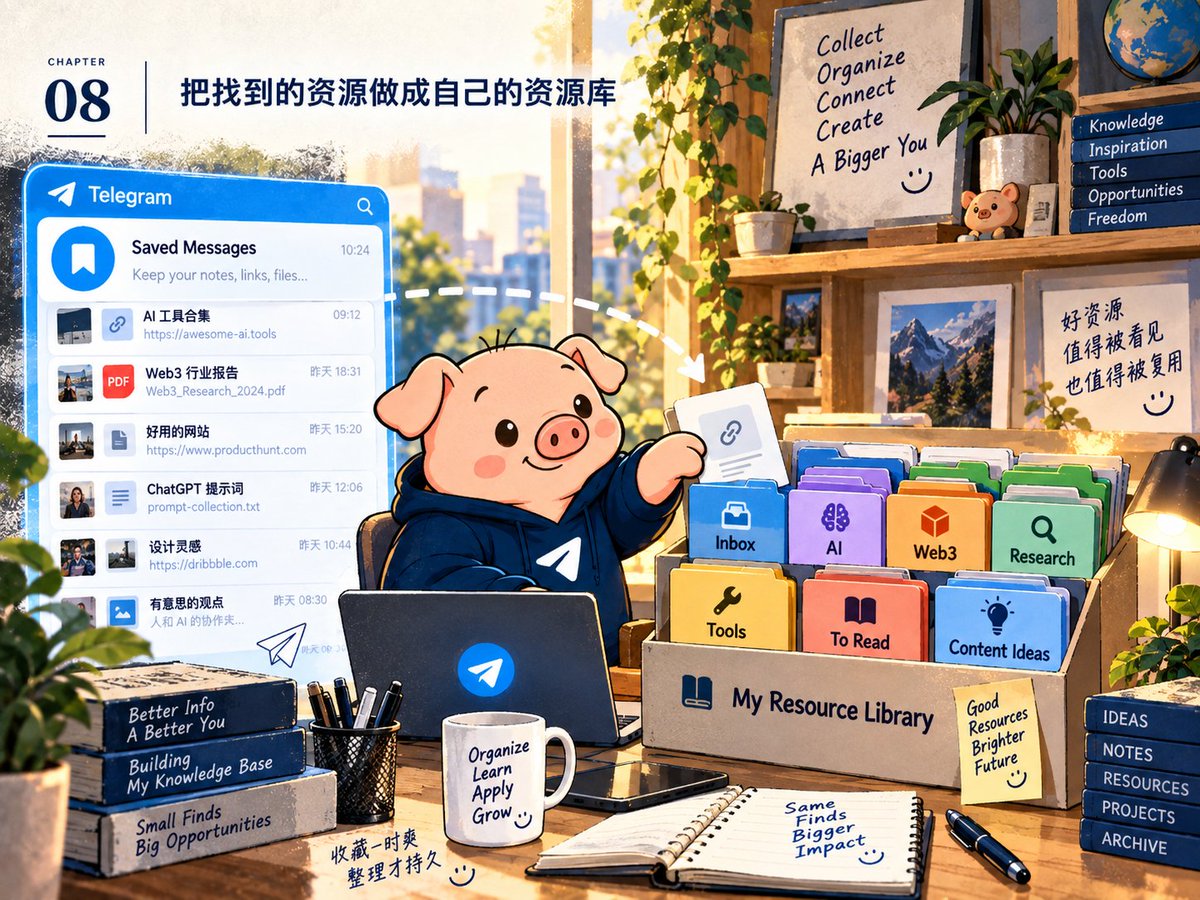
后来我把流程改了。我会把 Telegram 里的内容先分流到几个固定位置:
00_Inbox
01_AI
02_Web3
03_Research
04_Tools
05_To_Read
06_Content_Ideas
平时搜索到的东西先全部进入 00_Inbox。不要一边搜索一边精细分类,因为这会严重打断搜索节奏。
等一轮搜索结束以后,再统一处理:值得长期保存的,进入对应分类;只需要看一次的,放 To_Read;适合写文章的,进 Content_Ideas;没价值的,直接删。
这样 Telegram 才不是一个越用越乱的收藏夹,而是一个可以重新找到资料的资源库。
09|再往前一步:Telegram + AI 才真正开始有意思
这是我现在最常用的一种方式。Telegram 负责发现信息,AI 负责整理和加工。工作流很简单:
搜索机器人 ↓ 找到频道 / 文件 / 历史消息 ↓ 转进私人频道或 Saved Messages ↓ 交给 AI 总结、翻译、分类 ↓ 提取原始链接和关键观点 ↓ 进入知识库或选题库
比如我一次搜了二十条 AI Agent 相关资料,我不会自己一条条重新整理。
我会把内容整理后直接给 AI:
请处理下面这批 Telegram 资料。

输出:

1. 每条内容一句话摘要
2. 按 AI / Web3 / 工具 / 行业资讯分类
3. 标记重复内容
4. 提取所有原始链接
5. 找出最值得继续研究的 5 条
6. 说明为什么值得关注
7. 无法确认的信息标记“待核验”
这样做最大的好处不是省几分钟,而是你开始把 Telegram 从“聊天软件”变成“信息采集层”。
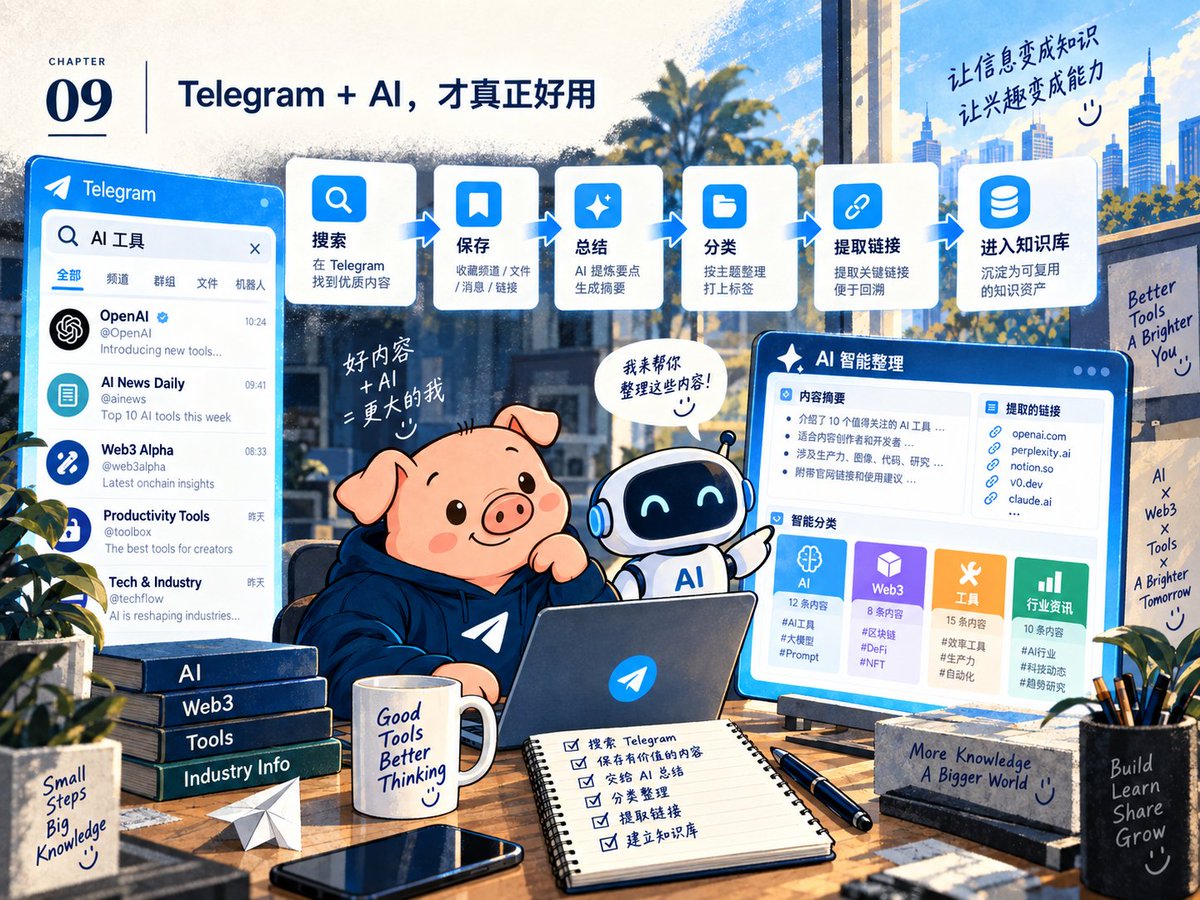
搜索机器人负责发现,私人频道负责暂存,AI 负责处理,最后真正有价值的东西再进入你的知识库。
这时候你得到的就不是一堆链接,而是一套可以持续运行的信息工作流。
10|资源库最容易掉进的坑:收藏很多,使用很少
这一点我踩过很多次。看到 PDF,先存;看到教程,先存;看到 Prompt,先存;看到别人整理的合集,还是先存。
最后收藏夹越来越大,但真正用过的资源越来越少。所以我现在给自己加了一条规则:每周至少清一次 Inbox。
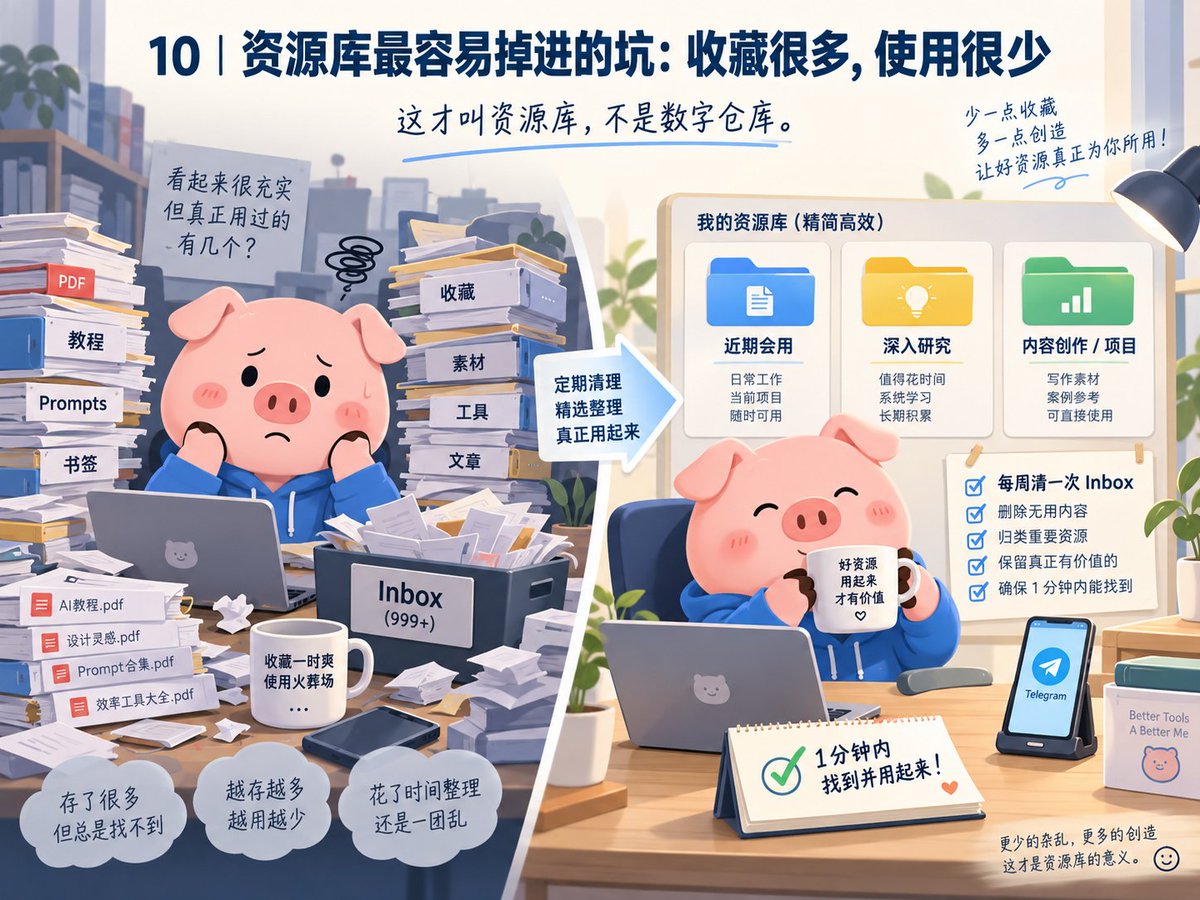
只留下三类东西:
-
近期马上会用
-
确定会深入研究
-
可以进入内容创作或项目
其他的,哪怕看起来“以后可能有用”,也可以删。因为资源库真正的价值,从来不是文件数量。
而是:当你真正需要某个信息时,你能不能在一分钟内重新找到它,并把它用起来。这才叫资源库。不是数字仓库。
最后
以前我用 Telegram,基本就是等别人分享。现在我的流程已经变成:自己搜 → 自己筛 → 自己存 → AI 整理 → 真正使用。
工具其实没变。变化的是我获取信息的方式。
很多人以为所谓“信息差”,就是别人有一个你不知道的网站、一个你不知道的群、一个你不知道的机器人。但这种信息差越来越短。
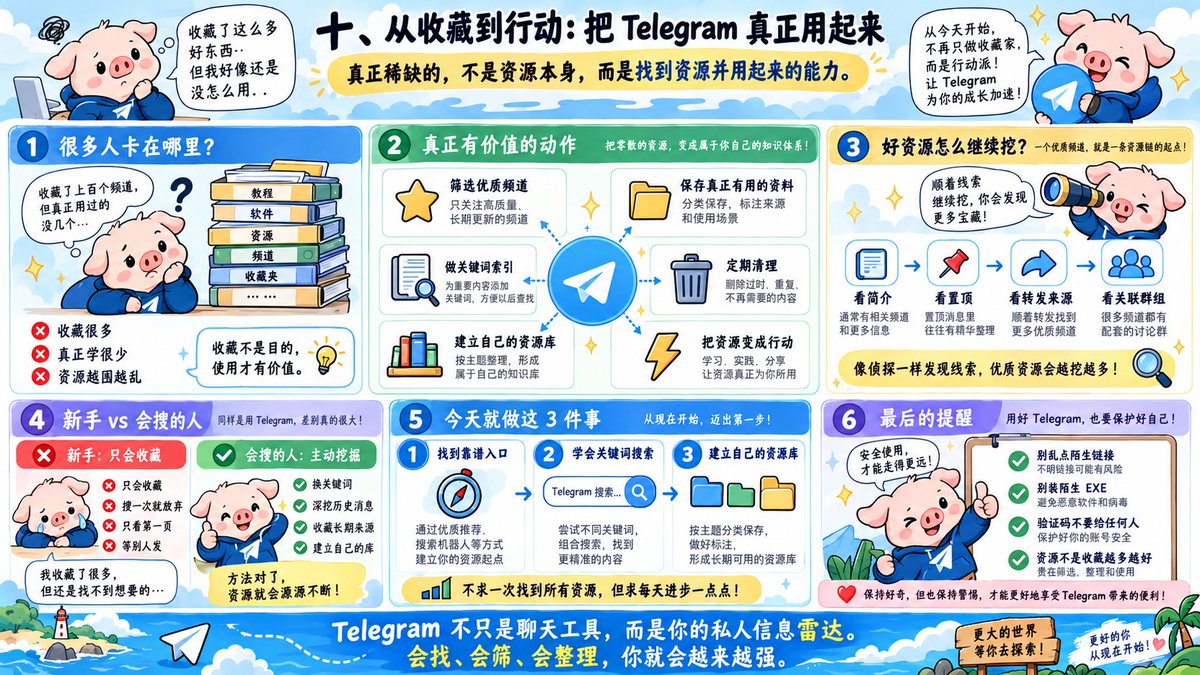
真正能长期积累的,是你有没有一套稳定的方法,把陌生主题快速拆成关键词,找到信息源,判断质量,然后把有价值的东西留下来。
所以搜索机器人真正值得学的,并不是“哪个机器人最好用”。而是它背后的这套能力:主动搜索、持续筛选、建立自己的信息网络。
因为资源永远不缺。真正稀缺的,是能持续找到、判断,并最终把资源用起来的人。
扩展阅读
关于作者
Fred-New @Fred834567|香港博士|AI × Web3 洞察|技术与趋势深度剖析|开源 AI 工具与代理|实用工作流程 |双语洞察 🇺🇸 & 🇨🇳|私信开放