
写真skill升级,增加了下面几个新功能(开源版)
文章目录
上个月,我把自己的写真 Prompt Skill 开源了。
当时它解决的问题很明确:看懂一组参考图,提取共同的视觉 DNA,再生成同系列的新画面。妆造、色彩、场景和成像质感可以延续,构图和动作不必重复。
这套能力现在依然保留着。
但我继续拿它跑写真时,目标已经往前走了一步:我不只想要“同一个审美世界里的变体”,还想要换一位人物,像真的把她带到同一家摄影店,由同一支团队按同一套企划重新拍一组新分镜。
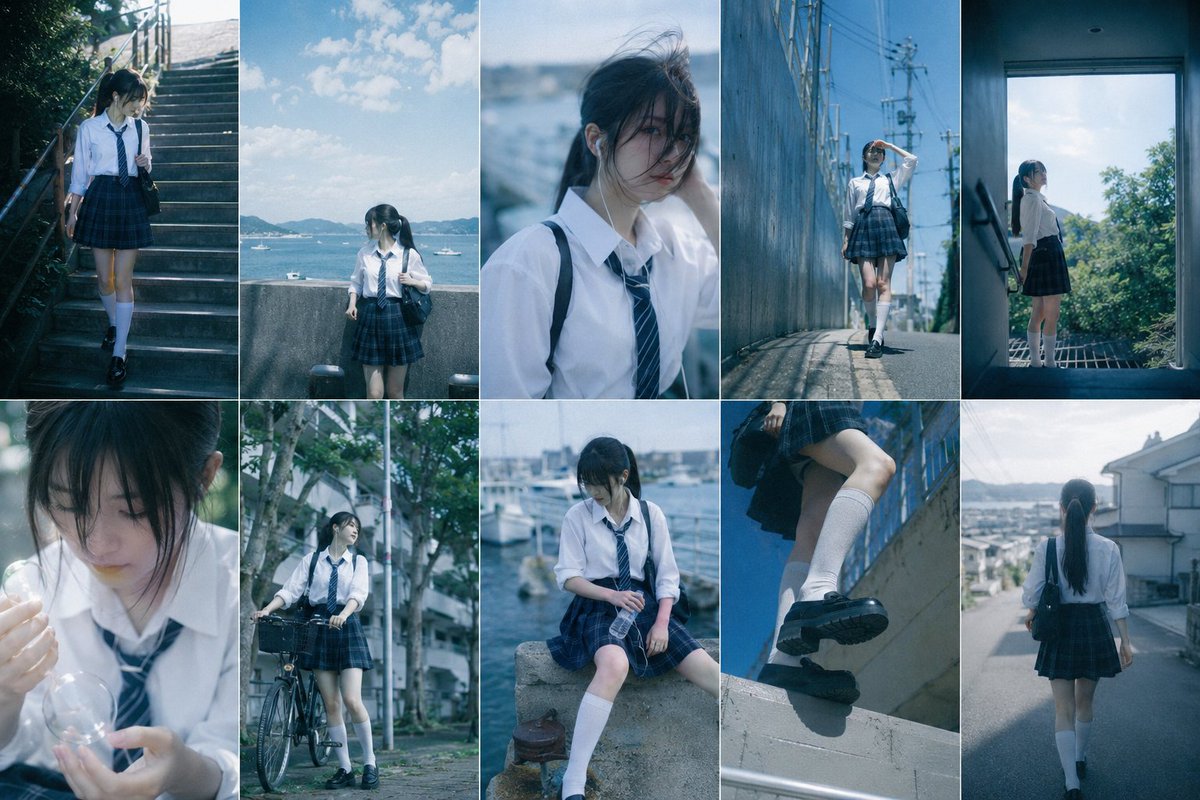
同一套蓝调海岸校园企划下的十个观看位置。它能证明分镜和系列关系可以一起延续;只看这张拼贴,还不能证明所有模型、所有轮次都能稳定保持同一张脸。
这两个目标听起来很像,实际差得很远。
“颜色差不多、衣服差不多、场景差不多”,只能说明模型学到了一层表面风格。真正换了机位以后,人物是谁、光从哪里来、表情为什么发生、背景应该清楚到什么程度,都会重新变成问题。
所以这一次,我几乎把写真 Skill 的复拍部分重新写了一遍,也决定把完整升级版继续开放出来。
先把“她是谁”和“这套写真怎么拍”拆开
这次最关键的改动,是把参考图的职责分开。
人物身份图只回答一件事:她是谁。它提供脸型、眼型、鼻唇关系、特征痣这些稳定辨识点,不负责把原图里的盘发、黑衣、中性表情和棚拍光线一起带进来。
写真参考图负责另一件事:这套照片怎么拍。妆容、发型、服装、场景、镜头、光线、色彩和成像,都由它接管,但它不能反过来覆盖人物身份。
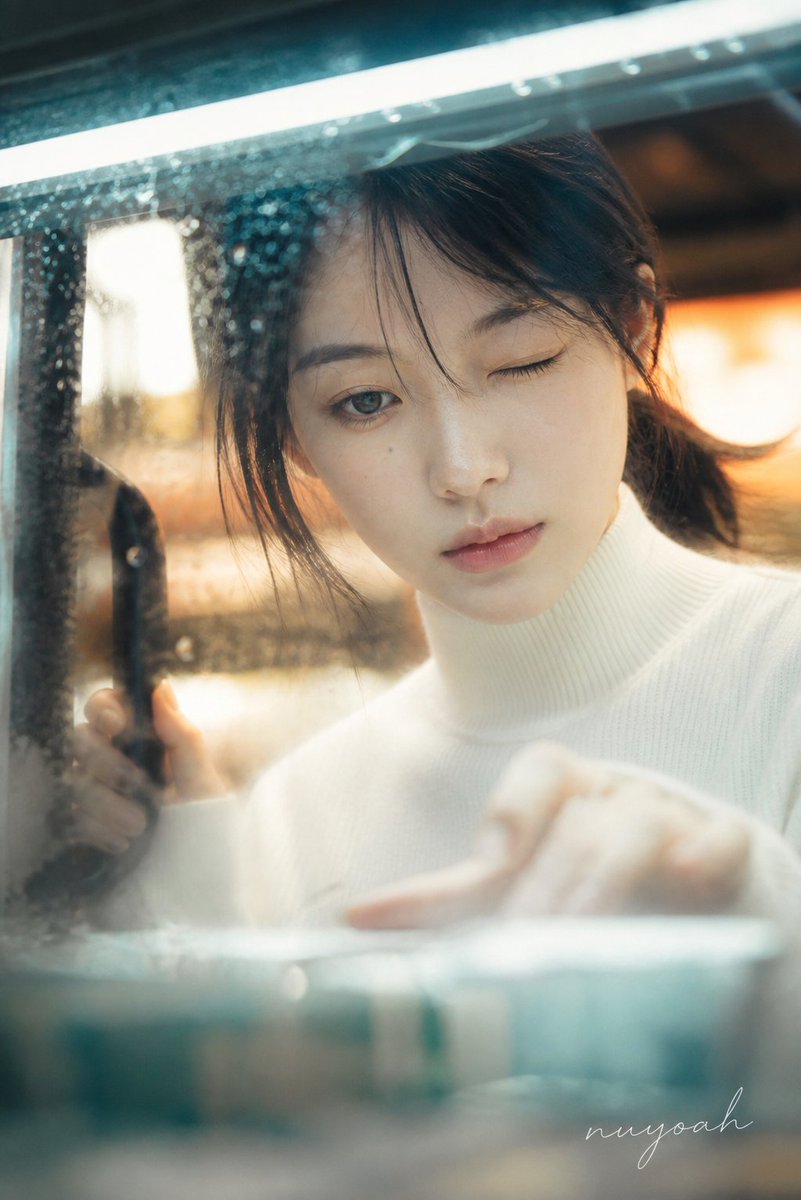
这一张把相机放进冷柜,隔着带雾气和水珠的玻璃向外拍。人物身份继续保留,场景、妆造和眨眼反应由本张摄影事件接管。身份与空间关系成立,但冷青色和锐度仍比原参考更现代、更清晰。
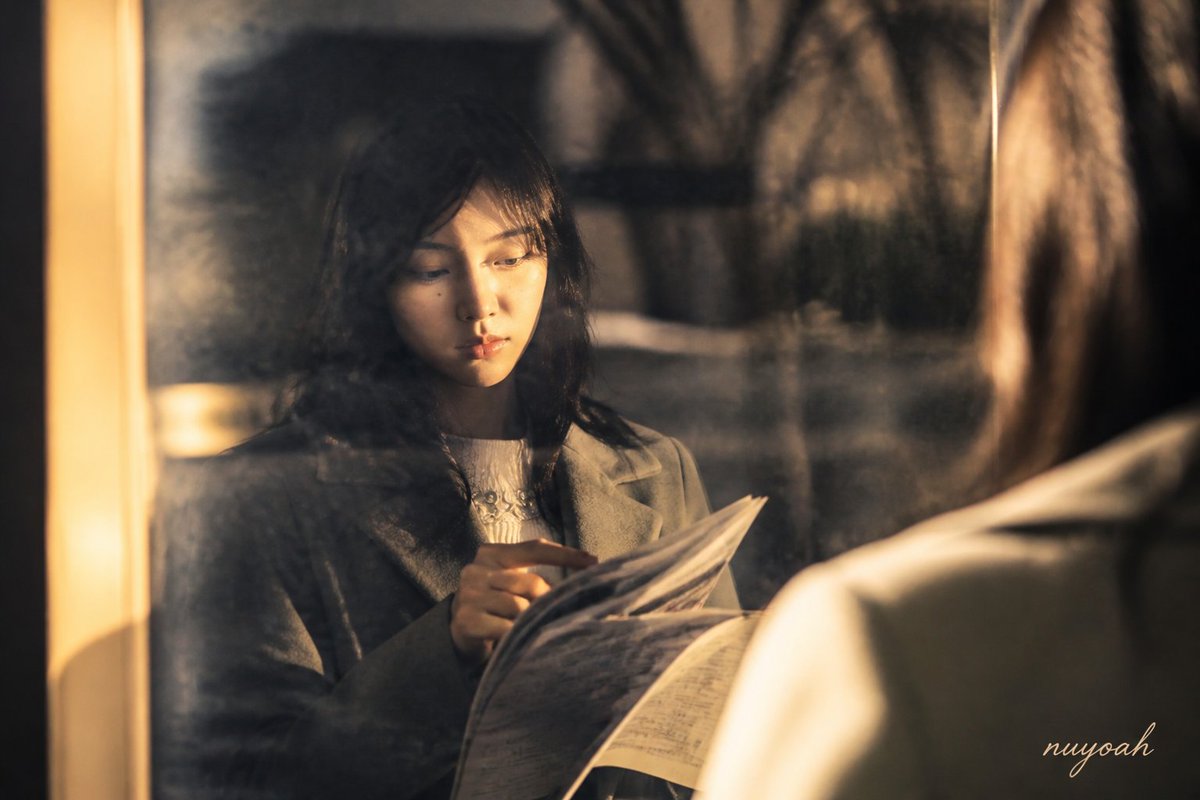
公交玻璃反射的新机位。五官、手指和纸页事件可辨,暖黄硬光与深暗关系也保留下来;但服装出现了轻微继承身份图的问题。
这层分离看起来只是多写几句职责,实际会直接影响成图。
一旦不分,模型很容易把身份图当成整张照片的总参考:脸保住了,原来的发型、表情和衣服也跟着回来;或者写真风格保住了,人物却慢慢变成参考写真里的另一个人。
而且“同一人物”也不是一道写完就永远通过的开关。
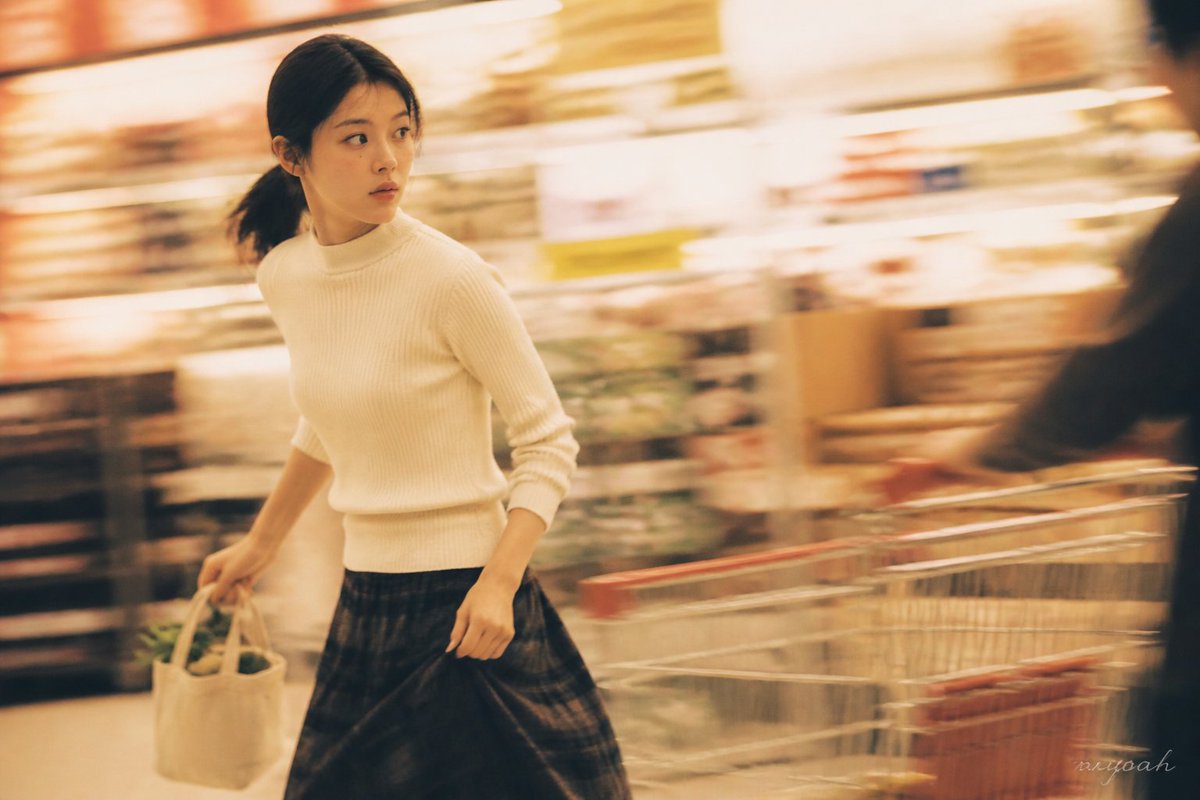
这是我保留下来的失败样本。横向追焦、购物车事件和运动关系都成立,但我回看后确认人脸已经漂移,主体又被保护得过于清楚,没真正承受住运动模糊的压力。它不能拿来证明身份稳定,只能说明边界在哪里。
失败图也说明,这套 Skill 并不是万能的。Image 2 在横向追焦和强运动模糊下维持人物身份,本身就有明显上限。Skill 能做的是尽量补齐可控部分,但无法绕过模型上限,更不可能追求一模一样。
换机位,不能让太阳跟着相机跑
复拍最容易露馅的地方,是光。
模型看到一张好看的参考图,经常会记住“左脸亮、右脸暗”“头发边缘有光”,然后把这些二维位置复制到下一张。相机一换方向,光也跟着转,最后每个机位都像临时搬来了一套更顺手的影棚灯。
升级版会先固定场景里的关系:光源在哪里,中间被什么挡住,光落到脸、手、衣服和环境的什么位置,周围又怎样把颜色反射回来。相机只改变观看位置,不负责搬动太阳、窗户和屋檐。
这套检查被我暂时叫作“光照拓扑重建”。它不是摄影行业的新术语,只是我在 Skill 里给这项检查起的描述性名字。
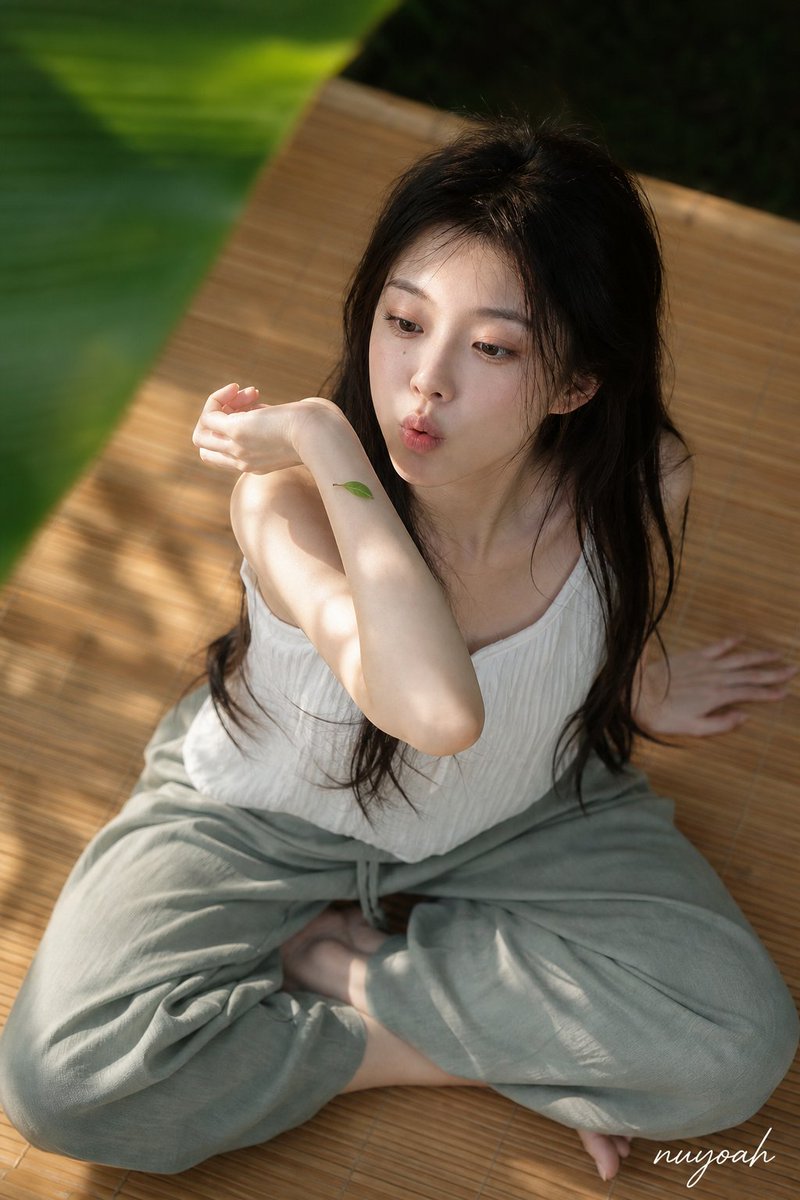
机位改成斜上方俯拍以后,光仍然从场景左上方穿过蕉叶。眼神光、鼻梁、前臂、白衣和竹席的受光关系要互相说得通,而不是因为相机升高,就自动变成一盏正上方的影棚顶光。
它不能保证每次都物理正确,但至少把验收从“看着挺像”推进到了更具体的问题:换完机位以后,这束光还成立吗?
表情不能只写“自然一点”
写真里还有一种很常见的假感:脸很漂亮,眼神却不知道在看什么;手在做动作,嘴角又像在拍另一张广告。
我以前也会在 Prompt 里写“自然、灵动、松弛”。跑得越多越发现,这些词没有告诉模型表情为什么发生。
升级版会先给人物一个当前场景里真实存在的小事件,再让身体、眉眼、呼吸、嘴唇、视线和手一起响应。
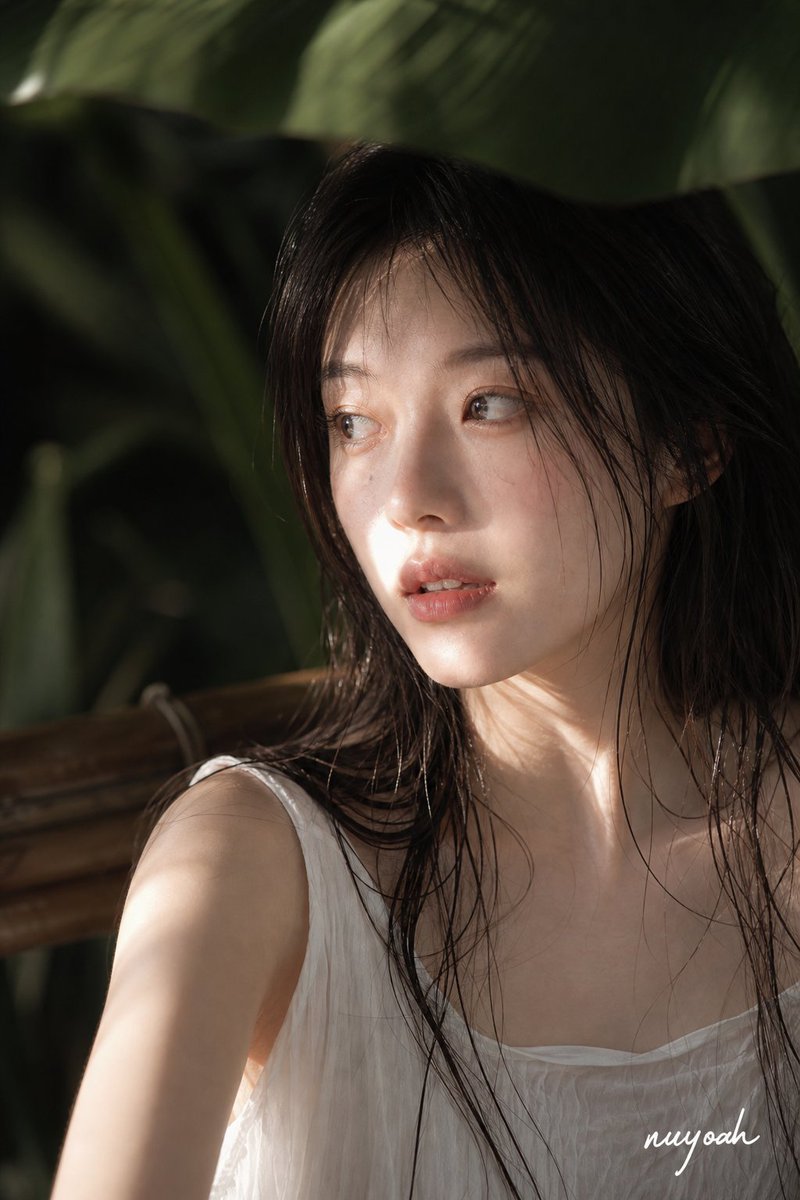
蕉叶被风推动,光斑刚从眼前移开。人物先轻轻眯眼,再重新适应光线;这张的事件因果成立,但表情幅度仍然偏克制。
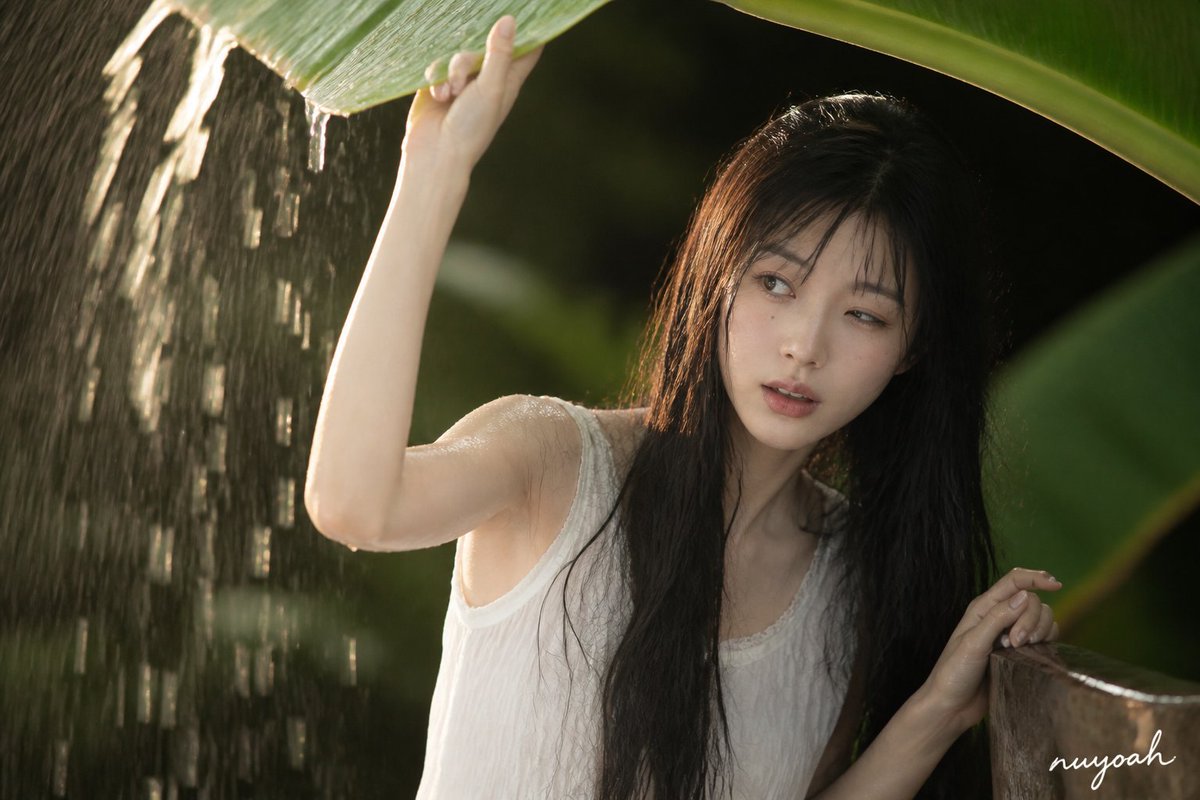
人物托起被雨水压低的蕉叶,积水从一侧倾下。
同一组里,我还专门控制了背景的信息量。该清楚的是眼睛、湿发、手和人物事件;大型蕉叶、竹席和深绿阴影负责构成画面,其余枝叶不必每一根都抢着证明自己存在。
这比一句“背景虚化”更有用。背景暗,不代表背景安静;满屏细枝、叶脉和高光点即使都很暗,依然会把人物淹没。
有时候,更漂亮反而离原作更远
模型很擅长把照片自动升级成商业大片:脸补亮一点,眼睛对焦更稳一点,发丝加一圈暖色轮廓光,衣服材质再清楚一点。
如果原参考本来就是精致棚拍,这些处理可能没问题。但有些作品的力量恰恰来自欠曝、失焦、堵黑、强风和一次没完全对准焦点的抓拍。把它“修好”,反而把原作最重要的东西修没了。
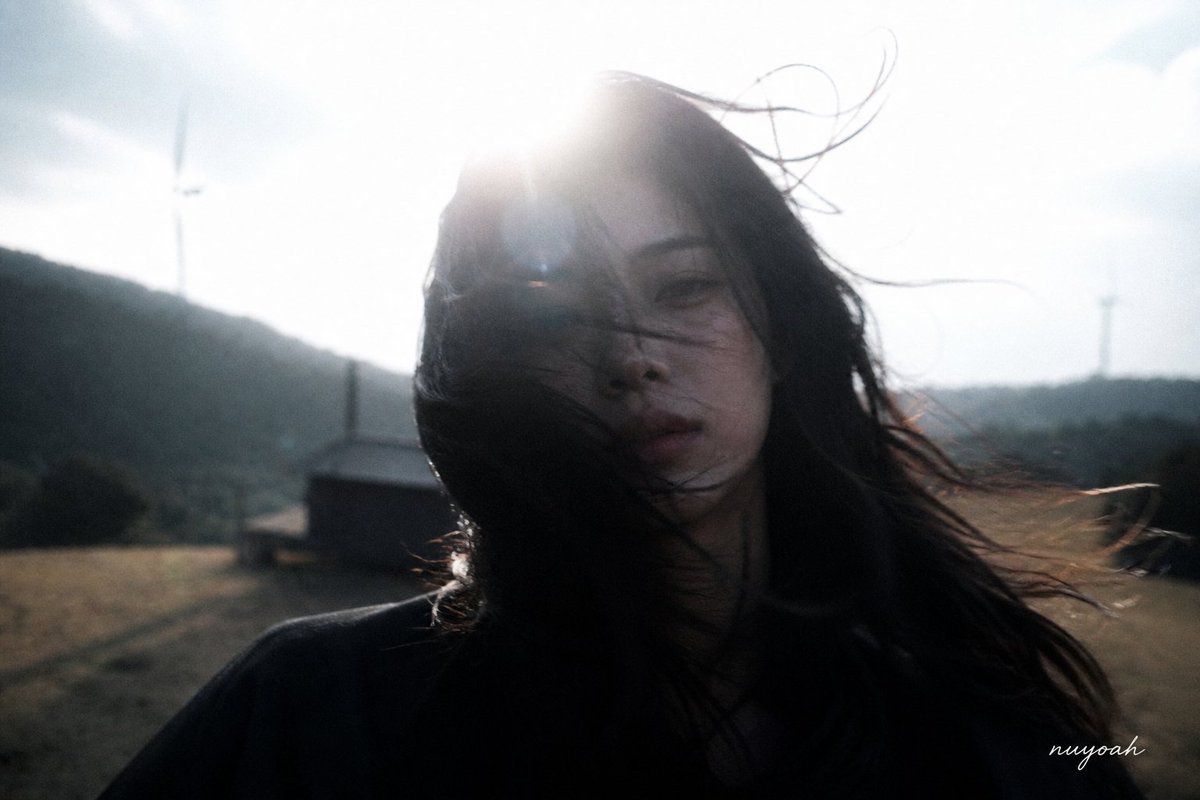
这张高原风场测试主动保留了太阳溢出、发丝遮脸、深暗面部和柔软失焦。
所以升级版增加了一层“去商业抛光”检查。它不会把所有写真都做旧、做脏,只在原作确实依赖这些成像缺陷时,压掉模型自己补上的商业摄影升级。
还有一条更笨、但很重要的规则:重做时不拿上一轮生成图继续喂给模型。
每一轮都回到原始人物图和原始写真参考,结合这轮反馈重新编译一条完整 Prompt。上一张图只用来诊断哪里失败,不变成下一轮的新参考。
否则迭代几轮以后,我们以为自己在靠近原作,实际只是在修一张已经偏掉的生成图。画面可能越来越顺眼,离最初想复拍的摄影企划却越来越远。
这次开放的,是一套更严格的复拍方法
基础版已经开源过。这次我决定继续把后来补完的摄影方案复拍工作流也开放出来。
它仍然保留普通写真 Prompt、组图拆解、系列母版和同系列变体;新增的重点,是人物身份与写真方案分控、新机位光照重建、人物事件与表情因果、背景信息层级、去商业抛光,以及每轮从原始参考重新开始的验收合同。
边界也要说清楚。
当前完整生图回归只在 Codex Image 环境中正式跑过。其他模型可以复用 Prompt 思路,但我不会在没有真实回归前写成“全模型稳定”。它也不承诺 1:1 复刻,不保证每一张都同脸,模型本身的能力边界也不是 Skill 能彻底补掉的。
这反而是我想把完整版本开放出来的原因。
一个写真 Skill 真正有价值的地方,不是替每张好图编一套事后解释,而是让身份、摄影方案、光、人物事件和失败状态都能被看见、被修改,也能被别人继续检验。
完整升级版已经在GitHub上哪开源了,链接在这:
https://github.com/nuyoah-ai-works/nuyoah-xiezhen-prompt.git
(希望能获取你们的小星星)
如果懒得跑一趟了,也可以直接把下面这条命令交给终端:
npx skills add nuyoah-ai-works/nuyoah-xiezhen-prompt -g -y
安装后新建一个任务,再把人物身份图和写真参考组一起发给 Agent,就可以从摄影方案复拍开始测试。
可能有很多不完善的地方,欢迎大家来提提建议。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


