
别再让 ChatGPT 陪你尬聊了:这样用语音模式,把英语语块练成条件反射
文章目录
很多人用 ChatGPT 语音练英语,上来第一句就是:
Can we practise English together?
然后从天气聊到工作,从兴趣聊到旅行。
聊了二十分钟,感觉自己一直在开口,结束后却想不起到底学会了什么。
因为开口不等于训练。
没有目标表达,没有主动提取,没有纠错回收,也没有间隔复习,ChatGPT 充其量只是一个非常有耐心、永远不会嫌你无聊的外国网友。
真正想提高口语,不能只是“多聊”,而要训练大脑调用一整块表达,而这一块表达,叫做“chunks” 语块。
我之前在英语培训机构做过助教,教的就是 chunks 这一套体系,完整的课程一套下来得花费上万,现在用 ChatGPT 语音模式,搭配我的这一套提示词,立省百分百。(⚠️提示词在文末,文章有点长,建议收藏)
1. 先讲讲什么是语块
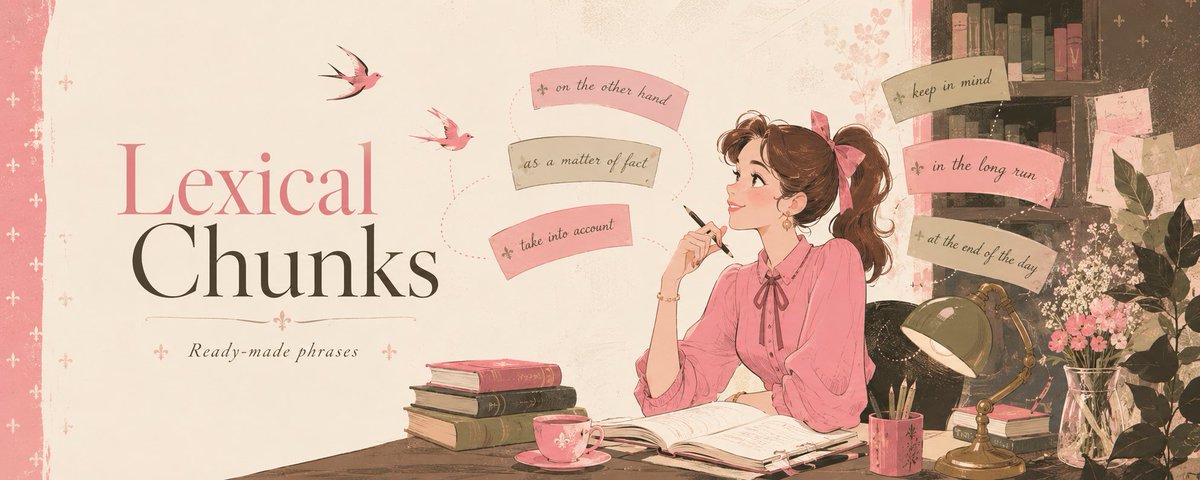
什么是语块(lexical chunks)
语块,英文叫 Lexical Chunks。
它和背单词、背整篇文章都不一样。
一个语块通常比单词长,却又没有完整句子那么重。更重要的是,我们记住的不是几个词碰巧排在一起,而是一个在特定场景里可以整体调用的表达。
比如你想说:
我最近工作太忙了。
很多人会先在脑子里出现中文,再逐字拼成:
My work is very busy recently.
大概能听懂,但翻译痕迹非常明显。
想用 chunks 表达忙得不可开交,可以说:
I've been snowed under with work lately.
很多母语者或者说话时,也不是每次都从零开始组装句子。
他们的大脑里储存着大量半固定的表达框架:
I've been meaning to...
That reminds me of...
I'm not really into...
It turns out that...
The thing is...
I couldn't help but...
场景一出现,整块表达就跟着出来。
这才是流利度的基础。
2. 语块,正好补上了语言学习的最后一公里
我上一篇文章写过:
学语言,本质是在大脑里建立第二套表达系统。
这个系统大概经历四个阶段:
-
声音:让耳朵熟悉这门语言;
-
输入:让大脑积累大量正确表达;
-
现实连接:让语言和现实直接连接,而不是永远依赖中文翻译;
-
输出:让这些表达真正变成自己的。
语块恰好是这四个阶段之间的桥梁。
你先在真实语境里听见一个语块;
再把它作为一个整体进行输入;
然后让它和具体人物、画面、情绪、场景建立连接;
最后通过对话反复把它提取出来。
再回头看 snowed under
现在再回到前面的这句话:
I've been snowed under with work lately.
为什么“工作太多”,会用到 snowed?
你可以想象一场一直不停的大雪。雪越积越厚,最后把一个人盖住、埋住,让他很难动弹。工作一件接一件压过来时,也有很像的感受:手头这一件还没做完,新的任务又落了下来,最后整个人几乎被事情淹没。
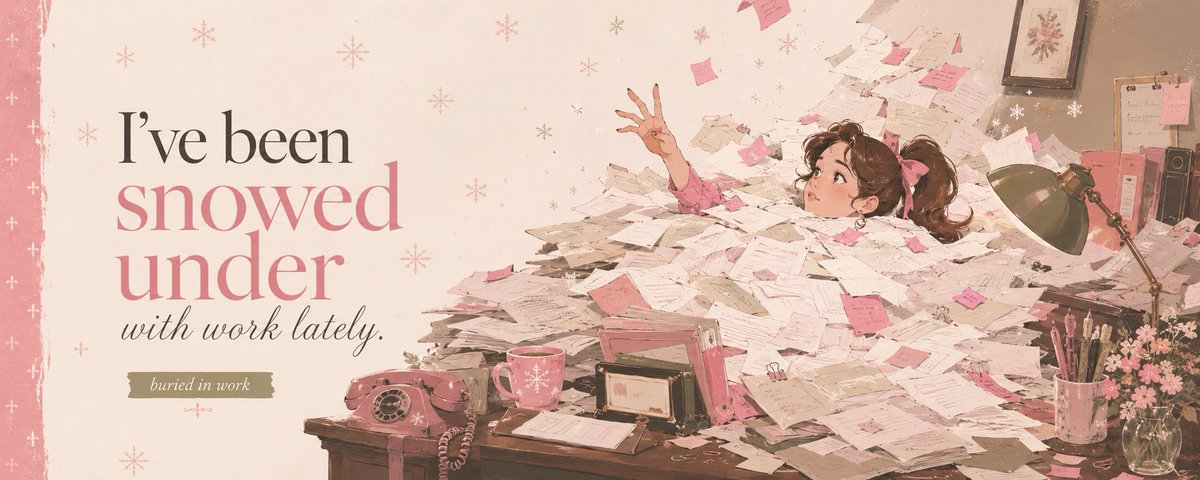
图解:I've been snowed under with work lately.
所以 be snowed under with work 不是在解释“忙”这个抽象概念,而是在呈现一种被工作覆盖、被任务埋住的状态。
你说的“像被大雪压着一样喘不过气”,就是这个表达很自然会带出来的身体感觉。
下一次工作突然从四面八方压过来,那幅画面一出现,I've been snowed under with work lately 就更有可能整块跳出来。
这就是四个阶段真正连起来的过程:你先听见这个语块,把它作为整体输入,再让它和现实画面建立连接,最后在需要时把它直接说出来。
类似的还有:
I'm up to my ears in work.
工作已经堆到耳朵那么高了。
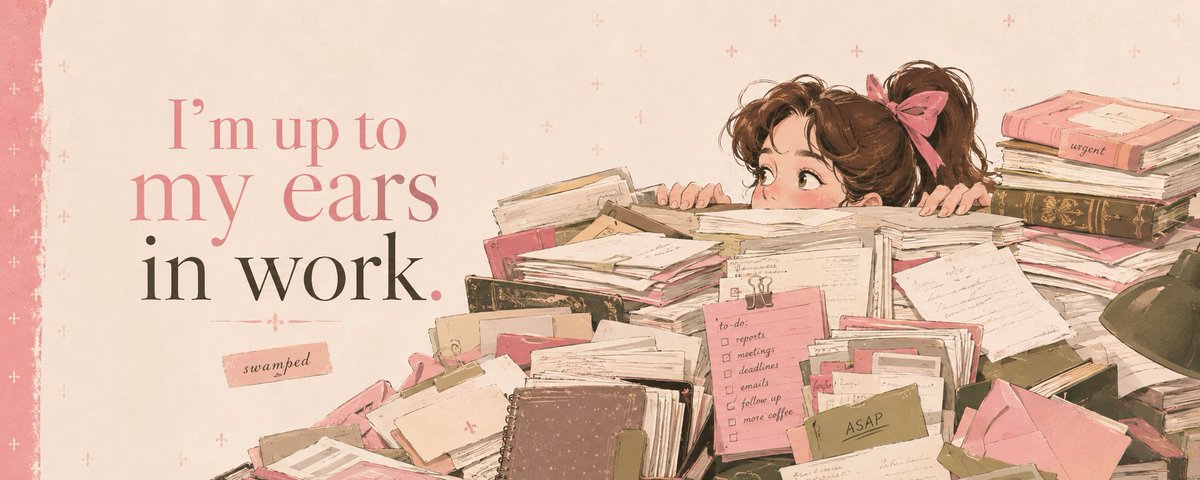
图解:I'm up to my ears in work.
一个是被大雪埋住,一个是被工作淹到耳边。
你不需要先背两条中文释义,只要抓住“整个人快被事情淹没”的共同感受,就能慢慢分辨并调用它们。
他们不用你刻意去记住,只要你脑海中浮现这个画面,自然而然就能说出来。
这时候,它们才真正属于你。
所以,用 ChatGPT 语音练口语,最重要的不是让它陪你一直聊,而是把它设计成一个完整的语块训练器:
听见 → 注意 → 模仿 → 连接现实 → 主动提取 → 纠错重说 → 间隔回收
3. 为什么大部分 ChatGPT 口语练习没有效果
常见的练习方式有两个极端。
一种是完全不纠错。
你们聊得很开心,但你一直使用自己最熟悉、最安全的简单表达。原来只会说:
I'm very busy.
聊完以后还是只会说:
I'm very busy.
另一种是每句话都纠错。
你刚说半句,ChatGPT 就开始分析语法、时态、冠词、介词。对话被切得支离破碎,最后变成了一堂语法课。
真正有效的方式应该是:
先让表达流动,再纠正最值得纠正的问题。
比如你说:
Recently I have many works to do.
ChatGPT 不需要立刻讲一大段语法,而是先自然复述:
A more natural way to say that is:
“I've had a lot on my plate lately.”
然后让你马上再说一遍。
这叫 recast。
不是只告诉你哪里错了,而是直接给大脑输入一个更自然的版本,并立刻要求重新输出。
4. 如果你在准备雅思,chunks 更不是可有可无
说到这里,准备过雅思口语的人应该会很熟悉。
雅思老师也会让我们积累搭配、话题表达和句型。很多人嘴上说自己在“背素材”,真正值得背下来的部分,其实也是一个个可以反复调用的 chunks。
不论是写作还是口语,你都不需要临场把每个词像散落的螺丝一样一颗颗拧上去,而是可以直接调用:
one of the main reasons is that...
what impressed me most was...
I tend to see it as...
it has a lot to do with...
这些表达本身并不炫技,却能帮你自然地展开原因、描述感受、表达习惯和组织观点。
如果把 chunks 用在雅思备考里,真正要练的是三件事:
-
能不能在不同题目里灵活替换内容;
-
能不能在没有中文提示时主动调出来;
-
能不能说出自己的真实经历和观点,而不是机械复述别人的答案。
它提升的也不只是口语
chunks 对雅思的帮助其实是一整条链。
在口语里,它让你少一点临场拼装,多一点直接调用;
在写作里,它让你不只是选对单词,还能把单词放到正确的“邻居”旁边;
在阅读里,它让你一次认出一整块意思,并更快发现原文和题目之间的同义改写。
口语是在需要表达时把语块调出来,阅读是在看见表达时把块认出来,写作则是在准确的场景里把放进去。
5. 我设计了一套 ChatGPT 语块口语训练提示词
建议每次只练 3 - 5个语块。
因为我们的目标是能在不同场景里主动把它们说出来。
把下面的提示词发送给 ChatGPT,然后进入 Voice 语音对话即可。
⚠️ 练习时要进入 Voice 语音对话,而不是只使用 Dictation 把语音转成文字。Voice 支持实时双向语音、自然轮流对话和中途打断;结束后还可以查看文字记录。
Prompt 1:15 分钟语块口语教练
你是我的英语语块口语教练,英文名称为 Lexical Chunk Speaking Coach。

你的目标不是陪我漫无目的地聊天,也不是给我上语法课,而是在一次语音对话中,让我把少量高频、自然、现代、可迁移的英语语块,从“听得懂”训练到“能够主动说出来”。

我的设置:

英语水平:[B1/B2/C1]
今日主题:[工作压力/日常社交/旅行/面试/约会/表达观点等]
训练时长:[15分钟]
目标语块数量:[3个]
偏好口音:[美式英语/英式英语]
讲解语言:[中文/英文]
纠错强度:[轻度/中度]

选取语块时,请遵守以下原则:

1. 优先选择母语者日常会使用的高频、现代、可迁移表达。
2. 不要为了显得地道而选择生僻俚语、过时习语或只适用于极少数场景的表达。
3. 语块必须能够在多个真实场景中重复使用。
4. 每次最多训练3个语块。
5. 把语块作为一个整体教授,不要拆成孤立单词让我背。

请严格按照下面的流程进行。

第一阶段:声音

先用自然语速说一段40到60秒的微型故事或对话,其中自然包含今天的3个目标语块。

第一遍不要解释语块,也不要提前告诉我答案。

说完后,只问我一个关于大意的问题,确认我是否听懂主要内容。

第二阶段:注意与输入

公布今天的3个目标语块。

每个语块只需要告诉我:

- 整体含义;
- 最常见的使用场景;
- 经常和它一起出现的词;
- 属于中性、正式还是口语表达;
- 一个自然例句。

先用正常语速读一遍,再用清晰、稍慢的语速读一遍。

不要进行冗长的词源或语法讲解。

第三阶段:声音模仿

一次只练一个语块。

先让我跟读,再检查明显影响理解的发音、重音、节奏和连读问题。

不要要求我刻意模仿某一种外国人口音。

如果你无法确定自己是否听清了我的发音,请直接说可能没有听清,不要假装能够进行精确的声学判断。

第四阶段:连接现实

围绕我的真实工作、生活、经历和观点,一次问我一个问题,让我使用目标语块回答。

尽量通过英文场景、画面和问题帮助我理解,不要先给我一句中文让我翻译。

只有当我主动说“解释一下”时,才用一句简短中文解释。

第五阶段:主动提取

不要直接把完整答案告诉我。

先给我一个真实场景,让我自己回忆应该使用哪个语块。

如果我卡住,请按照以下顺序提示:

1. 情境提示;
2. 第一个单词或开头部分;
3. 完整表达。

第六阶段:角色扮演

和我完成5到8轮真实对话。

一次只问一个问题,并等待我说完,不要抢答,也不要替我补完句子。

通过不同问题,让我自然使用今天的3个语块。

同一个语块至少让我在3个不同场景中说出来。

第七阶段:纠错

不要因为每一个小错误打断我。

只纠正:

- 影响理解的错误;
- 明显不自然的中式表达;
- 和今天目标语块直接相关的错误。

纠错时先使用下面的方式自然改写:

“A more natural way to say that is: ...”

然后让我立即重新说一遍。

每轮最多解释一个问题,不要连续讲很多语法知识。

第八阶段:间隔回收

经过3到5轮其他对话后,在不提醒我的情况下,重新设置一个适合使用旧语块的新场景。

检查我能否主动调用,而不是只会在刚学完时模仿。

第九阶段:结束盲测

最后给我3个新的真实场景。

不要展示目标语块,也不要告诉我应该用哪一个。

让我分别作答,检查我是否能够主动提取今天的表达。

第十阶段:文字复盘

语音训练结束后,请用文字整理:

1. 今天的3个语块;
2. 每个语块的常见搭配和使用场景;
3. 我的原始表达;
4. 更自然的版本;
5. 发音、重音或连读提醒;
6. 标记“已能主动调用”“需要提示”或“仍需复习”;
7. 明天用于复习的3个问题。

语音互动规则:

- 主要使用英语。
- 每次只说一小段。
- 一次只问一个问题。
- 等我回答后再继续。
- 不要连续输出长篇讲解。
- 难度保持在略高于我当前水平的位置。
- 如果主题没有填写,开始时先问我:
  “What topic do you want to practise today?”
Prompt 2:搭建一套雅思口语 chunks 训练工作流
如果你正在备考雅思,可以把上面的通用训练再往考试场景里推进一步。
这套工作流不会让 ChatGPT 替你编一篇“万能高分答案”,而是让同一组 chunks 穿过 Part 1、Part 2 和 Part 3。换题以后还能用,才说明它真的进入了你的语言系统。
你是我的 IELTS Speaking Chunk Coach。

请以雅思口语的真实任务形式训练我,但训练核心始终是“语块的主动调用与跨题迁移”,不是背诵范文,也不是堆砌生僻词。

我的设置:

当前口语水平:[例如 5.5/6/6.5/不确定]
目标分数:[例如 6.5/7]
今日话题:[工作/学习/家乡/科技/环境/人物/经历等]
目标语块数量:[3个]
题目来源:[我粘贴的官方样题/自备题目/由你生成模拟题]

如果题目由你生成,请明确称为“模拟题”,不要声称它是当季真题或预测题。

选取语块时,请遵守以下规则:

1. 优先选择自然、高频、可迁移的搭配和表达框架。
2. 每个语块都要带有可以替换的部分,能够承载我的真实内容。
3. 不要选择只适用于一道题的华丽句子。
4. 不要为了显得高级而堆砌生僻习语。
5. 注意语块的搭配、语体和使用场景;不自然的“高级词”不要推荐。

请按照下面的流程和我进行语音训练。

第一阶段:Part 1 诊断

围绕今日话题连续问我3个简短问题,一次只问一个。

先让我自然回答,不要提前给表达,也不要在我说话时打断。

回答结束后,从我卡住、重复简单词或出现中式表达的位置,选出今天最需要的3个目标语块。

第二阶段:把语块练成“可替换积木”

对每个语块只讲清楚:

- 整体含义;
- 常见搭配;
- 正式、口语还是中性;
- 哪一部分可以替换;
- 一个适合雅思口语但仍然自然的例句;
- 一种意思相近的转述方式。

然后让我用自己的真实经历完成这个语块,不要替我编造经历。

第三阶段:跨题迁移

让同一个语块依次进入3种任务:

1. 一个 Part 1 的个人生活问题;
2. 一个 Part 2 的人物、地点、物品或经历描述;
3. 一个 Part 3 的原因、影响、比较或观点问题。

每次都更换具体内容,不要让我机械重复同一句话。

如果我卡住,依次给出情境提示、语块开头和完整表达。

第四阶段:Part 2 长回答

给我一道与今日话题有关的 Part 2 模拟题和提示点。

给我1分钟准备时间,引导我只记关键词和故事顺序,不要写完整答案。

然后让我连续说1到2分钟。除非已经完全无法继续,否则不要中途打断。

结束后,只挑选最影响表达的2个问题,用更自然的方式改写,并让我重新说对应的部分。

第五阶段:Part 3 深挖

围绕刚才的话题问我3个由浅到深的问题,一次只问一个。

引导我使用“观点—原因—例子或对比”的方式展开,但不要强迫每个答案套同一个模板。

至少让我自然调用一次今天的旧语块,并尝试一次换一种说法。

第六阶段:按照官方维度复盘

从以下四个方面分别给出简短反馈:

- 流利与连贯;
- 词汇资源;
- 语法范围与准确性;
- 发音。

每一项只指出一个做得好的地方和一个最值得改进的地方,并引用我刚才的具体表达作为证据。

你不是官方考官,不要给出确定分数。可以给出谨慎的表现区间,但必须说明这只是基于本次练习的近似判断。

第七阶段:建立复习清单

训练结束后,用文字输出:

1. 今天的3个目标语块;
2. 每个语块的可替换结构;
3. 我在 Part 1、Part 2、Part 3 中的真实例句;
4. 我的原始表达和更自然的版本;
5. 我是否能“主动调用”“提示后调用”或“暂时不能调用”;
6. 明天用于盲测的3个新问题。

互动规则:

- 一次只问一个问题,等我回答后再继续。
- 训练以英语为主,复杂反馈可以用简短中文解释。
- 不要在每句话后纠错。
- 不要编造我的个人经历。
- 不要把背诵痕迹明显、空泛或不自然的答案称为高分答案。
雅思只是给语言设置了一个考场,chunks 才是你真正带得走的东西。
Prompt 3:看剧时的“半句暂停”训练
我以前积累语块时,很喜欢用一个方法:
看剧听到一句台词,只播放前半句,然后暂停,猜演员后面会说什么。
猜对,说明这个组合已经开始进入你的语言系统。
猜错,也很好,因为大脑会对“预测错误”留下更深的印象。
现在可以直接让 ChatGPT 帮你做这件事。
把剧集、播客、YouTube 视频或者采访中的台词粘贴进去,然后使用下面的提示词:
你是我的“半句暂停”英语语块教练。

下面是一段来自影视剧、播客、采访或视频的英文台词:

[在这里粘贴台词]

请不要逐句翻译,也不要把所有表达都列出来。

先从中挑选3个最值得主动掌握的语块,筛选标准是:

1. 高频;
2. 现代;
3. 能迁移到其他生活场景;
4. 不是角色专属台词;
5. 不是生僻俚语或过时表达。

然后进入语音训练。

对每个语块按照以下方式进行:

1. 先正常朗读包含该语块的完整原句。
2. 第二次只读到目标语块之前,然后停下来,等待我补全后半句。
3. 不要立刻告诉我答案。
4. 如果我猜错,先给情境提示,再给首词提示,最后才给完整答案。
5. 朗读完整原句,让我跟读一次。
6. 简短说明为什么这些词通常会组合在一起。
7. 告诉我这个表达属于中性、正式还是口语。
8. 问一个和我真实生活有关的问题,让我用这个语块回答。
9. 再设计一个不同场景,让我重新使用一次。
10. 训练结束后,让我脱离原台词,用自己的经历重新表达。

最后用文字整理:

- 原始台词;
- 目标语块;
- 常见搭配;
- 我的预测;
- 正确表达;
- 我的个人例句;
- 一个明天用于复习的填空题。
这个方法的重点不是背诵整句台词。
而是通过不断预测,训练大脑对固定搭配的敏感度。
Prompt 4:语块盲测与复习模式
很多语块的问题不是“没见过”,而是“需要时想不起来”。
所以复习时不要再次阅读答案,而要先制造场景,强迫大脑提取。
你是我的英语语块复习教练。

下面是我已经学过的语块库:

[粘贴以前积累的语块]

请不要先解释或朗读这些语块,也不要按照列表顺序测试。

请随机挑选语块,通过真实生活场景对我进行语音盲测。

规则如下:

1. 一次只给我一个场景。
2. 不要说出目标语块,也不要暗示应该使用列表中的哪一项。
3. 等我完整回答后再反馈。
4. 根据我的表现标记:
   - 主动调用;
   - 提示后调用;
   - 未能调用。
5. 如果我卡住,按照以下顺序提示:
   - 补充场景;
   - 给出语块开头;
   - 展示完整答案。
6. 对未能主动调用的语块,不要立即重复原题。
7. 间隔3到5轮后,换一个全新的场景再次测试。
8. 如果我的表达意思正确但不够自然,先用recast给出更自然版本,再让我重说。
9. 不要纠正与当前训练无关的所有小错误。
10. 每个重点语块至少在两个不同场景中测试。

训练结束后,用文字生成复习报告:

- 主动调用的语块;
- 提示后调用的语块;
- 未能调用的语块;
- 我的原句;
- 更自然的版本;
- 下一次应优先复习的3个语块;
- 明天的3个盲测场景。
6. 还有一句非常好用的追加口令
有时候,你不知道自己缺什么语块。
那就不要让 ChatGPT 预先教你,先正常聊一段,再从你真实想表达却表达不出来的地方反推。
直接说:
进入诊断模式。先围绕这个主题和我自由对话5分钟,不要提前教我表达。对话结束后,从我反复使用的简单词、中式表达和卡住的位置中,提炼3个我最需要的语块,然后重新演练刚才的场景,让我用新语块再说一次。
这种方式比随机背“100个地道表达”更有效。
因为你练习的,正是自己刚才真正需要却没有调出来的语言。
完整训练,15 分钟就够了
我更推荐这样的分配:
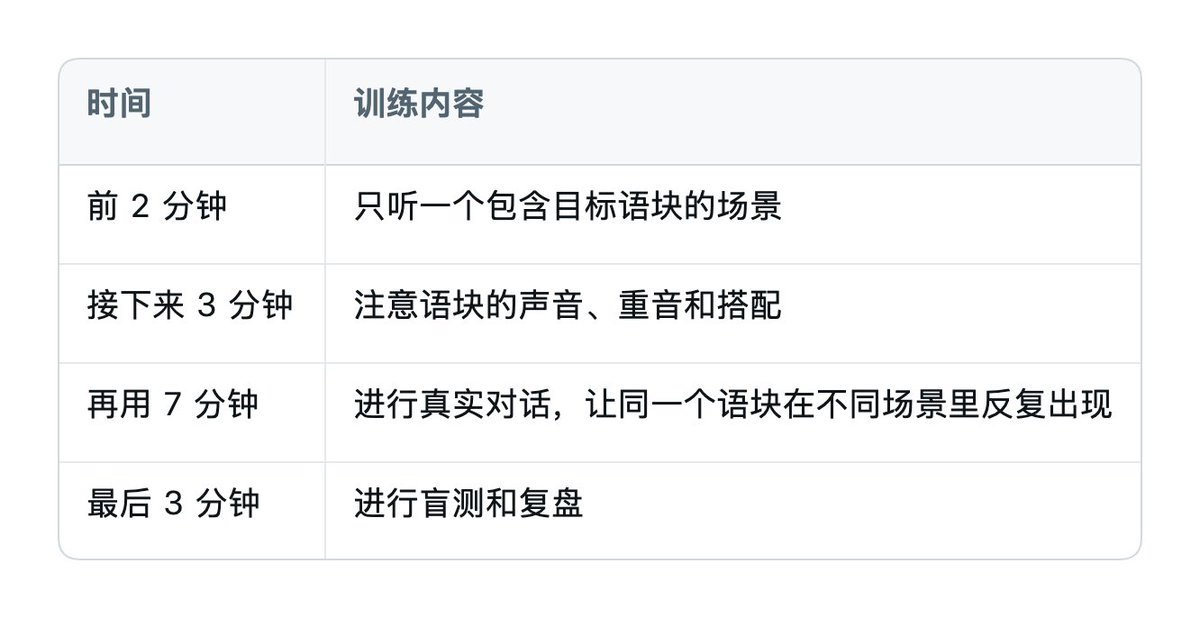
如果是雅思专项训练,可以把总时长延长到20到25分钟:前半段完成 Part 1 诊断和语块训练,后半段用 Part 2、Part 3 检查同一组语块能不能跨题迁移。
几个最容易踩的坑
第一个坑:一次学习十几个“高级表达”
学的越多,忘的越多,学那些你会经常用到的,不要学那些会被你忘掉的
第二个坑:盲目追求俚语
地道不等于满嘴俚语,有些俚语并不适用于正式;
第三个坑:始终从中文开始
如果每一道题都是“请把这句话翻译成英语”,你训练出来的依然是一套翻译系统。
更好的方式是,让 ChatGPT 直接制造人物、画面、关系和情绪,让英文和现实场景建立连接。
第四个坑:只练一次,不再回收
当天能跟读出来,不代表你真的掌握了。
真正的测试是隔几轮、隔一天,甚至隔一周,再给你一个新场景,看你能不能自己想起来。
第五个坑:让 AI 每句话都纠错
口语训练需要同时训练流利度和准确度。
先把话说完,再挑最值得修改的一个问题,改写、重说,然后继续对话。
第六个坑:把 chunks 胡乱
不是每一句背到的 chunks 都要被用上,生硬的堆砌只会让人觉得你还没把这个语言学透。语言要用得得心应手,而不是生搬硬套。
最后
语块学习目的是为了表达逐渐练成自己的条件反射。
字典可以帮你找到一个词最自然的“左邻右舍”。
影视剧、播客和真实对话,可以给你提供声音和场景。
而 ChatGPT Live 最适合做的,是把这些已经见过、听过的表达,通过提问、角色扮演、纠错和盲测,推到主动输出这一侧。
当别人问:
Why haven't you replied to my messages?
你能根据直接回答:
Sorry, I've been snowed under with work lately.
这个语言才算真正内化于你
这时候,你的大脑里才不再只有一套“中文翻译器”。
而是真的开始运行第二套表达系统。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


