
最多 ¥1 API 成本,得到 2min 超细节手绘视频,保姆级拆解 自由切换主题和 IP 的手绘完整步骤
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
一条 2 分钟的手绘白板视频,画面只播 120 秒,人工却可能按天甚至按周算。
没有自动化流程时,脚本、分镜、配音同步、画面素材和逐笔动画都要自己接起来。公开 DIY 制作指南给简单项目的时间参照是 1 到 3 天;脚本改一句,声音、字幕和画面时间都可能跟着重排。
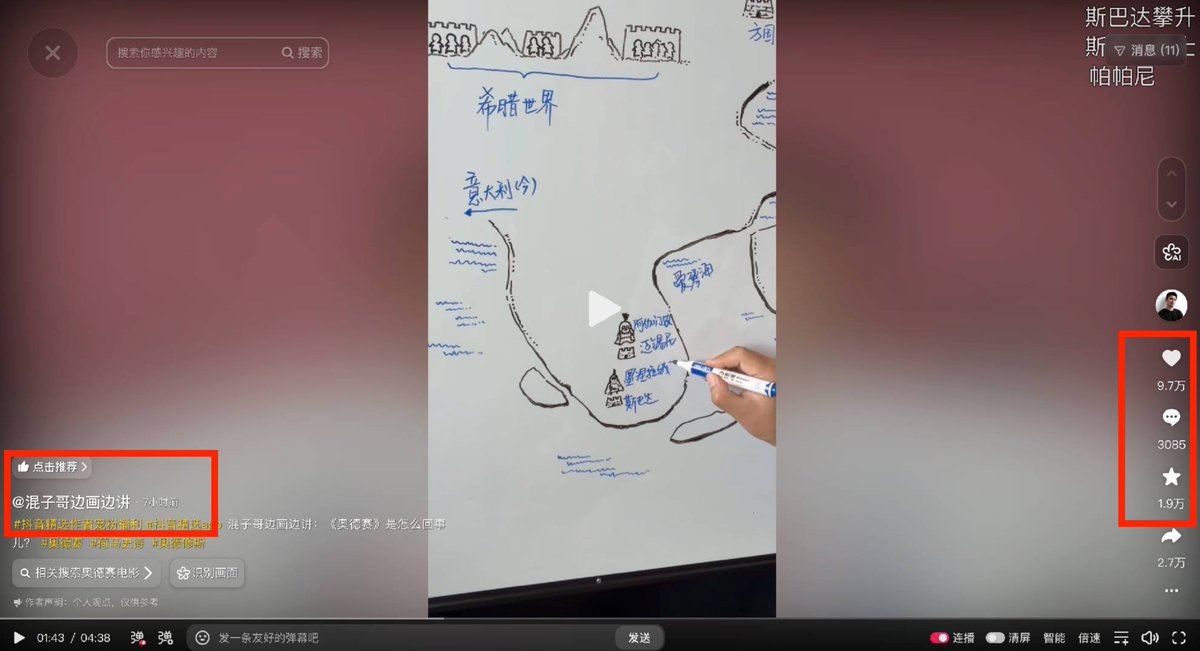
我刚跑完的这条黑板手绘视频有 117 秒、6 幕、23 个独立绘制区。图片和配音的可见 API 调用成本为 0.5-1 元,笔迹、字幕、黑板擦和视频合成都在本地完成。
这里的约 1 元只指本次可见的 API 调用账单。完整成本还包括前期开发调试 skill、人工确认、本地设备、网络和失败调用。这套流程省下的是以后每条视频重复接流程的时间,一处修改只让受影响的文件重跑。
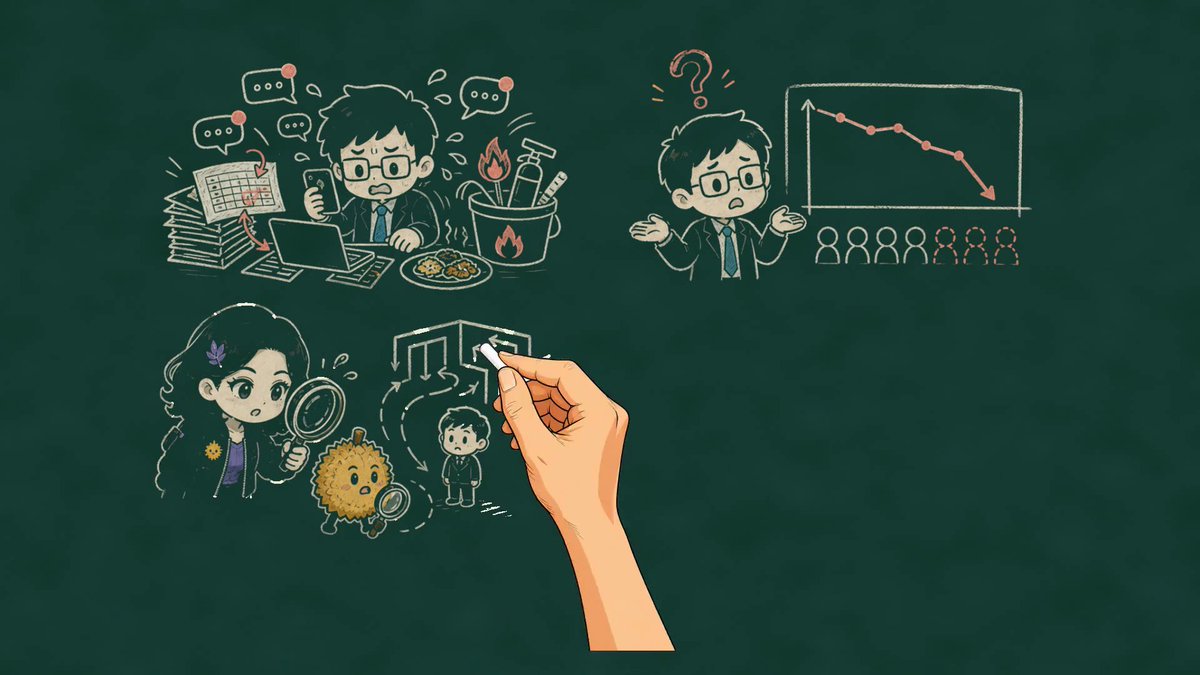
前几天,我围绕白板和黑板连续发了 4 条测试内容。截至 8 月 20 日,它们合计获得 40,070 次曝光和 304 次收藏。
评论区问得最多的是怎么做,以及能不能换成自己的 IP。还有人追着问,两分钟为什么只花约一块钱,这种视频能怎么变现。
这篇就按真实生产顺序往下走。从一个主题到最终视频,我把它拆成 8 步。每一步都能看到输入、生成的文件和确认标准。
先看这套完整流程的骨架
入口、规则、素材和执行代码分别存放,脚本、生图和视频渲染各有边界。
whiteboard-story-video/
├── 流程入口说明
│   └── 用户流程、两次确认和操作边界
├── assets/
│   ├── 项目与脚本模板
│   └── paper-marker、chalkboard 等视觉模板
├── references/
│   └── 脚本方法、项目契约和质量检查
├── scripts/
│   ├── workflow.py
│   └── whiteboard_story/
│       ├── 规划与时间
│       ├── 图片审核与分区
│       ├── 笔迹与逐帧渲染
│       └── 字幕、合成和状态管理
└── tests/
    └── 各阶段的自动检查
所有确定性操作都从 workflow.py 进入。用户只需要理解两次确认,第一次看脚本和配音,第二次看图片和绘制顺序。目录、状态和中间文件由这套完整流程管理。
8 个步骤会用到哪些技术
先把各层分开放在一张表里。后面的 8 个步骤,会把这些技术按实际生产顺序串起来。
| 层级 | 主要技术 | 负责什么 | 运行位置 |
|---|---|---|---|
| 流程与状态 | Python、JSON、workflow.py | 建项目、记录进度、恢复中断任务 | 本地 |
| 脚本与分镜 | 内容模型、场景与元素结构 | 把主题或文稿变成连续口播和可画分幕 | 模型与本地文件 |
| 声音与时间 | TTS、SRT、词级时间 | 生成旁白,并给场景、字幕和清场提供时间 | 联网生成与本地编译 |
| 整幕生图 | 图片模型、角色与风格参考 | 每幕生成一张完整的 16 比 9 板图 | 联网生成 |
| 图片审核 | OpenCV、NumPy、Pillow | 统一底色、检查安全区、生成分区与编号预览 | 本地 |
| 笔迹渲染 | 前景遮罩、骨架细化、八邻接追踪、蛇形填色 | 规划落笔、抬笔、描线和填色 | 本地 |
| 字幕与成片 | ASS 字幕、FFmpeg、H.264、AAC | 合成场景、声音和字幕,并导出 MP4 | 本地 |
| 确认与检查 | 阶段状态、两次确认、validate、自动测试 | 阻断缺文件和失效确认,保留可判断的警告 | 本地 |
第 1 步 建立系列和本期项目
我先把长期资产和单期内容分开。
系列目录保存角色参考图、默认画风和执笔素材。单期目录只保存这一条视频的主题、脚本、声音、图片和成片。换一期内容时,不会复制一套角色;换角色时,也不用改渲染代码。
workbench/
├── series/<series-id>/
│   ├── series.json
│   └── characters/<character-id>/references/
└── episodes/<episode-id>/
    ├── project.json
    ├── state.json
    ├── input/
    ├── build/
    └── deliverables/
project.json 记录用户想做什么,state.json 记录机器已经做到哪一步。新项目从 init 开始;重新接手一条做到一半的视频,我先运行 status,流程会直接告诉我下一步该生成图片、等确认,还是继续渲染。
后面 8 个步骤各放一段最小代码,只展示输入输出和通用关系。路径规划、阈值和服务参数都继续省略。新建项目后立即读取状态,最小命令如下。
python workflow.py init \
  --workbench ./workbench \
  --episode demo-video \
  --title "这一期的主题"

python workflow.py status \
  --episode-dir ./workbench/episodes/demo-video
这一层解决的是复用。角色属于系列,故事属于本期,纸张和笔属于模板,核心程序不认识任何固定 IP 名称。
第 2 步 把主题写成能连续听懂的脚本
输入可以是一个主题、一篇现成文稿,也可以是 SRT。
我会先写完整口播,再拆幕。先拆成六页提纲、再给每页补一段话,听起来很容易断。完整口播能连续读通以后,才按照人物动作、因果变化和画面切换拆成场景。
这次黑板视频的口播共有 608 个字符,最后拆成 6 幕。脚本内部保留的是这种关系。
script
└── scenes[]
    ├── 本幕开始和结束时间
    ├── 本幕口播
    ├── 出场角色
    └── elements[]
        ├── 可画的对象或动作
        └── 稳定的绘制顺序
把这棵关系写成一条最小场景记录,大概是下面这种形状。数组里的先后就是绘制顺序,示意文字不属于本次真实脚本。
scene = dict(
    id="scene-03",
    narration="这一幕对应的完整口播",
    characters=["host"],
    elements=[
        dict(id="cause", description="画出原因"),
        dict(id="result", description="画出结果"),
    ],
)
elements 直接写可画的对象和动作,例如人物抬头、文件堆起来、箭头指向结果。数组顺序就是后面的 1、2、3 号绘制区,程序不会根据画面坐标重新猜一遍。
每幕通常放 3 到 4 个元素。这次 6 幕最终得到 23 个绘制区,平均每幕接近 4 个。
第 3 步 先生成声音,再编译整条时间线
脚本定下来以后,我用 voice 生成旁白和词级时间;用户已有音频和字幕时,改用 attach-audio 接入。
声音会产出三类时间文件。
input/
├── narration.mp3
├── captions.srt
└── words.json
SRT 负责句子边界,words.json 保存词级时间。场景开始、区域出现、逐字字幕和清场动作都从这份时间里计算。
用 Python 读取 words.json 后,每个词只保留文本和起止毫秒。下面这段只计算一个词的真实发音时长。
words = load_json("input/words.json")["words"]
word = words[0]
start_ms = int(word["start_ms"])
end_ms = int(word["end_ms"])
duration_ms = end_ms - start_ms
字符数只能粗略估时。中文短词可能读得很慢,一串数字也可能比同样字数花更久。用真实语音边界以后,口播改动会重新生成所有派生时间,字幕和手绘不会各守着一套旧秒数。
这时进行第一次确认。用户会看到完整口播、配音试听、开场短标题、视觉模板、角色分工和每幕准备画什么。脚本确认之前不生图。确认后又改了口播或角色,这一阶段会重新失效,后面的旧图不会被误当成新版本继续使用。
第 4 步 每幕只生成一张完整白板图
脚本通过以后,完整流程会为每一幕准备一张 16 比 9 分镜。
每张图内部已经规划好 3 到 4 个互不连接的叙事区。人物、道具、箭头和地面线不能跨区,区与区之间留出抬笔移动的空白。角色参考图从系列目录读取,本期风格和单幕要求再逐层覆盖。
这次正式版本由 6 张完整图片组成,每幕只保留一张。分别生成人物、道具和箭头会增加调用次数,拼接后也更容易出现线宽、纸色和角色造型不一致。
prepare-images 先把分幕脚本编成逐幕生图清单,generate-images 再按清单生成图片。这个阶段留下三类文件。
build/
├── image-prompts.json
├── raw-boards/
└── boards/
生图清单在这里只暴露场景编号、元素数量和目标文件。完整提示词、角色参考图和服务参数不放进这段示意代码。
boards = [
    dict(
        scene_id=scene["id"],
        element_count=len(scene["elements"]),
        expected_file=f'build/boards/{scene["id"]}.png',
    )
    for scene in script["scenes"]
]
assert len(boards) == len(script["scenes"])
raw-boards 保存原始生成图,boards 保存统一底色和安全区后的正式板图。重复审核始终从原图重新计算,纸色不会因为多处理几次越变越脏。
第 5 步 检查安全区、分区和绘制顺序
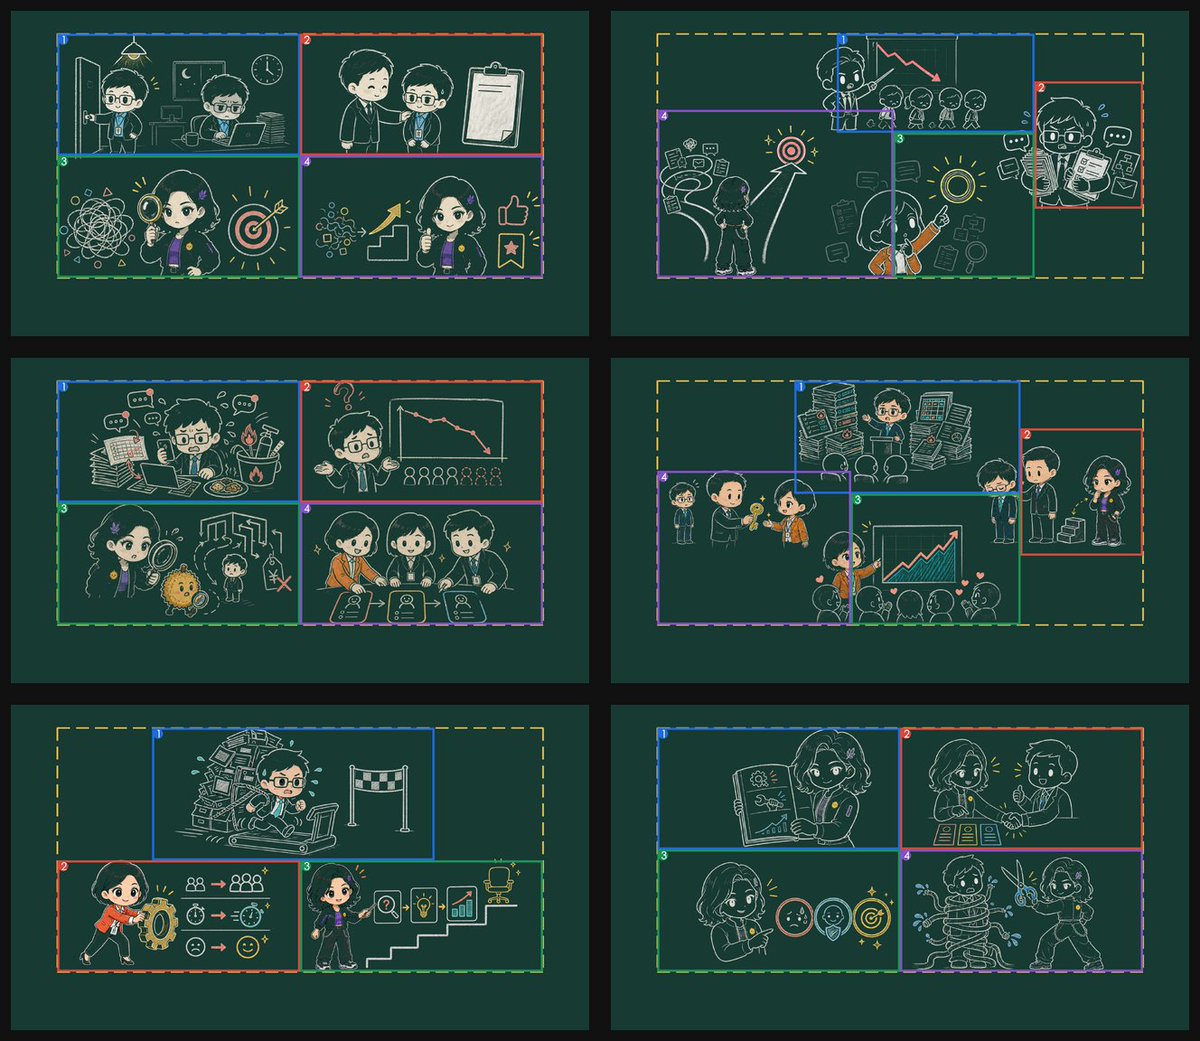
图片出来以后,我运行 review-images。流程会统一纸面或黑板底色,再检查发布安全区;主体越界时,程序对整张构图做等比缩小或平移,不会只裁掉人物的一只手。
随后生成编号预览和每幕标注。
build/
├── annotations/
│   └── scene-xx.annotation.json
└── review/
    ├── scene-xx-preview.png
    └── index.html
标注里保存画布、场景时长和元素列表。每个元素至少有绘制编号、区域范围和显露时间。矩形圈不准三角形或错位构图时,也可以用多边形区域。
当前区域允许恢复的像素遵守一条公开规则。
本区有效像素
= 本区范围 ∩ 当前有效前景
- 所有后续区域
- 明确保护区
把上面的集合关系翻成布尔运算,得到的 allowed 只会显露当前区域。
allowed = region_mask.astype(bool) & foreground_mask.astype(bool)
allowed &= ~later_regions_mask.astype(bool)
allowed &= ~protected_regions_mask.astype(bool)

reveal = blank.copy()
reveal[allowed] = board[allowed]
这条遮罩会先扣掉后续人物和道具。第 1 区的外接范围即使碰到第 2 区,也不会提前露出半张脸。
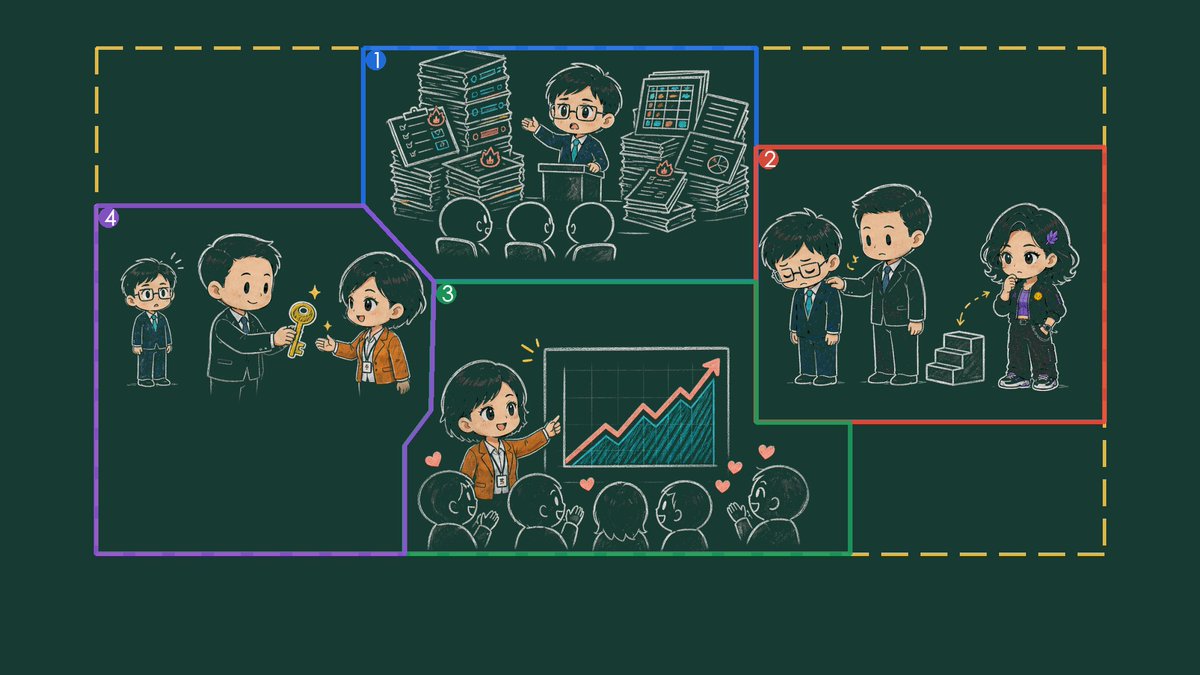
我会实际查看原图和编号预览,再进行第二次确认。黄色虚线只存在于审核图,数字就是正式绘制顺序。
这次项目的第 5 幕就在这里退回过。第一版配角穿得太随意,和其他职场人物不在一个体系。我只重做第 5 幕,再检查这一幕的区域。前面的脚本、配音和另外 5 张图都保留。
到了笔迹这一步,有六种做法
调研了一些开源项目和技术博客的思路,大概有下面的几个思路方案在用:
方案1:整图逐块显露会先把图片二值化,再切成很多小块。程序每次访问最近的含墨小块,经过哪里就恢复哪里的像素。它对图片要求低,开发也快;块太大时像马赛克,块太小时路径和渲染量会迅速增加。
方案2:对象分割会先找出人物、道具和背景,再给每个对象一张遮罩。故事可以按对象顺序出现,复杂插画更容易讲清。遮挡关系和重叠遮罩会增加处理成本,对象内部的笔该怎样走仍需另一层算法。
方案3:SVG 路径动画直接读取每条路径的长度,再把描边偏移从总长度降到零。图标、公式和流程图会画得很干净。普通 PNG 转成 SVG 后常得到墨线外轮廓,一根线可能被绕着画两遍,填色也要另做。有些项目还用到了 remotion 渲染
方案4:中心线骨架会把有宽度的线压成一像素宽,再沿端点、普通点和交叉点追成笔画。它最适合干净线稿,笔尖也更容易贴线。噪点、阴影和大色块会产生碎笔或错误分叉。
方案5:程序化手绘图元从线、圆、曲线和多边形直接开始,控制点加少量随机偏移,填充使用排线或点阵。程序从一开始就知道笔顺,图表和示意图很好改;人物和复杂 IP 需要额外的矢量资产。
方案6:视频模型可以直接生成手拿笔绘制的短镜头,纸张和手部运动很自然。镜头一长,笔尖错位、人物变形、首尾不一致和失败重试会一起增加。
| 方案 | 更适合的输入 | 笔尖贴线 | 主要代价 |
|---|---|---|---|
| 整图逐块显露 | 任意位图、快速原型 | 较弱 | 块状感、乱序和假连线 |
| 对象分割 | 人物与道具边界清楚的插画 | 中等 | 分割成本和遮挡处理 |
| SVG 路径 | 单线矢量、图标、公式 | 很强 | 素材准备和填色 |
| 中心线骨架 | 干净线稿、粉笔画 | 很强 | 噪点、交叉和粗色块 |
| 程序化图元 | 图表、箭头、几何示意 | 很强 | 复杂角色资产成本高 |
| 视频模型 | 几秒钟的气氛镜头 | 不稳定 | 一致性、重试和调用成本 |
| 当前混合方案 | 可换 IP 的长内容 | 很强 | 前期系统工程较多 |
我当前使用的是混合方案。模型处理内容理解和整幕画面,本地程序处理分区、路径、字幕、清场和编码。
第 6 步 把静态像素追成一条条笔画
确认图片以后,我运行 render,本地渲染才开始。
这一步没有新的模型调用。
程序把板图和空模板做差,变化过的像素成为前景候选。白纸模板寻找浅底上的深线,黑板模板寻找深底上的浅线。换成黑板时,背景颜色和前景提取方法要一起变。
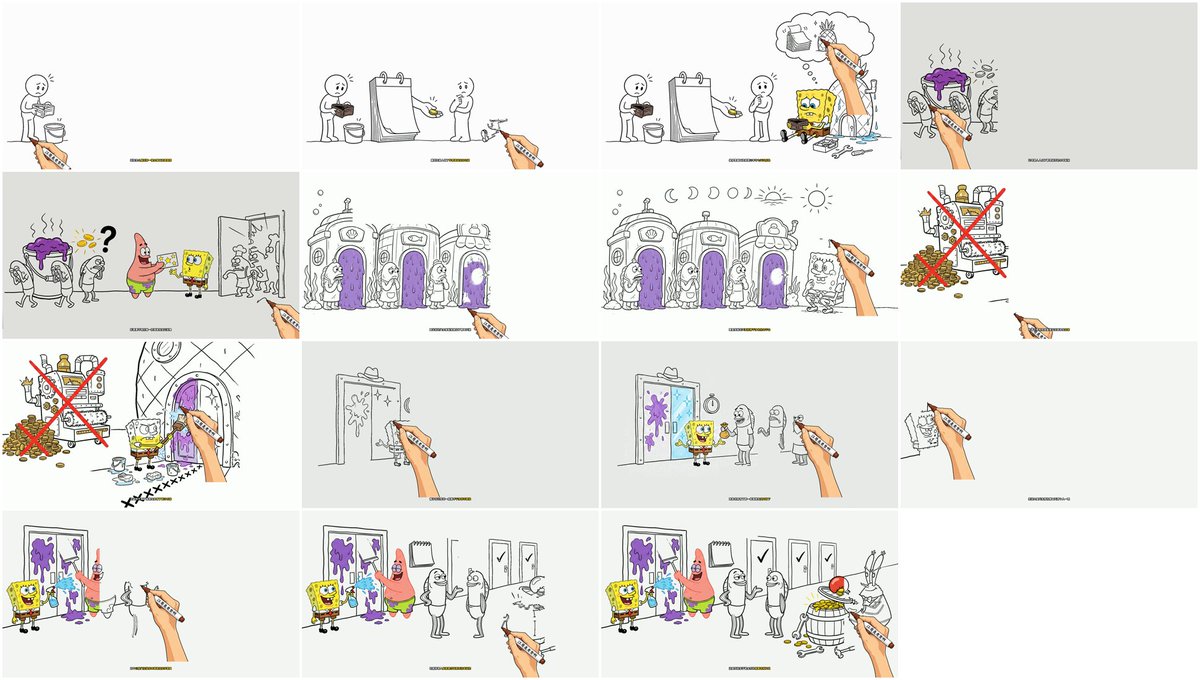
每个绘制区随后经过六道处理。
-
当前区域和前景遮罩相交,并扣掉后续区域。
-
线条候选被细化成一像素宽的骨架。
-
程序按八个方向寻找邻居,记录端点和交叉点。
-
未访问的边被追成独立笔画,分叉处优先选择方向变化较小的边。
-
笔画经过重采样和平滑,再吸附回有效墨线。
-
相近笔画归到同一对象,组内选择移动距离较短的下一笔。
把六道处理压成通用伪代码,数据会从静态像素一直变成带抬笔状态的运动序列。
foreground = extract_foreground(board, blank)
skeleton = thin_to_centerline(foreground)
strokes = trace_unvisited_edges(skeleton)
strokes = smooth_and_snap(strokes, foreground)
motion = insert_pen_up_moves(strokes)
最终图片没有保存原画师的真实笔顺,这里得到的是一条看起来合理、可以重复执行的路径。
两个对象之间还要插入抬笔状态。手部素材可以从人物眼睛移动到右侧图表,移动期间只更新手的位置,不更新笔迹遮罩。少了这个状态,再好的最近邻排序也会在两个对象之间画出一条假线。
第 7 步 描线、填色和清场分别渲染
线稿中心适合安排笔尖,不适合填满衣服和大色块。我把每个区域拆成描线和填色两段。
描线阶段沿中心线恢复轮廓。填色阶段在连通色块里生成蛇形路线,横向走完一行,下一行反向回来。填色笔刷更宽,只恢复当前区域内原图已有的颜色,程序不会重新猜人物颜色。
一段路径总长度为 L,分给它的时间为 T,平均绘制速度约为 L/T。同样 5 秒,人物半身像和密集流程图的路径长度差很多。画面太密时,程序可以减少采样,构图仍然要主动减对象、拆幕或延长口播。
描线和填色不使用固定秒数。下面的分配只看两段路径各自占了多少长度。
drawing_ms = max(0, scene_ms - clear_ms)
total_length = max(1, outline_length + fill_length)
outline_ms = round(drawing_ms * outline_length / total_length)
fill_ms = drawing_ms - outline_ms

outline_video = render_paths(outline, outline_ms)
fill_video = render_fill(fill_mask, fill_ms)
scene_video = concat(outline_video, fill_video, clear_action)
开场中文标题由本地字体生成准确字形。程序先描字形边缘,再在内部填色,图片模型不用承担正式中文文字。
纸张模板在非末页翻页,黑板模板让同一只手换成黑板擦。清场动作占用场景末尾已有的时间,最后一幕保留完整结论。每幕完成后先输出一段无声场景视频,统一放进 build/scenes。
第 8 步 合成字幕、声音并验收成片
所有场景准备好以后,本地合成器加入旁白、字幕和可选音乐,再输出 deliverables/final.mp4。
合成层使用的是常见视频命令。下面的示意省略了字幕样式、音量混音和音效延迟参数。
ffmpeg -f concat -safe 0 -i scenes.txt \
  -i narration.mp3 \
  -vf "subtitles=captions.ass" \
  -vcodec libx264 -acodec aac \
  -movflags +faststart -shortest final.mp4
逐字字幕直接读取 words.json。当前读到的字单独高亮,未读部分保持普通颜色。只有分句 SRT 时,系统会使用整句字幕,不会伪造不存在的词级边界。
最后运行 validate。它只拦无法交付的问题,例如视频轨缺失、配置了声音却没有音频轨、图片损坏、区域越界或确认后的文件已经变化;构图略挤、节奏略快这类问题保留为警告,由人决定要不要再改。
这次成片实测为 H.264、1920×1080、30fps、117.17 秒,带 AAC 单声道音轨。
图片和配音产生了本次可见的 API 调用。前景提取、骨架细化、路径追踪、抬笔、填色、字幕、标题、黑板擦、音效和视频编码都在本地运行,所以当前口径约 1 元。模型价格和计费方式会变,人工修改、本地设备、网络和失败调用也会改变实际总成本。
8 个步骤放在一张表里
前面讲的是每一步怎样工作。实际执行时,可以用下面这张表检查当前输入、动作和产物。
| 步骤 | 输入 | 主要动作 | 产物与确认点 |
|---|---|---|---|
| 1 建立系列和项目 | IP 参考、主题和模板选择 | 用 init 建项目,用 add-character 保存参考图,再用 status 读取进度 | project.json、state.json |
| 2 写连续脚本 | 主题、文稿或 SRT | 先写完整口播,再拆成场景、角色和绘制元素 | input/script.json |
| 3 生成声音与时间 | 脚本或已有音频 | 用 voice 或 attach-audio 得到真实时间 | narration.mp3、captions.srt、words.json;第一次确认 |
| 4 生成整幕板图 | 已确认脚本、角色和风格参考 | 准备生图清单,每幕生成一张完整图片 | image-prompts.json、raw-boards、boards |
| 5 审核图片与分区 | 正式板图和安全区 | 统一底色、调整构图、标注区域和绘制编号 | annotations、review;第二次确认 |
| 6 追踪笔画 | 已确认板图和标注 | 提取前景、细化骨架、追踪路径并插入抬笔 | 渲染器内的笔画与抬笔序列 |
| 7 渲染每一幕 | 笔画、模板和场景时间 | 描线、蛇形填色、绘制标题,再翻页或擦除 | build/scenes/*.mp4 |
| 8 合成并验收 | 场景视频、旁白和词级时间 | 加字幕与声音,用 FFmpeg 合成,再运行 validate | deliverables/final.mp4 |
改一处以后,系统从哪里重跑
input 保存已经确认的内容,build 保存可以重新生成的中间产物,deliverables 只放最终交付。这三层分开以后,返工范围可以沿着依赖关系往后走。
| 改了什么 | 重新生成什么 | 可以保留什么 |
|---|---|---|
| 口播含义或时长 | 配音、时间和受影响画面 | 系列角色与模板 |
| 某一幕图片 | 这一幕的标注、审核和渲染 | 脚本、配音和其他幕 |
| 某个绘制区 | 这一幕的笔迹渲染 | 原图和其他幕 |
| 字幕样式 | 最终合成 | 场景视频 |
| 手部或黑板擦素材 | 受影响的视觉片段 | 脚本和板图 |
API 账单很低,人工每次仍从头来一遍,整条生产线依然昂贵。state.json 和两次确认会让系统知道哪些结果还能用。
换主题、角色和画风时改哪里
这套结构把四类变化放在不同位置。
| 想改变什么 | 调整位置 |
|---|---|
| 新主题或新故事 | 新建一期 episode |
| 新角色或角色参考图 | 更新 series |
| 纸张、黑板、画笔和清场方式 | 新增或调整 template |
| 配音或生图实现 | 更换对应适配层 |
核心代码只接收这些分层数据。换角色时更新系列,换纸面时更新模板,故事脚本和渲染器都不用复制。
评论区追问最多的四件事,现在可以说透了
到底怎么做?
准备一个主题和几张 IP 参考图,先建项目,再按脚本、配音、整幕板图、分区标注、笔画追踪、逐幕渲染和成片验收的顺序往下走。人只需要在两个地方拍板,先确认脚本和声音,再确认图片与绘制顺序。后面的描线、填色、字幕、清场和合成由程序重复执行。
能不能换成自己的 IP?
可以直接换。角色参考图、声音和纸面风格都单独保存。换角色时更新参考图,换主题时新建一期,渲染程序不用跟着重写。同一个人物可以连续讲职场、科普、商业或生活故事,慢慢形成自己的系列。
两分钟为什么约一块钱?
因为这次只有图片和配音产生了可见的 API 调用。前景提取、笔画追踪、抬笔、填色、逐字字幕、黑板擦和视频编码都在本地运行。本次 117 秒成片的可见 API 账单约为 0.5 到 1 元。这个数字只代表本次调用,完整成本还包括前期开发、人工确认、本地设备、网络和失败重试。
这种视频怎么变现?
普通人可以用它持续发布垂直内容吸引客户,也可以接品牌合作、卖知识产品,或者替客户定制视频。最后能不能赚到钱,仍取决于选题、内容质量、更新频率和后续怎么接住观众,自动化不会替任何人保证流量和收入。
但是可以让你有更多的精力去思考后链路的问题,至少在入门的流量这一层可以保证你快速产出高质量的内容。
超级博主已经跑通,自动化让普通人也能快速复刻,保证内容质量和成本可控
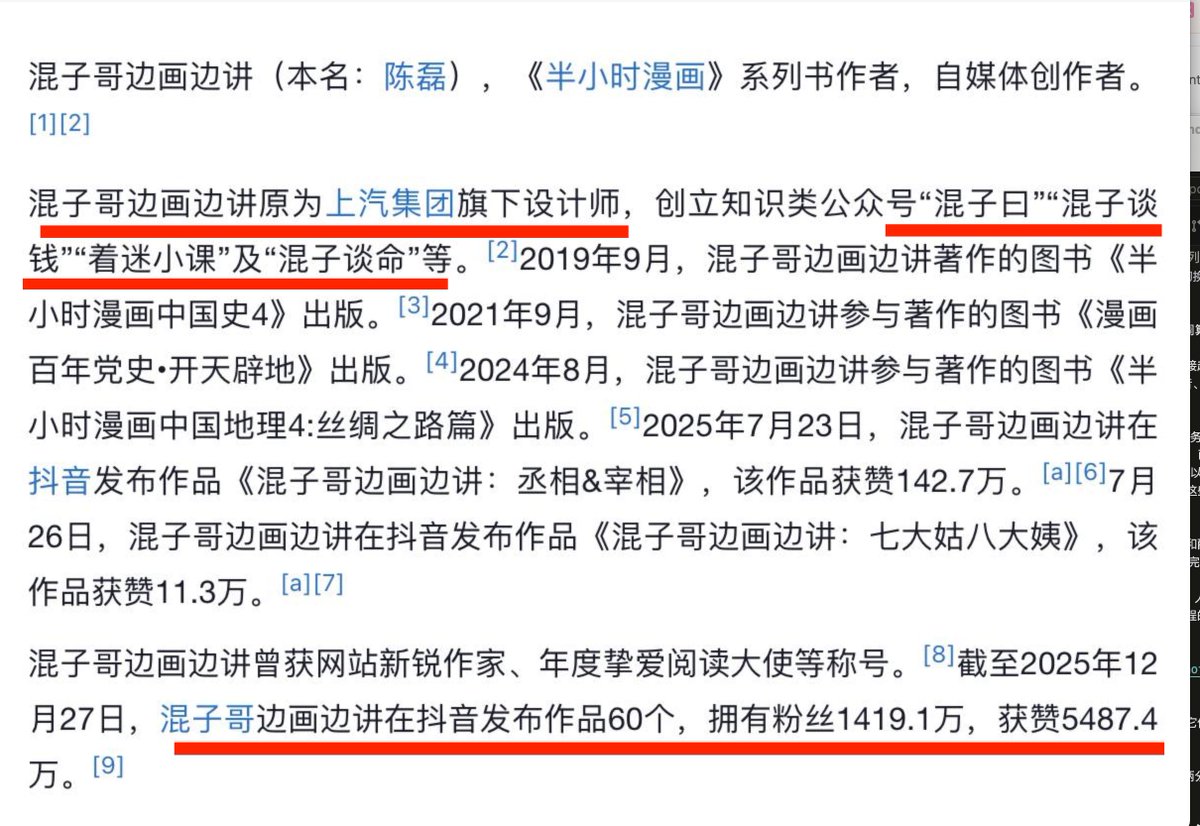
这类手绘叙事已经有超级博主跑通,说明这种内容既能长期更新,也有机会变成生意。普通人以前很难照着做,主要卡在制作时间和返工成本。
以前做完一条,下一条还要重新对脚本、配音、画面和时间。现在换主题、换 IP 或改一幕,只重跑受影响的部分。一个人也可以先做第一条,看完播、收藏和咨询,再决定下一条讲什么。自动化降低的是开始、返工和持续更新的门槛。
先做第一条。选一个你最想讲的主题,换上自己的 IP,把它从脚本确认跑到成片。做完这一条,角色、模板和已经确认的流程都能留给下一条继续使用。


