
AI 数字人网球教练带完一节 15 分钟网球课,开源可灵3.0数字人、真人动作复现、课程编排和语音指导全流程
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
运动训练产品最难规模化的不是播放器,而是足够大、风格统一、能反复编排的动作库。内容拍摄成本就是动作库的生产成本。
我把从真人动作参考、数字人制作到课程和语音编排的完整流程开源了:$ai-sports-coach Skill、素材预检和 Kling Motion Control 操作包,以及真实的动作、课程与语音示例:
https://github.com/zhenzoo/ai-sports-coach
安装后可以直接对 Agent 说:
Use the ai-sports-coach Skill to inspect my project, prepare Kling Motion Control generation packets, and stop before any paid generation.
真实 App 跟练:Da‑Yul 从动作示范、语音指导到计数和课程进度完整运行
无论是健身、网球、篮球、足球,还是体能训练、功能性训练、舞蹈和瑜伽,传统做法都绕不开真人拍摄:请教练或模特逐条演示,租场地、搭景、打灯、架机位,再录制、剪辑、配音。对一条宣传片,这套流程没有问题;但如果产品需要几百、上千个动作,每增加一个动作、一个角度或一次课程改版,都要重新协调人物、档期、场地、服装、灯光和后期。对小团队来说,产品很可能还没上线,预算和时间先被动作库吃完了。
另一种办法是直接使用网络上的真人跟练视频。YouTube、Bilibili、小红书和抖音上确实有海量、而且动作质量很高的参考素材,但它们通常不是为你的产品拍的:背景杂乱,镜头比例和机位不断变化,教练、服装和画质不统一,还可能带字幕、水印、环境噪音和别人的品牌元素。它们可以帮助确认动作,却很难原样拼成一套有自己品牌调性的课程;公开能看到,也不等于可以跳过来源和授权核对直接商用。
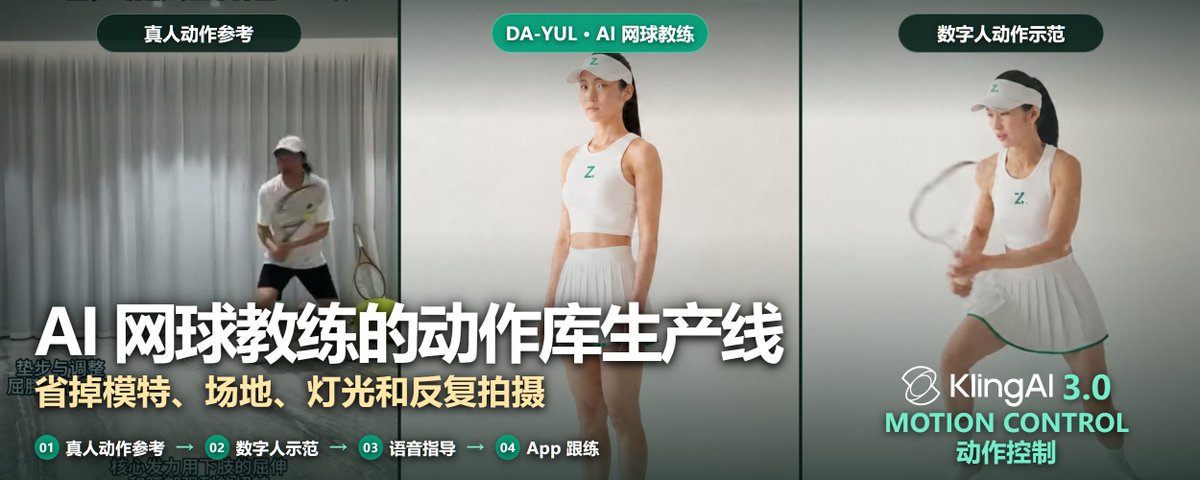
所以我想做的不是“不要真人”,也不是让 AI 凭一段文字凭空发明网球动作,而是走第三条路:真人视频提供动作轨迹,固定数字人负责统一交付。 把网络上零散但有价值的动作参考,经过切片、动作控制和人工 QA,转换成同一个教练、同一套服装、同一个摄影棚和同一种镜头语言的动作资产;再把这些资产按 ID 写进动作库,编排成课程,并把指导、纠错、鼓励、倒计时和进度语音放到正确的时间点。
这样改变的不是“视频看起来更像 AI 还是更像真人”,而是训练内容的生产方式:
-
真人动作仍然是运动轨迹的依据,不靠 prompt 猜动作;
-
同一个数字人统一角色、背景、服装、镜头和品牌视觉;
-
每条动作都能带着来源、prompt、模型和 QA 状态进入动作库,跨课程复用;
-
动作视频、课程结构和语音彼此分离,改一句指导不需要重做视频;
-
已通过 QA 的数字人动作可以先上线,未通过的继续回退真人参考,不必等整座动作库一次做完;
-
模特、场地和拍摄不再随每个新增动作重复投入,内容的边际生产成本因此显著下降。
现在,这条路线已经不只是一张对比图。Da‑Yul 已经能带完一节 10 分 35 秒的网球课:20 个动作、42 个步骤、198 条语音事件、418 个音效事件。她从热身进入正反手主训,再带到拉伸;动作开始前讲站位和准备姿势,训练中提醒发力、呼吸与节奏,结束前倒计时并切到下一项。
画面负责把动作做对,语音负责把用户带完。
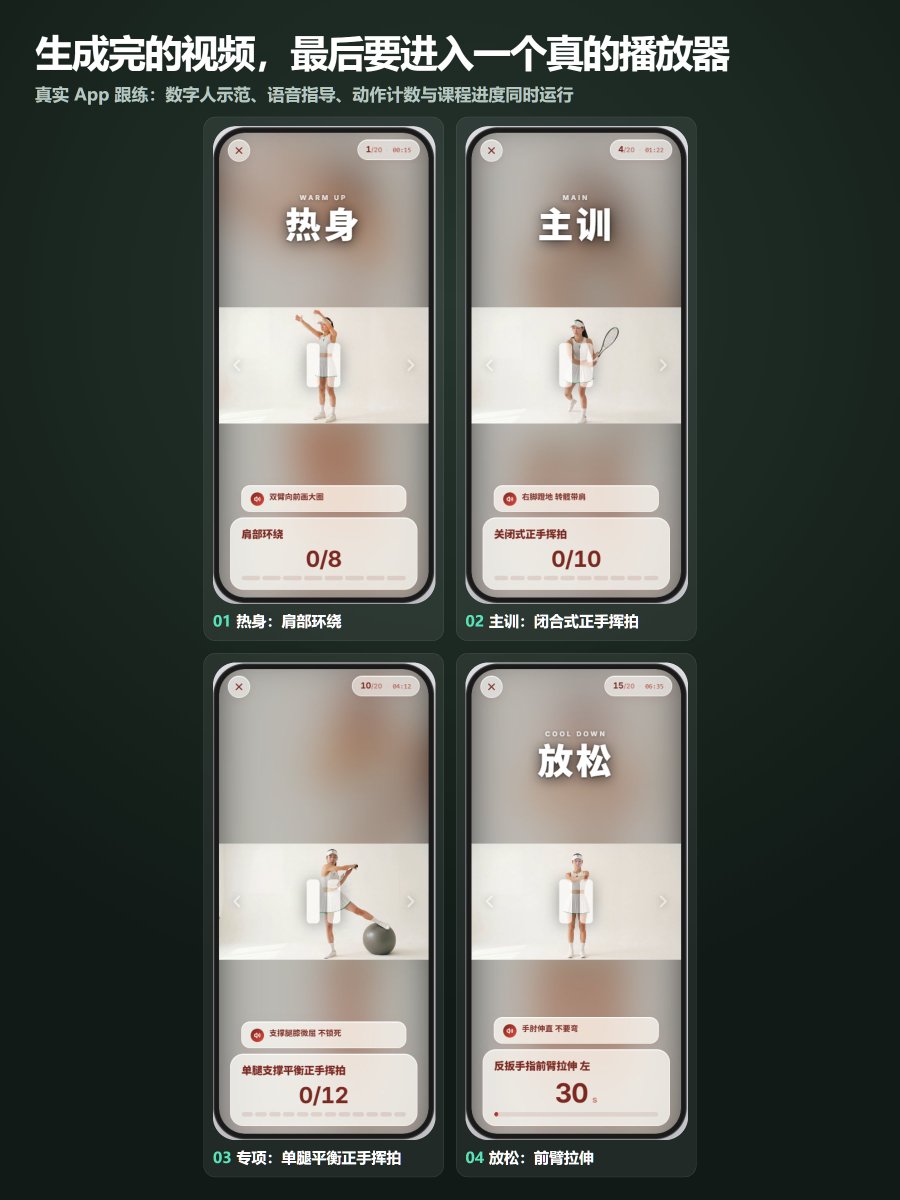
真实 App 跟练画面:数字人示范、语音指导、动作计数与课程进度同时工作
为了做到这一步,我把从动作参考到 App 跟练的完整生产线拆成八步:
课程与动作清单 → 动作源采集和单动作切片 → Character Bible → Kling 3.0 Motion Control → 人工 QA → ActionLib 动作库 → 课程时间轴 → 语音编排与播放器。
这条管线目前跑出了 21 条可入库视频:4 条热身、11 条网球专项、6 条拉伸放松,其中 20 个动作进入了这节课。它还没有完整集成进 iOS,但已经不是一条循环播放的 Demo,而是一套可以继续扩动作、排课程、改语音的跟练原型。
下面我把每一步为什么这么做、实际怎么做,以及哪些地方仍然会失败,完整拆开。
第一件事不是写 prompt,而是把动作源找对
这批网球专项动作,我主要从小红书找;一部分通用体能、热身和拉伸动作也会从 YouTube 找。选择动作源时,我关心的不是视频有多火,而是它能不能作为 Motion Control 的“动作底稿”。
我现在会优先选这些素材:
-
单人、全身完整入镜,手脚不要频繁出画;
-
一个片段只做一个动作,不要中途切镜头;
-
机位固定,身体不要被桌椅、字幕或其他人遮住;
-
动作有清楚的开始、发力、结束,节奏不要忽快忽慢;
-
球拍、网球、瑜伽球等关键道具尽量清楚;
-
片段最好落在 3–30 秒,足够看完一轮,又不塞进多余内容。
这次最完整的一条网球原片长 118.654 秒,里面连续演示了 11 个动作。我没有做自动切片,而是用 Bandicut 手动找每个动作的起止点,切成 11 条 6.733–10.6 秒的 mp4。
我后来把 Downloads 里的 11 个中文文件名分段,和 Yox 仓库中重命名后的 11 个真人参考视频逐个做了 SHA‑256 对比。11 组全部完全一致。这条证据链可以一路从原始长视频、Bandicut 分段,追到动作库里的 video_url。
这里也有一个需要诚实记录的缺口:这条原片对应的小红书帖子 URL 没有写进 JSON,下载文件的来源信息只保留了当时使用的下载工具页面,没有找回原帖链接。现在能确认的是本地原片、下载时间、11 个分段和仓库副本;从下一批开始,原帖 URL 必须在下载当时就写进来源账本。
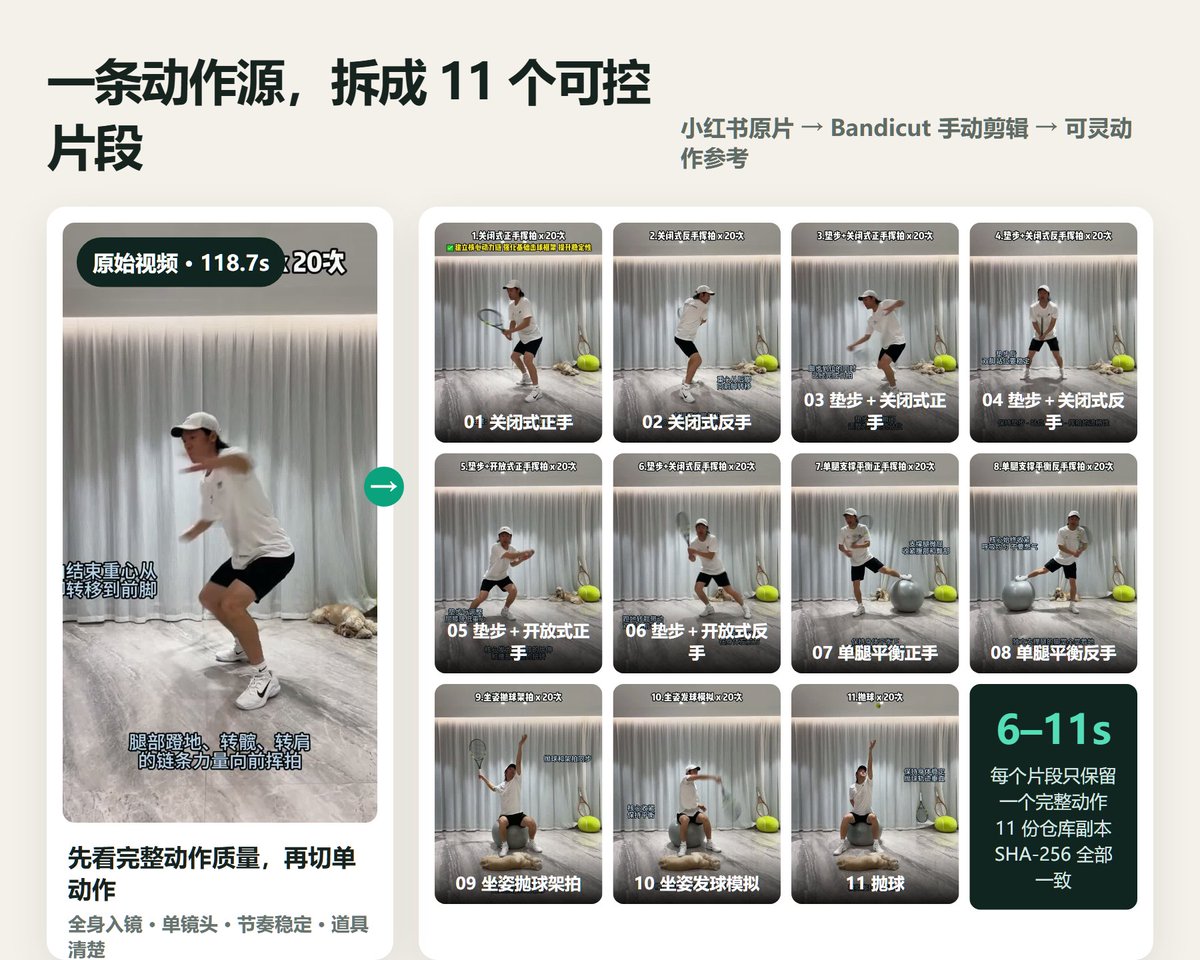
一条 118.7 秒动作源,经 Bandicut 手动拆成 11 个可控片段
为什么这里我还是坚持手动剪?因为 Motion Control 对边界很敏感。开头多留一个人走进机位,结尾多留一次转身,模型都有可能把它当成动作的一部分。对几十条素材,人工多看几秒,比后面反复重跑更省。
当然,“公开能看到”不等于“可以随便商用”。我会把原始页面、下载日期、作者、用途和授权状态做成来源账本。自有数字人解决的是画面主体的一致性,不会自动替动作源、Logo 或真人音色解决权利问题。这里说的是我的生产流程,不是法律意见;正式上线仍要逐项核对授权与平台条款。
形象一致不是运气,是一套锚定资产
AI 视频最容易让用户出戏的,不一定是某一帧手指不完美,而是同一个人这条视频和下一条视频长得不一样。
所以 Da‑Yul 不是一张漂亮正脸。她有横屏和竖屏两套 anchor,还有转身多视角、头部多视角、服装细节和动作演示四类 Character Bible 资产。
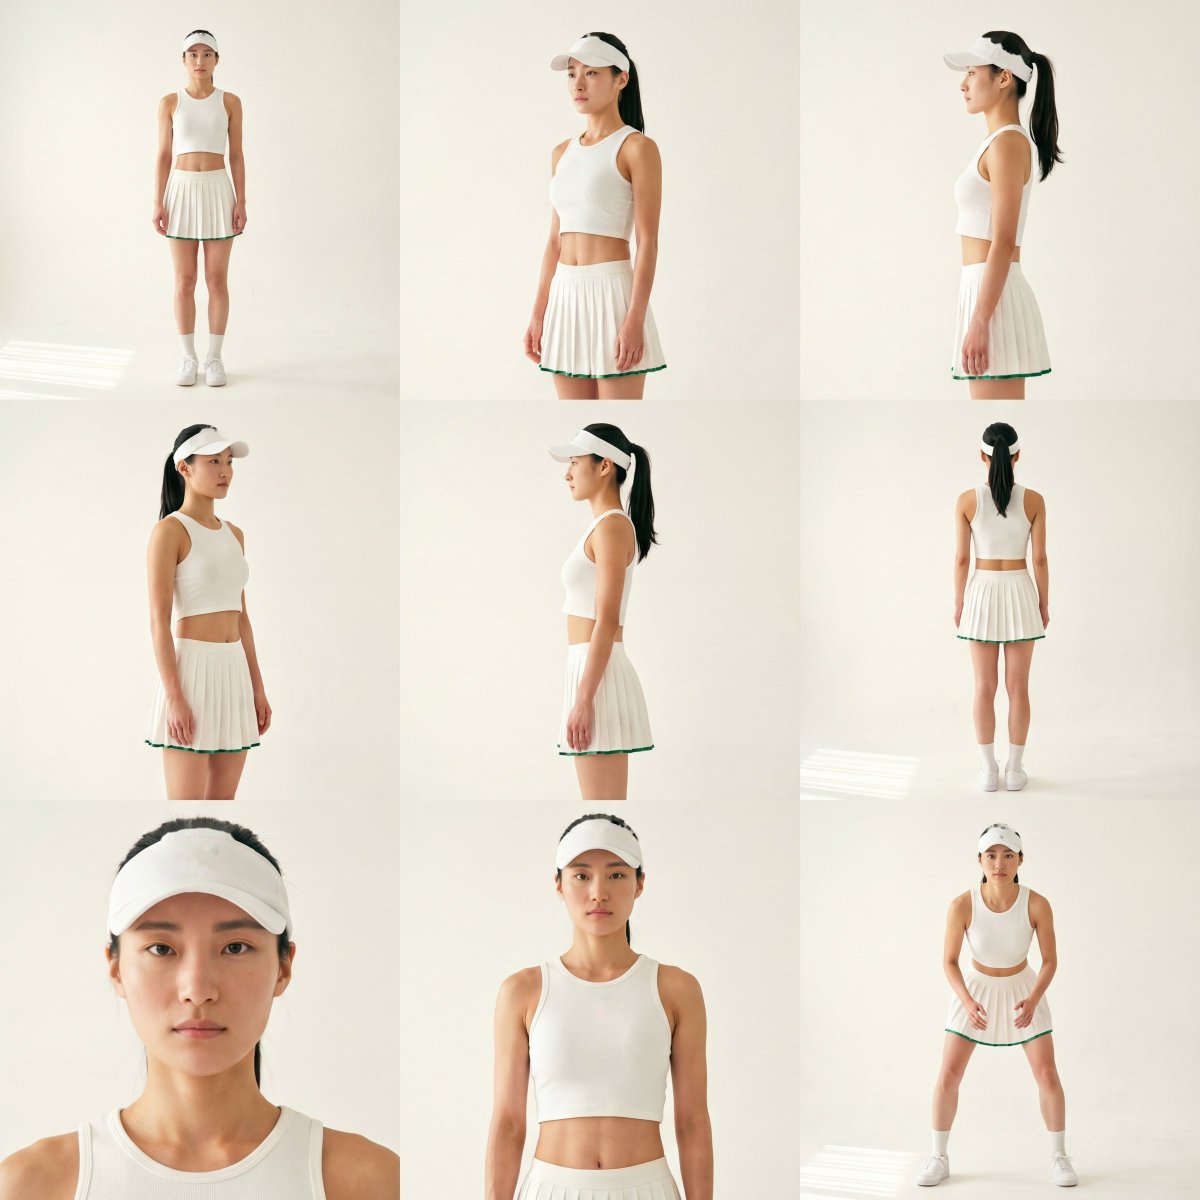
Da‑Yul 转身多视角:正面、侧面、背面和 45° 都有独立参考
头部表单独处理身份。正脸、两侧 45°、90°、背面和后侧视角越清楚,视频转头时越不容易突然换脸。
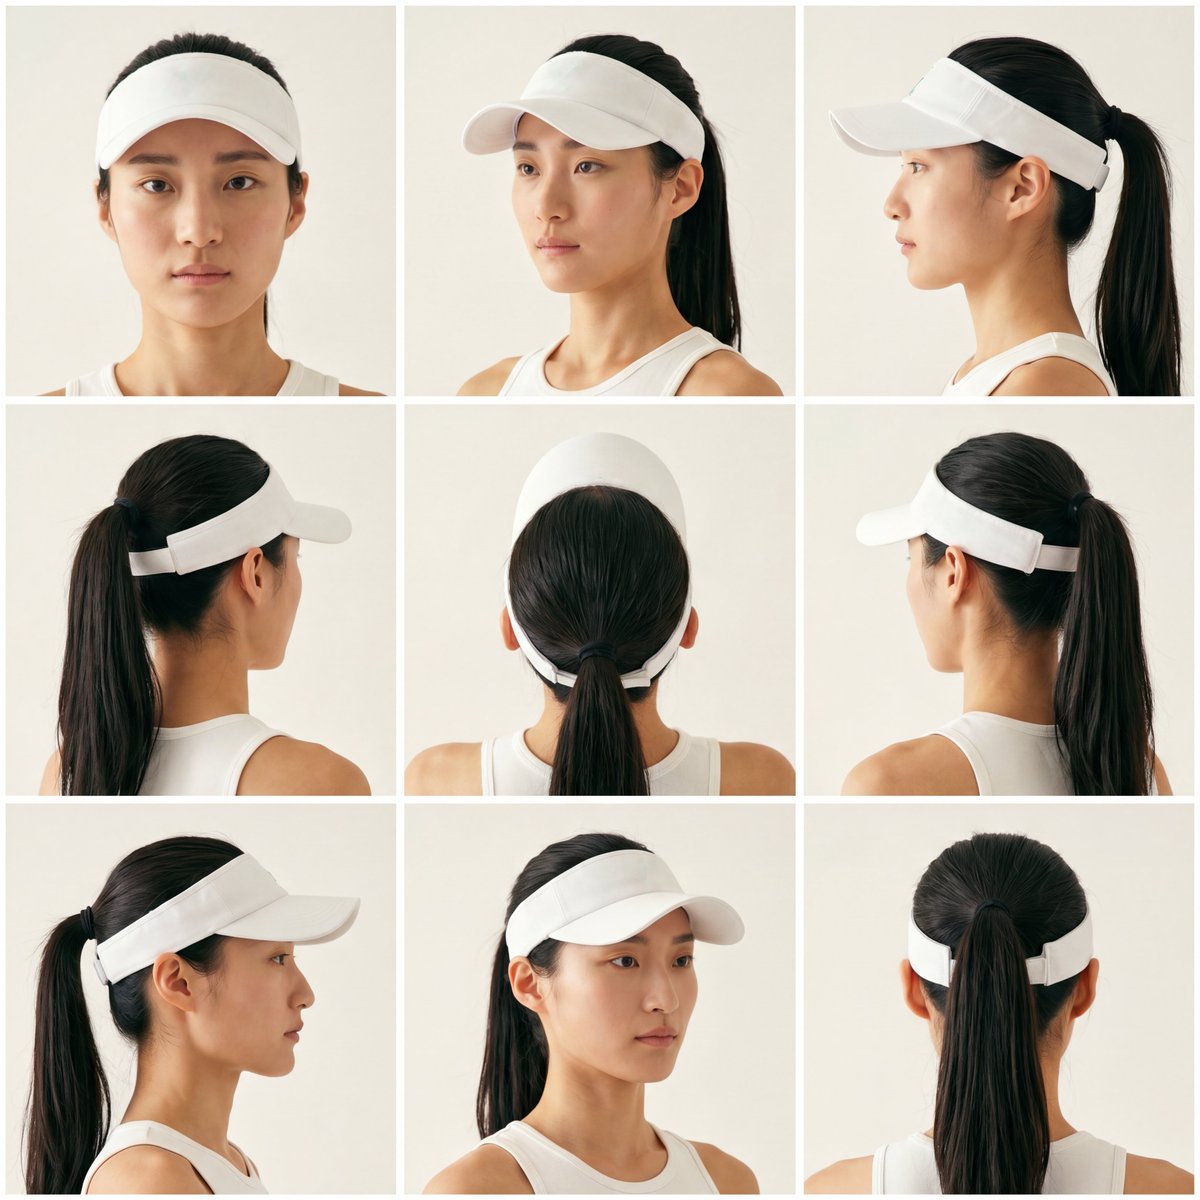
头部九视角:给正脸、侧脸和转头过程提供身份锚点
服装表则锁住白色上衣、百褶裙、绿色包边、遮阳帽、鞋袜和面料细节。它不是时尚 moodboard,而是防止这条裙子三层、下一条五层,装饰位置和颜色也跟着漂移。
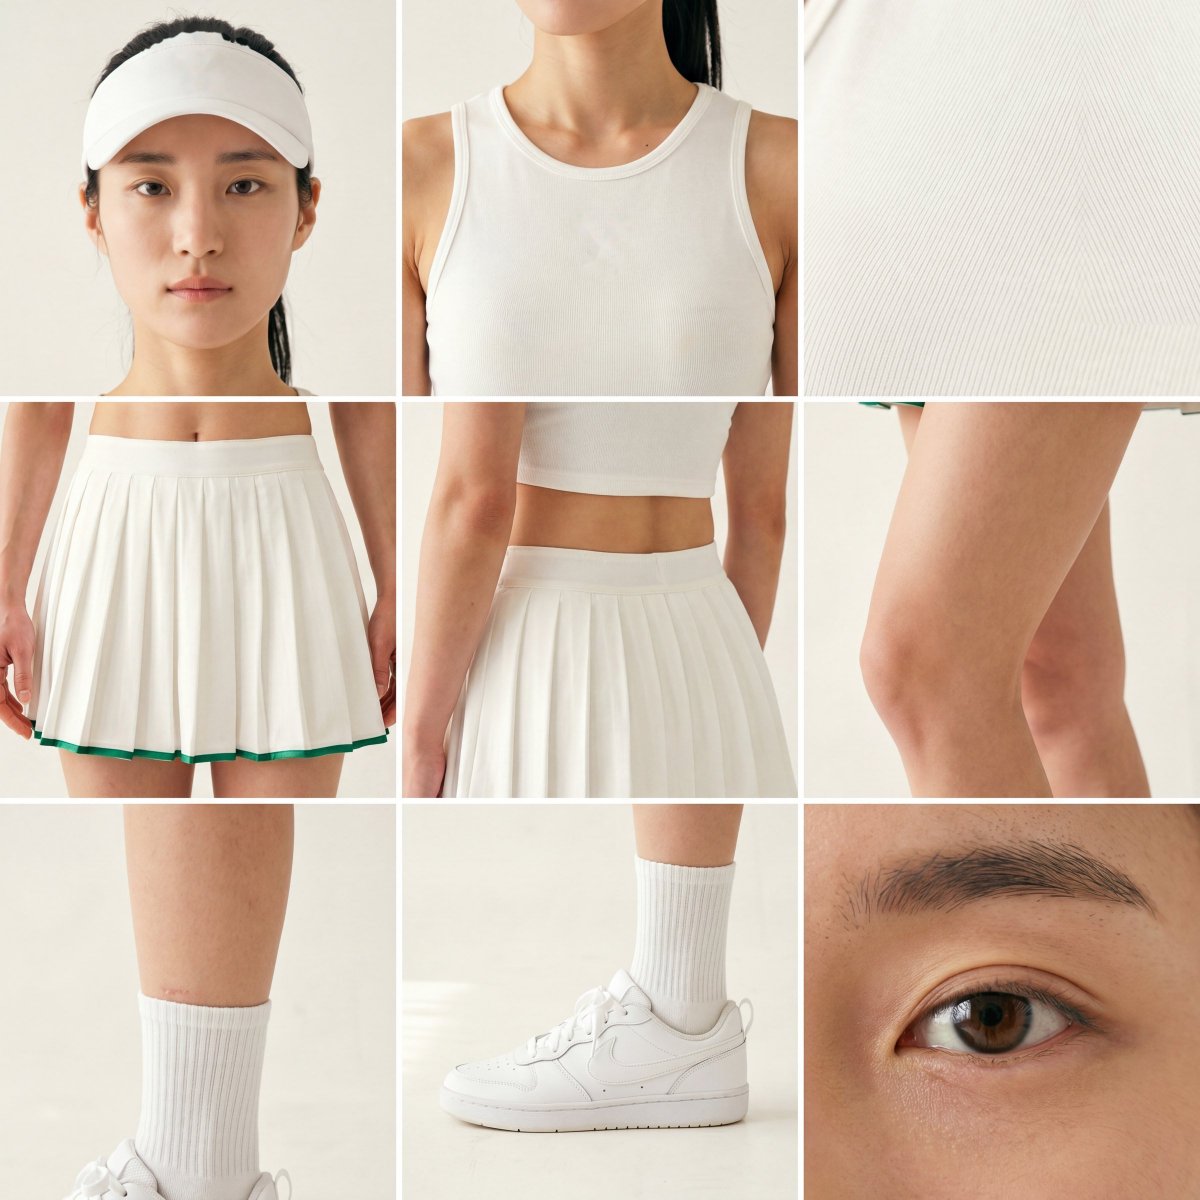
服装细节表:面孔、面料、裙褶、腿部、鞋袜和眼部细节分开固定
动作姿势表不是动作源,而是用深蹲、弓步、平板支撑、单腿平衡等不同身体状态,检查同一张脸、同一套身体比例和同一身服装在大幅度动作里会不会漂移。
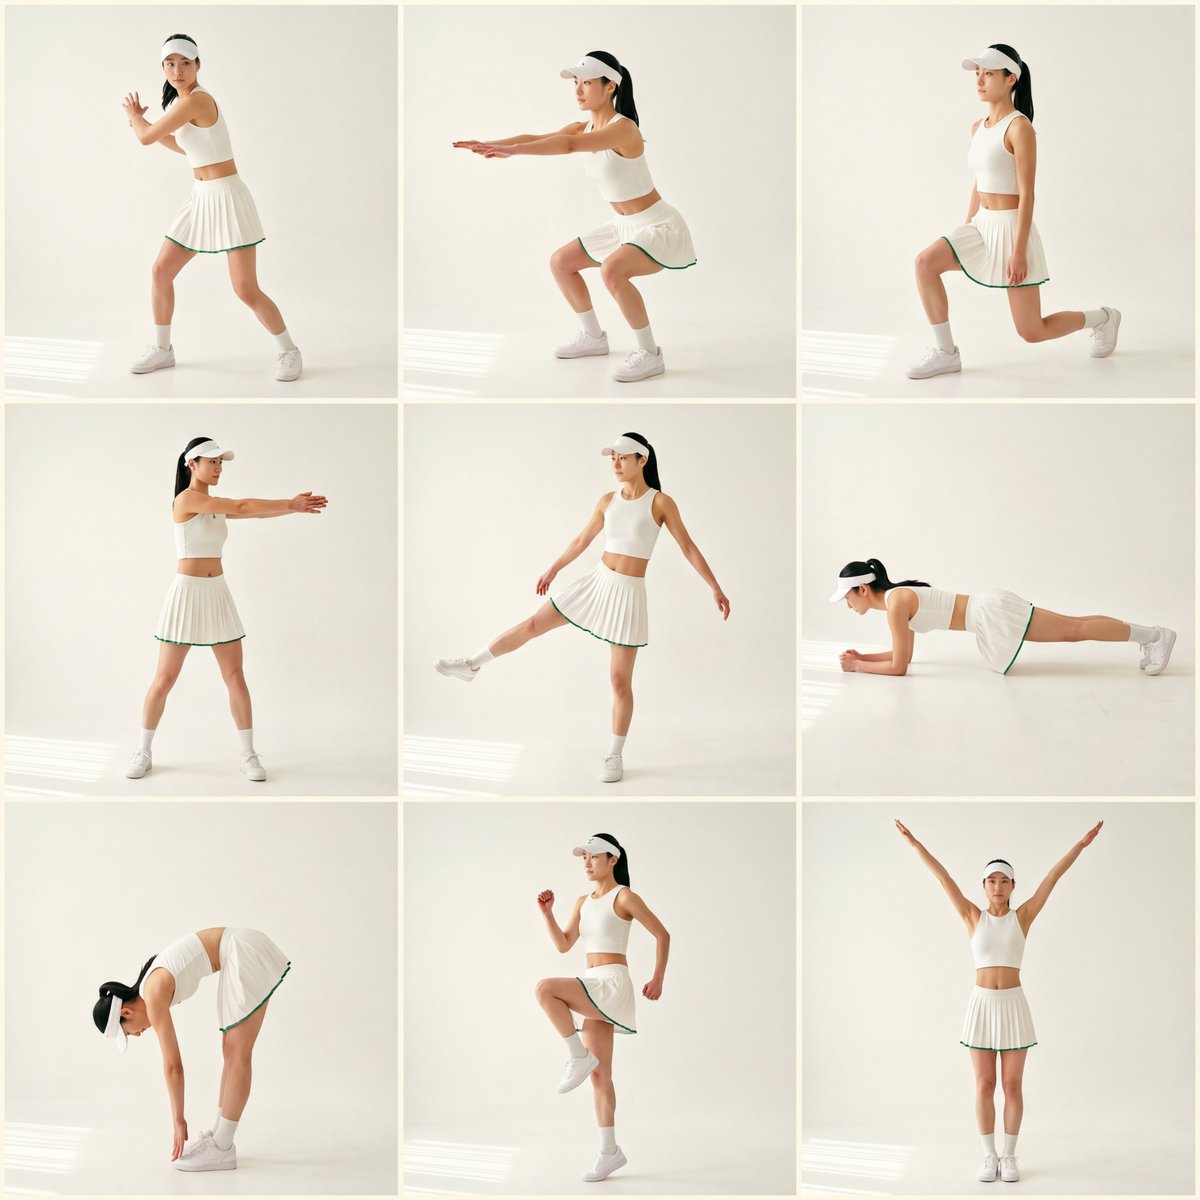
动作演示九宫格:用不同全身姿态检查身份、比例与服装的一致性
横屏和竖屏也必须分开准备。可灵生成的视频画幅会受到人物参考图构图影响:想要 16:9,就用横屏 anchor,让身体两侧留出运动空间;想要 9:16,就用竖屏人物图。用一张竖屏全身照硬做横屏,最常见的结果就是人被挤在中央、动作一展开就出画。
这套资产前后经历了很多版本。雀斑、下颌疤、手表、明显腹肌、过粗的腿和不需要公开的品牌标记都曾经出现过,又被逐一推翻。最后的经验不是“找到一条神 prompt”,而是让不同参考图分工:哪张管身份,哪张管角度,哪张管身体,哪张管服装,哪张管摄影质感。
我实际怎么用可灵 3.0 Motion Control 网页版
这批成片用的是快手可灵网页版的 Video 3.0 Motion Control。做这批内容时,动作控制节点还没有可用的 API 路线,网页端反而更直接,而且当时成本也更低,所以我没有假装把它包装成一套全自动 API 系统。
实际操作只有几个核心输入。
-
上传一条参考动作视频;
-
上传一张与目标视角、横竖比相匹配的 Da‑Yul 人物图;
-
选择人物朝向跟视频一致,还是跟图片一致;
-
绑定 Da‑Yul 面部主体,提高转头时的脸部一致性;
-
选择 Video 3.0、分辨率等生成参数;
-
写一段很短的动作、道具、场景和镜头 prompt。
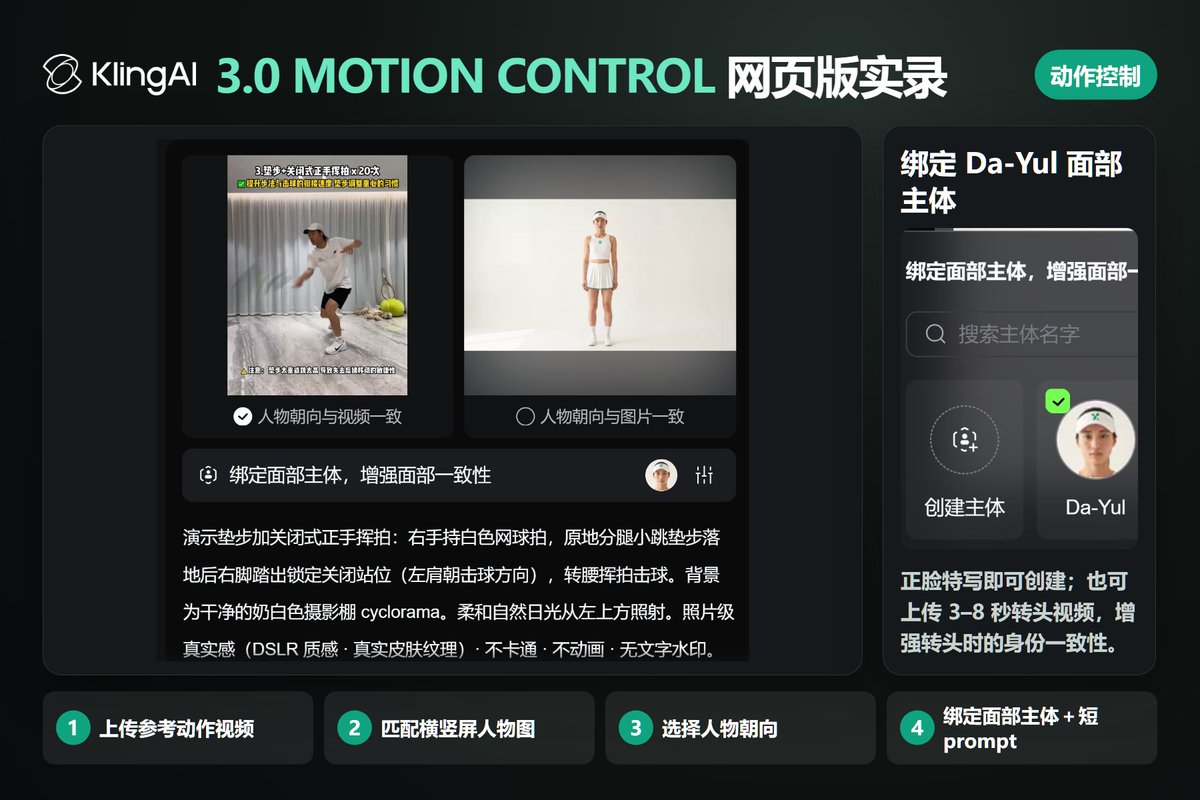
可灵 3.0 Motion Control 动作控制实录:参考视频、人物图、朝向、Da‑Yul 面部主体与实际 prompt
“人物朝向与视频一致”适合动作方向本身很重要的片段,比如垫步后往哪边踏、正反手从哪侧启动;“人物朝向与图片一致”则更依赖人物图的朝向。我的做法是先从 Da‑Yul 多视角资产中选最接近源视频的一张,再决定让哪一边主导,而不是拿同一张正面照硬跑所有动作。
面部主体可以直接上传一张正面脸部特写,也可以上传 3–8 秒的角色视频:正视镜头,再依次向左、向右、低头、抬头。我的这批 Da‑Yul 直接用了脸部特写,在可灵里创建并命名为 Da‑Yul。
下面三张截图不是三个界面示意,而是我真实跑过的三个类别。
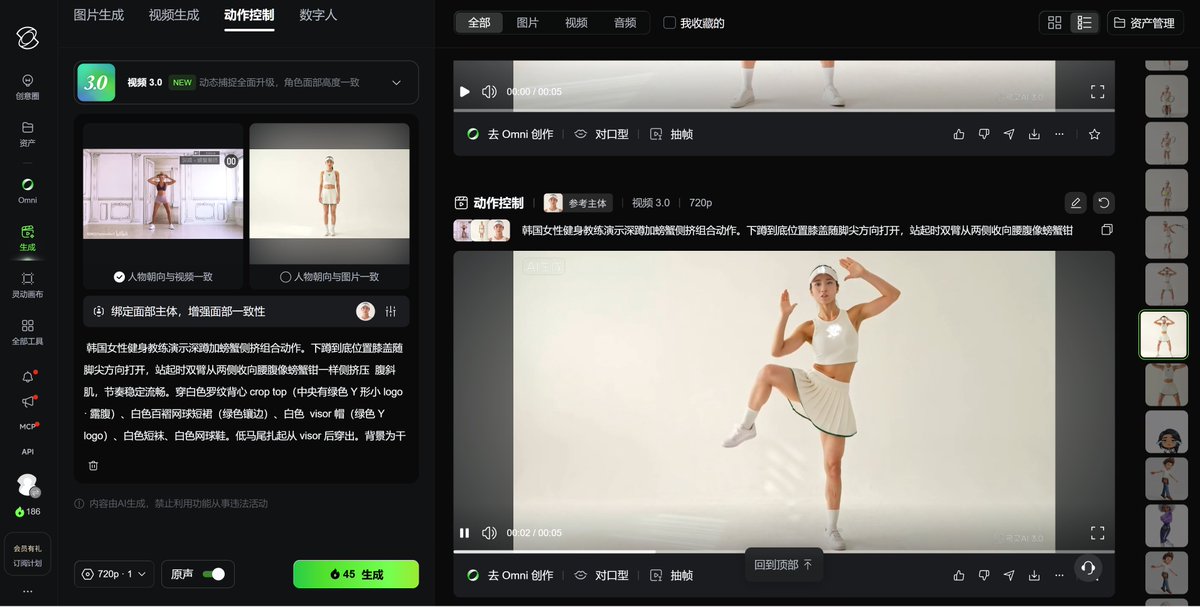
热身动作:深蹲挤压侧腹,720p 生成页与结果同屏
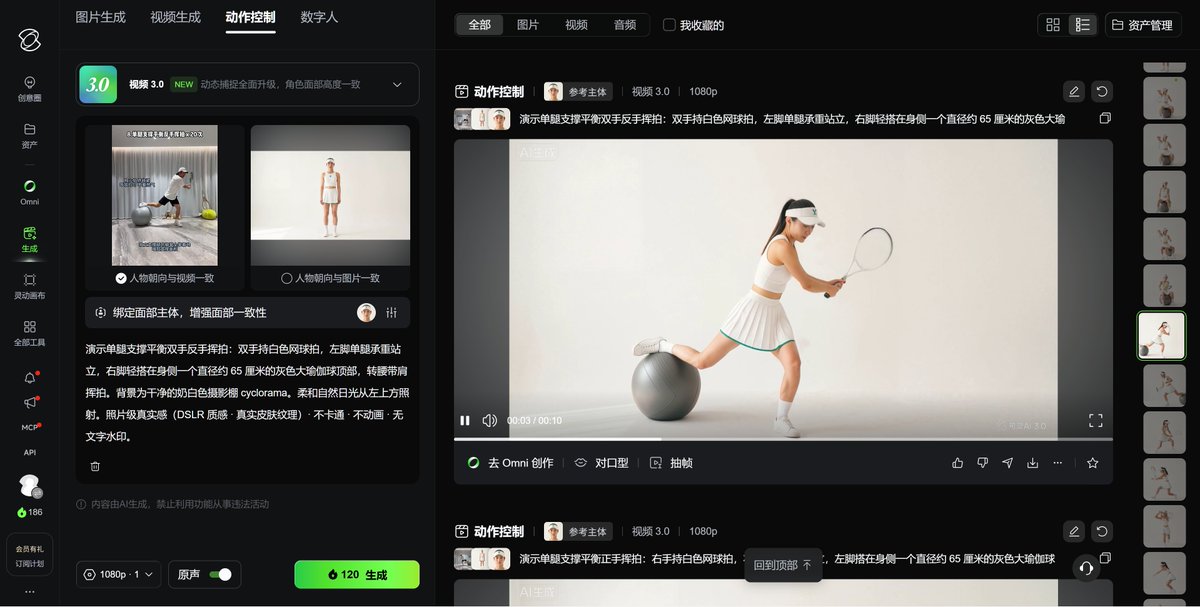
网球专项:单腿支撑双手反手,左腿承重、右脚搭在灰色瑜伽球上
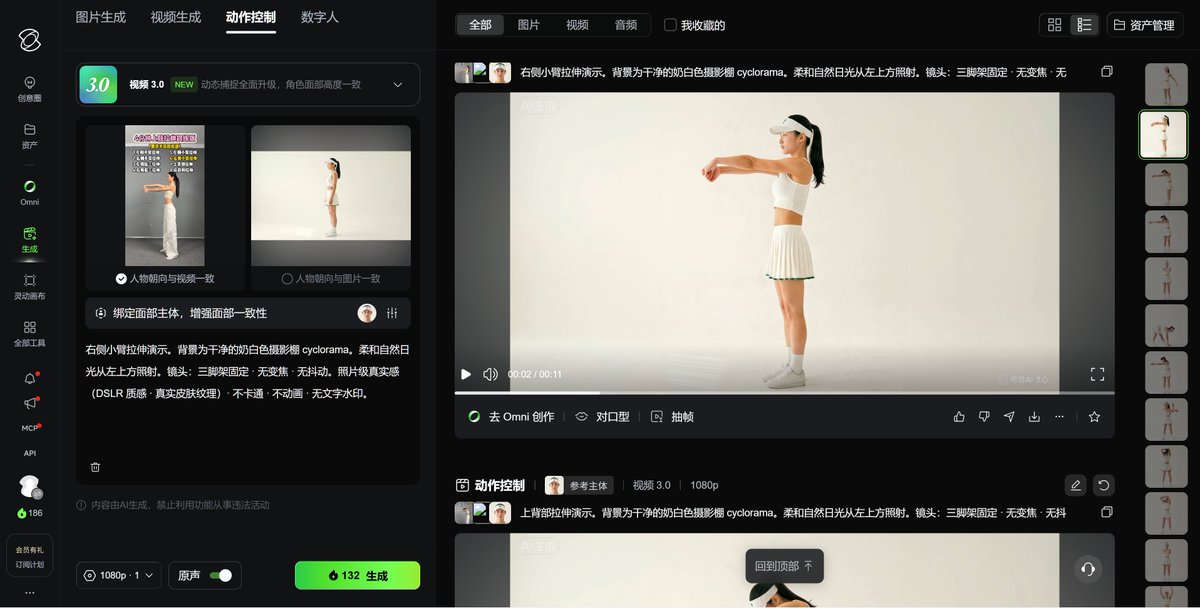
拉伸放松:右侧前臂拉伸,使用侧面人物图并绑定同一个 Da‑Yul 面部主体
截图里的三次任务分别显示了 45、120、132 点,但这不是一个可以直接外推的统一单价;分辨率、视频时长和当时的产品计费都会影响结果。我更愿意保留真实截图,让人看到我当时怎么点,而不是编一个漂亮但无法复核的“每条固定成本”。
Motion Control 里,prompt 为什么反而要短
因为这几个输入已经分工了。
参考视频负责动作;人物图和面部主体负责身份;prompt 只需要补视频和图片没有说清楚的东西:道具、站位、摄影棚、光线、镜头和禁止项。
例如“垫步+关闭式正手”的动作句是:
垫步加关闭式正手挥拍演示。右手持白色网球拍,原地分腿小跳垫步落地后右脚踏出锁定关闭站位(左肩朝击球方向),转腰挥拍击球。
所有视频再共用一个摄影棚后缀:
背景为干净的奶白色摄影棚 cyclorama。柔和自然日光从左上方照射。镜头:三脚架固定、无变焦、无抖动。照片级真实感,DSLR 质感、真实皮肤纹理,不卡通、不动画、无文字水印。
单腿平衡、坐姿抛球这类动作,再把“65 厘米灰色瑜伽球”“白色网球拍”“黄绿色网球”写清楚。
我不会把人体动力学的全部解释塞进 prompt,因为动作视频已经在演。prompt 写得越长,越容易和参考动作互相争夺控制权。真正有效的是分工明确,不是形容词多。
这也不代表道具已经完全稳定。球拍会变形,网球会消失,瑜伽球可能换位置或穿模。我的生产流程仍然是:生成、人工筛选、高风险动作多跑几次;失败就换更清楚、更慢的源视频,必要时后期补道具。Motion Control 解决了大头,不是把 QA 变没了。
左边生成,右边真人:我到底怎么判断“够不够像”
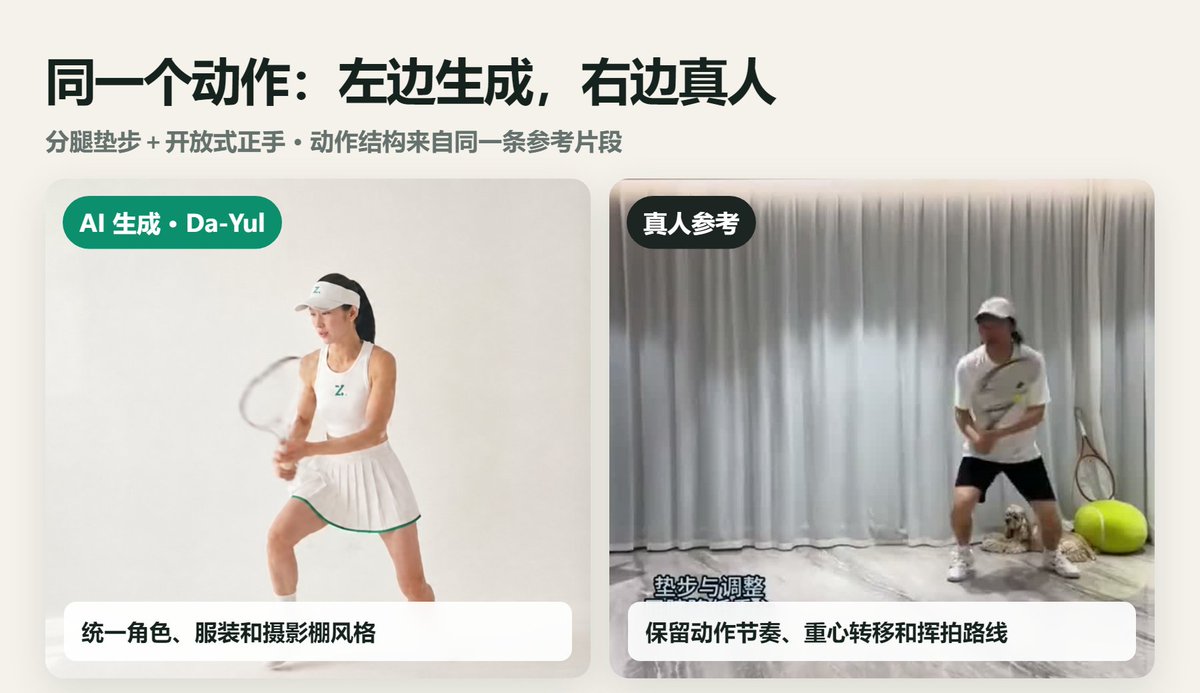
同一个分腿垫步+开放式正手:左边 Da‑Yul 生成,右边真人参考
同一个分腿垫步+开放式正手的同步对比:左边 Da‑Yul 生成,右边真人参考
如果只截一帧比较,很多动作都会显得很像;真正应该看的是整个时间序列:准备姿势、垫步落地、重心转移、转髋带肩、挥拍方向和收尾能不能对上。
我不会说生成结果“每一次都和真人丝毫不差”。更准确的说法是:经过人工筛选后,一部分成片已经能在核心动作轨迹上足够接近真人参考,可以进入跟练动作库。手部和道具仍然是最容易失败的地方。
而且这套东西的价值也不在于骗用户“这是真人”。她就是 Da‑Yul,一个统一的数字示范者。用户真正需要的是动作清楚、节奏稳定、课程里前后风格一致。
一条生成视频只是玩具,动作库和课程才是产品
我最后入库的不是 21 个散落的 mp4,而是 21 个带元数据的动作资产:
-
4 条热身:肩部环绕、弓步转体、站姿前屈转体上举、开合跳;
-
11 条网球专项:关闭式、开放式、分腿垫步、单腿平衡、坐姿发球和抛球;
-
6 条放松:前臂、肱三头肌、三角肌后束和上背部拉伸。
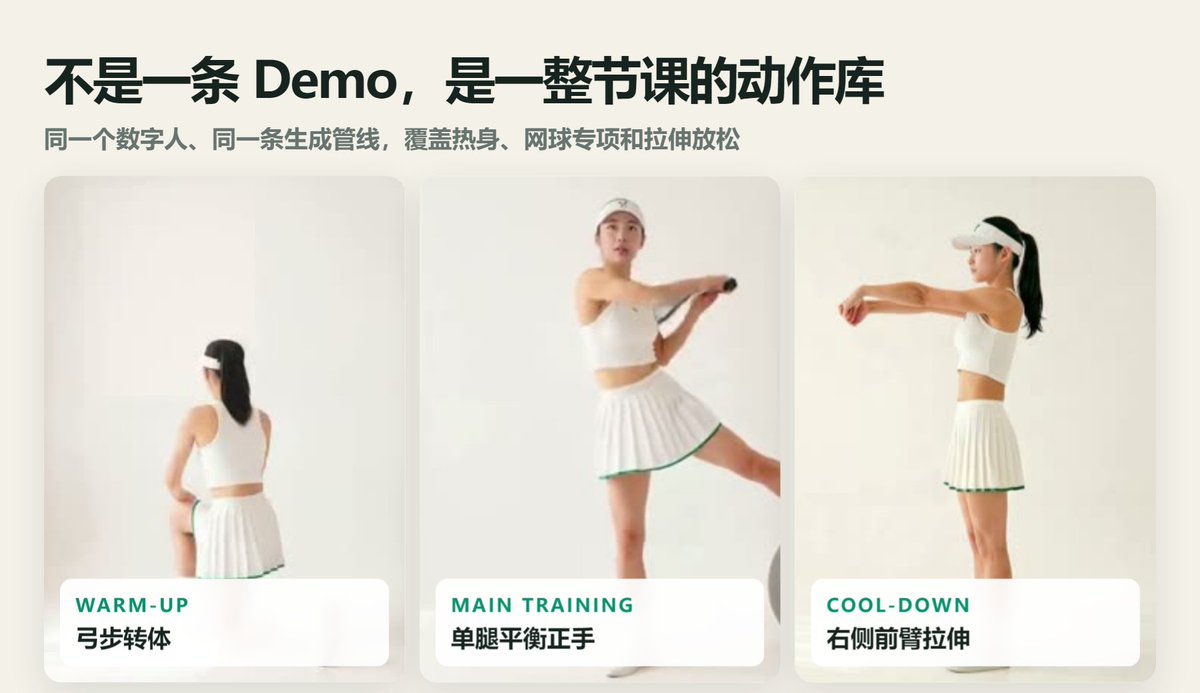
同一个数字人和同一条管线,覆盖热身、主训与拉伸放松
每个 ActionLib JSON 同时保存真人源视频、Da‑Yul 视频、完整 prompt、模型 kling-3.0、模式 motion-control、可灵导出源文件名和播放器适配参数。生成结果不是剪完就躺在 Downloads,而是能被课程编排器继续消费的资产。
课程 00030 · 网球正反手发力打磨 最终用了其中 20 个动作:热身 3 个、主训 11 个、放松 6 个,总时长 10 分 35 秒。每个动作前还有 5 秒准备,一共 42 个步骤。
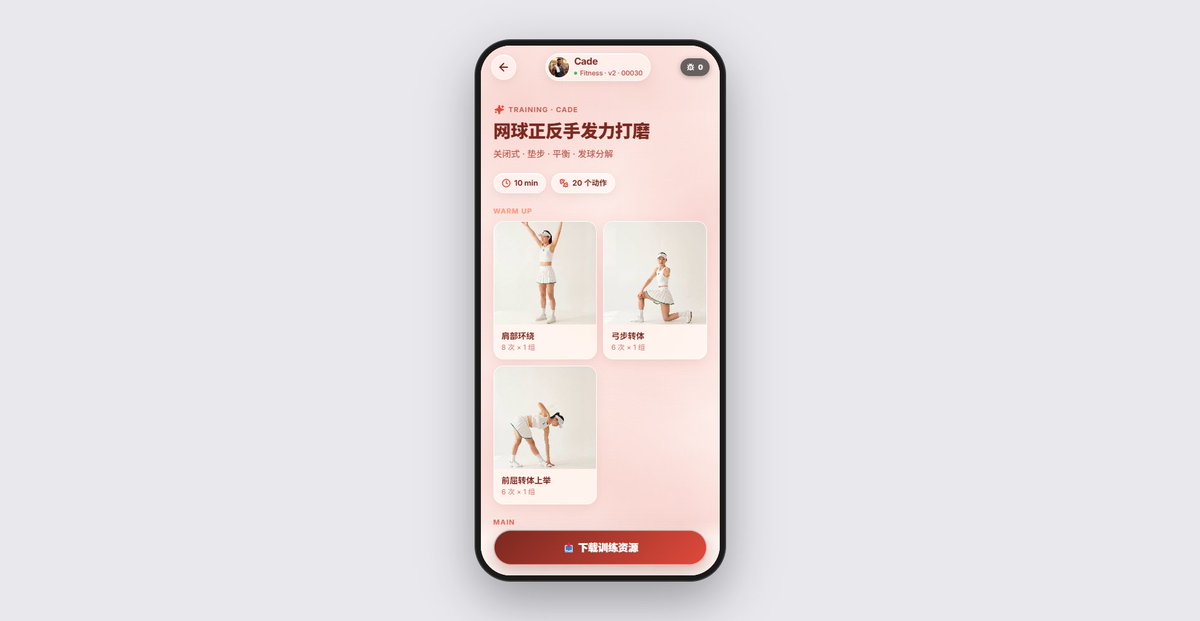
课程总览:20 个动作按热身、主训和拉伸进入同一条 10 分 35 秒时间线
这段录屏展示了课程总览、热身、主训、单腿平衡专项、拉伸和训练完成的真实衔接:
对应短推:
https://x.com/ZhenZhu200/status/2087943458094977241
这一步改变了经济模型:同一条“弓步转体”可以进入很多课程,同一条“右侧前臂拉伸”也不必为每门课重新拍。真正被复用的不是一段宣传片,而是动作资产。
网球教练在训练时,到底要说什么
Da‑Yul 不只是画面里的动作模特,她是这套跟练里的 AI 网球教练。语音系统负责她在训练时说的话,并在正确时点和动作视频叠在一起。
我把这些话按用户真正听到的体验来设计:
-
动作指导:站位、发力、挥拍轨迹、纠错和呼吸;
-
鼓励反馈:肯定这一拍,也提醒下一拍怎么更好;
-
叫你的名字:例如“Jacklyn,准备下一组”,让同一套课程变成个人陪练;
-
课程进度:第几组、还剩多久、何时换边和休息。
当前这节 Da‑Yul 课程的 21 个动作一共保存了 230 条训练提示。关闭式正手的实际指导是这样的:
-
侧身关闭,左肩对网;
-
右脚蹬地,转髋带肩;
-
重心推到前脚,拍头扫过;
-
送拍到左肩,完整收尾。
鼓励和进度也必须具体:“很好,这一拍很完整”“还剩 10 秒,保持节奏”都比泛泛说一句“继续加油”更有用。
这些话故意很短。训练中没有时间听一段百科解释。每句话都要一口气说完,最好动词开头,并且能落到“这一秒身体该怎么做”。短不是文风偏好,也是播放器计时和音频长度的工程约束。视频和语音分开保存,任何一句都可以单独修改,不用重做动作视频。
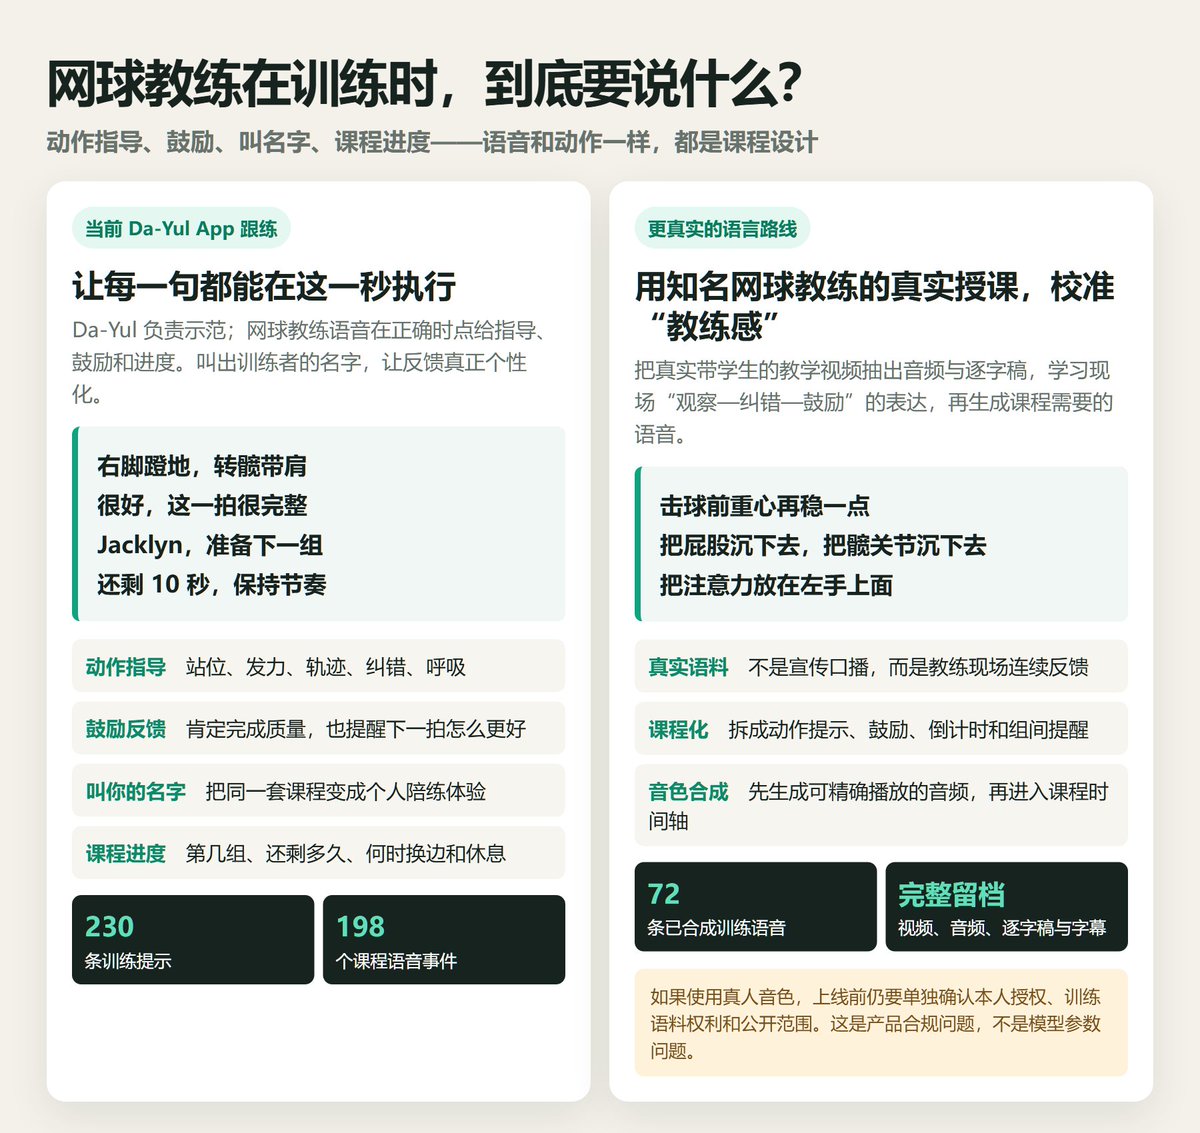
Da‑Yul 在训练时说的话:动作指导、鼓励、叫名字和课程进度
在播放器里,语音不是一条后期旁白,而是课程时间轴上的独立事件。当前课程把 198 条语音、418 个音效和 42 个视频事件逐条对齐;哪一句出现太早、太晚或太密,都可以单独调整,不需要重做动作视频。
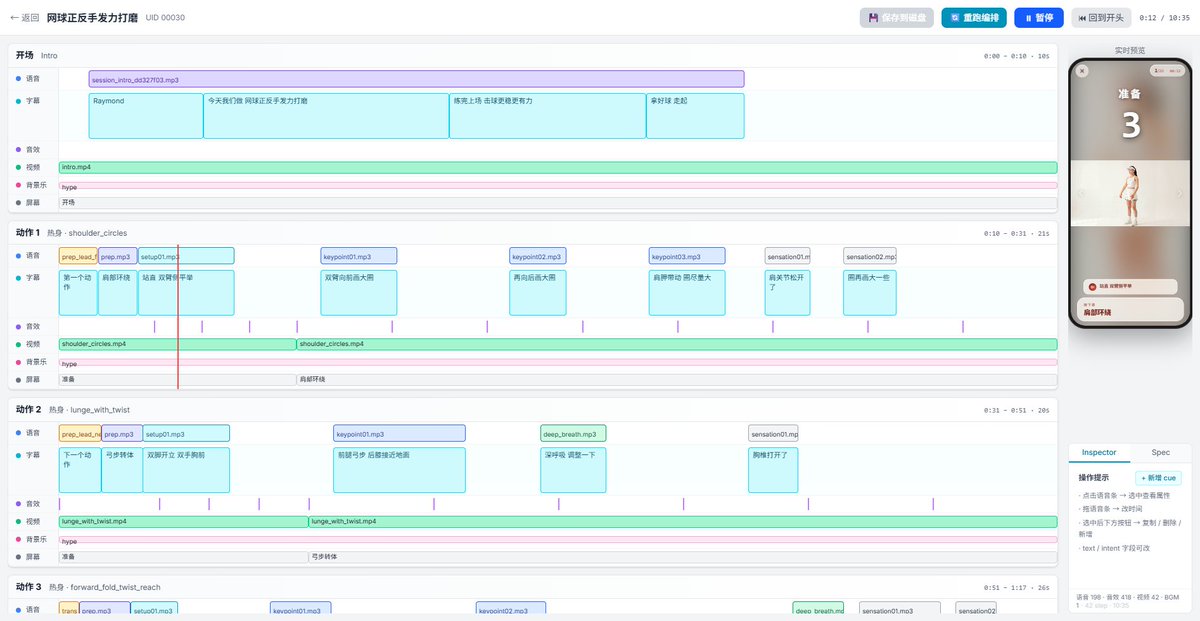
语音编排实录:每条动作指导、鼓励、倒计时和转场提示都落在课程时间轴上
这段录屏截取了热身转主训、主训中的动作纠正,以及主训转拉伸三个片段:
对应短推:https://x.com/ZhenZhu200/status/2088259939181748499
我还在另一个仓库跑通了一条更像真人教练的语言路线。
2026 年 5 月 15 日下载的一段 B 站网球教学,完整留下了 mp4、抽出的 mp3、逐字稿、SRT、摘要和原始识别 JSON。它不是宣传口播,而是一位知名网球教练真实带学生时连续出现的观察、纠错和鼓励:
-
击球前重心再稳一点;
-
把屁股沉下去,把髋关节沉下去;
-
把注意力放在左手上面;
-
对,可以再放松一点;
-
降重心,不要忘了。
这些话比“保持正确姿势、继续加油”真实得多,因为它来自一个教练真的盯着学员练。后续我把这套现场表达拆成动作提示、鼓励、倒计时和组间提醒;在获得真人授权的前提下,再用 MiniMax 合成对应音色。实验计划里已经保存了 72 条合成语音,播放器可以优先使用预生成 mp3,未命中时再回退普通 TTS。
这条真实教练语料路线目前是下一步可以融合的升级方向,我不会把研究路线写成已经上线的功能。真人音色公开发布和商业使用前,也必须单独确认本人同意、训练语料范围和授权方式。
播放器把“生成资产”变成“可跟练内容”
跟练运行时不会再现场调用生成式 AI。播放器只播放已经审核过的 mp4 和 mp3,所以启动、切换、缓存和时间轴都可预测。
动作库同时保存真人视频和 Da‑Yul 视频,运行时走一条很朴素的降级链:
AI 视频 → 真人源视频 → 黑底或动作卡兜底。
这意味着产品不必等 1000 条动作全部生成完才上线。哪条 Da‑Yul 已经通过 QA,就优先用;没通过的继续用真人参考;两边都不可用,至少还有动作卡,不让播放器崩掉。
横屏视频放进竖屏手机时,我也没有硬裁成 9:16。播放器把同一条 16:9 视频叠两层:背景层 cover 填满并模糊,前景层 contain 保留完整身体。这样拍摄和生成阶段优先保证动作完整,竖屏适配留给播放器。
数字人真正解的是一个成本方程
传统拍摄不是一次付钱、永久结束。每增加一个动作,都要重新协调模特、场地、灯光、机位、档期和后期。数字人路线把很多固定投入变成可复用资产:同一个人、同一套服装、同一套摄影棚风格、同一个播放器和同一套语音机制。
所以它真正降低的是边际生产成本。
但我也不会说边际成本已经是零。可灵 credits、失败重跑、人工筛选、转码、存储、角色维护、动作准确性审核都还存在。现阶段我能证明的是成本结构显著改善,而不是已经验证了收入、毛利和“暴利”。
如果要复刻,我会按这个顺序做
完整工作流、Kling 网页操作包、Prompt 模板和检查脚本已经放在公开仓库:
https://github.com/zhenzoo/ai-sports-coach
安装后可以直接对 Agent 说:
Use $ai-sports-coach to inspect my project, prepare Kling Motion Control generation packets, and stop before any paid generation.
-
先设计课程和动作清单,不要先批量生成;
-
给每个动作找单人、全身、单镜头、节奏稳定的源视频;
-
用 Bandicut 切到一个片段只剩一个完整动作;
-
记录来源、授权状态和下载日期;
-
准备角色横屏、竖屏和多视角 anchor;
-
补头部视角、服装细节、动作姿势和正脸特写;
-
在可灵创建面部主体;
-
Motion Control 上传动作视频和最匹配朝向的人物图;
-
根据动作决定跟随视频朝向还是图片朝向;
-
prompt 只写动作补充、道具、摄影棚、镜头和禁项;
-
多跑、人工筛选,尤其检查手、球拍、网球和瑜伽球;
-
把成片和真人源一起写回 ActionLib;
-
为每个动作写好动作指导、鼓励、叫名字和课程进度;
-
最后再进播放器做准备、计数、进度、降级和竖屏适配。
我越来越确定一件事:技术和自媒体如果不服务于一个真实的商业目标,很容易只剩“今天又试了一个模型”。
Da‑Yul 对我来说真正有价值的地方,是她开始替训练产品承担一件原本极贵、极慢、难以扩张的工作:把课程设计变成能持续量产的跟练内容。
这才是我愿意继续更新她的原因。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


