
不要再尝试让 Codex 从零生成视频了,而是让它复制剪映模板
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
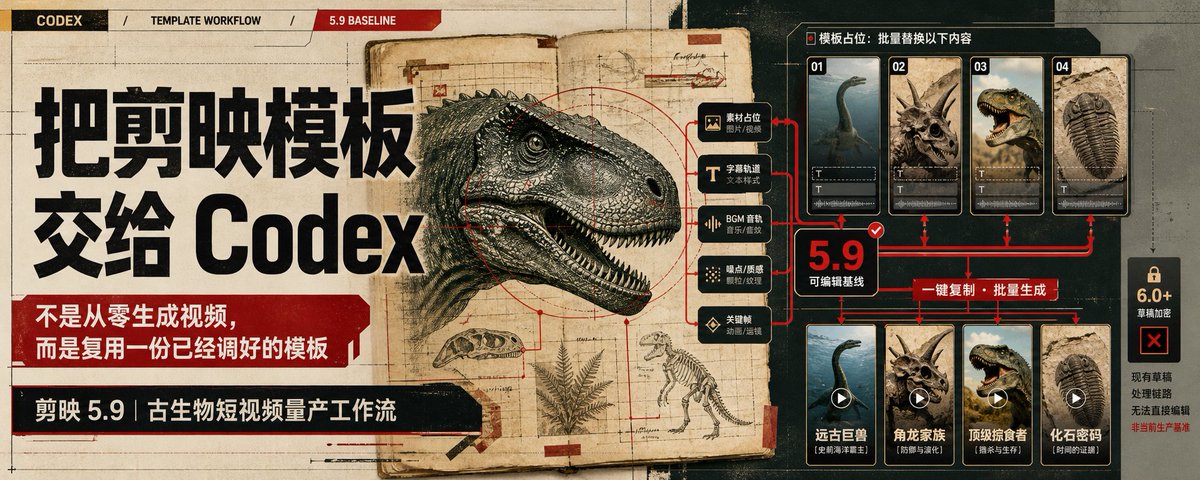
一套剪映短视频量产工作流
很多人说起 AI 剪辑,想象的都是一句话生成一条成片:给 Codex 输入主题,等一会儿,视频就出来了。然后就可以直接投稿。
但实际跑下来,最费事的是让每个环节都不走样。而目前codex自己剪视频根本做不到这一点。
于是我们开始选取折中的办法,让codex操控剪映,人工负责精细调整。
我们可以用 VectcutAPI 和 Jianying-editor 来编辑剪映草稿文件,最后由人工调整,再渲染。
sun-guannan/VectCutAPI: Open Cut API.
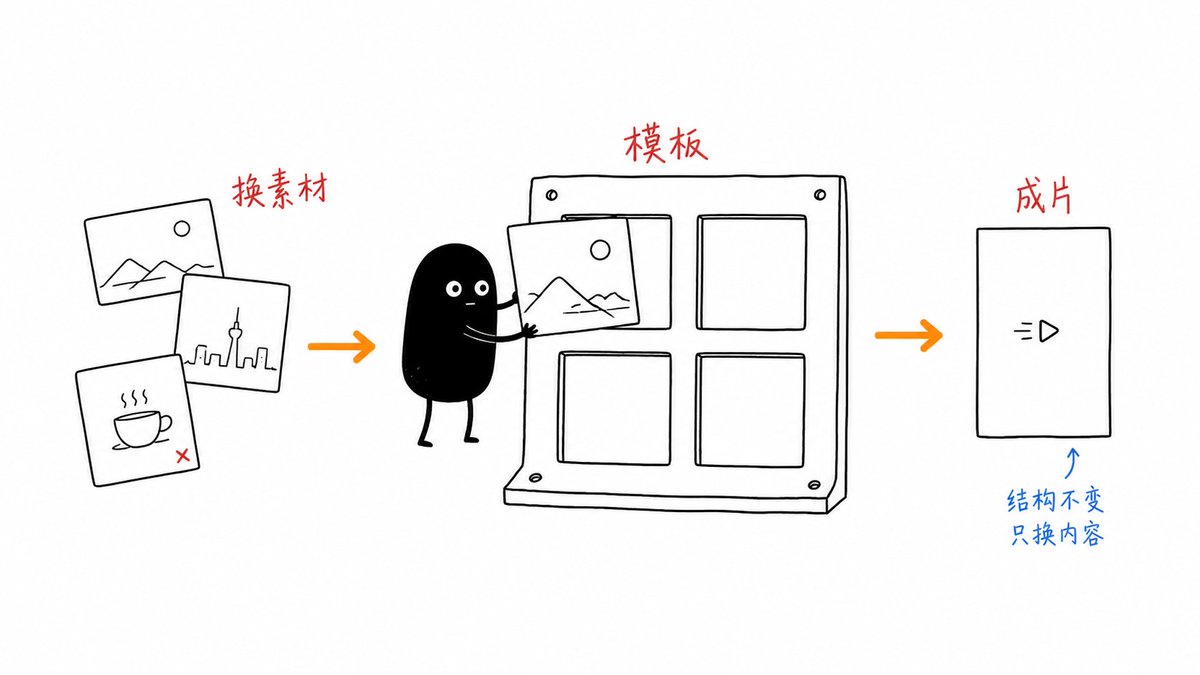
那么这种情况下的量产是:先把一条人工调好的视频做成模板,再让 Codex 按模板替换内容。图片、字幕、音乐、特效、关键帧和草稿结构都固定下来,下一条视频只换主题和素材。
我个人目前还没准备直接做AI教程起号,因为我想着先打好基础,由易到难。最简单的语录视频我已经量产了一周了,可以稳定做到。
现在我尝试了两天时间,把这套方法目前用在古生物和生物知识短视频上。因为我发现这些视频非常适合量产,并且也能保证一定程度上内容的差异化。
https://www.bilibili.com/video/BV1FSxKzeE4e 比如这个,可以看一下。
我模仿这类视频,已经用同一套剪映模板做过十几个不同主题,也把这些视频排成了 B 站抖音一天一条的定时发布。
下面按这套流程拆开讲。我们不讨论“AI 会不会替代剪辑师”这种大问题,只回答一个更实际的问题:如果我看上了一套可以量产的视频类别,怎样把它变成可以反复复制的稳定的生产线?
一、我们先弄清楚,自己到底要自动化什么
最开始,我也试过直接生成。给出主题,找图片,写字幕,再拼成一个视频。但是结果很快就暴露出问题:图片和字幕对不上,字幕位置会跑,字幕乱替换,画面切换带着黑屏,关键帧有时乱晃,原本模板里的特效也没有保留下来。
这些问题单独看都不复杂,合在一起却说明了一件事:视频制作不是“把几个文件放到一起”。它是一组彼此牵制的约束。
图片要和字幕对应,字幕要在正确的位置。画面要跟着音乐和节奏走,关键帧要把观众的注意力带到主体上,草稿还得能在剪映里正常打开。只要其中一项被重新发明,原来已经调好的东西就可能一起被破坏。
所以我后来把目标收窄了。需要自动化的,主要是那些重复、可以被写成规则的动作:复制草稿、替换素材、更新文字、保留关键帧、检查轨道、渲染预览和整理发布文件。
主题选择、文案方向和最终审片,仍然由人来决定。这样做的好处是,Codex 不需要每次重新理解我们想要什么,只需要在一套已经验证过的规则里完成下一条。
如果这一套跑通了,你现在就能去兼职剪辑接单了。
不过在此有个前提,我们需要使用5.9以下的剪映。因为剪映 6.0 及以上版本的草稿采用了加密结构,Codex 无法直接编辑。
我提供一下 5.9 剪映 :
https://pan.baidu.com/s/1UR2hmgqYM7Gx5KolMhvSQA?pwd=pnvs
二、第一步:先做出一条真的能用的模板
当前基准模板,就是在剪映专业版 5.9 里亲手调过的那份草稿。这个顺序很重要。
如果一开始就让 Codex 自己设计字幕、自己猜关键帧、自己选择转场,它很容易给出一个“看起来像视频”的结果,却未必符合我们的要求。那份在剪映里手工调过的草稿,才是视觉规则最完整的记录。
当前这套模板大约 48 秒,画布是 1440×1920,30fps。开头有一张引入画面,正文由 36 张图片组成,按 9 组四图结构排列。每一组都遵循同一条字幕语法:
-
前两张图只显示主名称。
-
后两张图继续保留主名称,在下面增加一行较小的补充字幕。
-
主名称从头到尾保持不变,补充字幕负责解释、补充或揭晓。
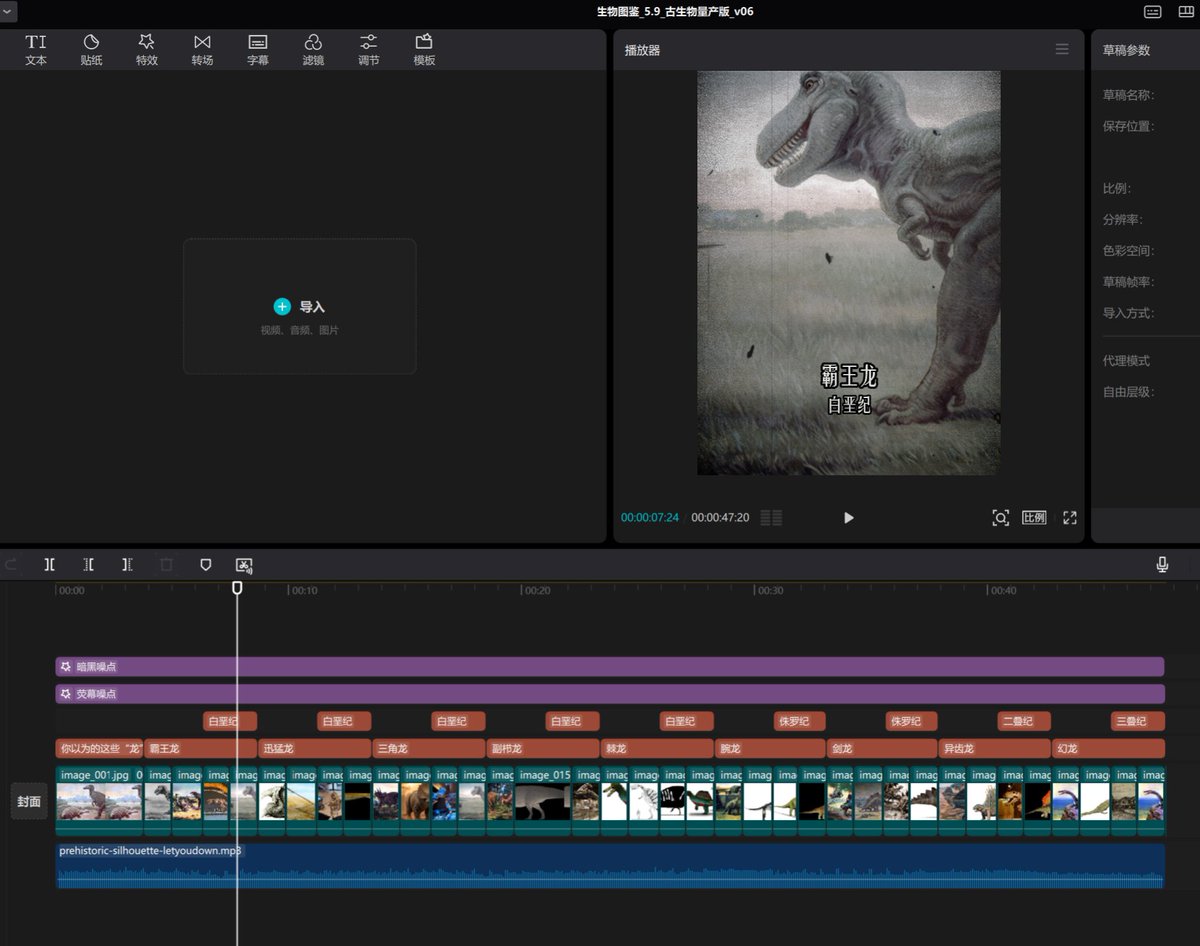
比如一组内容的主名称是“霸王龙”,前两张图只出现“霸王龙”,后两张图仍然保留“霸王龙”,下面再出现“白垩纪”。主名称不能被“白垩纪”替换,补充字幕也不能只闪现一帧。
这已经是一种清楚的数据结构。
当模板结构被固定以后,下一条视频会变成填充一组新的内容数据。
三、素材库决定了量产的上限
我在推特上搜到的几乎所有关于 Codex 自动化剪辑的文章都反复提到素材库,这一点我实际做下来也完全认同。
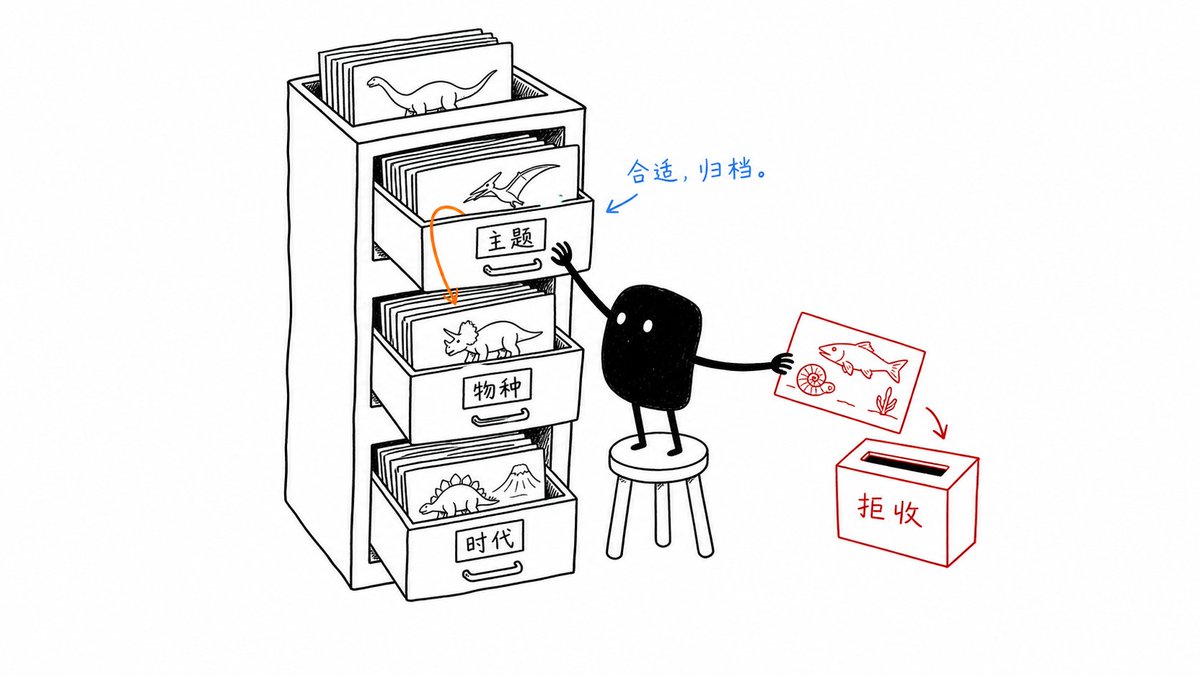
如果每条视频都让 AI 临时找图片,结果很难稳定。它可能找到一张看起来很像的古生物图,却把三叶虫放进植物这一组,把提塔利克鱼放进侏罗纪的主题,或者把一个时代的生物配到另一个时代的字幕下面。
所以素材准备要从主题文件夹开始:每张图都要写清楚能表达什么,不能只挑几张好看的图。
古生物主题主要参考查尔斯·奈特和布里安的古生物画。缺少合适作品时,再用明确标注物种的骨架图、复原图或其他可核对来源的素材补足,并把来源一并记下。不能因为画面“看起来很科学”就直接放进去。
我们现在会给每个主题保留素材清单和来源记录,图片先放进素材目录,再复制到具体草稿中。原始素材不移动、不覆盖,替换前也保留备份。这样做有两个好处:素材库可以继续复用,草稿出问题时也能退回上一版。
这一步还需要人工目检。文件名只能提供线索,不能代替画面检查。真正要看的,是图片里的物种、结构、时代和字幕是否属于同一组。哪怕图片风格很统一,只要语义错了,观众还是会很快看出来。
四、剪映草稿成为模板的核心,可以一直复制迭代
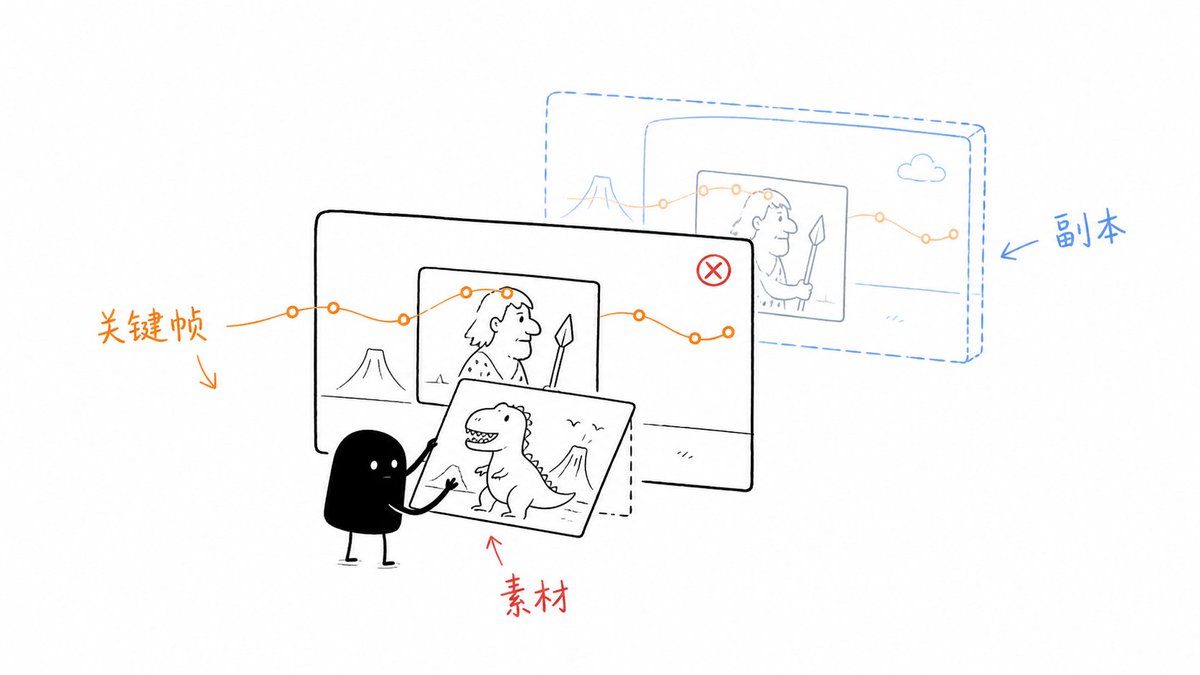
我们后来就不用继续从零生成一份新的模板,而是复制已经调好的初始草稿。
复制之后,原模板和已经完成的主题都不动。需要换图时,优先保留原来的素材文件名和路径,只替换对应的图片文件。这样,原草稿里已有的画面缩放、位置和关键帧就能继续生效。
通过 VectCutAPI 操作草稿时,我们仍然把初始草稿当作事实来源。能可靠读取和写入的部分才修改;关键帧无法确认时,不重写整份草稿,退回到“复制草稿、备份原图、替换同名素材”的做法。
自动化的边界也要写清楚:能保留已经调好的部分,就别让模型重新猜一遍。
五、关键帧要按画面单独构图
这部分是我们反复修改最多的地方,也是最难靠一句提示词说清楚的地方。
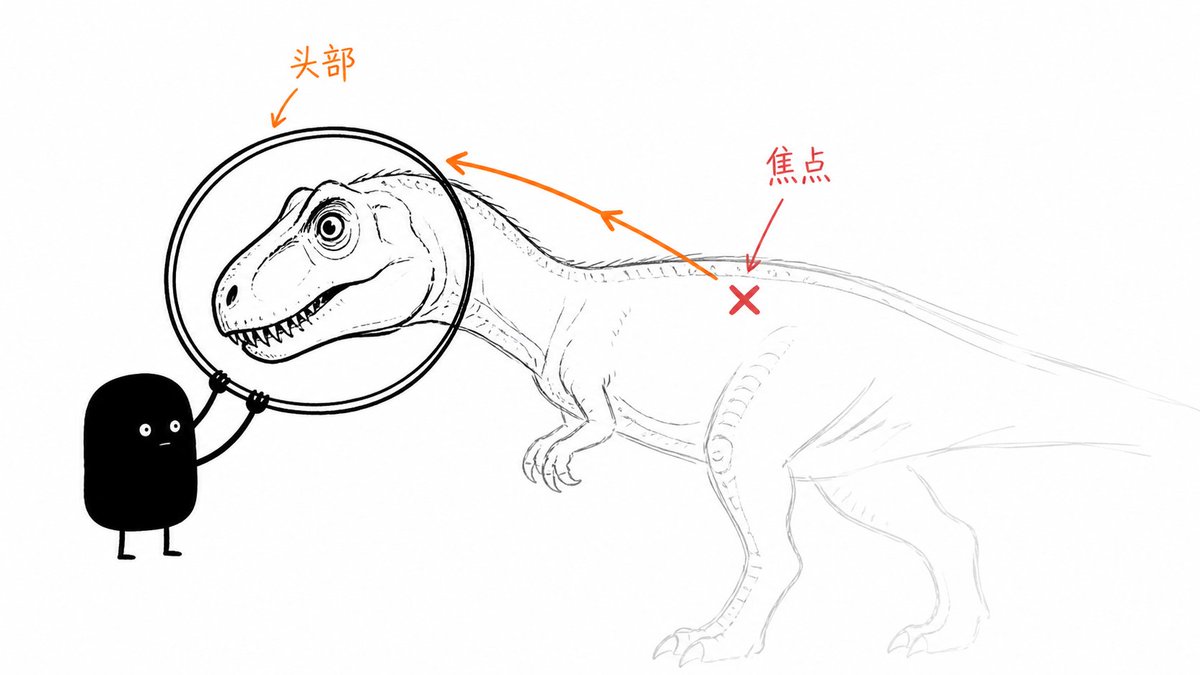
图片运动的主体位置并不统一。有的恐龙头部在左上方,有的在右侧,有的画面主体很大,有的主体被放在远景里。如果每张图都套用统一的运动参数,镜头很容易乱晃。
处理顺序是先让人工自己先改一遍,然后叫Codex读取草稿然后跟着学。我自己的调法:对于动物图,通常是头部、眼睛或牙齿;对于化石和分子图,可能是管状结构、关键节点或图中的核心标记。
运动方向也不固定。主体在左边,就可以把运动空间留给右侧;主体在上方,就让画面缓慢向上靠近;如果画面已经很满,可能只需要轻微横移。每张图的关键帧数量、幅度和方向都可以不同。
那么 Codex 一直读取我对运动关键帧的更改,它自己的技巧也逐渐迭代,往后的经验会越来越强,做到最后就能最大限度的替代人工,从而真正的做到自动剪辑,这是“一句话剪辑”无法做到的。在剪映里手工改过的关键帧,是这套模板里最有价值的经验。所以后续制作要尽量读取并保留这些修改,不要让Codex每次都从头开始。
六、实际生产时,我们会怎样让 Codex 执行
一条新视频通常从一个主题开始。主题来自我自己存进 Obsidian 知识库的一些思考,但这些思考只是选题原料,还要经过取舍、改写和配图核对。
我们会先确定主题、字幕,再准备图片。图片确认后,Codex 才进入草稿操作阶段。它需要读取项目现场、素材索引、待办和接班记录,确认当前使用的是剪映模板,然后完成以下工作:
-
复制模板草稿,创建新的版本目录。
-
保存原草稿和待替换图片的备份。
-
逐组检查图片与字幕是否对应。
-
替换新主题的图片和文字内容。
-
保留原来的 BGM、特效、剪辑。
-
对每一张图单独检查铺满画面和焦点位置,调整关键帧。
-
输出预览视频、制作说明和检查结果。
模板稳定以后,每条新视频的重复劳动会少很多。接下来只需要重新选题,然后按同一条路径复制草稿、替换内容、检查结果。
视频导出后,通过 Playwright 操作 B 站和抖音投稿页面,填写标题、知识分区、标签、封面和创作声明,再按一天一条设置定时发布。
然后就啥都不用干了,一直挂机,自动投稿,自动收入。
七、这套方法适合什么,不适合什么
它适合有稳定视觉模板、需要持续更新、画面结构相对固定的短视频。古生物视频、历史视频、知识点对比、产品展示,都可以用类似方式组织。
它不适合完全依赖现场表演、复杂情绪调度或每一秒都需要重新设计的原创短片。那类内容仍然需要更多人工剪辑和导演判断。
我始终不认为现在 Codex 可以一键剪辑出片
现在 AI 的多模态能力还先没有那么先进,这也是 AI 无法替代人工最大的差距之一。需要自己花时间把一条视频改好,把字幕位置、图片顺序、关键帧、噪点和音乐起点都固定下来,再让 Codex 去重复这些已经确认过的决定。
模板不是一张静态的草稿,它里面藏着很多判断:什么样的图片能用,字幕什么时候出现,镜头应该看向哪里,哪些效果不能碰,什么情况必须停下来交给人工检查。
Codex 的价值,就是把这些判断转成能被文件、脚本和草稿承载的规则。人负责选题、审美和最后确认,工具负责在稳定的边界内执行重复工作。
如果你也想做自己的量产流程,我建议从一条你已经亲手改满意的视频开始。先不要急着追求“一句话生成”,先问自己三个问题:这条视频的固定结构是什么?哪些元素必须保持不变?下一条只需要替换哪些内容?
这三个问题回答清楚以后,自动化才有真正的落点。
给 Codex 的启动提示词
下面这段可以作为同类项目的起点。路径和主题需要替换成自己的内容。
请使用“剪映量产流程”处理这个项目。

先读取项目现场、判断记录、素材索引、待办和接班记录,确认当前真实模板草稿和剪映版本。不要自行改用 Remotion,不要另起一套模板,也不要统一覆盖用户已经调整过的关键帧。

本次任务:
- 模板草稿:<模板草稿路径>
- 新主题:<主题名称>
- 补充字幕:<字幕>
- 新图片目录:<图片目录>

要求:
1. 复制模板到新的版本目录,原模板不可覆盖。
2. 替换图片和字幕,保留 BGM、特效、硬切、画布、帧率和音乐起点。
3. 图片必须铺满画面;每张图根据视觉核心单独判断位置、缩放和关键帧方向。
4. 逐张核对图片与字幕,不要使用语义无关的生物或重复图片凑数。
5. 完成后检查草稿是否能打开、素材是否存在、字幕轨道、音频轨道、特效轨道和关键帧是否保留。
6. 输出新草稿路径、备份位置、检查结果和仍需人工确认的问题。

可选的包装阶段:
7. 内容层完成并通过检查后,再分析已批准的参考视频,提取文字模板、贴纸、转场、音效和 BGM。
8. 未经确认不要改动主模板;没有可靠素材或无法确认语义时,标记为待人工确认,不要用无关内容填充。
参考学习
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


