
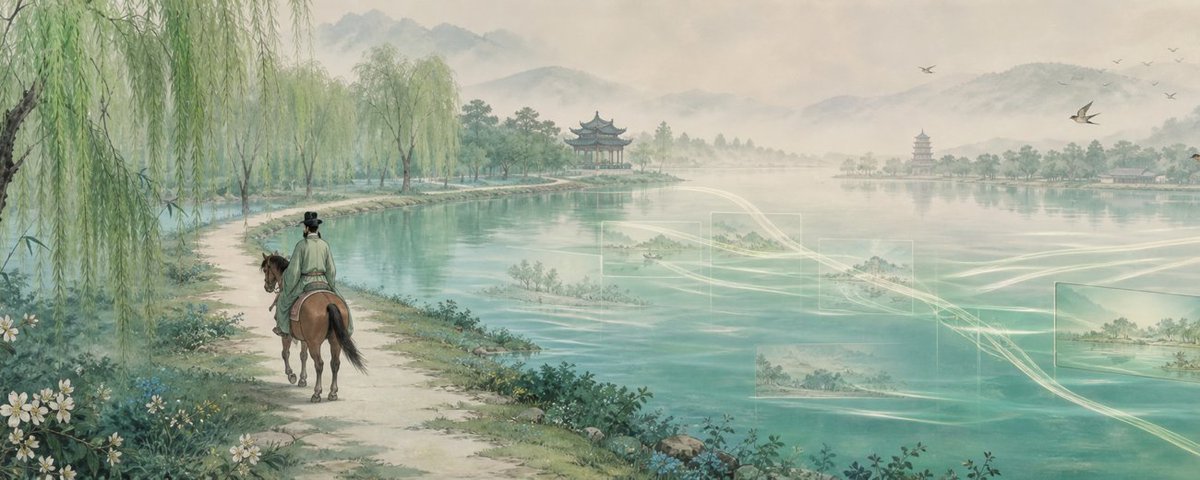
我用 Codex+ Gemini,几分钱成本,把《钱塘湖春行》做成了一条会呼吸的中国画视频
文章目录
我前后调整了很多轮,才把这条三十多秒的古诗视频做成现在的样子。
它看起来只是四幅中国画、四段诗句和一首背景音乐,但真正困难的地方并不是“生成一张漂亮古画”,而是同时解决下面几件事:
-
一首诗的不同句子应该有不同颜色和不同画法,不能全部套一张泛黄古绢模板。
-
动态必须来自画里的水、鸟、马、柳枝和衣袍,不能用后期推镜假装图生视频。
-
画面要动,但寺庙不能重建、鸟不能越动越多、马不能多腿、树枝不能凭空生长。
-
白色模型星标需要处理,但传统红色方印必须保留。
-
两句诗要像题跋一样从右到左逐字出现。
-
每段 AI 视频自带的风、水、鸟鸣和马蹄声不能丢,BGM 也要连续播放。
-
场景之间需要自然溶解,不能黑一下,也不能把环境声突然切断。
这篇文章以《钱塘湖春行》为例,把这套真实工作流完整拆开。
零、这条视频用了哪些工具
这不是靠一个软件完成的,而是一条由 Codex 串起来的本地媒体流水线。
| 工具 | 作用 | 是否必需 |
|---|---|---|
| Codex | 读诗、拆分镜、写提示词、调用脚本、检查抽帧和修复流程 | 核心控制台 |
| AI 生图 | 并行生成四张 9:16 中国画静帧 | 项目最终使用兼容图像 API;开源 Skill 默认调用内置 ImageGen |
| HBG Gemini Flow Suite | 通过 Docker 执行图生视频并下载原环境声视频 | 当前 I2V 运行时 |
| FFmpeg / ffprobe | 烧录字幕、混音、转场、编码、抽帧和媒体检查 | 核心后期工具 |
| ASS 字幕 | 控制两列毛笔字逐字出现 | 推荐 |
| Ma Shan Zheng | 中国风毛笔字体 | 可换其他有许可字体 |
| veo-watermark-remover | 可选地处理右下角白色星标 | 按需使用 |
Codex 在这里不是绘图模型,也不是视频模型。它更像整条流水线的导演和质检员:
古诗 → 意象与情绪 → 分镜 → 静帧提示词 → AI 生图 → Docker I2V → 抽帧验收 → 星标处理 → 毛笔字字幕 → 原声与 BGM 混音 → 交叉溶解 → 最终 MP4 QA
一、先承认一个问题:古诗视频不等于“统一古绢色”
最初的画面都比较像:泛黄纸张、左边一棵树、右边留白、远处淡山。单张看没有问题,连续看就像同一个模板反复换主体。
《钱塘湖春行》本身不是单一情绪。它从湖寺与低云开始,转向早莺与新燕,再进入乱花浅草和骑马游春,最后落在绿杨白堤。四个段落的视觉任务不同,色调当然也不应该完全一致。
所以我最后只统一三件事:
-
中国画的文化可信度和笔触质量。
-
唐代人物、建筑、马具和自然物象的时代合理性。
-
低饱和、克制颜料和竖屏题字区域。
其他部分允许变化:
| 场景 | 画法 | 主色 | 视觉任务 |
|---|---|---|---|
| 湖寺低云 | 淡墨山水 | 青灰、烟墨 | 交代西湖空间与早春水气 |
| 早莺新燕 | 工笔花鸟 | 暖黄、象牙白 | 把“争暖树、啄春泥”变成明确动作 |
| 乱花浅草 | 人物鞍马 | 草绿、花色、赭马 | 表现游春的人间气息 |
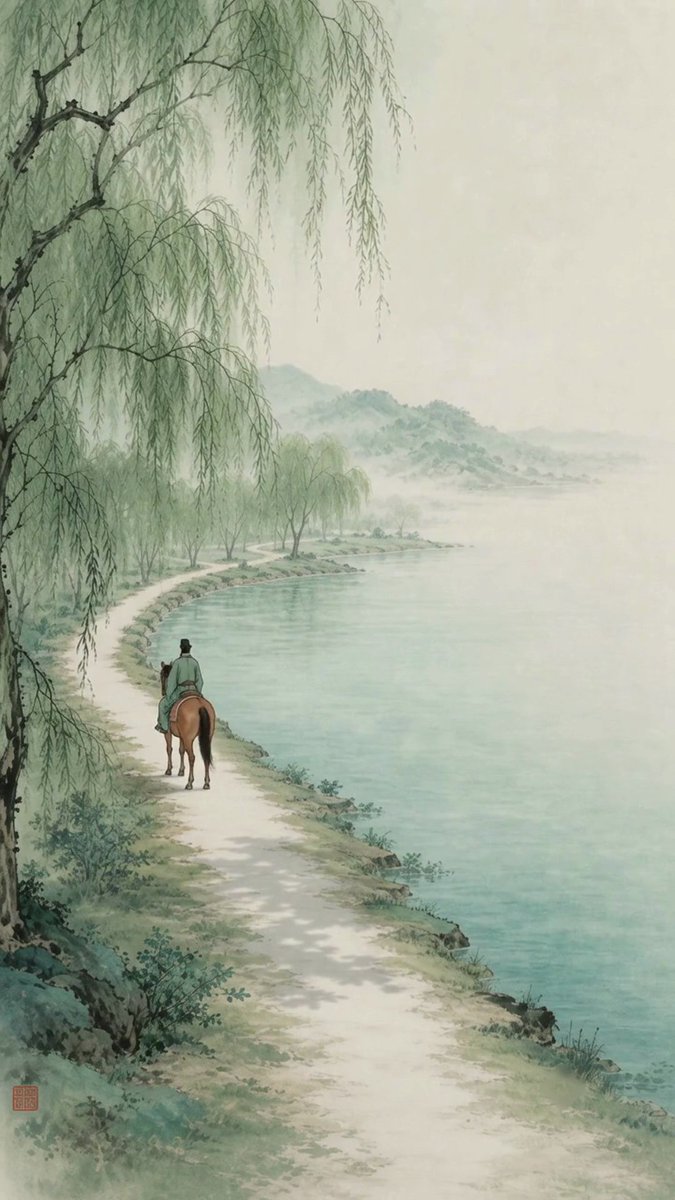
| 绿杨白堤 | 青绿山水 | 柳绿、湖青、白堤 | 把结尾变成舒展的行旅画面 |
统一的是“系列 DNA”,不是统一色卡。
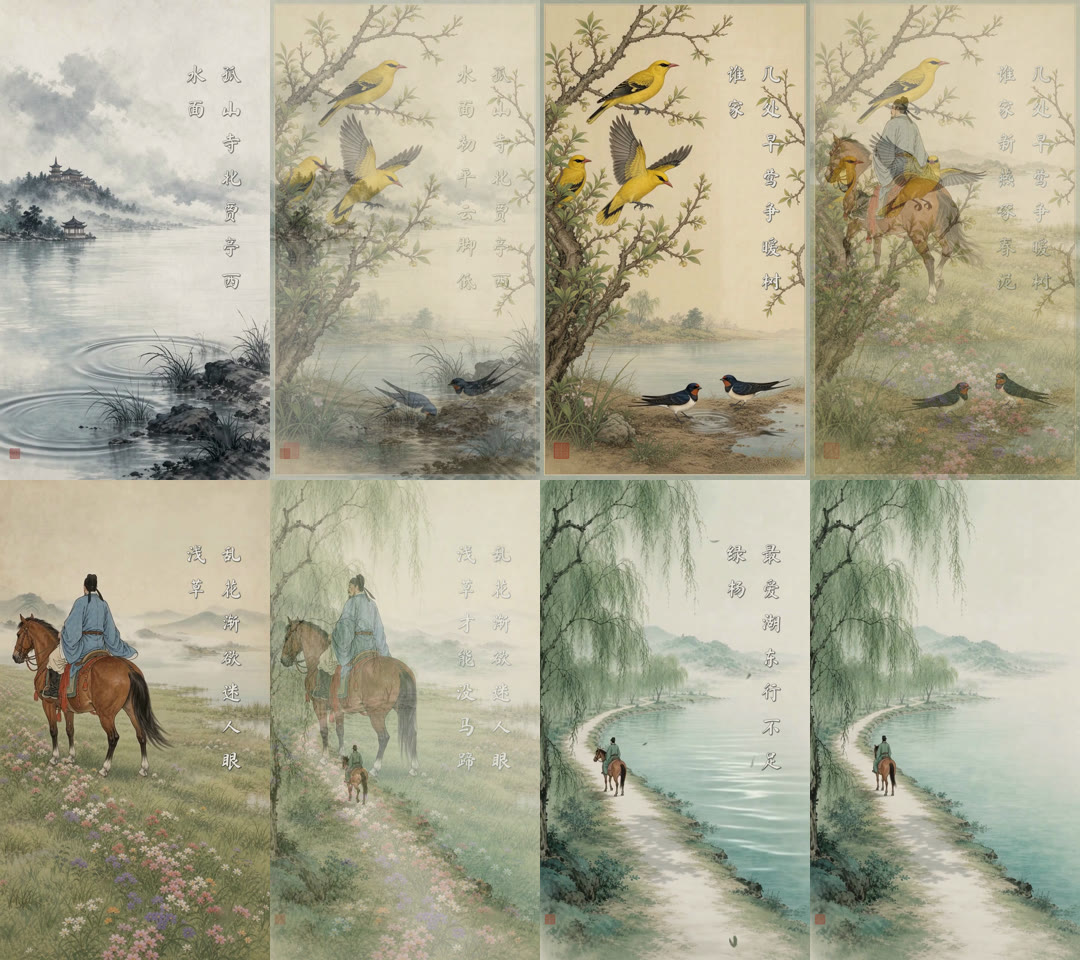
二、长诗默认两句一景,不要把整首诗塞进第一张图
《钱塘湖春行》有八句。我把连续两句合成一景,共四景:
孤山寺北贾亭西,水面初平云脚低。 几处早莺争暖树,谁家新燕啄春泥。 乱花渐欲迷人眼,浅草才能没马蹄。 最爱湖东行不足,绿杨阴里白沙堤。
每景只承担自己的意象。第一景不能提前出现莺燕和马,第二景不能把白沙堤也画进去。
我会为每景先写一张小型清单:
-
诗句中的明确名词。
-
一个主动作。
-
前景、中景、远景和天空。
-
这一景在整首诗里的情绪作用。
-
属于其他场景、必须禁止出现的物象。
这一步看起来慢,实际能减少大量重生。图像模型最容易犯的错误,就是觉得“既然是《钱塘湖春行》,那就把花、鸟、马、柳树和白堤全部放进每张图”。
三、静帧提示词要让诗推动画面,而不是让参考图支配诗
最终四张静帧通过用户指定的兼容图像 API 并行生成,早期样片则用内置 ImageGen 验证。为了让 Skill 能在 Codex 中直接复用,开源版本默认使用内置 image_gen,但分镜、提示词和验收规则不绑定某一家图像服务。
参考图只应该锚定材质、笔触和细节质量,不能复制它的构图。
每张静帧提示词至少要包含:
完整诗歌背景 当前两句原文 本景允许出现的明确物象 一个主视觉事件 前景 / 中景 / 远景 / 天空 本景独立的画法、色调和光线 右侧两列题字安全区 禁止生成文字、水印和现代物品 禁止泄漏其他场景的物象
真正重要的是“一景一条风格通道”。第二景的工笔鸟羽和第一景的淡墨水气可以不同,但它们的颜料克制、时代细节和中国画质感必须属于同一部片。
四、用户的一句纠正,改变了整个图生视频提示词
最开始的动态方案里有慢速推近。用户很快指出:
不对,不是推移。我是指你的图生视频提示词可以琢磨一下。
这句话非常关键。
很多所谓“动态古画”,其实只是静态 PNG 在后期从 100% 放大到 104%。画面确实动了,但水没有流、鸟没有叫、柳枝没有风、马也没有呼吸。
真正的图生视频应该让画中存在的原因产生画中存在的结果:
-
鸟鸣对应鸟喙张合和注意姿态。
-
水声对应接触点扩散的水纹。
-
风声对应芦苇、柳枝和衣袍摆动。
-
马蹄声对应一次可读的抬蹄与落地。
镜头因此改为默认完全锁定:
LOCKED CAMERA no zoom, push, pan, tilt, roll, reframing, parallax or crop change
动态来自画中物象,而不是摄影机。
五、图生视频提示词最终拆成四个部分
1. 静态锚点
明确告诉模型,哪些东西绝对不能动、不能重画:
寺庙屋顶、亭台、山体轮廓、树干、主枝、岸线、人物躯干、马体、红印、题字留白区
2. 局部动作区
每景只设置一个主动作,再加一到两个小动作:
主动作:两圈水纹从现有芦苇接触点扩散 辅助动作:芦苇一起弯曲一次;倒影只闪动几个像素
动作越多,模型越容易把整张图重新画一遍。
3. 稳定收尾
每段最后约一秒让残余动作慢慢停下。这样下一景做交叉溶解时,不会一边剧烈挥动、一边突然透明。
4. 反幻觉禁令
不同场景需要不同禁令:
禁止新增主体 禁止改变鸟数 禁止树枝生长 禁止柳叶脱落 禁止云雾变成描边祥云 禁止建筑重建 禁止多腿、融合关节和身体替换 禁止生成文字与额外印章
提示词不再只是“让画面动起来”,而是“只允许指定区域以指定方式动起来”。
六、真实失败一:低云变成了祥云,寺庙也被重新搭建
第一景最初要求低云移动、薄雾绕过寺庙。模型把“云雾运动”理解成了重新设计天空,中段出现大量描边祥云,寺庙层数和位置也发生变化。
我后来彻底取消了天空动画,只让前景水纹和芦苇承担动态:
Everything above the foreground waterline is completely frozen. Sky, clouds, mist, mountains, trees, temple and pavilion do not move.
结果反而更自然。画面不需要所有区域都动,只要观众能看到水面正在发生事情,就已经不是静态壁纸。
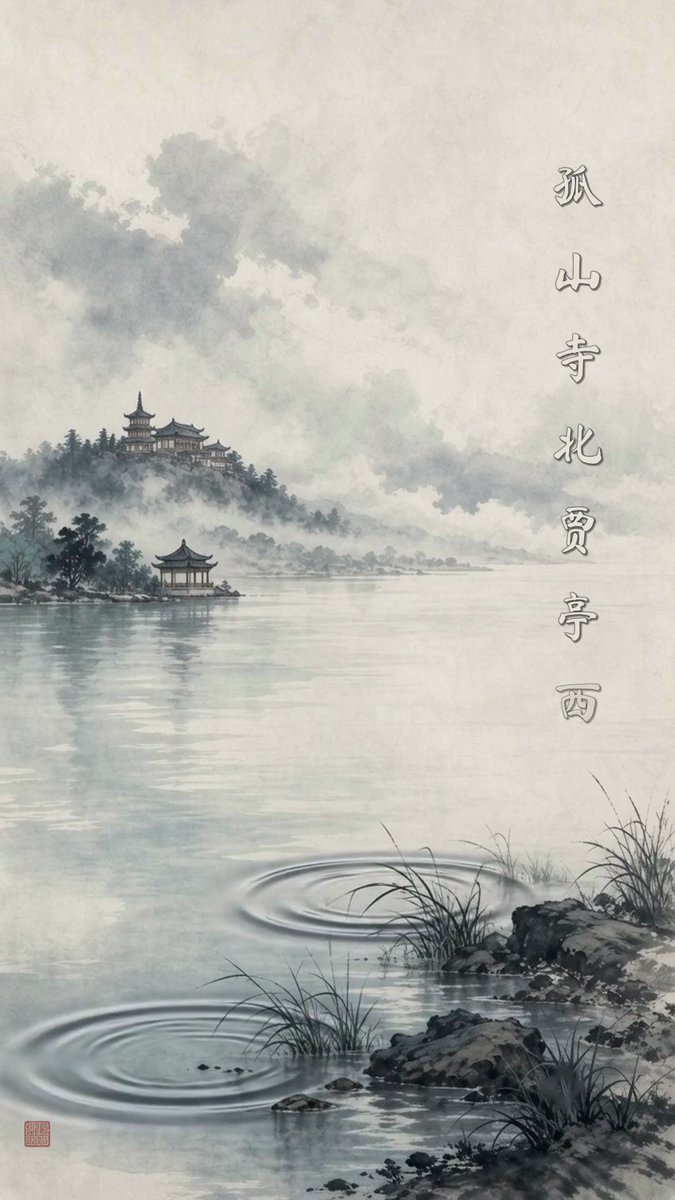
七、真实失败二:莺越飞越多,树枝越长越
第二景的静帧里有三只莺、两只燕。最初让一只飞行中的莺落到树枝上,模型在运动过程中复制了鸟,还补画了新的垂枝。
问题在于“落到树枝”包含了较长距离移动、身体姿态变化和落点重构。
修正版不再让鸟跨画面飞行:
-
飞行中的莺围绕原身体中心振翅一次,位移不超过画面高度的 3%。
-
栖枝莺只转头和张嘴。
-
燕子只在原泥点完成低头、啄泥、抬头。
-
整棵树完全冻结,不允许摆动、生长或新增枝条。
不是动作越大越好,而是动作越可控越好。
八、真实失败三:柳树一动,叶子就飞满天空
第四景原本要求柳枝两次风动、马匹向前走一步、水面出现流光。模型把“柳枝风动”扩展成了大量脱落叶片。
修正版增加了非常具体的连接关系:
Each leaf remains connected to its original twig. No leaf, twig, petal or debris may detach or fly through the air.
图生视频最有效的限制,往往不是抽象的“不要变形”,而是写清楚物体必须继续连接到哪里。
九、只清白色星标,红色方印必须留下
视频右下角会出现白色星形或菱形标记,而静帧左下角有传统红色方印。
这两个东西在视觉上都像“标记”,但语义完全不同:
-
白色星标是需要按用户要求处理的模型覆盖层。
-
红色方印是中国画构图的一部分。
清理脚本因此只锁定右下角白色菱形区域,不能做全画面自动抹除。处理后还要重新抽取右下角和左下角画面:白色星标消失,红印仍然存在,才算通过。
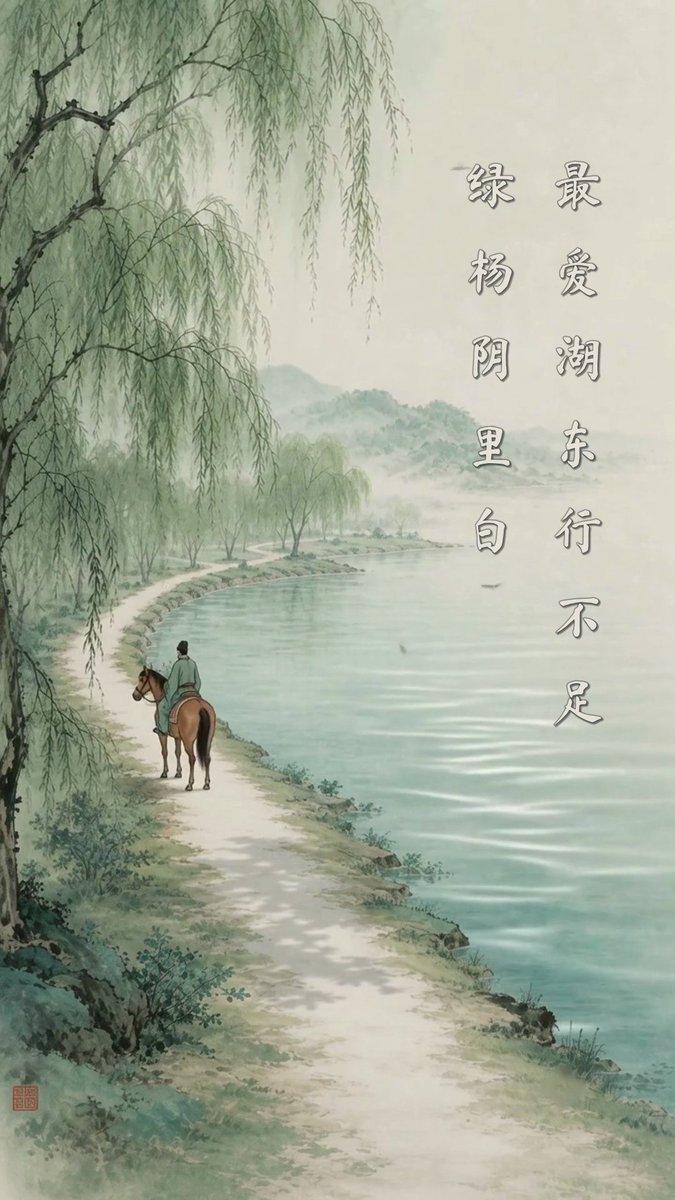
十、毛笔字不是一次出现,而是像题跋一样写出来
字幕使用 Ma Shan Zheng。两句诗分别放在两列:
-
第一句在右列。
-
第二句在左列。
-
标点不显示。
-
每个字间隔约 0.42 秒出现。
-
每景末尾一起淡出,给转场留出空间。
这里使用 ASS,而不是把文字直接生成进图片。原因很简单:绘图模型生成汉字不可靠,后期字幕才能保证每个字正确、位置一致并可修改。
十一、AI 原环境声不能丢,BGM 也不能每景重启
每段 I2V 视频都带有自己的环境声:湖水、风、鸟鸣、翅膀、草叶、衣袍和马蹄。
最初拼接时最容易犯两个错误:
-
烧录字幕时只保留画面,把模型原声丢掉。
-
每个场景都重新播放一次 BGM,导致音乐在转场处反复从头开始。
最后的音频结构是:
场景 1 原声 ─┐ 场景 2 原声 ─┼─ acrossfade ─┐ 场景 3 原声 ─┤ ├─ amix ─ limiter 场景 4 原声 ─┘ │ 连续 BGM ────────────────────┘
BGM 可以低音量铺底,也可以按用户要求 100% 原始增益与环境声并行。两种模式都不能做逐句抽吸,也不能在每景重新开始。
十二、自然渐变不只是画面,也包括环境声
四景之间使用 1.2 秒交叉溶解:
-
画面:xfade=transition=fade
-
原环境声:acrossfade
-
BGM:全片连续播放
实际编码时还遇到一个 FFmpeg 细节:xfade 会把输出提升成 4:4:4 色彩格式,而 H.264 High Profile 不接受默认的 4:4:4 输入。
最终在交叉溶解之后显式增加:
format=yuv420p
这个错误很典型:所有素材都已经是 yuv420p,但滤镜链中间仍可能改变像素格式。必须检查最终编码,不要根据输入文件推断输出一定正确。
十三、最终验收看的不是提示词,而是编码后的 MP4
最终视频是:
-
1080×1920
-
30fps
-
H.264 + AAC
-
32.44 秒
-
四个场景
-
三个 1.2 秒转场
我从最终 MP4 重新抽取:
-
每景主画面。
-
三个转场中点。
-
马匹与人物高风险帧。
-
最后一帧。
-
每景右下角星标区域。
-
左下角红印区域。
同时检查:
-
寺庙有没有复制或重构。
-
鸟数是否始终正确。
-
马是否保持四腿并接触同一地面。
-
右侧题字区域是否干净。
-
白色星标是否消失。
-
红印是否保留。
-
有没有黑帧、损坏末帧和长静音。
-
视频与音频编码是否符合发布规格。
自动命令通过,只能说明文件能播放;视觉关系通过,才说明视频能交付。
十四、把一次项目改成 Skill,真正固化的是什么
这个项目最后被整理成了 classical-poem-silk-video Agent Skill。
它固化的不是《钱塘湖春行》四张图,而是下面这些可复用判断:
-
四句以内逐句成景,长诗默认两句一景。
-
风格统一不等于色调完全一致。
-
图生视频默认锁定镜头。
-
每景一个主动作,局部动作优先于长距离移动。
-
静态锚点必须具体到建筑、树干、岸线和身体中心。
-
每景最后一秒收稳,方便自然转场。
-
星标和红印必须区别处理。
-
毛笔字字幕后期生成,不交给绘图模型。
-
模型原环境声必须保留。
-
BGM 全片连续,不随场景重启。
-
最终 MP4 必须重新抽帧验收。
Skill 的价值,就是把“这次终于改对了”变成“下一次默认不会再错”。
十五、完整工作流总结
读取整首诗 → 识别时代、地点、季节、意象和情绪弧线 → 逐句或两句一景 → 为每景选择独立中国画风格通道 → AI 生图并行生成无字静帧 → 写静态锚点 + 局部动作提示词 → Docker I2V 生成带环境声的视频 → 抽取早、中、晚、收尾帧验收 → 只重做不合格镜头 → 按需处理白色星标,保留红印 → 生成两列毛笔字逐字字幕 → 烧录字幕并保留原声 → 画面和环境声交叉溶解 → 连续混入 BGM → 对最终编码 MP4 做视觉与媒体 QA
这套方法不只适合唐诗。宋词、元曲、山水散文、古文名句,只要能够拆成明确意象,都可以用同一套流程制作。
真正让古画“活起来”的,不是让整幅画一直动,而是让最应该动的那一小部分,按照诗句的原因自然地动。
开源 Skill:https://github.com/Mr-funny/hbg-classical-poem-silk-video
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


