
GPT Image 2生图最大骗局:上传参考图,就能生成同一个人
文章目录
最近在使用 AI 生成图片时,我发现了一个很反常的问题:
不上传参考图时,画面的风格还挺稳定;一旦上传参考图,原本设计好的风格反而被带偏了。
更麻烦的是,我上传的明明是一张人物照片,希望 AI 保留人物长相,最终生成出来的人却完全不像。有时候只是发型和脸型有一点接近,有时候甚至像换了一个人。
例如,我上传的是这个虚拟人物形象,想通过提示词来完成人物形象的迁移,改成古风的风格图片。
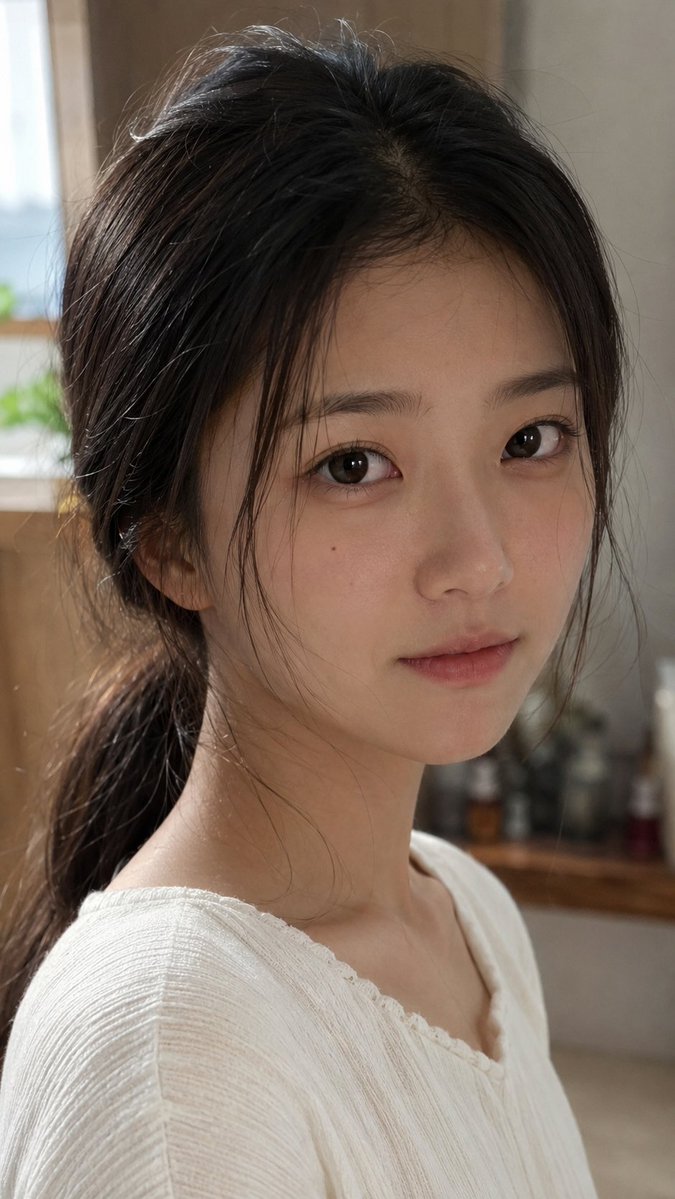
但最后我得到的图片,与原图的人物形象还是有很大差别。
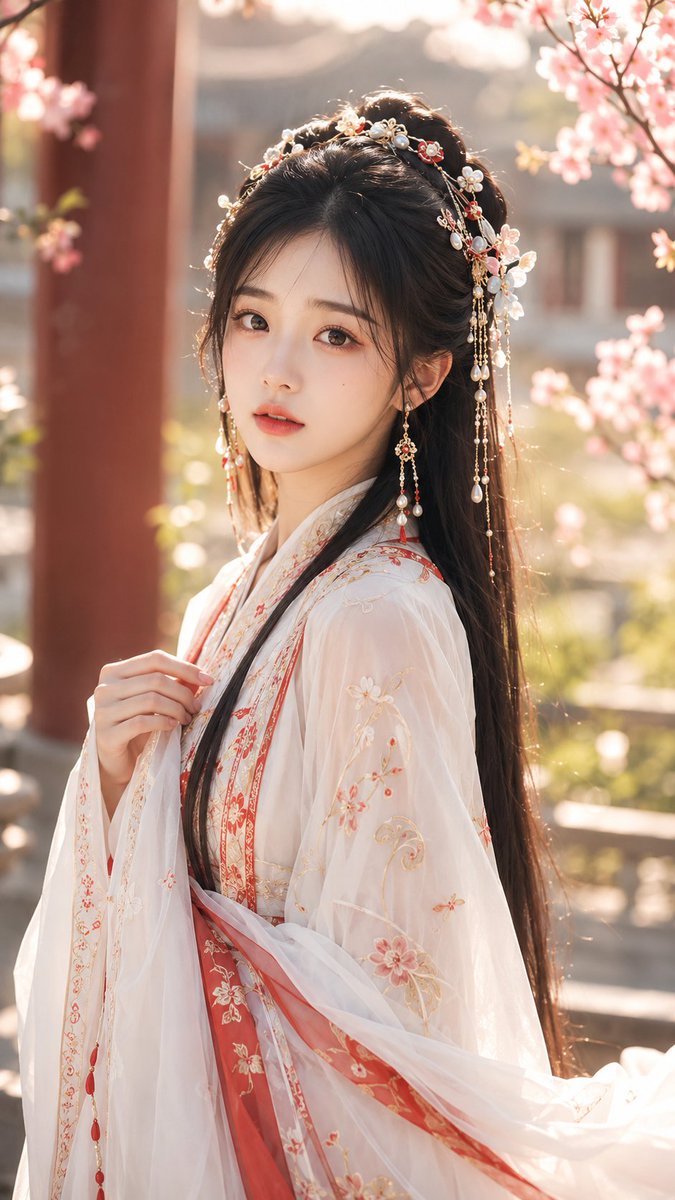
这让我产生了一个疑问:
既然已经提供了参考图,为什么 AI 还是做不到“照着这个人生成”?
经过多次测试,我发现问题通常不是一句“模型不行”就能解释的。
很多时候,真正的问题在于:我们以为自己上传的是一张人物参考图,但在 AI 眼里,它同时还是一张风格图、构图图、服装图、光线图和场景图。
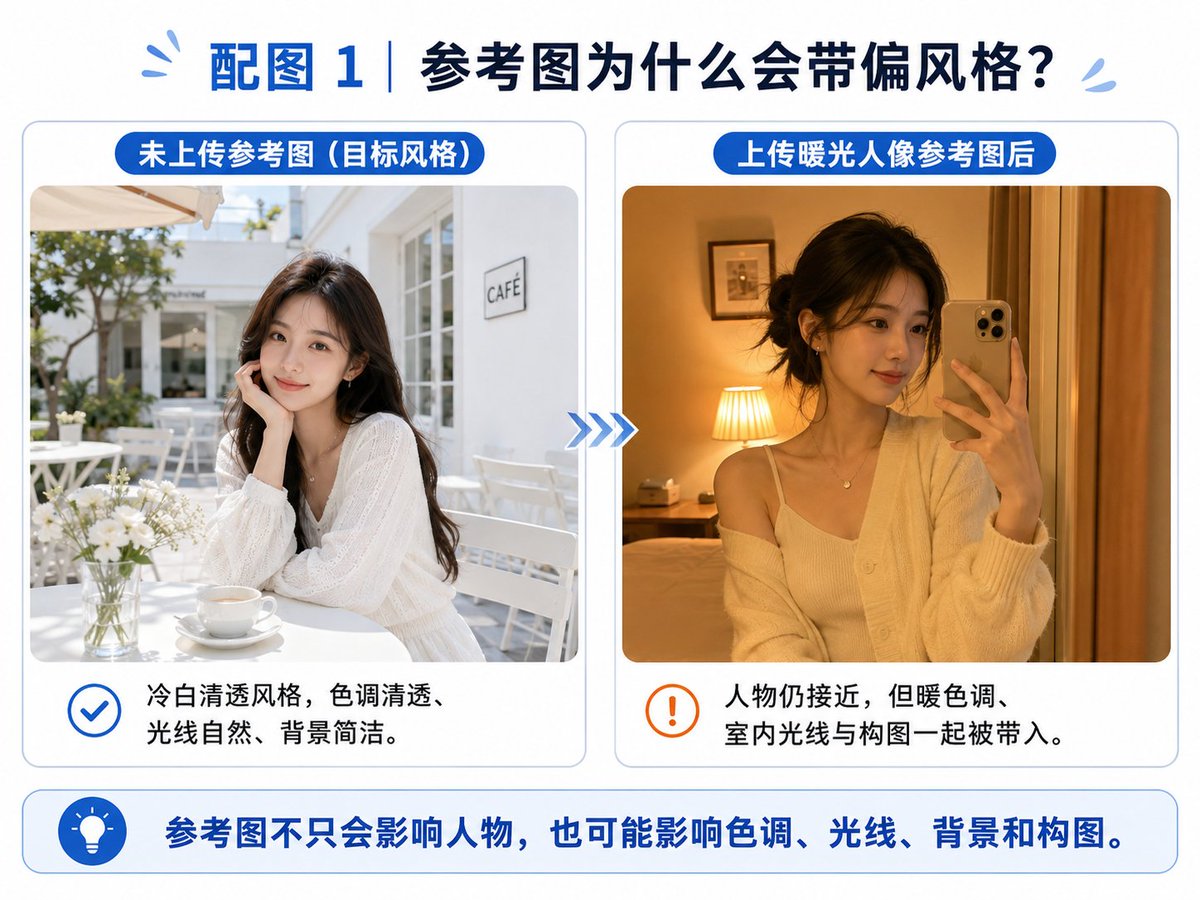
左侧为未上传参考图时生成的目标风格,右侧为上传人物照片后风格被参考图带偏的结果。
参考图不仅会影响人物,也可能影响色调、光线、背景和构图。
一、AI 并不知道我们到底想参考什么
我们看到一张照片时,可以非常自然地理解:
我只想参考这个人的脸,其他内容都不要。
但对于多数图像生成模型来说,一张参考图并不会自动被拆分成“人物身份”和“其他无关元素”。
模型可能同时从图片中读取:
- 人物脸型和五官;
- 发型、服装和妆容;
- 拍摄角度和人物姿态;
- 背景环境和构图;
- 光线方向;
- 色彩倾向;
- 摄影质感;
- 图片清晰度和压缩痕迹。
例如,你上传了一张室内暖黄色灯光下的人像照片,却要求生成一张冷白清透的户外 CCD 生活照,就是你上传的图片与你的提示词风格不一致。
在你的理解里:
人物长相参考上传图片,风格按照文字提示词执行。
但模型接收到的任务可能更接近:
保留参考图中的人物、暖黄色光线、室内质感和拍摄方式,同时尝试加入冷白户外 CCD 风格。
这两个方向本身就在互相竞争。
最终常见的结果就是:
人物没有完全保住,目标风格也没有完全实现。
二、上传参考图,不等于开启“人物复制”
这是很多人最容易产生的误解。
我们会下意识地认为:
上传一张人物照片,AI 应该就能识别这个人,并在其他场景中准确还原。
但普通的图片生成,更接近于根据参考图重新理解和生成,而不是把原图中的脸直接复制到新画面里。
模型往往只能提取一组近似特征,例如:
- 东方女性;
- 鹅蛋脸;
- 黑色长发;
- 杏眼;
- 鼻型小巧;
- 年轻、清秀;
- 淡妆;
- 温柔气质。
问题在于,符合这些描述的人可能有很多。
于是,AI 虽然保留了“人物类型”,却没有真正保留“这个具体的人”。
这也是为什么生成结果经常会出现一种感觉:
看起来像是同一类人,但不是同一个人。
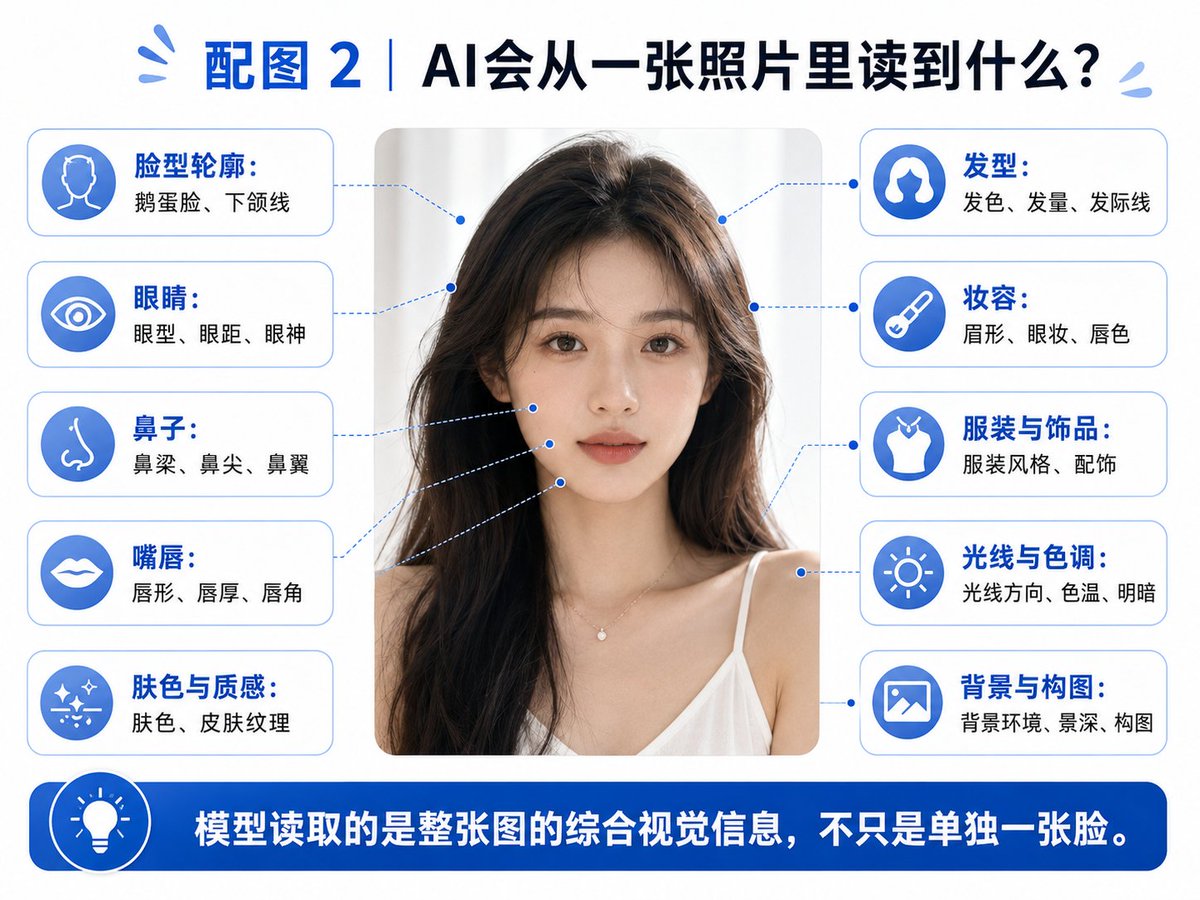
模型读取的不是单独一张脸,而是整张图片中的综合视觉信息。
三、参考图越强,目标风格越容易消失
参考图和文字提示词之间,通常存在一定程度的控制权竞争。
- 参考图影响越强,人物、构图和原图质感越容易保留,但新风格的自由度会下降。
- 参考图影响越弱,新的场景和风格更容易实现,但人物一致性又可能下降。
这就形成了一个很难同时满足的三角关系:
-
人物必须高度相似;
-
风格必须完全改变;
-
姿态、服装、背景和构图也要大幅变化。
当这三项同时要求很高时,模型就容易出现取舍。
例如,参考图是一张正面证件式人像,你却要求人物侧身坐在夜晚电影院里,使用低角度镜头,穿着完全不同的服装,还要呈现强烈的电影光影。
这意味着 AI 不仅要保留人物身份,还要重新计算:
- 侧脸轮廓;
- 新角度下的五官关系;
- 不同光线下的面部结构;
- 新表情;
- 新发型遮挡;
- 新姿态下的身体比例。
改变得越多,人物越容易漂移。
所以,人物不一致并不一定是参考图完全失效,也可能是你要求模型同时改变的变量太多了。
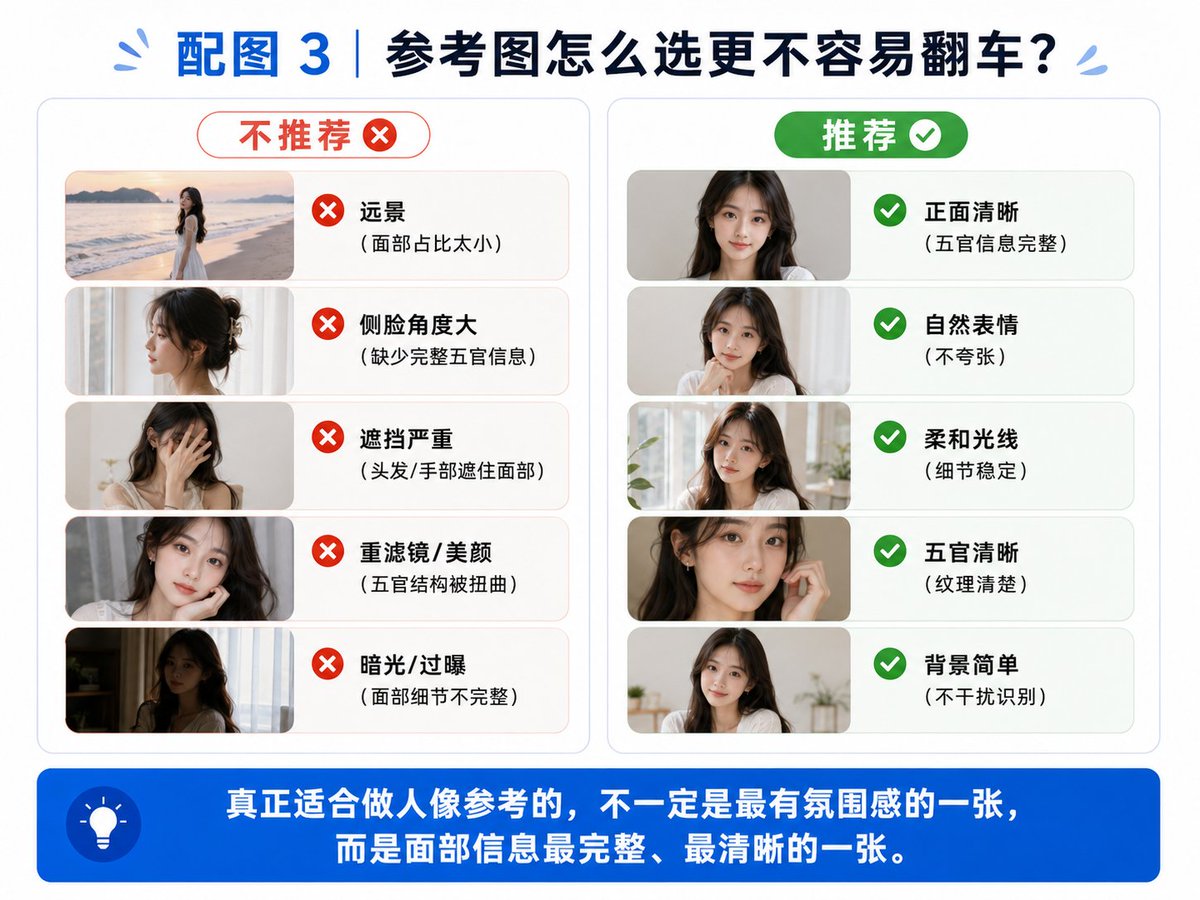
四、参考图本身,也可能不适合做人像一致性参考
并不是所有好看的照片,都适合作为人物参考图。
一张氛围感很强的写真,可能很适合发朋友圈,却不一定适合 AI 识别人脸。
以下几类图片尤其容易导致人物不一致:
1. 面部占比太小
如果人物只是全身照中的一小部分,模型能够读取到的五官信息非常有限。
2. 侧脸角度过大
单张侧脸照片缺少完整的正面五官关系,模型需要自行推测另一侧面部结构。
3. 头发遮挡面部
刘海、碎发、手部或者饰品遮挡眼睛和脸型时,都会降低人物特征的稳定性。
4. 美颜和滤镜过重
强磨皮、大眼、瘦脸、液化和夸张妆容,可能会让模型读取到错误的人脸结构。
5. 光影过于极端
当一半面部隐藏在阴影里,或者高光严重过曝时,人物身份信息会变得不完整。
6. 图片分辨率太低
模糊、压缩严重或者多次转存的图片,都会减少可用的面部细节。
7. 表情过于夸张
大笑、闭眼、撅嘴或者极端表情,会改变眼睛、嘴巴和面部肌肉关系。
真正适合做人物参考的图片,通常不是最有氛围感的那一张,而是面部信息最完整、最清楚、最中性的那一张。
五、解决方法一:一张参考图,只承担一种任务
这是我测试后认为最重要的一条原则:
不要让同一张参考图同时负责人物、风格、姿势、构图和场景。
在开始生成前,先明确这张图片的用途。
它究竟是:
- 人物身份参考;
- 风格参考;
- 姿态参考;
- 服装参考;
- 构图参考;
- 场景参考;
- 产品外观参考。
如果你上传的是人物照片,就应该在提示词中明确限制它的作用范围。
可以这样写:
仅参考上传图片中的人物身份特征,包括脸型、五官比例、眼型、鼻型、嘴唇和整体辨识度。不要继承参考图中的服装、背景、构图、姿态、光线、滤镜、色调和摄影风格。
然后再单独描述目标画面:
将同一位人物重新拍摄为冷白清透 CCD 生活照,场景为白色街角咖啡馆,晴天自然光,蓝白清透色彩,轻微柔闪,真实生活抓拍感。
这种写法不能保证百分之百锁定人物,但至少能够减少模型把参考图中的其他元素一起复制过来的概率。
六、解决方法二:先锁定人物,再改变风格
如果一次性要求 AI 完成人物一致性、换装、换场景、换姿势和换风格,失败率通常会比较高。
更稳定的方法是分两步完成。
第一步:建立人物基准图
先尽量少改动人物。
例如:
保留参考图中的人物身份和面部特征,生成同一人物的正面自然肖像。柔和均匀光线,简单背景,自然表情,面部清晰,不改变脸型、眼型、鼻型和嘴唇结构。
这一阶段不要追求复杂的风格,只需要确认人物是否足够像。
第二步:使用基准图改变场景和风格
当第一步生成出一张相对稳定的人物图后,再将它作为新的参考图,逐步修改:
- 先换服装;
- 再换场景;
- 再改变姿态;
- 最后增加复杂光影和滤镜。
这种方法的核心不是让模型一次完成所有事情,而是逐步缩小每次生成需要解决的变量。
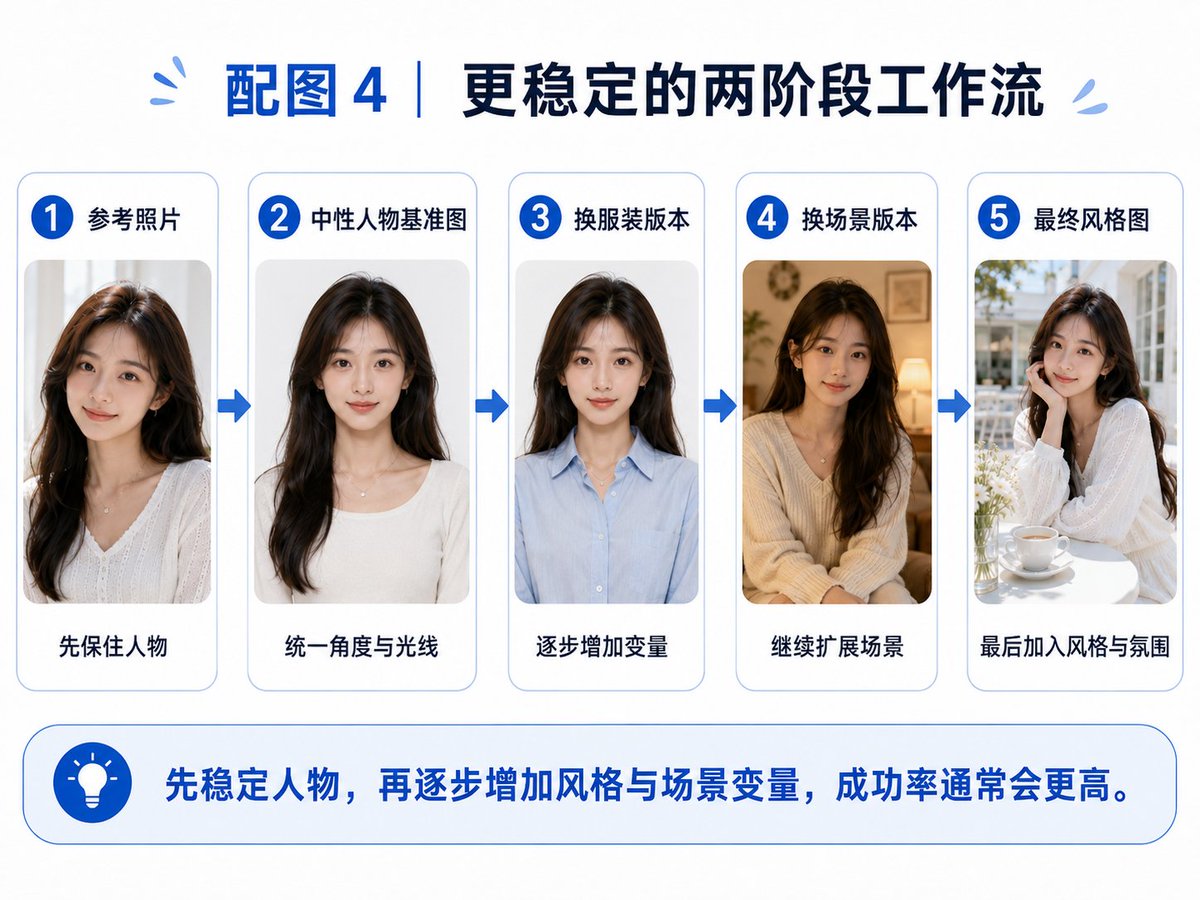
先稳定人物,再逐步增加风格和场景变量。
七、解决方法三:先裁剪参考图,再上传
如果你只想参考人物的脸,就不要直接上传一张包含大量环境信息的全身写真。
可以先将参考图裁剪成:
- 头部和肩部为主;
- 面部位于画面中心;
- 保留完整发际线和下颌线;
- 不要裁掉额头或下巴;
- 尽量减少背景面积;
- 不要进行二次美颜。
这样做的目的,是降低背景、服装和原始构图对生成结果的影响。
不过也不能裁得太近。
如果图片里只剩下眼睛、鼻子和嘴巴,缺少完整脸型、耳朵、发际线和头部轮廓,人物仍然容易出现偏差。
比较合理的是标准头肩肖像,而不是极端局部特写。
八、解决方法四:减少互相冲突的风格词
很多时候,问题不全在参考图,也在提示词。
例如一段提示词里同时出现:
- 真实生活抓拍;
- 高级时尚大片;
- 柔光 CCD;
- 电影级戏剧光影;
- 韩系清透;
- 港风暖黄;
- 冷白色调;
- 复古胶片;
- 商业棚拍。
单独看,每一个词都很好。
但放在一起以后,模型并不知道哪个才是主要方向。
上传参考图后,这种风格冲突会更加严重,因为参考图本身还会带入一套新的视觉风格。
所以提示词最好只保留一个主要风格,再搭配少量辅助质感。
例如:
主要风格:日间冷白清透 CCD 生活照。 辅助质感:柔和闪光、轻颗粒、真实抓拍感。
而不是把所有好看的风格词全部叠加进去。
九、解决方法五:不要一开始就追求大幅度换脸角度
如果参考图是正面,就先从正面或轻微侧脸开始。
如果参考图是半身,就先生成半身。
如果参考图中人物是自然表情,就先保持自然表情。
当人物稳定后,再逐步尝试:
- 三分之二侧脸;
- 低头或抬头;
- 坐姿;
- 运动状态;
- 强光影;
- 远景和全身;
- 更复杂的遮挡。
尤其是以下组合,对人物一致性的挑战很大:
单张正面参考图 + 完全侧脸 + 低角度仰拍 + 强烈表情 + 头发遮脸 + 暗光。
这并不代表不能生成,而是需要接受人物相似度可能明显下降。
十、一个更稳定的人物参考提示词模板
下面这段模板,可以根据自己的风格直接修改。
人物身份约束
仅参考上传图片中的人物身份特征。保留同一位成年人物的核心辨识度,包括脸型轮廓、五官比例、眼型、眉形、鼻梁、鼻尖、嘴唇形状、下颌线、发际线和整体气质。人物必须看起来是同一个人,而不是五官相似的另一位模特。

参考范围限制
不要继承参考图中的背景、场景、服装、饰品、姿态、镜头角度、构图、光线、滤镜、色调和摄影风格。参考图只用于人物身份一致性。

目标画面
将同一位人物重新拍摄为日间冷白清透 CCD 生活照。场景为现代白色街角咖啡馆,晴天高亮自然光,白色建筑和玻璃产生轻微冷白反射。人物穿浅水蓝修身针织上衣与奶白色休闲短裙,坐在户外圆桌旁,身体轻微侧向镜头,表情自然放松。

摄影风格
高色温自然光,冷白高光,蓝白清透色彩,轻微柔闪,极轻颗粒和轻数码噪点,真实生活抓拍感。人物面部清晰,肤色自然白皙,不要过度磨皮,不要网红脸,不要改变人物年龄和种族特征。

一致性约束
不要更换人物,不要重新设计五官,不要把人物生成成相似类型的陌生人。不要夸张大眼、尖下巴、高鼻梁或过度瘦脸。保持自然面部结构和真实比例。
这段提示词的重点不是反复写“像参考图”,而是明确告诉模型:
参考图负责什么,以及不负责什么。
十一、参考图越多,不一定越准确
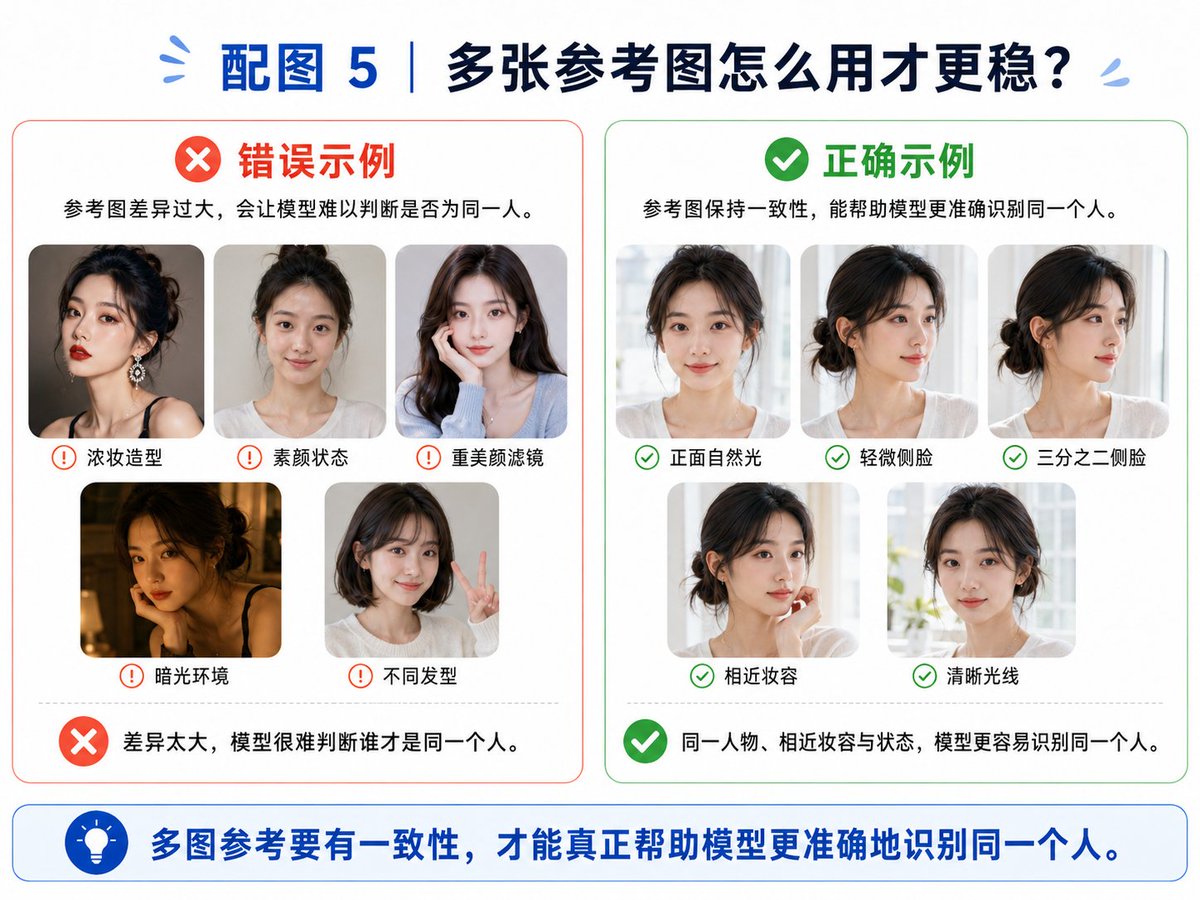
有些人发现一张参考图不够像,就会继续上传第二张、第三张、第四张。
但参考图越多,也可能带来新的问题。
如果不同照片存在以下差异:
- 年龄感不同;
- 妆容不同;
- 美颜程度不同;
- 发型不同;
- 光线不同;
- 脸型被镜头畸变;
- 某些照片经过明显液化;
- 拍摄时间跨度较大;
模型就需要判断,哪一张才代表人物的真实身份。
最终生成的人物,可能变成几张照片的平均结果,反而谁都不像。
多张参考图更适合用于补充不同角度,但前提是这些图片中的人物特征必须稳定。
比较理想的组合是:
- 一张正面自然肖像;
- 一张轻微侧脸;
- 一张三分之二侧脸;
- 相同发型;
- 相近妆容;
- 相近年龄状态;
- 柔和清晰的光线。
十二、如何判断到底是哪一步出了问题?
当生成结果不理想时,不要立即重新写一整段更长的提示词。
可以按照下面的顺序排查。
第1步:去掉参考图
只使用文字提示词生成一次。
如果风格恢复正常,说明参考图确实在干扰目标风格。
第2步:只保留人物参考
删除复杂场景、换装、姿态和滤镜要求,只生成简单人物肖像。
如果依然不像,说明参考图质量或模型的人物识别能力存在限制。
第3步:更换参考图
选择正面、清晰、自然光、低遮挡的人像重新测试。
第4步:逐项增加变量
先增加服装,再增加场景,再增加动作,最后加入复杂风格。
观察人物从哪一步开始发生明显漂移。
第5步:检查提示词冲突
删除重复风格词、矛盾光线、多个色调以及过度复杂的摄影要求。
通过这种方式,可以找到真正导致失败的变量,而不是不断堆叠提示词。
写在最后
以前我遇到人物不像时,第一反应通常是继续强调:
必须和参考图完全一致。 必须是同一个人。 不要换脸。 不要改变五官。
结果提示词越来越长,人物却没有明显变得更像,甚至连原来的风格也一起丢失了。
后来我才发现,问题不在于强调得不够多,而在于没有把参考图的作用说清楚。
一张参考图里包含的信息太多了。
当我们没有明确指定参考范围时,AI 只能自己判断哪些内容应该保留,哪些内容应该重新生成。
所以,解决参考图不一致问题的核心,并不是一句更强硬的“照着生成”,而是做好三件事:
- 选择真正适合识别人脸的参考图。
- 明确参考图只负责什么,不负责什么。
- 减少一次生成中需要同时改变的变量。
参考图不是万能复制按钮。
它更像是一份视觉材料。
我是李岳@liyue_ai 提示词工程师 | AI实战派 欢迎关注🌞🌞🌞
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


